

Dans Nous avons examiné la mise en cluster de RabbitMQ pour garantir la disponibilité et la tolérance aux pannes. Maintenant, approfondissons notre étude d'Apache Kafka.
Ici, l'unité de réplication est la partition. Chaque topic a une ou plusieurs partitions. Dans chaque partition, il y a un leader avec ou sans suiveurs. Lors de la création d'un topic, le nombre de partitions et le coefficient de réplication sont spécifiés. Une valeur courante est 3, ce qui signifie trois répliques : un leader et deux suiveurs.
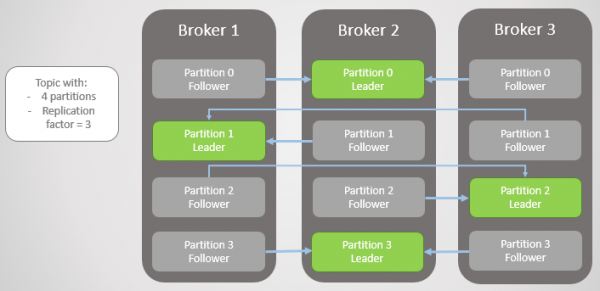
Fig. 1. Quatre partitions sont réparties entre trois courtiers
Toutes les requêtes de lecture et d'écriture sont dirigées vers le leader. Les suiveurs envoient périodiquement des requêtes au leader pour obtenir les derniers messages. Les consommateurs ne s'adressent jamais aux suiveurs, ces derniers n'existant que pour l'excès et la tolérance aux pannes.
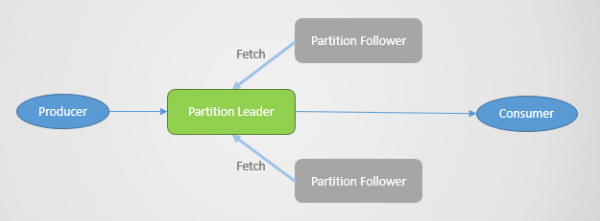
Panne de la partition
Lorsqu'un courtier tombe en panne, les leaders de plusieurs partitions sont souvent affectés. Dans chaque cas, un suiveur d'un autre nœud devient le leader. Ce n'est pas toujours le cas, car le facteur de synchronisation entre en jeu : existe-t-il des suiveurs synchronisés, et si ce n'est pas le cas, la transition vers une réplique non synchronisée est-elle autorisée ? Mais ne compliquons pas les choses pour l'instant.
Le courtier 3 tombe en panne — et un nouveau leader est élu pour la partition 2 sur le courtier 2.
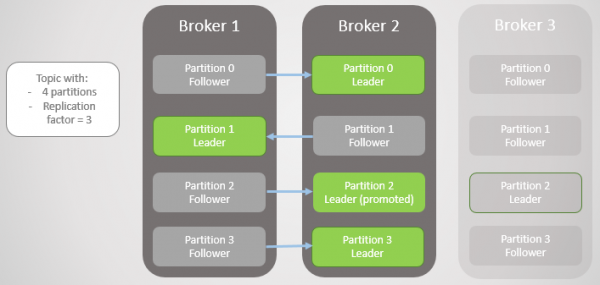
Fig. 2. Le courtier 3 meurt, et son suiveur sur le courtier 2 est élu nouveau leader de la partition 2
Ensuite, le courtier 1 échoue et la partition 1 perd également son leader, dont le rôle passe au courtier 2.
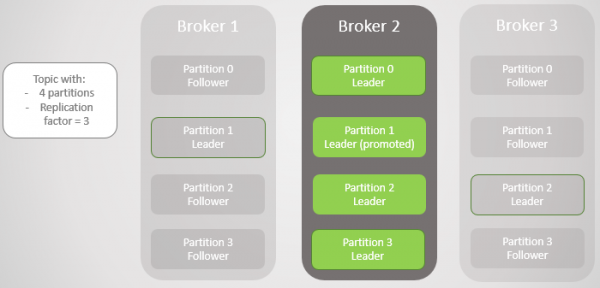
Fig. 3. Il ne reste qu'un seul courtier. Tous les leaders se trouvent sur le même courtier avec une redondance nulle
Lorsque le courtier 1 revient en ligne, il ajoute quatre suiveurs, apportant une certaine redondance à chaque partition. Mais tous les leaders restent toujours sur le courtier 2.
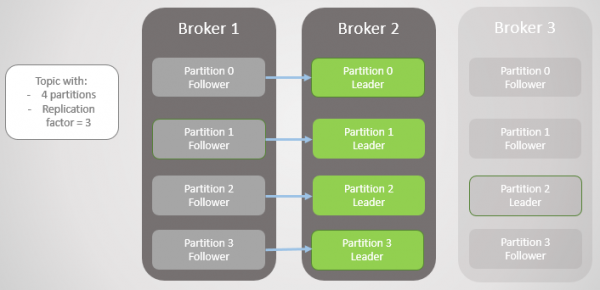
Fig. 4. Les leaders restent sur le courtier 2
Lorsque le courtier 3 redémarre, nous revenons à trois répliques par partition. Mais tous les leaders restent toujours sur le courtier 2.
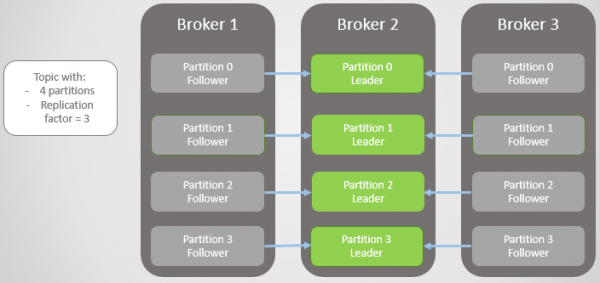
Fig. 5. Répartition déséquilibrée des leaders après le redémarrage des courtiers 1 et 3
Kafka dispose d'un outil pour un rééquilibrage des leaders de meilleure qualité que RabbitMQ. Ce dernier nécessitait l'utilisation d'un plugin tiers ou d'un script qui modifiait les politiques pour migrer le nœud principal au détriment de la redondance pendant la migration. En outre, pour de grandes files d'attente, il fallait composer avec l'indisponibilité pendant la synchronisation.
Kafka a la conception de « répliques préférées » pour le rôle de leader. Lors de la création de partitions de sujet, Kafka essaie de répartir les leaders de manière équilibrée entre les nœuds et marque ces premiers leaders comme préférés. Avec le temps, en raison du redémarrage des serveurs, des pannes et de la perte de connectivité, les leaders peuvent se retrouver sur d'autres nœuds, comme dans le cas extrême décrit ci-dessus.
Pour remédier à cela, Kafka propose deux options :
- L'option auto.leader.rebalance.enable=true permet au nœud contrôleur de réaffecter automatiquement les leaders vers les répliques préférées, rétablissant ainsi une répartition équilibrée.
- L'administrateur peut exécuter le script kafka-preferred-replica-election.sh pour réaffecter manuellement.
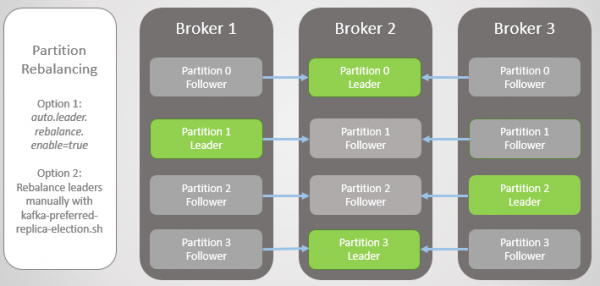
Figure 6. Répliques après rééquilibrage
C'était une version simplifiée de la panne, mais la réalité est plus complexe, bien qu'il n'y ait rien de trop compliqué ici. Tout se résume aux répliques synchronisées (In-Sync Replicas, ISR).
Répliques synchronisées (ISR)
ISR est un ensemble de répliques d'une partition qui est considéré comme « synchronisé » (in-sync). Il y a un leader, et il se peut qu'il n'y ait pas de suiveurs. Un suiveur est considéré comme synchronisé s'il a créé des copies exactes de tous les messages du leader avant l'expiration de l'intervalle replica.lag.time.max.ms.
Un suiveur est retiré de l'ensemble ISR s'il :
- n'a pas effectué de demande d'extraction pendant l'intervalle replica.lag.time.max.ms (considéré comme mort)
- n'a pas pu se mettre à jour pendant l'intervalle replica.lag.time.max.ms (considéré comme lent)
Les suiveurs effectuent des demandes d'extraction dans l'intervalle replica.fetch.wait.max.ms, qui est par défaut de 500 ms.
Pour expliquer clairement l'objectif de l'ISR, il faut examiner les confirmations du producteur et certains scénarios de panne. Les producteurs peuvent choisir quand le courtier envoie une confirmation :
- acks=0, aucune confirmation n'est envoyée
- acks=1, la confirmation est envoyée après que le leader a enregistré le message dans son journal local
- acks=all, la confirmation est envoyée après que toutes les répliques dans l'ISR ont enregistré le message dans leurs journaux locaux
Dans la terminologie de Kafka, si l'ISR a conservé le message, son « engagement » a lieu. Acks=all est l'option la plus sûre, mais cela entraîne également un délai supplémentaire. Examinons deux exemples de panne et comment différentes options ‘acks’ interagissent avec le concept d'ISR.
Acks=1 et ISR
Dans cet exemple, nous verrons que si le leader ne s'attend pas à recevoir chaque message de tous les suiveurs, une perte de données peut survenir lors d'une défaillance du leader. Le passage à un suiveur non synchronisé peut être autorisé ou interdit par la configuration. unclean.leader.election.enable.
Dans cet exemple, le producteur a la valeur acks=1. La partition est répartie sur les trois brokers. Le broker 3 est en retard, il s'est synchronisé avec le leader il y a huit secondes et accuse maintenant un retard de 7456 messages. Le broker 1 n'est en retard que d'une seconde. Notre producteur envoie un message et reçoit rapidement un ack, sans surcharge liée aux suiveurs lents ou morts, que le leader n'attend pas.
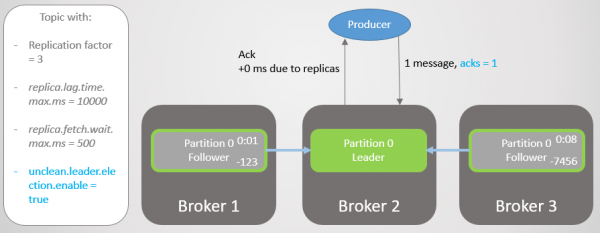
Fig. 7. ISR avec trois répliques
Le broker 2 tombe en panne, et le producteur reçoit une erreur de connexion. Après le passage du leadership au broker 1, nous perdons 123 messages. Le suiveur sur le broker 1 était dans l'ISR, mais n'était pas entièrement synchronisé avec le leader quand il a échoué.
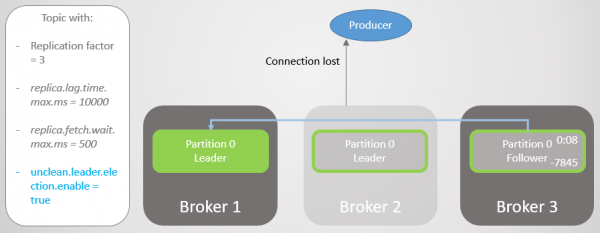
Fig. 8. Des messages sont perdus en cas de défaillance
Dans la configuration bootstrap.servers le producteur liste plusieurs brokers et peut demander à un autre broker qui est devenu le nouveau leader de la partition. Ensuite, il établit une connexion avec le broker 1 et continue d'envoyer des messages.
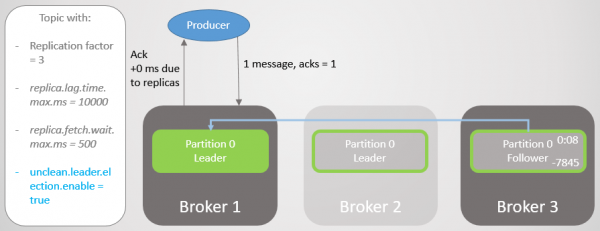
Fig. 9. L'envoi de messages reprend après une courte pause
Le broker 3 est encore plus en retard. Il fait des demandes de récupération, mais ne peut pas se synchroniser. Cela peut être dû à une connexion réseau lente entre les brokers, un problème de stockage, etc. Il est retiré de l'ISR. L'ISR se compose maintenant d'une seule réplique : le leader ! Le producteur continue d'envoyer des messages et de recevoir des confirmations.
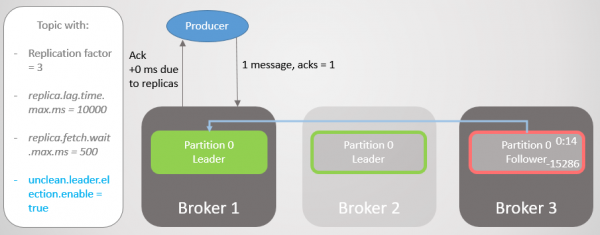
Fig. 10. Le suiveur sur le broker 3 est retiré de l'ISR
Le broker 1 tombe en panne et le leadership passe au broker 3 avec une perte de 15286 messages ! Le producteur reçoit un message d'erreur de connexion. Le passage au leader en dehors de l'ISR n'a été possible que grâce à la configuration unclean.leader.election.enable=true. S'il est configuré à faux, le passage ne se serait pas produit et toutes les requêtes de lecture et d'écriture auraient été rejetées. Dans ce cas, nous attendons le retour du broker 1 avec ses données intactes dans la réplique, qui redeviendra le leader.
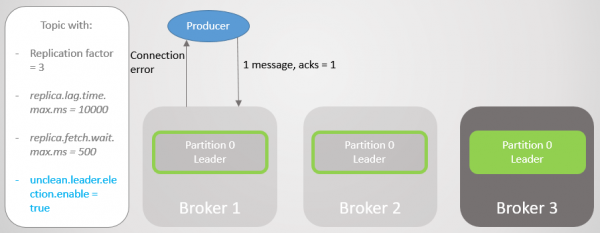
Fig. 11. Le broker 1 tombe en panne. De nombreux messages sont perdus en cas de défaillance.
Le producteur établit une connexion avec le dernier courtier et constate qu'il est désormais le leader de la section. Il commence à envoyer des messages au courtier 3.
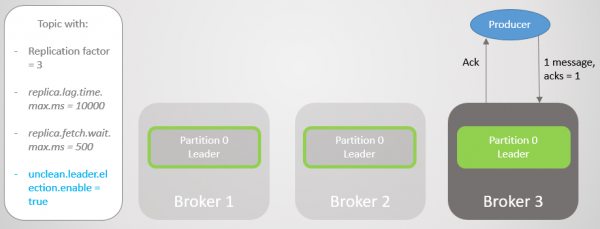
Fig. 12. Après une courte pause, les messages sont à nouveau envoyés à la section 0
Nous avons vu qu'en dehors des courtes interruptions causées par l'établissement de nouvelles connexions et la recherche d'un nouveau leader, le producteur envoyait constamment des messages. Cette configuration assure la disponibilité grâce à la cohérence (sécurité des données). Kafka a perdu des milliers de messages mais continuait à accepter de nouveaux enregistrements.
Acks=all et ISR
Récapitulons ce scénario encore une fois, mais avec acks=all. Le délai du courtier 3 est en moyenne de quatre secondes. Le producteur envoie un message avec acks=all, et maintenant il ne reçoit pas de réponse rapide. Le leader attend que le message soit enregistré par toutes les répliques dans l'ISR.
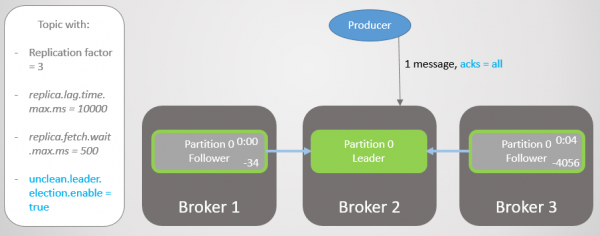
Fig. 13. ISR avec trois répliques. Une fonctionne lentement, ce qui entraîne un délai d'écriture
Après quatre secondes de délai supplémentaire, le courtier 2 envoie un ack. Toutes les répliques sont maintenant complètement à jour.
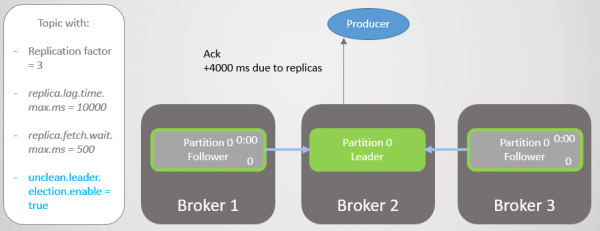
Fig. 14. Toutes les répliques conservent les messages et un ack est envoyé
Le courtier 3 est maintenant encore plus à la traîne et est retiré de l'ISR. Le délai est considérablement réduit, car il ne reste plus de répliques lentes dans l'ISR. Le courtier 2 attend maintenant seulement le courtier 1, qui a un délai moyen de 500 ms.
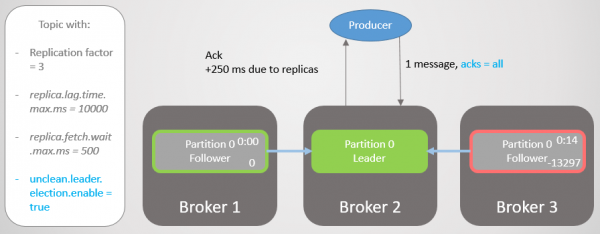
Fig. 15. La réplique sur le courtier 3 est retirée de l'ISR
Ensuite, le courtier 2 tombe, et la direction passe au courtier 1 sans perte de messages.
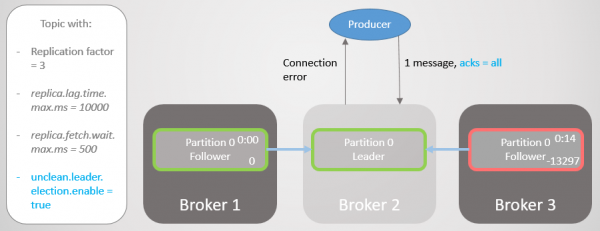
Fig. 16. Le courtier 2 tombe
Le producteur trouve un nouveau leader et commence à lui envoyer des messages. Le délai diminue encore, car l'ISR ne contient qu'une seule réplique ! Donc, l'option acks=all n'ajoute pas de redondance.
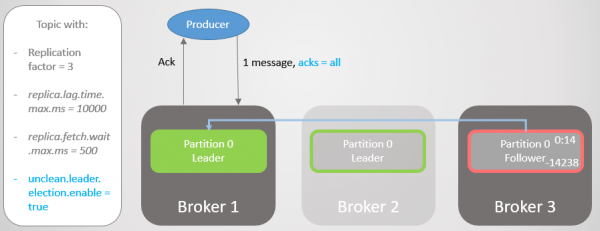
Fig. 17. La réplique sur le courtier 1 prend la direction sans perte de messages
Ensuite, le courtier 1 tombe, et la direction passe au courtier 3 avec une perte de 14238 messages !
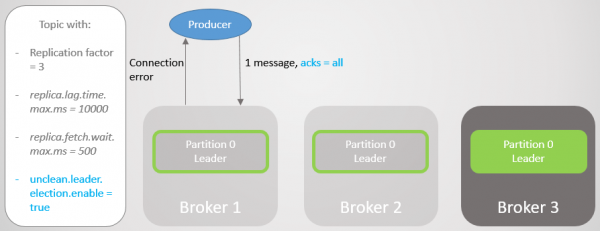
Fig. 18. Le courtier 1 meurt, et le passage de leadership avec le réglage unclean entraîne d'importantes pertes de données
Nous aurions pu ne pas définir l'option unclean.leader.election.enable à la valeur true. Par défaut, elle est égale à faux. Le réglage acks=all avec unclean.leader.election.enable=true assure la disponibilité avec une certaine sécurité des données supplémentaire. Mais, comme vous le voyez, nous pouvons toujours perdre des messages.
Mais que faire si nous voulons augmenter la sécurité des données ? Nous pouvons définir unclean.leader.election.enable = false, mais cela ne nous protègera pas nécessairement de la perte de données. Si le leader échoue durement et emporte des données, alors les messages sont toujours perdus, de plus, l'accessibilité est perdue jusqu'à ce que l'administrateur rétablisse la situation.
Il est préférable de garantir la redondance de tous les messages, sinon de renoncer à l'enregistrement. Alors, d'un point de vue du courtier, la perte de données n'est possible qu'en cas de deux pannes simultanées ou plus.
Acks=all, min.insync.replicas et ISR
Avec la configuration du topic min.insync.replicas nous augmentons le niveau de sécurité des données. Revenons à la dernière partie du scénario précédent, mais cette fois avec min.insync.replicas=2.
Ainsi, le courtier 2 a un leader de réplique, et le suiveur sur le courtier 3 a été retiré de l'ISR.
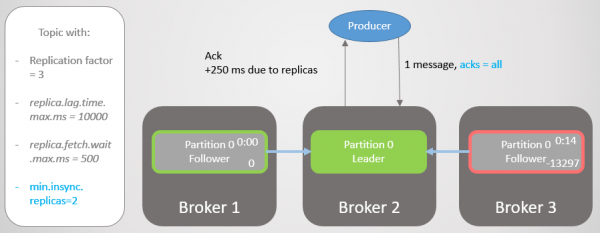
Fig. 19. ISR de deux répliques
Le courtier 2 tombe, et le leadership passe au courtier 1 sans perte de messages. Mais maintenant l'ISR est constitué d'une seule réplique. Cela ne correspond pas au nombre minimum requis pour écrire, et donc le courtier répond à la tentative d'écriture par une erreur. NotEnoughReplicas.
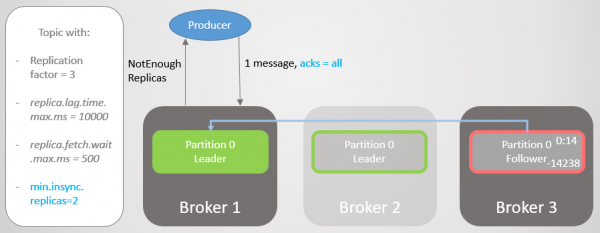
Fig. 20. Le nombre d'ISR est inférieur de un à celui spécifié dans min.insync.replicas
Cette configuration sacrifie l'accessibilité au profit de la cohérence. Avant de confirmer un message, nous garantissons qu'il est enregistré sur au moins deux répliques. Cela donne au producteur une confiance beaucoup plus grande. Ici, la perte de messages n'est possible qu'en cas de panne simultanée de deux répliques pendant une courte période, jusqu'à ce que le message soit répliqué à un suiveur supplémentaire, ce qui est peu probable. Mais si vous êtes super paranoïaque, vous pouvez établir un taux de réplication de 5, et min.insync.replicas pour 3. Ici, trois courtiers devraient tomber simultanément pour perdre l'enregistrement ! Bien sûr, pour une telle fiabilité, vous paierez un délai supplémentaire.
Quand l'accessibilité est nécessaire pour la sécurité des données
Comme dans , parfois l'accessibilité est nécessaire pour la sécurité des données. Vous devez réfléchir à ceci :
- Le publieur peut-il simplement renvoyer une erreur, et le service supérieur ou l'utilisateur peut-il tenter à nouveau plus tard ?
- Un éditeur peut-il conserver le message localement ou dans une base de données pour réessayer plus tard ?
Si la réponse est négative, alors l'optimisation de l'accessibilité améliore la sécurité des données. Vous perdrez moins de données si vous choisissez l'accessibilité au lieu de renoncer à l'enregistrement. Tout se résume à trouver un équilibre, et la solution dépend de la situation spécifique.
Le sens de l'ISR
L'ensemble ISR permet de choisir un équilibre optimal entre la sécurité des données et la latence. Par exemple, assurer la disponibilité en cas de défaillance de la majorité des réplicas, tout en minimisant l'impact des réplicas morts ou lents en termes de latence.
Nous choisissons nous-mêmes la valeur replica.lag.time.max.ms en fonction de nos besoins. En essence, ce paramètre indique quelle latence nous sommes prêts à accepter lors de acks=all. La valeur par défaut est de dix secondes. Si cela est trop long pour vous, vous pouvez la réduire. Cela augmentera la fréquence des changements dans l'ISR, car les suiveurs seront supprimés et ajoutés plus souvent.
Dans RabbitMQ, il s'agit simplement d'un ensemble de miroirs à répliquer. Les miroirs lents introduisent une latence supplémentaire, et les miroirs morts peuvent prendre un temps considérable avant d'être détectés en fonction de la durée de vie des paquets vérifiant la disponibilité de chaque nœud (net tick). L'ISR est une manière intéressante de contourner ces problèmes de latence accrue. Mais nous risquons de perdre la redondance, car l'ISR ne peut se réduire qu'au leader. Pour éviter ce risque, utilisez le paramètre min.insync.replicas.
Garantie de connexion des clients
Dans les paramètres bootstrap.servers du producteur et du consommateur, vous pouvez spécifier plusieurs courtiers pour la connexion des clients. L'idée est que, si un nœud se déconnecte, plusieurs secours restent disponibles, permettant au client d'ouvrir une connexion. Il ne s'agit pas nécessairement des leaders de partitions, mais simplement d'une plateforme pour le démarrage initial. Le client peut les interroger sur le nœud où se trouve le leader de la partition pour la lecture/écriture.
Dans RabbitMQ, les clients peuvent se connecter à n'importe quel nœud, et le routage interne envoie la demande au bon endroit. Cela signifie que vous pouvez installer un équilibreur de charge devant RabbitMQ. Kafka exige que les clients se connectent au nœud où se trouve le leader de la partition correspondante. Dans cette situation, un équilibreur de charge ne peut pas être installé. La liste bootstrap.servers est cruciale pour que les clients puissent accéder aux nœuds requis et les retrouver après une panne.
Architecture de consensus de Kafka
Jusqu'à présent, nous n'avons pas examiné comment le cluster prend connaissance de l'échec d'un courtier et comment un nouveau leader est élu. Pour comprendre comment Kafka fonctionne avec les partitions réseau, il faut d'abord comprendre l'architecture de consensus.
Chaque cluster Kafka est déployé avec un cluster Zookeeper — un service de consensus distribué qui permet au système d'atteindre un consensus sur un état défini avec une priorité sur la cohérence plutôt que sur la disponibilité. L'approbation des opérations de lecture et d'écriture nécessite le consentement de la majorité des nœuds Zookeeper.
Zookeeper stocke l'état du cluster :
- Liste des sujets, partitions, configuration, répliques leaders actuelles, répliques préférées.
- Membres du cluster. Chaque broker envoie un ping au cluster Zookeeper. Si ce dernier ne reçoit pas de ping dans un délai défini, Zookeeper enregistre le broker comme étant indisponible.
- Choix des nœuds principaux et secondaires pour le contrôleur.
Le nœud contrôleur — l'un des brokers Kafka — est responsable de l'élection des leaders de réplicas. Zookeeper envoie des notifications au contrôleur concernant l'adhésion au cluster et les modifications des sujets, et le contrôleur doit agir en fonction de ces modifications.
Prenons par exemple un nouveau sujet avec dix partitions et un coefficient de réplication de 3. Le contrôleur doit choisir un leader pour chaque partition, en essayant d'optimiser la distribution des leaders entre les brokers.
Pour chaque partition, le contrôleur :
- met à jour les informations dans Zookeeper sur l'ISR et le leader ;
- envoie la commande LeaderAndISRCommand à chaque broker qui héberge une réplique de cette partition, en informant les brokers de l'ISR et du leader.
Lorsque le broker avec le leader échoue, Zookeeper envoie une notification au contrôleur, qui choisit un nouveau leader. Encore une fois, le contrôleur met d'abord à jour Zookeeper, puis envoie une commande à chaque broker pour les informer du changement de leadership.
Chaque leader est responsable d'un ensemble d'ISR. La configuration replica.lag.time.max.ms détermine qui en fera partie. Lorsqu'il y a un changement d'ISR, le leader transmet de nouvelles informations à Zookeeper.
Zookeeper est toujours informé de tout changement, afin qu'en cas de défaillance, la direction passe en douceur à un nouveau leader.
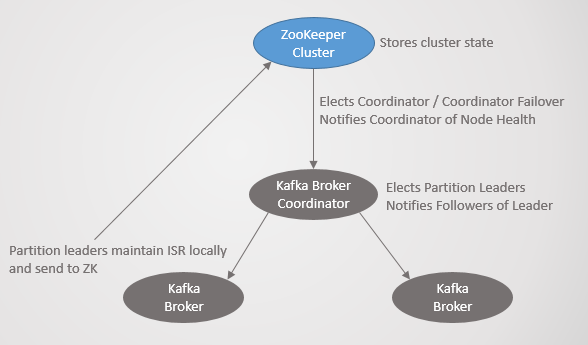
Fig. 21. Consensus Kafka
Protocole de réplication
Comprendre les détails de la réplication aide à mieux saisir les scénarios potentiels de perte de données.
Requêtes de récupération, Log End Offset (LEO) et Highwater Mark (HW)
Nous avons examiné que les suiveurs envoient périodiquement des demandes de récupération (fetch) au leader. L'intervalle par défaut est de 500 ms. Cela diffère de RabbitMQ, où la réplication est initiée par le maître, et non par le miroir de la file d'attente. Le maître pousse les modifications vers les miroirs.
Le leader et tous les suiveurs conservent le décalage de fin de journal (Log End Offset, LEO) et la marque Highwater (HW). La marque LEO conserve le décalage du dernier message dans la réplique locale, tandis que HW conserve le décalage du dernier commit. N'oubliez pas que pour le statut « commit », le message doit être enregistré dans tous les répliques ISR. Cela signifie que LEO est généralement légèrement en avance sur HW.
Lorsque le leader reçoit un message, il l'enregistre localement. Le suiveur fait une demande de récupération, en transmettant son LEO. Ensuite, le leader envoie un paquet de messages en commençant par ce LEO, et transmet également le HW actuel. Lorsque le leader reçoit l'information que toutes les répliques ont enregistré le message avec le décalage donné, il déplace la marque HW. Seul le leader peut déplacer HW, et ainsi tous les suiveurs apprennent la valeur actuelle dans les réponses à leur demande. Cela signifie que les suiveurs peuvent être en retard par rapport au leader, tant sur les messages que sur la connaissance du HW. Les consommateurs reçoivent des messages uniquement jusqu'au HW actuel.
Notez que « persistant » (persisted) signifie enregistré en mémoire, et non sur disque. Pour des raisons de performance, Kafka effectue la synchronisation sur disque à des intervalles spécifiques. RabbitMQ a également un tel intervalle, mais il enverra une confirmation au publicateur uniquement après que le maître et tous les miroirs aient enregistré le message sur disque. Les développeurs de Kafka ont décidé, pour des raisons de performance, d'envoyer un ack dès que le message est enregistré en mémoire. Kafka parie que la redondance compensera le risque de stockage à court terme des messages confirmés uniquement en mémoire.
Panne de leader
Lorsque le leader tombe, Zookeeper avertit le contrôleur, qui choisit une nouvelle réplique leader. Le nouveau leader établit une nouvelle marque HW en fonction de son LEO. Ensuite, les suiveurs reçoivent l'information sur le nouveau leader. En fonction de la version de Kafka, le suiveur choisira l'un des deux scénarios :
- Il tronquera le journal local jusqu'à un HW connu et enverra une demande au nouveau leader pour des messages après cette marque.
- Enverra une demande au leader pour connaître HW au moment de son élection en tant que leader, puis tronquera le journal jusqu'à ce décalage. Il commencera ensuite à effectuer des demandes périodiques d'échantillonnage, en commençant à partir de ce décalage.
Un suiveur peut avoir besoin de tronquer le journal pour les raisons suivantes :
- Lorsqu'une panne de leader se produit, le premier suiveur du jeu d'ISR, enregistré dans Zookeeper, remporte les élections et devient le leader. Tous les suiveurs dans ISR, bien qu'ils soient considérés comme « synchronisés », n'ont pas nécessairement reçu tous les messages de l'ancien leader. Il est tout à fait possible que le suiveur élu n'ait pas la copie la plus à jour. Kafka garantit qu'il n'y a pas de divergence entre les répliques. Ainsi, pour éviter une divergence, chaque suiveur doit tronquer son journal jusqu'à la valeur HW du nouveau leader au moment de son élection. C'est une autre raison pour laquelle la configuration acks=all est si importante pour la cohérence.
- Les messages sont périodiquement écrits sur disque. Si tous les nœuds du cluster échouent simultanément, les disques conserveront des répliques avec des décalages différents. Il est tout à fait possible que lorsque les brokers reviennent sur le réseau, le nouveau leader, qui sera élu, se retrouve derrière ses suiveurs, car il a été enregistré sur disque avant les autres.
Reconnexion au cluster
Lors de la reconnexion au cluster, les répliques sont traitées de la même manière que lors d'une panne de leader : vérification de la réplique du leader et tronquation de leur journal jusqu'à son HW (au moment de l'élection). En comparaison, RabbitMQ considère les nœuds reconnectés comme complètement nouveaux. Dans les deux cas, le broker rejette tout état existant. Si la synchronisation automatique est utilisée, le maître doit répliquer absolument tout le contenu actuel dans un nouveau miroir de manière "et que le monde attende". Pendant cette opération, le maître n'accepte aucune opération de lecture ou d'écriture. Cette approche entraîne des problèmes dans de grandes files d'attente.
Kafka est un log distribué, et en général, il stocke plus de messages qu'une file d'attente RabbitMQ, où les données sont supprimées de la file après leur lecture. Les files d'attente actives doivent rester relativement petites. Mais Kafka est un log avec sa propre politique de conservation, qui peut établir une durée en jours ou en semaines. L'approche avec verrouillage de la file et synchronisation complète est totalement inacceptable pour un log distribué. Au lieu de cela, les suiveurs de Kafka tronquent simplement leur log au leader HW (au moment de son élection) si leur copie dépasse le leader. Dans le cas plus probable où le suiveur est en retard, il commence simplement à faire des requêtes de récupération, en démarrant à partir de son LEO actuel.
Les nouveaux suiveurs ou ceux qui sont réintégrés commencent en dehors de l'ISR et ne participent pas aux validations. Ils travaillent simplement à côté du groupe, recevant des messages aussi rapidement qu'ils le peuvent jusqu'à ce qu'ils rattrapent le leader et entrent dans l'ISR. Il n'y a pas de verrouillage et il n'est pas nécessaire de jeter toutes les données.
Violation de la cohérence
Kafka a plus de composants que RabbitMQ, donc il y a un ensemble de comportements plus complexe lorsque la connectivité dans le cluster est rompue. Mais Kafka a été conçu dès le départ pour les clusters, donc les solutions sont très bien pensées.
Voici quelques scénarios de rupture de la connectivité :
- Scénario 1. Le suiveur ne voit pas le leader, mais voit toujours Zookeeper.
- Scénario 2. Le leader ne voit aucun suiveur, mais voit toujours Zookeeper.
- Scénario 3. Le suiveur voit le leader, mais ne voit pas Zookeeper.
- Scénario 4. Le leader voit des suiveurs, mais ne voit pas Zookeeper.
- Scénario 5. Le suiveur est complètement isolé des autres nœuds Kafka et de Zookeeper.
- Scénario 6. Le leader est complètement isolé des autres nœuds Kafka et de Zookeeper.
- Scénario 7. Le nœud contrôleur de Kafka ne voit aucun autre nœud Kafka.
- Scénario 8. Le contrôleur de Kafka ne voit pas Zookeeper.
Chaque scénario a son propre comportement.
Scénario 1. Le suiveur ne voit pas le leader, mais voit toujours Zookeeper.
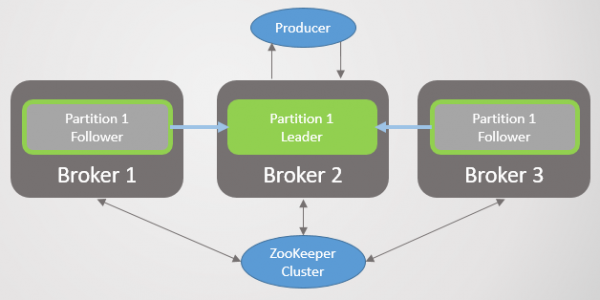
Fig. 22. Scénario 1. ISR de trois répliques.
La rupture de la connectivité isole le broker 3 des brokers 1 et 2, mais pas de Zookeeper. Le broker 3 ne peut plus faire de requêtes de récupération. Après un certain temps. replica.lag.time.max.ms Il est retiré de l'ISR et ne participe pas aux messages de validation. Une fois la connectivité rétablie, il reprendra les requêtes de récupération et rejoindra l'ISR lorsqu'il rattrapera le leader. Zookeeper continuera de recevoir des pings et considérera que le courtier est vivant et en bonne santé.
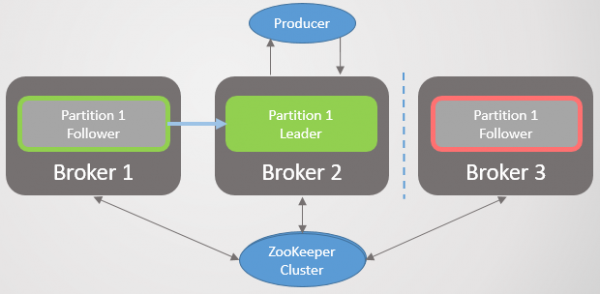
Fig. 23. Scénario 1. Le courtier est retiré de l'ISR s'il n'a pas reçu de requête de récupération pendant l'intervalle replica.lag.time.max.ms.
Il n'y a pas de séparation logique (split-brain) ou de mise en pause du nœud, comme dans RabbitMQ. Au lieu de cela, la redondance est réduite.
Scénario 2. Le leader ne voit aucun suiveur, mais voit toujours Zookeeper.
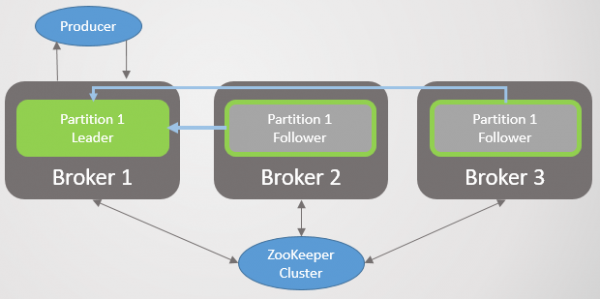
Fig. 24. Scénario 2. Le leader et deux suiveurs.
Une rupture de la connectivité réseau sépare le leader des suiveurs, mais le courtier voit toujours Zookeeper. Comme dans le premier scénario, l'ISR se réduit, mais cette fois seulement au leader, car tous les suiveurs cessent d'envoyer des requêtes de récupération. Encore une fois, il n'y a pas de séparation logique. Au lieu de cela, il y a une perte de redondance pour les nouveaux messages, jusqu'à ce que la connectivité soit rétablie. Zookeeper continue de recevoir des pings et considère que le courtier est vivant et en bonne santé.
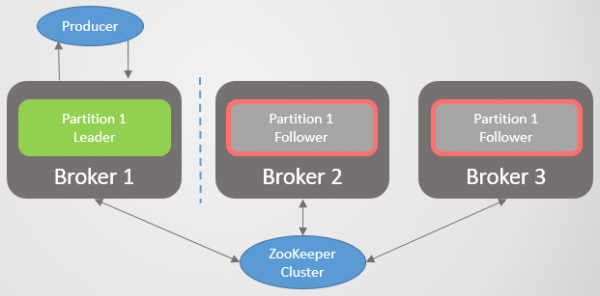
Fig. 25. Scénario 2. L'ISR s'est réduit uniquement au leader.
Scénario 3. Le suiveur voit le leader, mais ne voit pas Zookeeper.
Le suiveur est séparé de Zookeeper, mais pas du courtier avec le leader. Par conséquent, le suiveur continue d'effectuer des requêtes de récupération et est membre de l'ISR. Zookeeper ne reçoit plus de pings et enregistre la chute du courtier, mais comme c'est seulement un suiveur, il n'y a pas de conséquences après la restauration.
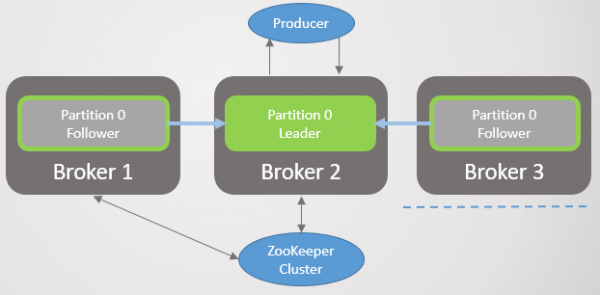
Fig. 26. Scénario 3. Le suiveur continue d'envoyer des requêtes de récupération au leader.
Scénario 4. Le leader voit des suiveurs, mais ne voit pas Zookeeper.
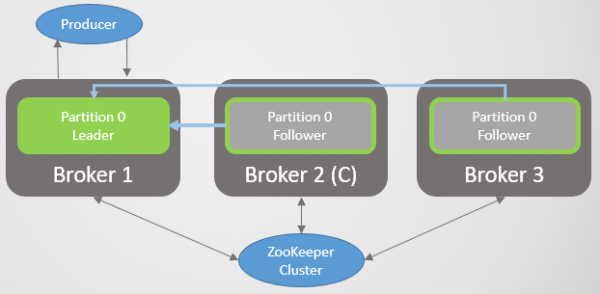
Fig. 27. Scénario 4. Le leader et deux suiveurs.
Le leader est séparé de Zookeeper, mais pas des courtiers avec les suiveurs.
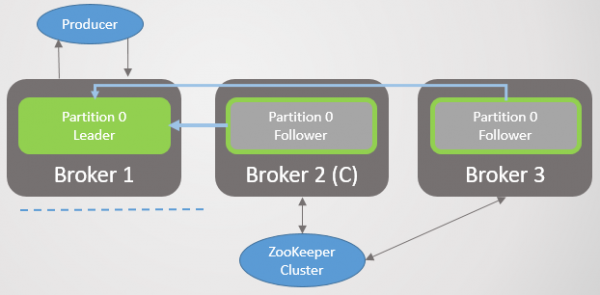
Fig. 28. Scénario 4. Le leader est isolé de Zookeeper.
Après un certain temps, Zookeeper enregistrera la chute du courtier et en informera le contrôleur. Celui-ci choisira un nouveau leader parmi les suiveurs. Cependant, le leader d'origine continuera de penser qu'il est le leader et continuera de recevoir des enregistrements avec acks=1. Les suiveurs ne lui envoient plus de requêtes de récupération, donc il les considérera comme morts et essaiera de réduire l'ISR à lui-même. Mais comme il n'a pas de connexion à Zookeeper, il ne pourra pas le faire et à ce moment-là, il renoncera à recevoir davantage d'enregistrements.
Messages acks=all Ils ne recevront pas de confirmation, car d'abord l'ISR inclut toutes les répliques, et les messages ne parviennent pas jusqu'à elles. Lorsque le leader initial essaiera de les retirer de l'ISR, il ne pourra pas le faire et cessera complètement de recevoir des messages.
Les clients remarquent bientôt le changement de leader et commencent à envoyer des enregistrements au nouveau serveur. Une fois que le réseau est rétabli, le leader d'origine constate qu'il n'est plus le leader et réduit son journal à la valeur HW que le nouveau leader avait au moment de la panne, afin d'éviter des incohérences de journaux. Tous les enregistrements du leader d'origine non répliqués au nouveau leader seront perdus. Cela signifie que les messages non confirmés par le leader initial pendant ces quelques secondes où deux leaders étaient actifs seront perdus.
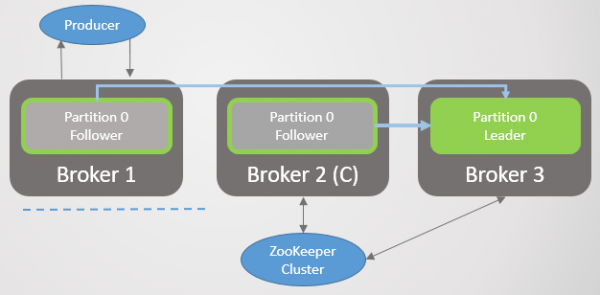
Fig. 29. Scénario 4. Le leader sur le courtier 1 devient follower après la restauration du réseau
Scénario 5. Follower complètement isolé des autres nœuds Kafka et de Zookeeper
Le follower est complètement isolé des autres nœuds Kafka et de Zookeeper. Il est simplement retiré de l'ISR tant que le réseau n'est pas rétabli, puis rattrape les autres.

Fig. 30. Scénario 5. Le follower isolé est retiré de l'ISR
Scénario 6. Le leader est complètement isolé des autres nœuds Kafka et de Zookeeper
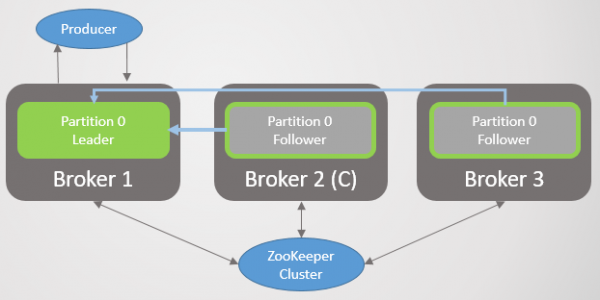
Fig. 31. Scénario 6. Leader et deux followers
Le leader est complètement isolé de ses followers, du contrôleur et de Zookeeper. Pendant une courte période, il continuera à recevoir des enregistrements avec acks=1.
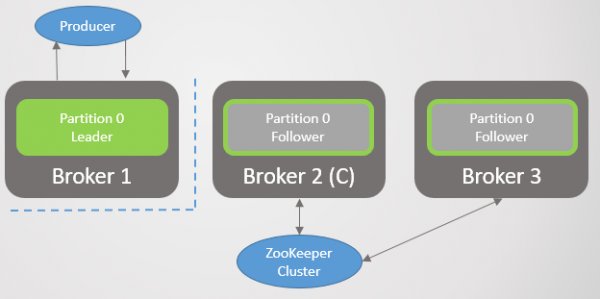
Fig. 32. Scénario 6. Isolement du leader par rapport aux autres nœuds Kafka et Zookeeper
Ne recevant pas de requêtes après replica.lag.time.max.ms, il essaiera de réduire l'ISR à lui-même, mais ne pourra pas le faire car il n'y a pas de connexion avec Zookeeper, alors il cessera de recevoir des enregistrements.
Pendant ce temps, Zookeeper marquera le courtier isolé comme mort, et le contrôleur choisira un nouveau leader.
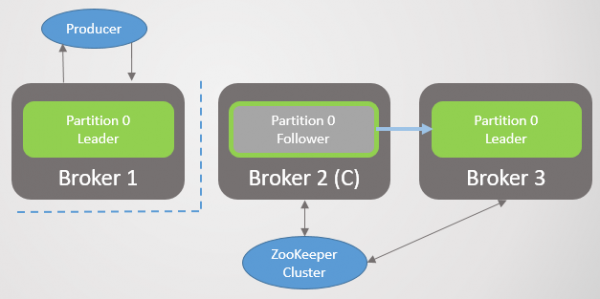
Fig. 33. Scénario 6. Deux leaders
Le leader initial peut recevoir des enregistrements pendant quelques secondes, mais cesse ensuite de recevoir des messages. Les clients se mettent à jour toutes les 60 secondes avec les dernières métadonnées. Ils seront informés du changement de leader et commenceront à envoyer des enregistrements au nouveau leader.
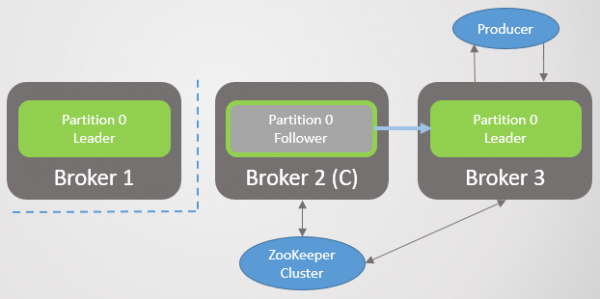
Fig. 34. Scénario 6. Les producteurs basculent vers le nouveau leader
Toutes les entrées confirmées faites par le leader d'origine depuis la perte de connectivité seront perdues. Une fois le réseau rétabli, le leader d'origine découvrira via Zookeeper qu'il n'est plus le leader. Il tronquera ensuite son journal jusqu'à HW du nouveau leader au moment de son élection et commencera à envoyer des requêtes en tant que suiveur.
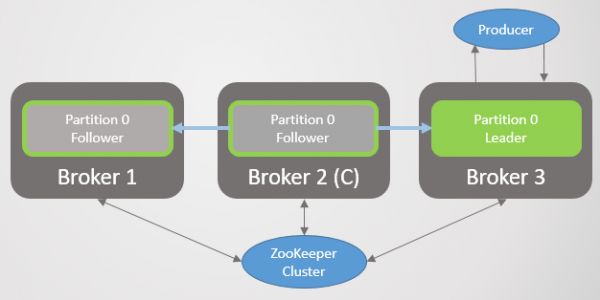
Fig. 35. Scénario 6. Le leader d'origine devient un suiveur après la restauration de la connectivité du réseau
Dans cette situation, une séparation logique peut être observée pendant une courte période, mais seulement si acks=1 et min.insync.replicas elle est aussi 1. La séparation logique se termine automatiquement soit après la restauration du réseau, lorsque le leader d'origine comprend qu'il n'est plus le leader, soit lorsque tous les clients réalisent que le leader a changé et commencent à écrire au nouveau leader — selon ce qui se produit en premier. Dans tous les cas, il y aura perte de certains messages, mais seulement avec acks=1.
Il existe une autre variante de ce scénario, où juste avant la séparation du réseau, les suiveurs sont en retard, et le leader a réduit l'ISR à lui-même. Ensuite, il est isolé en raison de la perte de connectivité. Un nouveau leader est élu, mais le leader initial continue de recevoir des entrées, même acks=all, car il n'y a personne d'autre dans l'ISR à part lui. Ces entrées seront perdues après la restauration du réseau. La seule façon d'éviter ce scénario est min.insync.replicas = 2.
Scénario 7. Le nœud contrôleur Kafka ne voit pas un autre nœud Kafka
En général, après la perte de connexion avec un nœud Kafka, le contrôleur ne pourra pas lui transmettre d'informations concernant le changement de leader. Dans le pire des cas, cela entraînera une séparation logique à court terme, comme dans le scénario 6. Le plus souvent, le courtier ne se présentera tout simplement pas comme candidat à la direction en cas de défaillance du dernier.
Scénario 8. Le contrôleur Kafka ne voit pas Zookeeper
Le contrôleur Zookeeper en panne ne recevra pas de ping et choisira un nouveau nœud Kafka comme contrôleur. Le contrôleur d'origine peut continuer à se présenter comme tel, mais il ne reçoit pas de notifications de Zookeeper, donc il n'aura aucune tâche à accomplir. Une fois le réseau rétabli, il comprendra qu'il n'est plus contrôleur, mais qu'il est devenu un nœud Kafka ordinaire.
Conclusions des scénarios
Nous constatons que la perte de connectivité des followers ne conduit pas à une perte de messages, mais réduit simplement temporairement la redondance jusqu'à ce que le réseau se rétablisse. Cela peut bien sûr entraîner une perte de données si un ou plusieurs nœuds sont perdus.
Si, en raison de la perte de connectivité, le leader est séparé de Zookeeper, cela peut entraîner une perte de messages avec acks=1. L'absence de connexion avec Zookeeper provoque une division logique temporaire avec deux leaders. Ce problème est résolu par le paramètre acks=all.
Paramètre min.insync.replicas en deux répliques ou plus garantit des garanties supplémentaires que de tels scénarios à court terme ne mèneront pas à une perte de messages, comme dans le scénario 6.
Résumé sur la perte de messages
Énumérons tous les moyens par lesquels des données peuvent être perdues dans Kafka :
- Tout échec du leader, si les messages ont été confirmés à l'aide de acks=1
- Toute transition de leadership non propre, c'est-à-dire vers un follower en dehors de l'ISR, même avec acks=all
- L'isolement du leader par rapport à Zookeeper, si les messages ont été confirmés à l'aide de acks=1
- Isolement complet du leader, qui a déjà réduit le groupe ISR à lui-même. Tous les messages seront perdus, même acks=all. Cela n'est vrai que si min.insync.replicas=1.
- Défaillances simultanées de tous les nœuds de la partition. Étant donné que les messages sont confirmés à partir de la mémoire, certains peuvent ne pas encore avoir été écrits sur le disque. Après le redémarrage des serveurs, certains messages peuvent manquer.
Les transitions de leadership non propres peuvent être évitées en les interdisant ou en garantissant une redondance d'au moins deux. La configuration la plus robuste est une combinaison de acks=all et min.insync.replicas plus de 1.
Comparaison directe de la fiabilité de RabbitMQ et Kafka
Pour garantir la fiabilité et une haute disponibilité, les deux plateformes mettent en œuvre un système de réplication primaire et secondaire. Cependant, RabbitMQ a un talon d'Achille. Lorsqu'elles se reconnectent après une défaillance, les nœuds abandonnent leurs données et la synchronisation est bloquée. Ce double coup remet en question la durabilité des grandes files d'attente dans RabbitMQ. Vous devrez vous Contenterez soit d'une réduction de la redondance, soit de longs blocages. La réduction de la redondance augmente le risque de perte massive de données. Mais si les files d'attente sont petites, la redondance avec de courtes périodes d'indisponibilité (quelques secondes) peut être gérée par des tentatives de connexion répétées.
Kafka n'a pas ce problème. Elle rejette uniquement les données au point de divergence entre le leader et le follower. Toutes les données communes sont conservées. De plus, la réplication ne bloque pas le système. Le leader continue d'accepter des enregistrements pendant que le nouveau follower le rattrape, ce qui rend l'ajout ou le rétablissement d'un cluster trivial pour les DevOps. Bien sûr, des problèmes subsistent, tels que la bande passante réseau lors de la réplication. Si plusieurs followers sont ajoutés simultanément, il est possible de rencontrer une limite de bande passante.
RabbitMQ surpasse Kafka en termes de fiabilité en cas de panne simultanée de plusieurs serveurs dans le cluster. Comme nous l'avons déjà mentionné, RabbitMQ envoie une confirmation au publisher uniquement après l'enregistrement du message sur le disque chez le maître et tous les miroirs. Mais cela ajoute un délai supplémentaire pour deux raisons :
- fsync toutes les quelques centaines de millisecondes
- Une défaillance du miroir ne peut être détectée qu'après l'expiration du temps de vie des paquets qui vérifient l'accessibilité de chaque nœud (net tick). Si le miroir est en retard ou est tombé, cela ajoute du délai.
Kafka parie sur le fait que si un message est stocké sur plusieurs nœuds, les messages peuvent être confirmés dès qu'ils sont en mémoire. Cela entraîne un risque de perte de messages de tout type (même acks=all, min.insync.replicas=2) en cas de défaillance simultanée.
Dans l'ensemble, Kafka démontre une performance supérieure et est initialement conçu pour des clusters. Le nombre de followers peut être augmenté jusqu'à 11 si nécessaire pour la fiabilité. Un coefficient de réplication de 5 et un nombre minimal de réplicas en état synchronisé min.insync.replicas=3 rendra la perte de message un événement très rare. Si votre infrastructure peut garantir ce coefficient de réplication et ce niveau de redondance, vous pouvez choisir cette option.
La mise en cluster de RabbitMQ est idéale pour de petites files d'attente. Mais même de petites files peuvent rapidement croître avec un fort trafic. Une fois que les files deviennent grandes, il faudra faire un choix difficile entre disponibilité et fiabilité. La mise en cluster de RabbitMQ est la mieux adaptée pour des situations moins typiques, où les avantages de flexibilité de RabbitMQ l'emportent sur les inconvénients de sa mise en cluster.
L'une des solutions à la vulnérabilité de RabbitMQ concernant les grandes files d'attente consiste à les diviser en plusieurs petites. Si l'on ne nécessite pas un ordonnancement complet de l'ensemble de la file d'attente, mais seulement des messages appropriés (par exemple, des messages d'un client spécifique), ou même rien du tout, cette option est acceptable : consultez mon projet. pour diviser la file d'attente (le projet est encore à un stade précoce).
Enfin, n'oubliez pas qu'il existe plusieurs bugs dans les mécanismes de mise en cluster et de réplication tant chez RabbitMQ que chez Kafka. Avec le temps, les systèmes sont devenus plus matures et stables, mais aucun message ne sera jamais à 100 % protégé contre la perte ! De plus, des pannes massives surviennent dans les centres de données !
Si j'ai manqué quelque chose, commis une erreur ou si vous n'êtes pas d'accord avec l'un des points, n'hésitez pas à laisser un commentaire ou à me contacter.
On me demande souvent : « Que choisir, Kafka ou RabbitMQ ? », « Quelle plateforme est meilleure ? ». La vérité est que cela dépend vraiment de votre situation, de votre expérience actuelle, etc. Je n'ose pas donner mon opinion, car il serait trop simpliste de recommander une plateforme unique pour tous les cas d'utilisation et limitations possibles. J'ai écrit cette série d'articles pour que vous puissiez vous faire votre propre opinion.
Je tiens à dire que les deux systèmes sont des leaders dans ce domaine. Peut-être que je suis un peu biaisé, car à travers mes expériences de projets, j'ai tendance à apprécier des éléments tels que l'ordonnancement garanti des messages et la fiabilité.
Je vois d'autres technologies qui manquent de cette fiabilité et de cet ordonnancement garanti, puis je regarde RabbitMQ et Kafka — et je comprends la valeur incroyable de ces deux systèmes.
Source : habr.com
