

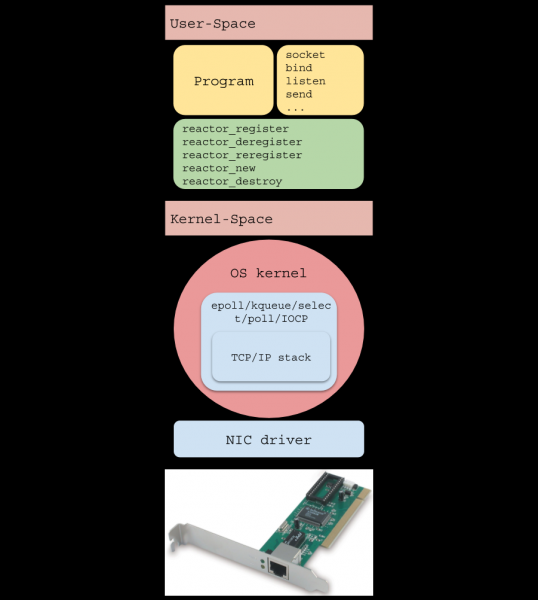
Introduction
(monothread ) — c'est un modèle pour écrire des logiciels très chargés, utilisé dans de nombreuses solutions populaires :
- …
Dans cet article, nous examinerons les coulisses du réacteur I/O et le principe de son fonctionnement, nous écrirons une implémentation en moins de 200 lignes de code et ferons en sorte qu'un simple serveur HTTP puisse traiter plus de 40 millions de requêtes par minute.
Préface
- Cet article est écrit dans le but d'aider à comprendre le fonctionnement du réacteur I/O, et donc de réaliser les risques associés à son utilisation.
- Pour comprendre cet article, il est nécessaire de connaître les bases et d'avoir une petite expérience de développement d'applications réseau.
- Tout le code est écrit en C conformément à laattention : PDF long) pour Linux et est disponible sur .
Pourquoi est-ce nécessaire ?
Avec la montée en popularité d'Internet, les serveurs web ont eu besoin de traiter de nombreuses connexions simultanément, ce qui a conduit à deux approches : I/O bloquant avec un grand nombre de threads du système d'exploitation et I/O non-bloquant combiné à un système de notification d'événements, aussi appelé « sélecteur système » (///etc).
La première approche consistait à créer un nouveau thread du système d'exploitation pour chaque connexion entrante. Son inconvénient est une faible évolutivité : le système d'exploitation doit effectuer de nombreux et . Ce sont des opérations coûteuses et peuvent entraîner un manque de RAM libre avec un nombre important de connexions.
Une version modifiée alloue (piscine de threads), ce qui empêche le système de terminer l'exécution de manière inattendue, mais introduit un nouveau problème : si à ce moment le pool de threads bloque des opérations de lecture prolongées, d'autres sockets qui sont déjà prêts à recevoir des données ne pourront pas le faire.
La deuxième approche utilise (sélecteur système), fourni par le système d'exploitation. Cet article traite du type de sélecteur système le plus couramment rencontré, basé sur les notifications d'événements sur la disponibilité pour les opérations I/O, plutôt que sur . Un exemple simplifié de son utilisation peut être présenté dans le diagramme de flux suivant :
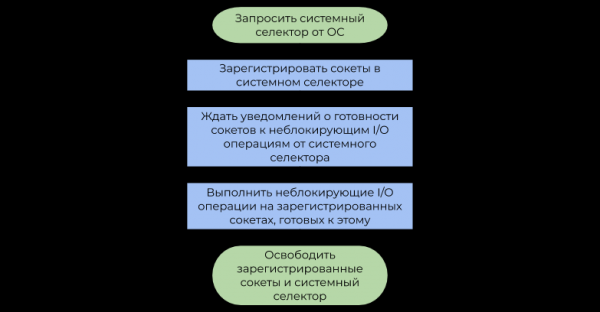
La différence entre ces approches est la suivante :
- Les opérations I/O bloquantes suspendent le flux utilisateur jusqu'à ce qu'AWS fasse de même et construise un business autour, et lorsque les clients exigeront littéralement la même chose. Cependant, il faut fournir des efforts pour obliger Google à soutenir quelque chose., tant que le système d'exploitation n'est pas les paquets en flux de bytes (, réception de données) ou qu'il n'y a pas assez d'espace dans les tampons internes d'enregistrement pour un envoi ultérieur via (envoi de données).
- Le sélecteur système informe le programme après un certain temps que le système d'exploitation a défragmenté les paquets IP (TCP, réception de données) ou qu'il y a suffisamment d'espace dans les tampons internes d'enregistrement déjà disponible (envoi de données). déjà En résumé, réserver le flux du système d'exploitation pour chaque I/O est un gaspillage de puissance de calcul, car en réalité, les flux ne sont pas occupés par un travail utile (d'où le terme
"interruption logicielle" Le modèle I/O du réacteur
Le réacteur I/O agit comme une couche entre le sélecteur système et le code utilisateur. Son principe de fonctionnement est décrit dans le diagramme suivant :
Rappelons que l'événement est une notification qu'un socket particulier est en mesure d'exécuter une opération I/O non bloquante.
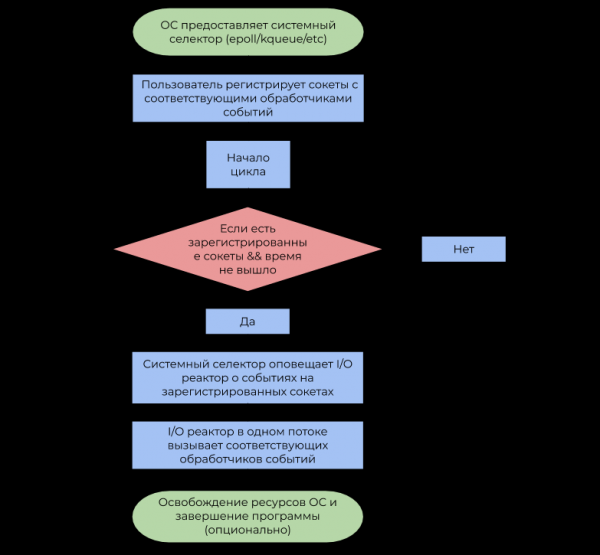
- Le gestionnaire d'événements est une fonction appelée par le réacteur I/O lors de la réception d'un événement, qui effectue ensuite une opération I/O non bloquante.
- Il est important de noter que le réacteur I/O est par définition monophasé, mais rien n'empêche d'utiliser ce concept dans un environnement multithread en respectant 1 thread : 1 réacteur, optimisant ainsi tous les cœurs CPU.
Nous mettrons l'interface publique dans le fichier
Mise en œuvre
reactor.h reactor.c . , et l'implémentation dans Afficher les déclarations dans reactor.h
Afficher les annonces dans reactor.h
typedef struct reactor Reactor;

/*
 * Pointeur vers une fonction qui sera appelée par le réacteur I/O lors de la réception
 * d'un événement du sélecteur système.
 */
typedef void (*Callback)(void *arg, int fd, uint32_t events);

/*
 * Retourne `NULL` en cas d'erreur, un pointeur non-`NULL` vers `Reactor` dans
 * le cas contraire.
 */
Reactor *reactor_new(void);

/*
 * Libère le sélecteur système, tous les sockets enregistrés à ce moment
 * et le réacteur I/O lui-même.
 *
 * Les fonctions suivantes retournent -1 en cas d'erreur, 0 en cas de succès.
 */
int reactor_destroy(Reactor *reactor);

int reactor_register(const Reactor *reactor, int fd, uint32_t interest,
                     Callback callback, void *callback_arg);
int reactor_deregister(const Reactor *reactor, int fd);
int reactor_reregister(const Reactor *reactor, int fd, uint32_t interest,
                       Callback callback, void *callback_arg);

/*
 * Lance la boucle d'événements avec un délai `timeout`.
 *
 * Cette fonction transférera le contrôle au code appelant si le temps imparti est écoulé
 * ou/et s'il n'y a pas de sockets enregistrés.
 */
int reactor_run(const Reactor *reactor, time_t timeout);
La structure du réacteur I/O se compose de sélecteur et , qui associe chaque socket à CallbackData (structure du gestionnaire d'événements et l'argument utilisateur pour cela).
Afficher Reactor et CallbackData
struct reactor {
    int epoll_fd;
    GHashTable *table; // (int, CallbackData)
};

typedef struct {
    Callback callback;
    void *arg;
} CallbackData;
Notez que nous avons utilisé la capacité de traitement avec par pointeur. Dans , et l'implémentation dans nous déclarons la structure reactor, et dans se composera des déclarations suivantes : nous la définissons, empêchant ainsi l'utilisateur de modifier explicitement ses champs. C'est l'un des modèles , s'inscrivant de manière concise dans la sémantique C.
Fonctions reactor_register, reactor_deregister et reactor_reregister met à jour la liste des sockets d'intérêt et des gestionnaires d'événements correspondants dans le sélecteur système et la table de hachage.
Afficher les fonctions d'enregistrement
#define REACTOR_CTL(reactor, op, fd, interest)
    if (epoll_ctl(reactor->epoll_fd, op, fd,
                  &(struct epoll_event){.events = interest,
                                        .data = {.fd = fd}}) == -1) {
        perror("epoll_ctl");
        return -1;
    }

int reactor_register(const Reactor *reactor, int fd, uint32_t interest,
                     Callback callback, void *callback_arg) {
    REACTOR_CTL(reactor, EPOLL_CTL_ADD, fd, interest)
    g_hash_table_insert(reactor->table, int_in_heap(fd),
                        callback_data_new(callback, callback_arg));
    return 0;
}

int reactor_deregister(const Reactor *reactor, int fd) {
    REACTOR_CTL(reactor, EPOLL_CTL_DEL, fd, 0)
    g_hash_table_remove(reactor->table, &fd);
    return 0;
}

int reactor_reregister(const Reactor *reactor, int fd, uint32_t interest,
                       Callback callback, void *callback_arg) {
    REACTOR_CTL(reactor, EPOLL_CTL_MOD, fd, interest)
    g_hash_table_insert(reactor->table, int_in_heap(fd),
                        callback_data_new(callback, callback_arg));
    return 0;
}
Après que le réacteur I/O ait intercepté un événement avec le descripteur fd, il appelle le gestionnaire d'événements correspondant, auquel il transmet fd, d'événements générés et un pointeur utilisateur vers void.
Afficher la fonction reactor_run()
int reactor_run(const Reactor *reactor, time_t timeout) {
    int result;
    struct epoll_event *events;
    if ((events = calloc(MAX_EVENTS, sizeof(*events))) == NULL)
        abort();

    time_t start = time(NULL);

    while (true) {
        time_t passed = time(NULL) - start;
        int nfds =
            epoll_wait(reactor->epoll_fd, events, MAX_EVENTS, timeout - passed);

        switch (nfds) {
        // Erreur
        case -1:
            perror("epoll_wait");
            result = -1;
            goto cleanup;
        // Temps écoulé
        case 0:
            result = 0;
            goto cleanup;
        // Opération réussie
        default:
            // Appeler les gestionnaires d'événements
            for (int i = 0; i table, &fd);
                callback->callback(callback->arg, fd, events[i].events);
            }
        }
    }

cleanup:
    free(events);
    return result;
}
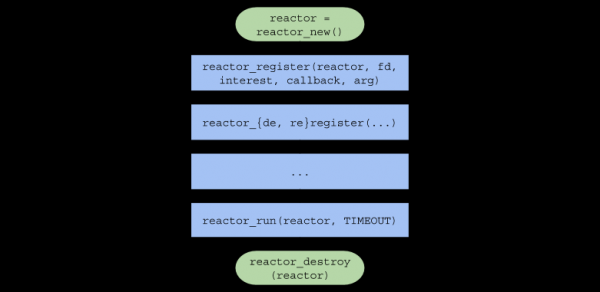
En résumé, la chaîne d'appels de fonctions dans le code utilisateur prendra la forme suivante :
Serveur monocore
Pour tester le réacteur I/O sous une forte charge, nous allons écrire un simple serveur web HTTP qui répondra avec une image à toute requête.
Bref aperçu du protocole HTTP
— c'est un protocole , principalement utilisé pour l'interaction entre le serveur et le navigateur.
HTTP peut facilement être utilisé au-dessus protocole , en envoyant et en recevant des messages selon un format défini .
Format de la requête
CRLF
CRLF
CRLF
CRLF CRLFCRLF— c'est une séquence de deux caractères :retn, séparant la première ligne de la requête, les en-têtes et les données.<КОМАНДА>— l'une desCONNECT,SUPPRIMER,GET,HEAD,OPTIONS,PATCH,POST,PUT,TRACE. Le navigateur enverra au serveur la commandeGET, signifiant "Envoie-moi le contenu du fichier".<URI>— . Par exemple, si URI =/index.html, alors le client demande la page d'accueil du site.<ВЕРСИЯ HTTP>— version du protocole HTTP au formatHTTP/X.Y. La version la plus souvent utilisée aujourd'hui estHTTP/1.1.:, envoyée au serveur pour une analyse ultérieure.— données requises par le serveur pour exécuter l'opération. Souvent, il s'agit simplement de ou de tout autre format.
Format de la réponse
 CRLF
CRLF
CRLF
CRLF CRLF
— c'est un nombre représentant le résultat d'une opération. Notre serveur retournera toujours un statut 200 (opération réussie).<ОПИСАНИЕ СТАТУСА>— une représentation sous forme de chaîne du code de statut. Pour le code de statut 200, c'estOK.Content-Length(taille du fichier) etContent-Type: text/html(type de données retournées).— les données demandées par l'utilisateur. Dans notre cas, c'est le chemin vers l'image dans .
Le fichier (serveur à un seul thread) inclut le fichier , qui contient les prototypes de fonctions suivants :
Afficher les prototypes de fonctions dans common.h
/*
 * Обработчик событий, который вызовется после того, как сокет будет
 * готов принять новое соединение.
 */
static void on_accept(void *arg, int fd, uint32_t events);

/*
 * Обработчик событий, который вызовется после того, как сокет будет
 * готов отправить HTTP ответ.
 */
static void on_send(void *arg, int fd, uint32_t events);

/*
 * Обработчик событий, который вызовется после того, как сокет будет
 * готов принять часть HTTP запроса.
 */
static void on_recv(void *arg, int fd, uint32_t events);

/*
 * Переводит входящее соединение в неблокирующий режим.
 */
static void set_nonblocking(int fd);

/*
 * Печатает переданные аргументы в stderr и выходит из процесса с
 * кодом `EXIT_FAILURE`.
 */
static noreturn void fail(const char *format, ...);

/*
 * Возвращает файловый дескриптор сокета, способного принимать новые
 * TCP соединения.
 */
static int new_server(bool reuse_port);
Il décrit également le macro fonctionnel SAFE_CALL() et définit la fonction fail(). Le macro compare la valeur d'une expression avec une erreur, et si la condition est vérifiée, il appelle la fonction fail():
#define SAFE_CALL(call, error)
    do {
        if ((call) == error) {
            fail("%s", #call);
        }
    } while (false)
Fonction fail() imprime les arguments passés dans le terminal (comme ) et termine le programme avec le code EXIT_FAILURE:
static noreturn void fail(const char *format, ...) {
    va_list args;
    va_start(args, format);
    vfprintf(stderr, format, args);
    va_end(args);
    fprintf(stderr, ": %sn", strerror(errno));
    exit(EXIT_FAILURE);
}
Fonction new_server() retourne un descripteur de fichier pour le socket du «serveur», créé par des appels système , et et capable d'accepter des connexions entrantes en mode non-bloquant.
Afficher la fonction new_server()
static int new_server(bool reuse_port) {
    int fd;
    SAFE_CALL((fd = socket(AF_INET, SOCK_STREAM | SOCK_NONBLOCK, IPPROTO_TCP)),
              -1);

    if (reuse_port) {
        SAFE_CALL(
            setsockopt(fd, SOL_SOCKET, SO_REUSEPORT, &(int){1}, sizeof(int)),
            -1);
    }

    struct sockaddr_in addr = {.sin_family = AF_INET,
                               .sin_port = htons(SERVER_PORT),
                               .sin_addr = {.s_addr = inet_addr(SERVER_IPV4)},
                               .sin_zero = {0}};

    SAFE_CALL(bind(fd, (struct sockaddr *)&addr, sizeof(addr)), -1);
    SAFE_CALL(listen(fd, SERVER_BACKLOG), -1);
    return fd;
}- Notez que le socket est initialement créé en mode non-bloquant avec le drapeau
SOCK_NONBLOCK, de sorte que dans la fonctionon_accept()(lire la suite) l'appel systèmeaccept()ne bloque pas l'exécution du thread. - Si
reuse_portest égal àtrue, cette fonction configurera le socket avec l'option à travers , pour utiliser le même port dans un environnement multithreadé (voir la section «Serveur multithreadé»).
Le gestionnaire d'événements on_accept() est appelé après que le système d'exploitation ait généré un événement EPOLLIN, signifiant dans ce cas qu'une nouvelle connexion peut être acceptée. on_accept() accepte une nouvelle connexion, la bascule en mode non-bloquant et l'enregistre avec le gestionnaire d'événements on_recv() dans le réacteur I/O.
Afficher la fonction on_accept()
static void on_accept(void *arg, int fd, uint32_t events) {
    int incoming_conn;
    SAFE_CALL((incoming_conn = accept(fd, NULL, NULL)), -1);
    set_nonblocking(incoming_conn);
    SAFE_CALL(reactor_register(reactor, incoming_conn, EPOLLIN, on_recv,
                               request_buffer_new()),
              -1);
}
Le gestionnaire d'événements on_recv() est appelé après que le système d'exploitation ait généré un événement EPOLLIN, dans ce cas signifiant que la connexion enregistrée on_accept(), est prête à accepter des données.
on_recv() lit les données de la connexion jusqu'à ce que la requête HTTP soit entièrement reçue, puis elle enregistre le gestionnaire on_send() pour envoyer la réponse HTTP. Si le client interrompt la connexion, le socket est désenregistré et fermé par .
Afficher la fonction on_recv()
static void on_recv(void *arg, int fd, uint32_t events) {
    RequestBuffer *buffer = arg;

    // Recevoir les données d'entrée jusqu'à ce que recv retourne 0 ou une erreur
    ssize_t nread;
    while ((nread = recv(fd, buffer->data + buffer->size,
                         REQUEST_BUFFER_CAPACITY - buffer->size, 0)) > 0)
        buffer->size += nread;

    // Le client a interrompu la connexion
    if (nread == 0) {
        SAFE_CALL(reactor_deregister(reactor, fd), -1);
        SAFE_CALL(close(fd), -1);
        request_buffer_destroy(buffer);
        return;
    }

    // read a retourné une erreur, différente de l'erreur qui bloquerait l'appel
    // du thread
    if (errno != EAGAIN && errno != EWOULDBLOCK) {
        request_buffer_destroy(buffer);
        fail("read");
    }

    // Une requête HTTP complète a été reçue du client. Maintenant, nous enregistrons le gestionnaire
    // d'événements pour envoyer des données
    if (request_buffer_is_complete(buffer)) {
        request_buffer_clear(buffer);
        SAFE_CALL(reactor_reregister(reactor, fd, EPOLLOUT, on_send, buffer),
                  -1);
    }
}
Le gestionnaire d'événements on_send() est appelé après que le système d'exploitation ait généré un événement EPOLLOUT, signifiant que la connexion enregistrée on_recv(), est prête à envoyer des données. Cette fonction envoie une réponse HTTP contenant du HTML avec une image au client, puis change à nouveau le gestionnaire d'événements vers on_recv().
Afficher la fonction on_send()
static void on_send(void *arg, int fd, uint32_t events) {
    const char *content = "<img "
 "src="https://habrastorage.org/webt/oh/wl/23/"
                          "ohwl23va3b-dioerobq_mbx4xaw.jpeg">";
    char response[1024];
    sprintf(response,
            "HTTP/1.1 200 OK" CRLF "Content-Length: %zd" CRLF "Content-Type: "
            "text/html" DOUBLE_CRLF "%s",
            strlen(content), content);

    SAFE_CALL(send(fd, response, strlen(response), 0), -1);
    SAFE_CALL(reactor_reregister(reactor, fd, EPOLLIN, on_recv, arg), -1);
}
Et enfin, dans le fichier http_server.c, dans la fonction main() nous créons un réacteur I/O à l'aide de reactor_new(), créons un socket serveur et l'enregistrons, exécutons le réacteur avec reactor_run() pendant une minute, puis libérons les ressources et sortons du programme.
Afficher http_server.c
#include "reactor.h"

static Reactor *reactor;

#include "common.h"

int main(void) {
    SAFE_CALL((reactor = reactor_new()), NULL);
    SAFE_CALL(
        reactor_register(reactor, new_server(false), EPOLLIN, on_accept, NULL),
        -1);
    SAFE_CALL(reactor_run(reactor, SERVER_TIMEOUT_MILLIS), -1);
    SAFE_CALL(reactor_destroy(reactor), -1);
}
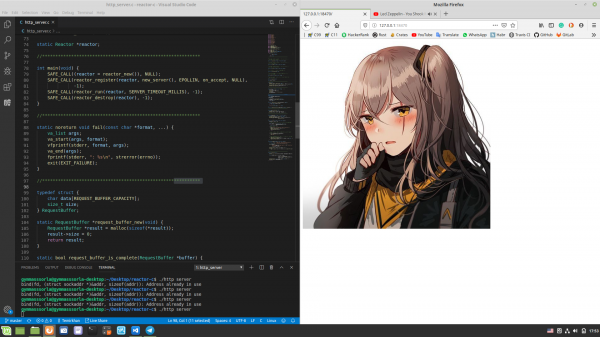
Vérifions que tout fonctionne comme prévu. Nous compilons (chmod a+x compile.sh && ./compile.sh à la racine du projet) et exécutons le serveur fait maison, ouvrons dans le navigateur et observons ce que nous attendions :
Mesure de performance
Afficher les spécifications de ma machine
$ screenfetch
 MMMMMMMMMMMMMMMMMMMMMMMMMmds+.        OS: Mint 19.1 tessa
 MMm----::-://oymNMd+`     Kernel: x86_64 Linux 4.15.0-20-generic
 MMd      /++                -sNMd:    Uptime: 2h 34m
 MMNso/`  dMM    `.::-. .-::.` .hMN:   Packages: 2217
 ddddMMh  dMM   :hNMNMNhNMNMNh: `NMm   Shell: bash 4.4.20
     NMm  dMM  .NMN/-+MMM+-/NMN` dMM   Resolution: 1920x1080
     NMm  dMM  -MMm  `MMM   dMM. dMM   DE: Cinnamon 4.0.10
     NMm  dMM  -MMm  `MMM   dMM. dMM   WM: Muffin
     NMm  dMM  .mmd  `mmm   yMM. dMM   WM Theme: Mint-Y-Dark (Mint-Y)
     NMm  dMM`  ..`   ...   ydm. dMM   GTK Theme: Mint-Y [GTK2/3]
     hMM- +MMd/-------...-:sdds  dMM   Icon Theme: Mint-Y
     -NMm- :hNMNNNmdddddddddy/`  dMM   Font: Noto Sans 9
      -dMNs-``-::::-------.``    dMM   CPU: Intel Core i7-6700 @ 8x 4GHz [52.0°C]
       `/dMNmy+/:-------------:/yMMM   GPU: NV136
          ./ydNMMMMMMMMMMMMMMMMMMMMM   RAM: 2544MiB / 7926MiB
             .MMMMMMMMMMMMMMMMMMM
Mesurons la performance d'un serveur à thread unique. Ouvrons deux terminaux : dans l'un, nous ferons tourner ./http_server, dans l'autre — . Après une minute, les statistiques suivantes apparaîtront dans le deuxième terminal :
$ wrk -c100 -d1m -t8 http://127.0.0.1:18470 -H "Host: 127.0.0.1:18470" -H "Accept-Language: en-US,en;q=0.5" -H "Connection: keep-alive"
Running 1m test @ http://127.0.0.1:18470
  8 threads and 100 connections
  Thread Stats   Avg      Stdev     Max   +/- Stdev
    Latency   493.52us   76.70us  17.31ms   89.57%
    Req/Sec    24.37k     1.81k   29.34k    68.13%
  11657769 requests in 1.00m, 1.60GB read
Requests/sec: 193974.70
Transfer/sec:     27.19MB
Notre serveur à thread unique a réussi à traiter plus de 11 millions de requêtes par minute, provenant de 100 connexions. Un bon résultat, mais peut-on l'améliorer ?
Serveur multithread
Comme mentionné précédemment, le réacteur I/O peut être créé dans des threads séparés, utilisant ainsi tous les cœurs du CPU. Appliquons cette approche pratiquement :
Afficher http_server_multithreaded.c
#include "reactor.h"

static Reactor *reactor;
#pragma omp threadprivate(reactor)

#include "common.h"

int main(void) {
#pragma omp parallel
    {
        SAFE_CALL((reactor = reactor_new()), NULL);
        SAFE_CALL(reactor_register(reactor, new_server(true), EPOLLIN,
                                   on_accept, NULL),
                  -1);
        SAFE_CALL(reactor_run(reactor, SERVER_TIMEOUT_MILLIS), -1);
        SAFE_CALL(reactor_destroy(reactor), -1);
    }
}
Maintenant, chaque thread réacteur :
static Reactor *reactor;
#pragma omp threadprivate(reactor)
Notez que l'argument de la fonction new_server() est true. Cela signifie que nous attribuons au socket du serveur l'option , afin de l'utiliser dans un environnement multithread. Vous pouvez en lire plus à propos de cela .
Deuxième essai
Mesurons maintenant la performance du serveur multithread :
$ wrk -c100 -d1m -t8 http://127.0.0.1:18470 -H "Host: 127.0.0.1:18470" -H "Accept-Language: en-US,en;q=0.5" -H "Connection: keep-alive"
Running 1m test @ http://127.0.0.1:18470
  8 threads and 100 connections
  Thread Stats   Avg      Stdev     Max   +/- Stdev
    Latency     1.14ms    2.53ms  40.73ms   89.98%
    Req/Sec    79.98k    18.07k  154.64k    78.65%
  38208400 requests in 1.00m, 5.23GB read
Requests/sec: 635876.41
Transfer/sec:     89.14MB
Le nombre de requêtes traitées en 1 minute a augmenté d'environ 3,28 fois ! Mais il a manqué environ deux millions pour atteindre un chiffre rond, essayons de corriger cela.
D'abord, examinons les statistiques générées :
$ sudo perf stat -B -e task-clock,context-switches,cpu-migrations,page-faults,cycles,instructions,branches,branch-misses,cache-misses ./http_server_multithreaded

 Statistiques des compteurs de performance pour './http_server_multithreaded':

     242446,314933      horloge de tâche (msec)         #    4,000 CPU utilisés
         1 813 074      changements de contexte          #    0,007 M/sec
             4 689      migrations de CPU            #    0,019 K/sec
               254      fautes de page               #    0,001 K/sec
   895 324 830 170      cycles                    #    3,693 GHz
   621 378 066 808      instructions              #    0,69  insn par cycle
   119 926 709 370      branches                  #  494,653 M/sec
     3 227 095 669      échecs de branche             #    2,69 % de toutes les branches
           808 664      échecs de cache

60,604330670 secondes de temps écoulé, compilation avec -march=native, , augmentation du nombre de hits dans , augmentation MAX_EVENTS et utilisation de EPOLLET n'ont pas donné de gains significatifs en performance. Mais que se passe-t-il si l'on augmente le nombre de connexions simultanées ?
Statistiques à 352 connexions simultanées :
$ wrk -c352 -d1m -t8 http://127.0.0.1:18470 -H "Host: 127.0.0.1:18470" -H "Accept-Language: en-US,en;q=0.5" -H "Connection: keep-alive"
Exécution d'un test de 1m @ http://127.0.0.1:18470
  8 threads et 352 connexions
  Statistiques des threads   Moyenne      Écart-type     Max   +/− Écart-type
    Latence     2.12ms    3.79ms  68.23ms   87.49%
    Req/Sec    83.78k    12.69k  169.81k    83.59%
  40006142 requêtes en 1,00m, 5.48GB lus
Requêtes/sec : 665789.26
Transfert/sec :     93.34MB
Le résultat souhaité a été obtenu, ainsi qu'un graphique intéressant montrant la dépendance du nombre de requêtes traitées en 1 minute par rapport au nombre de connexions :
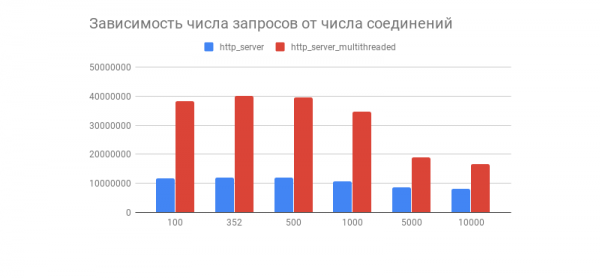
On voit qu'après quelques centaines de connexions, le nombre de requêtes traitées par les deux serveurs chute brusquement (cela est plus marqué dans la version multithread). Cela pourrait-il être lié à la mise en œuvre de la pile TCP/IP de Linux ? N'hésitez pas à partager vos réflexions sur ce comportement du graphique et les optimisations des versions multithread et unithread dans les commentaires.
Comment dans les commentaires, ce test de performance ne montre pas le comportement du réacteur I/O sous de vraies charges, car le serveur interagit presque toujours avec la base de données, génère des logs, utilise la cryptographie avec etc., ce qui rend la charge hétérogène (dynamique). Des tests avec des composants tiers seront menés dans l'article sur le réacteur I/O.
Inconvénients du réacteur I/O
Il faut comprendre que le réacteur I/O n'est pas exempt d'inconvénients, à savoir :
- Utiliser le réacteur I/O dans un environnement multithread est un peu plus compliqué, car il faut gérer manuellement les threads.
- La pratique montre que dans la plupart des cas, la charge n'est pas homogène, ce qui peut entraîner un flux qui sera ignoré pendant qu'un autre sera surchargé de travail.
- Si un gestionnaire d'événements bloque un flux, le sélecteur système sera également bloqué, ce qui peut entraîner des bogues difficiles à déceler.
Ces problèmes sont résolus par , qui comprend souvent un planificateur qui répartit uniformément la charge dans le pool de threads, et dispose également d'une API plus conviviale. Nous en parlerons plus tard dans un autre article de ma part.
Conclusion
Ainsi, notre voyage de la théorie au profilage se termine ici.
Il ne faut pas s'arrêter là, car il existe de nombreuses autres approches tout aussi intéressantes pour écrire des logiciels réseau avec divers niveaux de commodité et de rapidité. Voici quelques liens intéressants à mon avis.
À bientôt !
Projets intéressants
- C
Que lire d'autre ?
Source : habr.com
