

Il y a quelques années, Kubernetes dans le blog officiel de GitHub. Depuis, il est devenu la technologie standard pour le déploiement de services. Kubernetes gère désormais une partie importante des services internes et publics. À mesure que nos clusters ont augmenté et que les exigences de performance se sont intensifiées, nous avons commencé à remarquer que dans certains services sur Kubernetes, des délais apparaissaient sporadiquement, qui ne pouvaient pas être expliqués par la charge de l'application elle-même.
En gros, dans les applications, il se produit comme un délai réseau aléatoire de 100 ms ou plus, ce qui entraîne des délais d'attente ou des tentatives de nouvelle connexion. On s'attendait à ce que les services puissent répondre aux requêtes beaucoup plus rapidement que 100 ms. Mais c'est impossible si la connexion elle-même prend autant de temps. Nous avons également constaté que les requêtes MySQL, qui auraient dû prendre des millisecondes, étaient effectivement traitées en millisecondes, mais du point de vue de l'application qui demande, la réponse prenait 100 ms ou plus.
Il est rapidement devenu clair que le problème ne se produisait qu'en se connectant à un nœud Kubernetes, même si l'appel provenait de l'extérieur de Kubernetes. Le plus simple pour reproduire le problème était de le tester , qui est exécuté depuis n'importe quel hôte interne, teste le service Kubernetes sur un port spécifique, et enregistre sporadiquement une grande latence. Dans cet article, nous examinerons comment nous avons pu retracer la cause de ce problème.
Éliminer la complexité excessive dans la chaîne de défaillance
En reproduisant le même exemple, nous avons voulu concentrer notre attention sur le problème et éliminer les couches de complexité superflues. À l'origine, il y avait trop d'éléments dans le flux entre Vegeta et les pods sur Kubernetes. Pour identifier un problème réseau plus profond, il fallait en exclure certains.
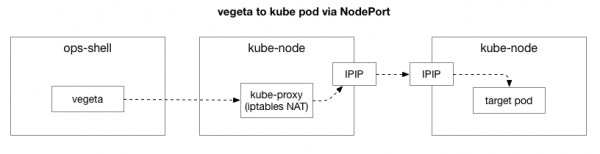
Le client (Vegeta) établit une connexion TCP avec n'importe quel nœud du cluster. Kubernetes fonctionne comme un réseau superposé (au-dessus du réseau existant du centre de données), utilisant , c'est-à-dire encapsule les paquets IP du réseau superposé dans des paquets IP du centre de données. Lors de la connexion au premier nœud, une traduction d'adresses réseau (NAT) avec suivi de l'état pour convertir l'adresse IP et le port du nœud Kubernetes en adresse IP et port dans le réseau de superposition (en particulier, le pod avec l'application). Pour les paquets reçus, une séquence inversée est effectuée. C'est un système complexe avec de nombreux états et de nombreux éléments qui se mettent constamment à jour et changent lors du déploiement et du déplacement des services.
Utilitaire tcpdump dans le test Vegeta, il y a un délai lors de l'établissement de la connexion TCP (entre SYN et SYN-ACK). Pour supprimer cette complexité excessive, on peut utiliser hping3 pour des « pings » simples avec des paquets SYN. Nous vérifions s'il y a un délai dans le paquet de réponse, puis nous réinitialisons la connexion. Nous pouvons filtrer les données en n'incluant que les paquets de plus de 100 ms, ce qui nous donne une version plus simple de la reproduction du problème qu'un test complet au niveau réseau 7 dans Vegeta. Voici les « pings » du nœud Kubernetes utilisant TCP SYN/SYN-ACK sur le « port nœud » du service (30927) avec un intervalle de 10 ms, filtrés par les réponses les plus lentes :
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -S -p 30927 -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1485 win=29200 rtt=127.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1486 win=29200 rtt=117.0 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1487 win=29200 rtt=106.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1488 win=29200 rtt=104.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5024 win=29200 rtt=109.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5231 win=29200 rtt=109.2 ms
On peut immédiatement faire la première observation. Par les numéros de séquence et les timings, il est évident que ce ne sont pas des congestions occasionnelles. Le délai s’accumule souvent, et est finalement traité.
Ensuite, nous voulons déterminer quels composants pourraient être impliqués dans la congestion. Pourrait-il s'agir de certaines des centaines de règles iptables dans le NAT ? Ou y a-t-il des problèmes avec le tunneling IPIP dans le réseau ? Un moyen de vérifier cela est d'examiner chaque étape du système, en l'excluant. Que se passe-t-il si nous supprimons le NAT et la logique du pare-feu, en ne conservant que la partie IPIP :
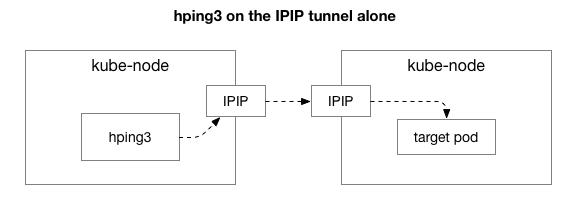
Heureusement, Linux permet d'accéder facilement directement à la couche de superposition IP, si la machine se trouve dans le même réseau :
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7346 win=0 rtt=127.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7347 win=0 rtt=117.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7348 win=0 rtt=107.2 ms
D'après les résultats, le problème persiste ! Cela exclut iptables et NAT. Donc, le problème vient de TCP ? Vérifions le ping ICMP ordinaire :
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=28 ip=10.125.20.64 ttl=64 id=42594 icmp_seq=104 rtt=110.0 ms
len=28 ip=10.125.20.64 ttl=64 id=49448 icmp_seq=4022 rtt=141.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49449 icmp_seq=4023 rtt=131.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49450 icmp_seq=4024 rtt=121.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49451 icmp_seq=4025 rtt=111.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49452 icmp_seq=4026 rtt=101.1 ms
len=28 ip=10.125.20.64 ttl=64 id=50023 icmp_seq=4343 rtt=126.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50024 icmp_seq=4344 rtt=116.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50025 icmp_seq=4345 rtt=106.8 ms
len=28 ip=10.125.20.64 ttl=64 id=59727 icmp_seq=9836 rtt=106.1 ms
Les résultats montrent que le problème n'a pas disparu. Peut-être s'agit-il d'un tunnel IPIP ? Simplifions encore le test :
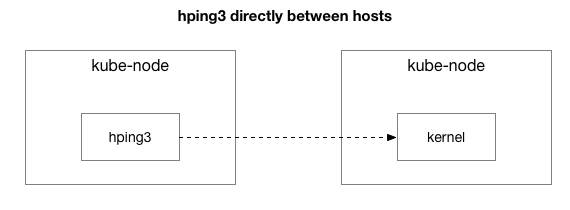
Tous les paquets sont-ils envoyés entre ces deux hôtes ?
theojulienne@kube-node-client ~ $ sudo hping3 172.16.47.27 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 id=41127 icmp_seq=12564 rtt=140.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41128 icmp_seq=12565 rtt=130.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41129 icmp_seq=12566 rtt=120.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41130 icmp_seq=12567 rtt=110.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41131 icmp_seq=12568 rtt=100.7 ms
len=46 ip=172.16.47.27 ttl=61 id=9062 icmp_seq=31443 rtt=134.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9063 icmp_seq=31444 rtt=124.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9064 icmp_seq=31445 rtt=114.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9065 icmp_seq=31446 rtt=104.2 ms
Nous avons simplifié la situation à deux nœuds Kubernetes s'échangeant n'importe quel paquet, même un ping ICMP. Ils ressentent toujours un délai si l'hôte cible est « mauvais » (certains plus que d'autres).
Maintenant, une dernière question : pourquoi le délai ne se produit-il qu'avec les serveurs kube-node ? Et cela se produit-il lorsque kube-node est l'expéditeur ou le destinataire ? Heureusement, il est également assez facile de le découvrir en envoyant un paquet depuis un hôte en dehors de Kubernetes, mais avec le même « mauvais » destinataire connu. Comme nous le voyons, le problème n'a pas disparu :
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=312 win=0 rtt=108.5 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=5903 win=0 rtt=119.4 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=6227 win=0 rtt=139.9 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=7929 win=0 rtt=131.2 ms
Exécutons ensuite les mêmes requêtes depuis le kube-node source précédent vers l'hôte externe (ce qui exclut l'hôte source, car le ping inclut à la fois le composant RX et TX) :
theojulienne@kube-node-client ~ $ sudo hping3 172.16.33.44 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
 ^C
 --- 172.16.33.44 hping statistique ---
 22352 paquets transmis, 22350 paquets reçus, 1% de perte de paquets
 round-trip min/avg/max = 0.2/7.6/1010.6 ms
Après avoir analysé les captures de paquets avec latence, nous avons obtenu des informations supplémentaires. En particulier, le serveur (en bas) constate ce délai, tandis que le destinataire (en haut) ne le voit pas — voir la colonne Delta (en secondes) :
De plus, si nous regardons la différence dans l'ordre des paquets TCP et ICMP (par numéro de séquence) du côté du destinataire, les paquets ICMP arrivent toujours dans le même ordre dans lequel ils ont été envoyés, mais avec des timings différents. En revanche, les paquets TCP sont parfois mélangés, et certains restent bloqués. En particulier, si nous examinons les ports des paquets SYN, du côté de l'expéditeur, ils arrivent dans l'ordre, mais pas du côté du destinataire.
Il y a une nuance dans la façon dont des serveurs modernes (comme dans notre centre de données) traitent les paquets contenant du TCP ou de l'ICMP. Lorsqu'un paquet arrive, l'adaptateur réseau le "hache par connexion", c'est-à-dire qu'il tente de répartir les connexions sur plusieurs files d'attente et d'envoyer chaque file d'attente sur un cœur de processeur distinct. Pour le TCP, ce hachage inclut à la fois l'adresse IP source et destination ainsi que le port. En d'autres termes, chaque connexion est (potentiellement) hachée différemment. Pour l'ICMP, seuls les adresses IP sont hachées, car il n'y a pas de ports.
Une autre observation nouvelle : durant cette période, nous observons des latences ICMP sur toutes les communications entre deux hôtes, alors qu’il n’y a pas de latence pour le TCP. Cela nous indique que la cause est probablement liée au hachage des files d'attente RX : il est presque certain que le goulet d'étranglement se produit lors du traitement des paquets RX, et non lors de l'envoi des réponses.
Cela élimine l'envoi des paquets comme cause possible. Nous savons maintenant que le problème de traitement des paquets se situe du côté de la réception sur certains serveurs kube-node.
Enquête sur le traitement des paquets dans le noyau Linux
Pour comprendre pourquoi le problème se produit chez le destinataire sur certains serveurs kube-node, examinons comment le noyau Linux traite les paquets.
En revenant à l'implémentation traditionnelle la plus simple, la carte réseau reçoit un paquet et envoie au noyau Linux, indiquant qu'il y a un paquet à traiter. Le noyau interrompt les autres tâches, passe au contexte du gestionnaire d'interruptions, traite le paquet, puis revient aux tâches en cours.
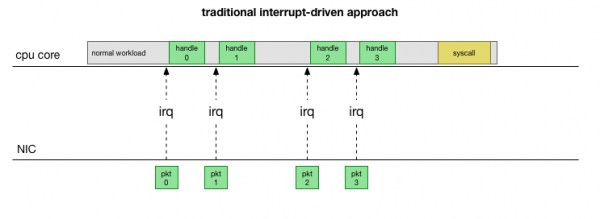
Ce changement de contexte se produit lentement : il est possible que le délai ait été imperceptible sur les cartes réseau 10 Mbit/s dans les années 90, mais sur les cartes modernes 10G avec une capacité maximale de 15 millions de paquets par seconde, chaque noyau d'un petit serveur à huit cœurs peut être interrompu des millions de fois par seconde.
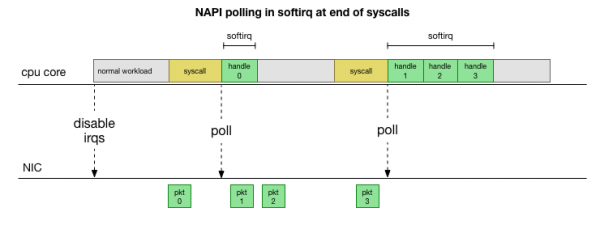
Pour ne pas avoir à traiter constamment les interruptions, Linux a ajouté il y a de nombreuses années : une API réseau que tous les pilotes modernes utilisent pour améliorer les performances à haute vitesse. À faible vitesse, le noyau continue de recevoir des interruptions de la carte réseau de l'ancienne manière. Une fois qu'un nombre suffisant de paquets dépasse le seuil, le noyau désactive les interruptions et commence à interroger l'adaptateur réseau pour récupérer les paquets par tranches. Le traitement s'effectue dans un softirq, c'est-à-dire dans après les appels système et les interruptions matérielles, lorsque le noyau (contrairement à l'espace utilisateur) est déjà en cours d'exécution.
C'est beaucoup plus rapide, mais cela pose un autre problème. Si le nombre de paquets est trop élevé, tout le temps est consacré au traitement des paquets de la carte réseau, et les processus de l'espace utilisateur ne parviennent pas à vider ces files d'attente (lecture à partir des connexions TCP, etc.). Finalement, les files d'attente se remplissent et nous commençons à perdre des paquets. Pour tenter de trouver un équilibre, le noyau établit un budget pour le nombre maximum de paquets traités dans le contexte du softirq. Dès que ce budget est dépassé, un thread distinct ksoftirqd (vous en verrez un dans ps pour chaque noyau), qui traite ces softirq en dehors du chemin normal d'appel système/interruption. Ce thread est planifié par le planificateur de processus standard, qui essaie de répartir les ressources de manière équitable.
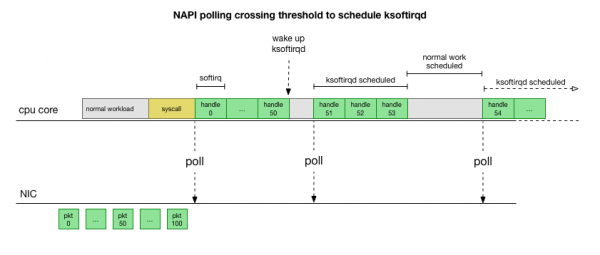
En étudiant comment le noyau traite les paquets, on peut constater qu'il existe une certaine probabilité de congestion. Si les appels softirq arrivent moins fréquemment, les paquets devront attendre un certain temps pour être traités dans la file RX de la carte réseau. Cela peut être dû à une tâche bloquant le noyau du processeur, ou quelque chose d'autre empêche le noyau de lancer le softirq.
Nous réduisons le traitement à celui du noyau ou de la méthode.
Les délais softirq ne sont pour l'instant qu'une hypothèse. Mais cela a du sens, et nous savons que nous observons quelque chose de très similaire. Donc, la prochaine étape est de confirmer cette théorie. Et si elle est confirmée, il faudra trouver la cause de ces délais.
Revenons à nos paquets lents :
len=46 ip=172.16.53.32 ttl=61 id=29573 icmp_seq=1953 rtt=99.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29574 icmp_seq=1954 rtt=89.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29575 icmp_seq=1955 rtt=79.2 ms
len=46 ip=172.16.53.32 ttl=61 id=29576 icmp_seq=1956 rtt=69.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29577 icmp_seq=1957 rtt=59.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29790 icmp_seq=2070 rtt=75.7 ms
len=46 ip=172.16.53.32 ttl=61 id=29791 icmp_seq=2071 rtt=65.6 ms
len=46 ip=172.16.53.32 ttl=61 id=29792 icmp_seq=2072 rtt=55.5 ms
Comme mentionné précédemment, ces paquets ICMP sont mis en cache dans une seule file d'attente NIC RX et traités par un seul cœur CPU. Si nous voulons comprendre le fonctionnement de Linux, il est utile de savoir où (sur quel cœur CPU) et comment (softirq, ksoftirqd) ces paquets sont traités afin de retracer le processus.
Il est maintenant temps d'utiliser des outils qui permettent de suivre en temps réel le fonctionnement du noyau Linux. Ici, nous avons utilisé . Cet ensemble d'outils permet d'écrire de petits programmes en C qui interceptent des fonctions arbitraires dans le noyau et mettent en mémoire tampon les événements dans un programme Python en espace utilisateur, qui peut les traiter et vous renvoyer le résultat. Les hooks pour des fonctions arbitraires dans le noyau sont une affaire complexe, mais l'utilitaire est conçu pour une sécurité maximale et destiné à suivre précisément ce genre de problème de production, qui est difficile à reproduire dans un environnement de test ou de développement.
Le plan ici est simple : nous savons que le noyau traite ces ping ICMP, donc nous allons placer un hook sur la fonction noyau , qui reçoit un paquet ICMP « echo request » entrant et initie l'envoi d'une réponse ICMP « echo response ». Nous pouvons identifier le paquet par l'augmentation du numéro icmp_seq, qui montre hping3 ci-dessus.
Code semble compliqué, mais il n'est pas aussi effrayant qu'il y paraît. La fonction icmp_echo transmet struct sk_buff *skb: c'est le paquet avec la demande « echo request ». Nous pouvons le suivre, extraire la séquence echo.sequence (qui correspond à icmp_seq de hping3 supérieur), et l'envoyer dans l'espace utilisateur. Il est également pratique de capturer le nom actuel du processus/id. Voici les résultats que nous voyons directement pendant le traitement des paquets par le noyau :
TGID    PID     NOM DU PROCESSUS    ICMP_SEQ
0       0       swapper/11      770
0       0       swapper/11      771
0       0       swapper/11      772
0       0       swapper/11      773
0       0       swapper/11      774
20041   20086   prometheus      775
0       0       swapper/11      776
0       0       swapper/11      777
0       0       swapper/11      778
4512    4542   spokes-report-s  779
Il convient de noter ici que dans ce contexte softirq les processus ayant effectué des appels système apparaîtront comme «processus», bien qu'en réalité, c'est le noyau qui gère en toute sécurité les paquets dans le contexte du noyau.
Avec cet outil, nous pouvons établir un lien entre des processus spécifiques et des paquets spécifiques qui présentent des retards dans hping3. Nous réalisons une simple grep capture sur cette capture pour certaines valeurs icmp_seq. Les paquets correspondants aux valeurs icmp_seq ci-dessus ont été notés avec leur RTT, que nous avons observé ci-dessus (les valeurs RTT attendues des paquets que nous avons filtrés pour des valeurs RTT inférieures à 50 ms sont indiquées entre parenthèses) :
TGID    PID     NOM DU PROCESSUS    ICMP_SEQ ** RTT
--
10137   10436   cadvisor        1951
10137   10436   cadvisor        1952
76      76      ksoftirqd/11    1953 ** 99ms
76      76      ksoftirqd/11    1954 ** 89ms
76      76      ksoftirqd/11    1955 ** 79ms
76      76      ksoftirqd/11    1956 ** 69ms
76      76      ksoftirqd/11    1957 ** 59ms
76      76      ksoftirqd/11    1958 ** (49ms)
76      76      ksoftirqd/11    1959 ** (39ms)
76      76      ksoftirqd/11    1960 ** (29ms)
76      76      ksoftirqd/11    1961 ** (19ms)
76      76      ksoftirqd/11    1962 ** (9ms)
--
10137   10436   cadvisor        2068
10137   10436   cadvisor        2069
76      76      ksoftirqd/11    2070 ** 75ms
76      76      ksoftirqd/11    2071 ** 65ms
76      76      ksoftirqd/11    2072 ** 55ms
76      76      ksoftirqd/11    2073 ** (45ms)
76      76      ksoftirqd/11    2074 ** (35ms)
76      76      ksoftirqd/11    2075 ** (25ms)
76      76      ksoftirqd/11    2076 ** (15ms)
76      76      ksoftirqd/11    2077 ** (5ms)
Les résultats nous renseignent sur plusieurs aspects. Tout d'abord, tous ces paquets sont gérés par le contexte ksoftirqd/11. Cela signifie que pour cette paire de machines particulière, les paquets ICMP étaient hachés sur le noyau 11 du côté récepteur. Nous voyons également qu'à chaque engorgement, il y a des paquets traités dans le contexte de l'appel système cadvisor. Ensuite, ksoftirqd prend la relève et traite la file d'attente accumulée : c'est le nombre de paquets qui s'est accumulé après cadvisor.
Le fait que juste avant cela, un cadvisorfonctionne toujours, implique son implication dans le problème. Ironiquement, la fonction est d'analyser l'utilisation des ressources et les caractéristiques de performance des conteneurs en cours d'exécution, et non de provoquer ce problème de performance.
Comme pour d'autres aspects du fonctionnement des conteneurs, tout cela est un outil extrêmement avancé, dont on peut s'attendre à ce qu'il entraîne des problèmes de performance dans certaines circonstances imprévues.
Que fait cadvisor qui ralentit la file d'attente des paquets ?
Nous avons maintenant une compréhension assez claire de la façon dont le plantage se produit, quel processus le provoque et sur quel CPU. Nous voyons que, en raison d'un verrouillage strict, le noyau Linux ne parvient pas à planifier à temps. ksoftirqd. Et nous voyons que les paquets sont traités dans le contexte cadvisor. Il est logique de supposer que cadvisor lance un syscall lent, après quoi tous les paquets accumulés pendant ce temps sont traités :
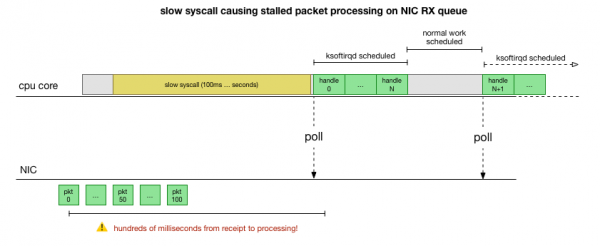
C'est une théorie, mais comment la vérifier ? Ce que nous pouvons faire, c'est suivre le fonctionnement du noyau CPU tout au long de ce processus, trouver le point où le budget de paquets est dépassé et ksoftirqd est appelé, puis regarder un peu avant — ce qui fonctionnait sur le noyau CPU juste avant ce moment. C'est comme une radiographie du CPU toutes les quelques millisecondes. Il ressemblera à peu près à cela :
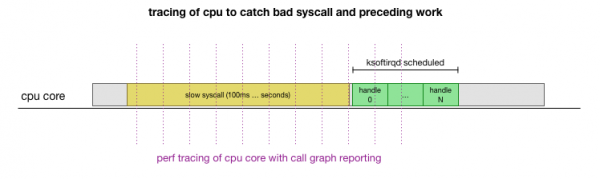
Heureusement, tout cela peut être réalisé avec des outils existants. Par exemple, vérifie périodiquement un noyau CPU donné et peut générer un graphique des appels de système en cours d'exécution, y compris l'espace utilisateur et le noyau Linux. Nous pouvons prendre cet enregistrement et le traiter avec un petit fork du programme de Brendan Gregg, qui conserve l'ordre de la trace de la pile. Nous pouvons conserver des traces de la pile sur une seule ligne toutes les 1 ms, puis extraire et conserver un échantillon pendant 100 millisecondes avant que la trace ne soit enregistrée. ksoftirqd:
# record 999 times a second, or every 1ms with some offset so not to align exactly with timers
 sudo perf record -C 11 -g -F 999
 # take that recording and make a simpler stack trace.
 sudo perf script 2>/dev/null | ./FlameGraph/stackcollapse-perf-ordered.pl | grep ksoftir -B 100
Voici les résultats :
(des centaines de traces qui se ressemblent)
cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_iter cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;ixgbe_poll;ixgbe_clean_rx_irq;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;bond_handle_frame;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;ipip_tunnel_xmit;ip_tunnel_xmit;iptunnel_xmit;ip_local_out;dst_output;__ip_local_out;nf_hook_slow;nf_iterate;nf_conntrack_in;generic_packet;ipt_do_table;set_match_v4;ip_set_test;hash_net4_kadt;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;hash_net4_test ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;gro_cell_poll;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;dev_queue_xmit_nit;packet_rcv;tpacket_rcv;sch_direct_xmit;validate_xmit_skb_list;validate_xmit_skb;netif_skb_features;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;__dev_queue_xmit;dev_hard_start_xmit;__bpf_prog_run;__bpf_prog_run
Il y a beaucoup de choses ici, mais le principal est que nous trouvons le modèle « cadvisor avant ksoftirqd », que nous avons vu auparavant dans le traceur ICMP. Que signifie cela ?
Chaque ligne est une traçabilité du CPU à un moment donné. Chaque appel vers le bas de la pile dans la ligne est séparé par un point-virgule. Au milieu des lignes, nous voyons l'appel syscall effectué : read(): .... ;do_syscall_64;sys_read; .... Ainsi, cadvisor passe beaucoup de temps sur l'appel système read(), relatif aux fonctions mem_cgroup_* (partie supérieure de la pile d'appels / fin de la ligne).
Dans la traçabilité des appels, il est inconfortable de voir ce qui est réellement lu, alors lançons strace et voyons ce que fait cadvisor, et trouvons les appels système de plus de 100 ms :
theojulienne@kube-node-bad ~ $ sudo strace -p 10137 -T -ff 2>&1 | egrep '<0.[1-9]'
 [pid 10436]  ) = 0
 [pid 10432]  ) = 0
 [pid 10137]  ) = 0
 [pid 10384]  ) = 0
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 658
 [pid 10384]  ) = 0
 [pid 10436]  ) = 0
 [pid 10436]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10427]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10411]  ) = 0
 [pid 10382]  ) = 0 (Délai d'attente)
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 660
 [pid 10417]  ) = 0
 [pid 10436]  ) = 0
 [pid 10417]  ) = 0
 [pid 10417]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 576
Comme on pouvait s'y attendre, ici nous voyons des appels lents read(). Du contenu des opérations de lecture et du contexte mem_cgroup il est évident que ces appels read() se réfèrent au fichier memory.stat, qui montre l'utilisation de la mémoire et les limites de cgroup (technologie d'isolation des ressources dans Docker). L'outil cadvisor interroge ce fichier pour obtenir des informations sur l'utilisation des ressources pour les conteneurs. Vérifions si c'est le noyau ou cadvisor qui fait quelque chose d'inhabituel :
theojulienne@kube-node-bad ~ $ time cat /sys/fs/cgroup/memory/memory.stat >/dev/null
réel 0m0.153s
utilisateur 0m0.000s
système 0m0.152s
theojulienne@kube-node-bad ~ $
Nous pouvons maintenant reproduire le bug et comprenons que le noyau Linux rencontre une pathologie.
Pourquoi l'opération de lecture est-elle si lente ?
À ce stade, il est beaucoup plus facile de trouver des messages d'autres utilisateurs sur des problèmes similaires. Il s'est avéré que, dans le tracker cadvisor, ce bug a été signalé comme , simplement personne n'avait remarqué que le retard était également reflété de manière aléatoire dans la pile réseau. Il a effectivement été remarqué que cadvisor consommait plus de temps processeur que prévu, mais cela n'a pas été pris au sérieux, car nos serveurs ont beaucoup de ressources processeur, donc le problème n'a pas été étudié en profondeur.
Le problème réside dans le fait que les groupes de contrôle (cgroups) prennent en compte l'utilisation de la mémoire dans l'espace de noms (conteneur). Lorsque tous les processus de ce cgroup se terminent, Docker libère le groupe de contrôle de la mémoire. Cependant, 'mémoire' ne signifie pas seulement la mémoire du processus. Bien que la mémoire des processus ne soit plus utilisée, il apparaît que le noyau attribue encore un contenu mis en cache, tel que des dentries et des inodes (métadonnées de répertoires et de fichiers), qui sont mis en cache dans le cgroup de mémoire. Extrait de la description du problème :
cgroups-zombies : des groupes de contrôle qui n'ont pas de processus et qui ont été supprimés, mais pour lesquels de la mémoire est encore allouée (dans mon cas, à partir du cache dentry, mais cela peut également provenir du cache de pages ou de tmpfs).
La vérification par le noyau de toutes les pages dans le cache lors de la libération du cgroup peut être très lente, c'est pourquoi un processus paresseux a été choisi : attendre que ces pages soient de nouveau demandées, et seulement alors, lorsque la mémoire est réellement nécessaire, enfin nettoyer le cgroup. Jusqu'à ce moment, le cgroup est toujours comptabilisé lors de la collecte des statistiques.
Du point de vue des performances, ils ont sacrifié de la mémoire pour la performance : accélérant le nettoyage initial grâce à un peu de mémoire mise en cache restante. C'est acceptable. Lorsque le noyau utilise le dernier morceau de mémoire mise en cache, la cgroup est finalement nettoyée, donc on ne peut pas parler de « fuite ». Malheureusement, la mise en œuvre spécifique du mécanisme de recherche memory.stat dans cette version du noyau (4.9), associée à la grande quantité de mémoire sur nos serveurs, entraîne un temps de récupération des dernières données mises en cache et de nettoyage des cgroup zombies beaucoup plus long.
Il s'avère que sur certains de nos nœuds, il y avait tellement de cgroup zombies que la lecture et le délai dépassaient une seconde.
Une solution pour contourner le problème de cadvisor est de libérer immédiatement les caches dentries/inodes dans tout le système, ce qui élimine immédiatement le délai de lecture et le délai réseau sur l'hôte, car la suppression du cache implique également la libération des pages mises en cache des cgroup zombies. Ce n'est pas une solution, mais cela confirme la cause du problème.
Il s'est avéré qu'avec des versions plus récentes du noyau (4.19+) la performance des appels a été améliorée memory.stat, donc passer à ce noyau résolvait le problème. Dans le même temps, nous avions des outils pour détecter les nœuds problématiques dans les clusters Kubernetes, les isoler élégamment et les redémarrer. Nous avons passé en revue tous les clusters, trouvé des nœuds avec une latence suffisamment élevée et les avons redémarrés. Cela nous a donné le temps de mettre à jour le système d'exploitation sur les autres serveurs.
En résumé
Puisque ce bug stoppait le traitement des files d'attente RX NIC pendant des centaines de millisecondes, cela provoquait à la fois une grande latence sur les connexions courtes, ainsi qu'une latence en milieu de connexion, par exemple entre les requêtes MySQL et les paquets de réponse.
Comprendre et maintenir les performances des systèmes les plus fondamentaux, comme Kubernetes, est essentiel pour la fiabilité et la rapidité de tous les services qui en dépendent. Toutes les systèmes lancés bénéficient des améliorations de performance de Kubernetes.
Source : habr.com
