

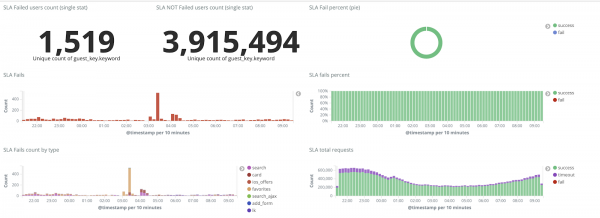
Bonjour à tous, je m'appelle Alexandre, je travaille chez CIAN en tant qu'ingénieur et je m'occupe de l'administration système et de l'automatisation des processus d'infrastructure. Dans les commentaires d'un de nos anciens articles, on nous a demandé de parler de l'origine des 4 To de logs que nous générons chaque jour et de leur traitement. Oui, nous avons beaucoup de logs, et un cluster d'infrastructure spécifique a été mis en place pour les traiter, ce qui nous permet de résoudre rapidement les problèmes. Dans cet article, je vais expliquer comment, en un an, nous avons adapté ce système pour gérer un flux de données en constante augmentation.
Par quoi nous avons commencé
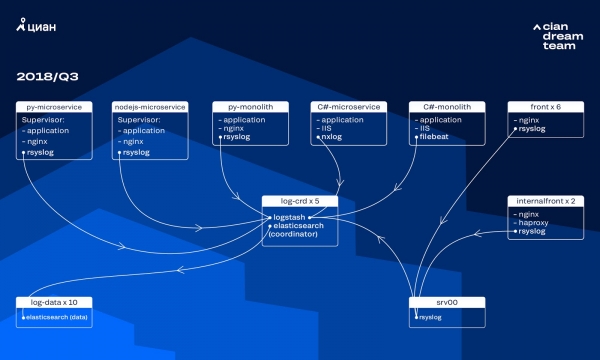
Au cours des dernières années, la charge sur cian.ru a augmenté très rapidement, et au troisième trimestre 2018, le site a atteint 11,2 millions d'utilisateurs uniques par mois. À cette époque, lors des moments critiques, nous perdions jusqu'à 40 % des logs, ce qui nous empêchait de résoudre rapidement les incidents et nous faisait perdre beaucoup de temps et d'efforts pour y faire face. Nous avions également souvent du mal à identifier la cause des problèmes, qui réapparaissait après un certain temps. C'était l'enfer, et il fallait faire quelque chose.
À ce moment-là, nous utilisions un cluster de 10 nœuds de données avec ElasticSearch version 5.5.2 avec des paramètres d'indexation standards pour le stockage des logs. Il a été mis en place il y a plus d'un an en tant que solution populaire et accessible : à l'époque, le flux de logs n'était pas si important, il n'y avait pas de raison d'inventer des configurations non standard.
Le traitement des logs entrants était assuré par Logstash sur différents ports sur cinq coordinateurs ElasticSearch. Un index, quelle que soit sa taille, se composait de cinq shards. Une rotation horaire et quotidienne a été organisée, résultant en environ 100 nouveaux shards dans le cluster chaque heure. Tant que le volume de logs n'était pas trop important, le cluster fonctionnait bien et personne ne se préoccupait de ses paramètres.
Problèmes de croissance rapide
Le volume de logs générés a connu une croissance très rapide, car deux processus se chevauchaient. D'une part, le nombre d'utilisateurs du service augmentait. D'autre part, nous avons commencé à adopter activement une architecture microservices, en décomposant nos anciens monolithes en C# et Python. Plusieurs dizaines de nouveaux microservices remplaçant des parties du monolithe généraient beaucoup plus de logs pour le cluster d'infrastructure.
C'est précisément l'échelle qui nous a amenés à rendre le cluster pratiquement ingérable. Lorsque les logs ont commencé à arriver à un rythme de 20 000 messages par seconde, une rotation fréquente et inutile a augmenté le nombre de shards à 6 000, et il y avait plus de 600 shards pour un nœud.
Cela a entraîné des problèmes de mémoire vive, et lors de la chute d'un nœud, le déplacement simultané de tous les shards a multiplié le trafic et chargé les autres nœuds, rendant pratiquement impossible l'enregistrement des données dans le cluster. Pendant cette période, nous étions sans logs. En cas de problème avec serveur nous perdions en fait 1/10 du cluster. Un grand nombre d'index de petite taille compliquait encore les choses.
Sans logs, nous ne comprenions pas les causes de l'incident et risquions de tomber à nouveau dans les mêmes pièges, ce qui était inacceptable selon l'idéologie de notre équipe, car tous nos mécanismes de travail visent précisément à éviter de répéter les mêmes problèmes. Pour cela, nous avions besoin d'un accès complet aux logs et de leur livraison pratiquement en temps réel, car l'équipe d'ingénieurs de garde surveillait les alertes non seulement des métriques, mais aussi des logs. Pour comprendre l'ampleur du problème, à l'époque, le volume total des logs était d'environ 2 To par jour.
Nous avons défini comme objectif d'éliminer complètement la perte de logs et de réduire le temps de leur livraison vers le cluster ELK à un maximum de 15 minutes en cas d'urgence (cette valeur est par la suite devenue notre KPI interne).
Un nouveau mécanisme de rotation et des nœuds hot-warm
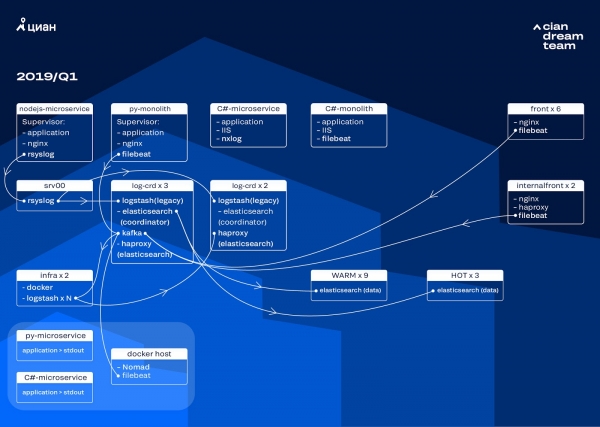
Nous avons commencé la transformation du cluster par la mise à jour de la version d'ElasticSearch de 5.5.2 à 6.4.3. Notre cluster en version 5 est tombé à nouveau, et nous avons décidé de l'éteindre et de le mettre à jour complètement — puisqu'il n'y avait de toute façon pas de logs. Nous avons donc réalisé cette transition en seulement quelques heures.
La transformation la plus importante à ce stade a été l'implémentation sur trois nœuds avec un coordinateur comme tampon intermédiaire d'Apache Kafka. Le courtier de messages nous a libérés de la perte de journaux lors de problèmes avec ElasticSearch. En même temps, nous avons ajouté 2 nœuds au cluster et sommes passés à une architecture hot-warm avec trois nœuds « chauds », disposés dans différentes baies du centre de données. Sur ceux-ci, nous avons redirigé selon le masque des journaux qui ne devaient en aucun cas être perdus — nginx, ainsi que les journaux d'erreurs des applications. Les autres nœuds recevaient des journaux mineurs — debug, warning, etc., et après 24 heures, des journaux « importants » des nœuds « chauds » étaient transférés.
Pour ne pas augmenter le nombre d'index de petite taille, nous sommes passés d'une rotation par temps à un mécanisme de rollover. Les forums contenaient beaucoup d'informations indiquant que la rotation par taille d'index était très peu fiable, c'est pourquoi nous avons décidé d'utiliser la rotation basée sur le nombre de documents dans l'index. Nous avons analysé chaque index et noté le nombre de documents après lequel la rotation devait être déclenchée. Ainsi, nous avons atteint une taille de shard optimale — pas plus de 50 Go.
Optimisation du cluster
Cependant, nous n'avons pas complètement éliminé les problèmes. Malheureusement, de petits index apparaissaient toujours : ils n'atteignaient pas le volume requis, ne rotativaient pas et étaient supprimés par un nettoyage global des index de plus de trois jours, car nous avions supprimé la rotation par date. Cela entraînait des pertes de données, car l'index disparaissait complètement du cluster, et la tentative d'enregistrement dans un index inexistant brisait la logique de curator que nous utilisions pour la gestion. L'alias pour l'écriture se transformait en index et perturbait la logique de rollover, provoquant une croissance incontrôlée de certains index jusqu'à 600 Go.
Par exemple, pour la configuration de rotation :
curator-elk-rollover.yaml

---
actions:
  1:
    action: rollover
    options:
      name: "nginx_write"
      conditions:
        max_docs: 100000000
  2:
    action: rollover
    options:
      name: "python_error_write"
      conditions:
        max_docs: 10000000
En l'absence d'alias de rollover, une erreur est survenue :
ERROR     alias "nginx_write" not found.
ERROR     Failed to complete action: rollover.  <type 'exceptions.ValueError'>: Unable to perform index rollover with alias "nginx_write".
Nous avons laissé la résolution de ce problème pour une prochaine itération et nous nous sommes concentrés sur une autre question : nous sommes passés à une logique de travail par pull pour Logstash, gérant le traitement des logs entrants (suppression des informations superflues et enrichissement). Nous l'avons placé dans Docker, que nous lançons via docker-compose, et y avons également déployé logstash-exporter, qui envoie des métriques à Prometheus pour un suivi opérationnel du flux de logs. Cela nous a permis de modifier progressivement le nombre d'instances de Logstash responsables du traitement de chaque type de logs.
Pendant que nous perfectionnions le cluster, le trafic sur cian.ru a augmenté jusqu'à 12,8 millions d'utilisateurs uniques par mois. En conséquence, nos transformations ont légèrement pris du retard par rapport aux changements en production, et nous avons constaté que les nœuds « tièdes » ne parvenaient pas à gérer la charge, ralentissant ainsi toute la livraison des logs. Les données « chaudes » arrivaient sans interruptions, mais il fallait intervenir manuellement sur la livraison des autres et effectuer des rollovers manuels pour répartir uniformément les index.
Cependant, la mise à l'échelle et les changements de configuration des instances de Logstash dans le cluster étaient compliqués par le fait qu'il s'agissait d'un docker-compose local, et toutes les actions étaient effectuées à la main (pour ajouter de nouveaux endpoints, il fallait manuellement passer par tous les serveurs et exécuter docker-compose up -d partout).
Répartition des logs
En septembre de cette année, nous continuions encore à décomposer le monolithe, la charge sur le cluster augmentait, et le flux de logs approchait les 30 000 messages par seconde.
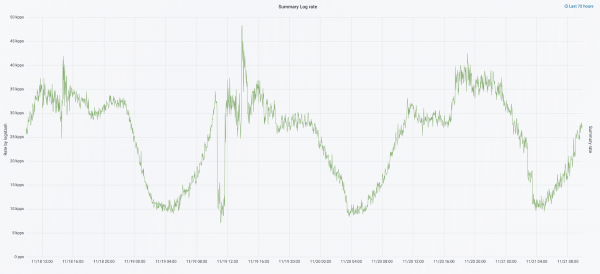
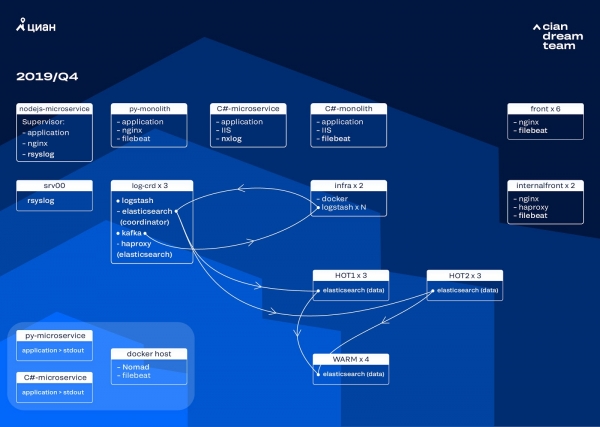
Nous avons commencé la prochaine itération par une mise à jour du matériel. Nous sommes passés de cinq coordonnateurs à trois, avons remplacé les nœuds de données, et avons réalisé des économies tant financières qu’en capacité de stockage. Pour les nœuds, nous utilisons deux configurations :
- Pour les nœuds « chauds » : E3-1270 v6 / 960 Go SSD / 32 Go x 3 x 2 (3 pour Hot1 et 3 pour Hot2).
- Pour les nœuds « tièdes » : E3-1230 v6 / 4 To SSD / 32 Go x 4.
À cette itération, nous avons extrait l'index avec les logs d'accès des microservices, qui occupe autant d'espace que les logs des nginx frontaux, vers le second groupe des trois nœuds « chauds ». Les données sur les nœuds « chauds » sont maintenant conservées pendant 20 heures, puis transférées vers les nœuds « tièdes » avec les autres logs.
Nous avons résolu le problème de disparition des petits index en reconfigurant leur rotation. Désormais, les index sont tournés toutes les 23 heures, même s'il y a peu de données. Cela a légèrement augmenté le nombre de shards (près de 800), mais du point de vue des performances du cluster, c'est acceptable.
En conséquence, le cluster se compose de six nœuds "chauds" et seulement quatre nœuds "tièdes". Cela entraîne un léger retard dans les requêtes sur de grands intervalles, mais l'augmentation du nombre de nœuds à l'avenir résoudra ce problème.
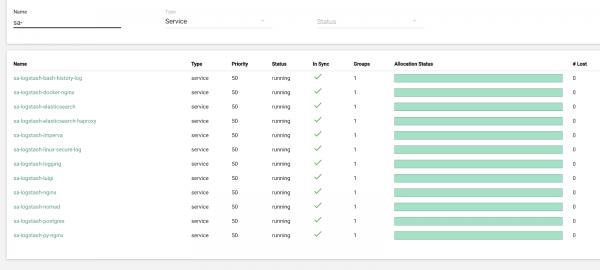
Dans cette itération, nous avons également corrigé le problème du manque de scalabilité semi-automatique. Pour cela, nous avons déployé un cluster Nomad d'infrastructure, similaire à celui déjà déployé en production. Pour l'instant, le nombre de Logstash n'est pas ajusté automatiquement en fonction de la charge, mais nous y parviendrons également.
Plans pour l'avenir
La configuration mise en œuvre se масштабирует parfaitement, et nous stockons actuellement 13,3 To de données — tous les logs des 4 derniers jours, ce qui est nécessaire pour le traitement d'urgence des alertes. Une partie des logs est transformée en métriques, que nous stockons dans Graphite. Pour faciliter le travail des ingénieurs, nous avons des métriques pour le cluster d'infrastructure et des scripts pour la réparation semi-automatique des problèmes typiques. Après l'augmentation du nombre de nœuds de données prévue pour l'année prochaine, nous passerons du stockage de données de 4 à 7 jours. Cela sera suffisant pour les opérations, car nous veillons toujours à enquêter sur les incidents le plus rapidement possible, et pour les enquêtes à long terme, nous avons les données de télémétrie.
En octobre 2019, le trafic de cian.ru a atteint 15,3 millions d'utilisateurs uniques par mois. Cela a constitué un véritable test pour la solution architecturale de livraison des logs.
Nous nous préparons actuellement à mettre à jour ElasticSearch vers la version 7. Cependant, cela nécessitera la mise à jour de la structure de nombreux index dans ElasticSearch, car ils ont été migrés de la version 5.5 et ont été déclarés obsolètes dans la version 6 (ils n'existent tout simplement pas dans la version 7). Cela signifie qu'il y aura sûrement un imprévu au cours du processus de mise à jour, ce qui nous laissera sans logs pendant un certain temps. De la version 7, nous attendons surtout Kibana avec une interface améliorée et de nouveaux filtres.
Nous avons atteint notre objectif principal : nous avons cessé de perdre des journaux et réduit le temps d'arrêt de notre cluster d'infrastructure de 2 à 3 pannes par semaine à quelques heures de maintenance par mois. Tout ce travail en production est presque imperceptible. Cependant, nous pouvons maintenant identifier avec précision ce qui se passe avec notre service, nous pouvons le faire rapidement en mode tranquille et sans craindre que les journaux se perdent. En général, nous sommes satisfaits, heureux et nous nous préparons à de nouveaux exploits dont nous parlerons plus tard.
Source : habr.com
