

Aujourd'hui, nous allons parler des principes et des modèles GitOps, ainsi que de la manière dont ces modèles sont mis en œuvre sur la plateforme OpenShift. Un guide interactif sur ce sujet est disponible. .
En bref, GitOps est un ensemble de méthodes pratiques utilisant des pull requests Git pour gérer les configurations d'infrastructure et d'applications. Un dépôt Git dans le cadre de GitOps est considéré comme la seule source unique d'informations sur l'état du système, et tout changement d'état est complètement traçable et auditable.
L'idée de traçabilité des changements dans GitOps n'est pas nouvelle, cette approche est déjà largement appliquée lors de travaux avec le code source des applications. GitOps met simplement en œuvre des fonctions analogues (revues, pull requests, balises, etc.) pour la gestion des configurations d'infrastructure et d'applications, offrant ainsi des avantages similaires à ceux de la gestion du code source.
Il n'y a pas de définition académique ou de code de règles approuvé pour GitOps, juste un ensemble de principes sur lesquels cette pratique est fondée :
- La description déclarative du système est stockée dans un dépôt Git (configurations, surveillance, etc.).
- Les changements d'état sont effectués via des pull requests.
- L'état des systèmes en fonctionnement est aligné avec les données dans le dépôt à l'aide des push requests Git.
Principes de GitOps
- Les définitions des systèmes sont décrites comme du code source.
La configuration des systèmes est considérée comme du code, ce qui permet de la conserver et de la versionner automatiquement dans un dépôt Git, qui constitue la seule source de vérité. Cette approche permet de facilement déployer (rollout) et de revenir en arrière (rollback) sur les changements dans les systèmes.
- L'état souhaité et la configuration des systèmes sont définis et versionnés dans Git.
En stockant et en versionnant dans Git l'état souhaité des systèmes, nous avons la possibilité de déployer et de revenir facilement sur les modifications dans les systèmes et les applications. Nous pouvons également utiliser les mécanismes de sécurité de Git pour contrôler la propriété du code et en vérifier l'authenticité.
- Les modifications des configurations peuvent être appliquées automatiquement via des pull requests.
En utilisant les pull requests Git, nous pouvons facilement gérer comment les modifications sont appliquées aux configurations dans le dépôt. Par exemple, elles peuvent être soumises à la vérification d'autres membres de l'équipe ou passées par des tests CI.
Et il n'est pas nécessaire de distribuer les pouvoirs d'administration à tout va. Pour effectuer un commit des modifications dans la configuration, les utilisateurs doivent disposer des autorisations appropriées dans le dépôt Git où ces configurations sont stockées.
- Résoudre le problème du dérive des configurations non contrôlées
Lorsque l'état souhaité du système est stocké dans un dépôt Git, il ne nous reste plus qu'à trouver un logiciel qui contrôlera si l'état actuel du système correspond à son état souhaité. Si ce n'est pas le cas, ce logiciel doit – en fonction des paramètres – soit corriger l'inadéquation de lui-même, soit nous avertir du dérive des configurations.
Modèles GitOps pour OpenShift
Ressource de réconciliation On-Cluster
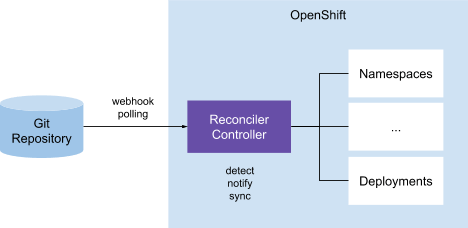
Selon ce modèle, il y a un contrôleur dans le cluster qui est responsable de la comparaison des ressources Kubernetes (fichiers YAML) dans le dépôt Git avec les ressources réelles du cluster. Lors de la détection de divergences, le contrôleur envoie des notifications et, éventuellement, prend des mesures pour résoudre les non-conformités. Ce modèle GitOps est utilisé dans Anthos Config Management et Weaveworks Flux.
Ressource de réconciliation externe (Push)
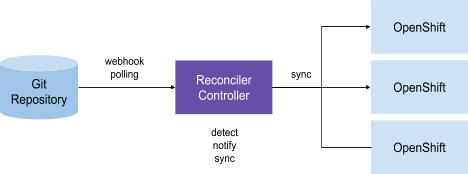
Ce modèle peut être considéré comme une variante du précédent, où nous avons un ou plusieurs contrôleurs responsables de la synchronisation des ressources dans des paires « dépôt Git – cluster Kubernetes ». La différence ici est que chaque cluster géré n'a pas nécessairement besoin d'avoir son propre contrôleur distinct. Les paires « Git – cluster k8s » sont souvent définies comme des descriptions CRD (custom resources definition), dans lesquelles on peut spécifier comment le contrôleur doit effectuer la synchronisation. Dans ce modèle, les contrôleurs comparent le dépôt Git défini dans le CRD avec les ressources du cluster Kubernetes qui sont également définies dans le CRD, et effectuent les actions appropriées sur la base des résultats de la comparaison. En particulier, ce modèle GitOps est utilisé dans ArgoCD.
GitOps sur la plateforme OpenShift
Administration d'une infrastructure Kubernetes multi-cluster
Avec la généralisation de Kubernetes et l'augmentation de la popularité des stratégies multi-cloud et du edge computing, le nombre moyen de clusters OpenShift par client est également en hausse.
Par exemple, lors de l'utilisation de l'informatique en périphérie, des clusters d'un même client peuvent être déployés par centaines, voire par milliers. En conséquence, il est obligé de gérer plusieurs clusters OpenShift indépendants ou synchronisés dans le cloud public et sur site.
Cela implique de résoudre de nombreux problèmes, notamment :
- Contrôler que les clusters sont dans un état identique (configurations, surveillance, stockage, etc.)
- Recréer (ou restaurer) des clusters à partir d'un état connu.
- Créer de nouveaux clusters à partir d'un état connu.
- Appliquer des modifications sur plusieurs clusters OpenShift.
- Revenir sur des modifications dans plusieurs clusters OpenShift.
- Lier des configurations modélisées avec différents environnements.
Configurations d'application
Au cours de leur cycle de vie, les applications passent souvent par une série de clusters (dev, stage, etc.) avant d'atteindre le cluster de production. De plus, en raison des exigences de disponibilité et d'évolutivité, les clients déploient souvent des applications sur plusieurs clusters sur site ou dans plusieurs régions d'une plateforme cloud public.
Cela implique de résoudre les tâches suivantes :
- Assurer le mouvement des applications (binaires, configurations, etc.) entre les clusters (dev, stage, etc.).
- Appliquer des modifications aux applications (binaires, configurations, etc.) dans plusieurs clusters OpenShift.
- Revenir sur des modifications dans les applications au niveau de l'état précédent connu.
Cas d'utilisation d'OpenShift GitOps
1. Appliquer des modifications depuis le dépôt Git
L'administrateur du cluster peut stocker les configurations du cluster OpenShift dans un dépôt Git et les appliquer automatiquement afin de créer sans effort de nouveaux clusters et de les ramener à un état identique à celui connu, stocké dans le dépôt Git.
2. Synchronisation avec Secret Manager
L'administrateur pourra également synchroniser les objets secrets OpenShift avec des logiciels appropriés comme Vault, afin de les gérer avec des outils spécialement conçus à cet effet.
3. Contrôle de la dérive des configurations
L'administrateur sera favorable à ce qu'OpenShift GitOps identifie et signale les divergences entre les configurations réelles et celles définies dans le dépôt, afin de pouvoir réagir rapidement à la dérive.
4. Notifications de dérive de configurations
Utile lorsque l'administrateur souhaite être informé rapidement des cas de dérive de configurations afin de prendre des mesures appropriées sans délai.
5. Synchronisation manuelle des configurations en cas de dérive
Permet à l'administrateur de synchroniser le cluster OpenShift avec le dépôt Git en cas de dérive de configurations, afin de ramener rapidement le cluster à un état antérieur connu.
6. Autosynchronisation des configurations en cas de dérive
L'administrateur peut également configurer le cluster OpenShift pour une autosynchronisation avec le dépôt lors de la détection d'une dérive, garantissant que la configuration du cluster correspond toujours aux fichiers de configuration dans Git.
7. Plusieurs clusters – un seul dépôt
L'administrateur peut stocker dans un seul dépôt Git les configurations de plusieurs clusters OpenShift différents et les appliquer sélectivement au besoin.
8. Hiérarchie des configurations de clusters (héritage)
L'administrateur peut définir une hiérarchie des configurations de clusters dans le dépôt (stage, prod, portfolio d'applications, etc. avec héritage). En d'autres termes, il peut déterminer comment les configurations doivent être appliquées – à un ou plusieurs clusters.
Par exemple, si l'administrateur définit dans le dépôt Git la hiérarchie « Clusters de production (prod) → Clusters du système X → Clusters de production du système X », alors aux clusters de production du système X s'applique la combinaison des configurations suivantes :
- Configurations communes à tous les clusters de production.
- Configurations pour le cluster du système X.
- Configurations pour le cluster de production du système X.
9. Modèles et redéfinition des configurations
L'administrateur peut redéfinir l'ensemble des configurations héritées et leurs valeurs, par exemple, pour affiner la configuration pour certains clusters auxquels elles seront appliquées.
10. Includes et excludes sélectifs pour les configurations, configurations des applications
L'administrateur peut définir des conditions d'application ou de non-application de certaines configurations à des clusters ayant des caractéristiques spécifiques.
11. Prise en charge des modèles
Les développeurs apprécieront la possibilité de choisir comment les ressources de l'application seront définies (Helm Chart, yaml Kubernetes natif, etc.) afin d'utiliser le format le plus approprié pour chaque application spécifique.
Outils GitOps sur la plateforme OpenShift
ArgoCD
ArgoCD implémente un modèle External Resource Reconcile et propose une interface utilisateur centralisée pour orchestrer les relations entre les clusters et les dépôts Git selon un schéma « un à plusieurs ». Parmi les inconvénients de ce programme, on peut citer l'impossibilité de gérer des applications lorsque ArgoCD est hors service.
Flux
Flux implémente un modèle On-Cluster Resource Reconcile, et par conséquent, il n'y a pas de gestion centralisée du dépôt des définitions, ce qui constitue un point faible. D'autre part, en raison de l'absence de centralisation, la possibilité de gérer des applications est maintenue même en cas de défaillance d'un cluster.
Installation d'ArgoCD sur OpenShift
ArgoCD propose une excellente interface de ligne de commande et une console web, nous ne considérerons donc pas Flux et d'autres alternatives ici.
Pour déployer ArgoCD sur la plateforme OpenShift 4, effectuez les étapes suivantes en tant qu'administrateur de cluster :
Déploiement des composants ArgoCD sur la plateforme OpenShift
# Create a new namespace for ArgoCD components
oc create namespace argocd
# Apply the ArgoCD Install Manifest
oc -n argocd apply -f https://raw.githubusercontent.com/argoproj/argo-cd/v1.2.2/manifests/install.yaml
# Get the ArgoCD Server password
ARGOCD_SERVER_PASSWORD=$(oc -n argocd get pod -l "app.kubernetes.io/name=argocd-server" -o jsonpath='{.items[*].metadata.name}')
Modification du serveur ArgoCD pour qu'il soit visible par OpenShift Route
# Patch ArgoCD Server so no TLS is configured on the server (--insecure)
PATCH='{"spec":{"template":{"spec":{"$setElementOrder/containers":[{"name":"argocd-server"}],"containers":[{"command":["argocd-server","--insecure","--staticassets","/shared/app"],"name":"argocd-server"}]}}}}'
oc -n argocd patch deployment argocd-server -p $PATCH
# Expose the ArgoCD Server using an Edge OpenShift Route so TLS is used for incoming connections
oc -n argocd create route edge argocd-server --service=argocd-server --port=http --insecure-policy=Redirect
Déploiement de l'outil en ligne de commande ArgoCD
# Download the argocd binary, place it under /usr/local/bin and give it execution permissions
curl -L https://github.com/argoproj/argo-cd/releases/download/v1.2.2/argocd-linux-amd64 -o /usr/local/bin/argocd
chmod +x /usr/local/bin/argocd
Changement du mot de passe admin du serveur ArgoCD
# Get ArgoCD Server Route Hostname
ARGOCD_ROUTE=$(oc -n argocd get route argocd-server -o jsonpath='{.spec.host}')
# Login with the current admin password
argocd --insecure --grpc-web login ${ARGOCD_ROUTE}:443 --username admin --password ${ARGOCD_SERVER_PASSWORD}
# Update admin's password
argocd --insecure --grpc-web --server ${ARGOCD_ROUTE}:443 account update-password --current-password ${ARGOCD_SERVER_PASSWORD} --new-password
Après avoir effectué ces étapes, vous pouvez interagir avec le serveur ArgoCD via la console web ArgoCD WebUI ou l'outil en ligne de commande ArgoCD Cli.
GitOps – il n'est jamais trop tard
« Le train est parti » – c'est ce qu'on dit d'une situation où l'opportunité d'agir a été manquée. Dans le cas d'OpenShift, le désir de commencer immédiatement à utiliser cette nouvelle plateforme géniale crée souvent une telle situation concernant la gestion et l'entretien des routes, des déploiements et d'autres objets OpenShift. Mais l'opportunité est-elle toujours définitivement manquée ?
En continuant notre série d'articles sur , aujourd'hui nous allons montrer comment transformer une application créée manuellement et ses ressources en un processus géré par les outils GitOps. Pour ce faire, nous allons d'abord déployer manuellement l'application httpd. L'image ci-dessous montre comment nous créons un espace de noms, un déploiement et un service, puis nous exposons ce service pour créer une route.
oc create -f https://raw.githubusercontent.com/openshift/federation-dev/master/labs/lab-4-assets/namespace.yaml
oc create -f https://raw.githubusercontent.com/openshift/federation-dev/master/labs/lab-4-assets/deployment.yaml
oc create -f https://raw.githubusercontent.com/openshift/federation-dev/master/labs/lab-4-assets/service.yaml
oc expose svc/httpd -n simple-app
Donc, nous avons une application créée manuellement. Maintenant, elle doit être transférée sous la gestion de GitOps sans perte de disponibilité. En résumé, cela fonctionne comme suit :
- Création d'un dépôt Git pour le code.
- Nous exportons nos objets actuels et les chargeons dans le dépôt Git.
- Nous sélectionnons et déployons l'outil GitOps.
- Nous ajoutons notre dépôt dans cet outil.
- Nous définissons l'application dans notre outil GitOps.
- Nous effectuons un lancement d'essai de l'application en utilisant l'outil GitOps.
- Nous synchronisons les objets à l'aide de l'outil GitOps.
- Nous activons le nettoyage et l'autosynchronisation des objets.
Comme déjà mentionné précédemment, dans GitOps, il n'y a qu'une seule source d'informations sur tous les objets dans le(s) cluster(s) Kubernetes - le dépôt Git. Nous partons de l'hypothèse que votre organisation utilise déjà un dépôt Git. Celui-ci peut être public ou privé, mais doit être accessible par les clusters Kubernetes. Il peut s'agir du même dépôt que celui utilisé pour le code des applications, ou d'un dépôt séparé créé spécialement pour les déploiements. Dans le dépôt, il est recommandé d'avoir des autorisations strictes, car des objets secrets, des routes et d'autres éléments sensibles à la sécurité y seront stockés.
Dans notre exemple, nous allons créer un nouveau dépôt public sur GitHub. Vous pouvez le nommer comme vous le souhaitez, nous utilisons le nom blogpost.
Si les fichiers YAML des objets n'étaient pas stockés localement ou dans Git, nous devrons utiliser les binaires oc ou kubectl. Sur l'écran ci-dessous, nous demandons le YAML pour notre espace de noms, notre déploiement, notre service et notre route. Auparavant, nous avions cloné le dépôt récemment créé et nous y sommes allés avec la commande cd.
oc get namespace simple-app -o yaml --export > namespace.yaml
oc get deployment httpd -o yaml -n simple-app --export > deployment.yaml
oc get service httpd -o yaml -n simple-app --export > service.yaml
oc get route httpd -o yaml -n simple-app --export > route.yaml
Nous allons maintenant corriger le fichier deployment.yaml pour supprimer le champ que Argo CD ne peut pas synchroniser.
sed -i '/sgeneration: .* /d' deployment.yamlDe plus, nous devons modifier la route. Nous allons d'abord définir une variable multi-ligne, puis remplacer ingress: null par le contenu de cette variable.
export ROUTE="  ingress:
    - conditions:
        - status: 'True'
          type: Admitted"

sed -i "s/  ingress: null/$ROUTE/g" route.yaml
Ainsi, nous avons réglé les fichiers, il ne reste plus qu'à les sauvegarder dans le dépôt Git. Après cela, ce dépôt devient la seule source d'informations, et toute modification manuelle des objets doit être strictement interdite.
git commit -am 'initial commit of objects'
git push origin master
Nous partons du principe qu'ArgoCD est déjà déployé chez vous (voir comment faire – cf. précédent) ). Nous allons donc ajouter dans ArgoCD le dépôt que nous avons créé, contenant le code de l'application de notre exemple. Assurez-vous simplement d'indiquer le dépôt exact que vous avez créé précédemment.
argocd repo add https://github.com/cooktheryan/blogpostNous créons maintenant l'application. L'application définit les valeurs que l'outil GitOps doit comprendre pour savoir quel dépôt et quels chemins utiliser, quel OpenShift est nécessaire pour gérer les objets, ainsi que quelle branche spécifique du dépôt est requise, et si la synchronisation automatique des ressources doit être effectuée.
argocd app create --project default
--name simple-app --repo https://github.com/cooktheryan/blogpost.git
--path . --dest-server https://kubernetes.default.svc
--dest-namespace simple-app --revision master --sync-policy none
Après avoir défini l'application dans ArgoCD, cet outil commence à vérifier les objets déjà déployés par rapport aux définitions dans le dépôt. Dans notre exemple, la synchronisation automatique et le nettoyage sont désactivés, donc les éléments ne changent pas pour le moment. Notez que dans l'interface ArgoCD, notre application affichera le statut « Out of Sync » (Non synchronisé) car il n'y a pas d'étiquette label apposée par ArgoCD.
C'est pourquoi, lorsque nous lancerons la synchronisation un peu plus tard, le redéploiement des objets ne sera pas effectué.
Nous allons maintenant effectuer un test pour nous assurer qu'il n'y a pas d'erreurs dans nos fichiers.
argocd app sync simple-app --dry-runS'il n'y a pas d'erreurs, vous pouvez passer à la synchronisation.
argocd app sync simple-appAprès avoir exécuté la commande argocd get sur notre application, nous devrions voir que le statut de l'application a changé en Healthy (Sain) ou Synced (Synchronisé). Cela signifiera que toutes les ressources dans le dépôt Git correspondent maintenant aux ressources déjà déployées.
argocd app get simple-app
Name:               simple-app
Project:            default
Server:             https://kubernetes.default.svc
Namespace:          simple-app
URL:                https://argocd-server-route-argocd.apps.example.com/applications/simple-app
Repo:               https://github.com/cooktheryan/blogpost.git
Target:             master
Path:               .
Sync Policy:
Sync Status:        Synced to master (60e1678)
Health Status:      Healthy
...
Nous pouvons maintenant activer la synchronisation automatique et le nettoyage pour garantir qu'aucun objet ne sera créé manuellement et que chaque fois qu'un objet est créé ou mis à jour dans le dépôt, un déploiement sera effectué.
argocd app set simple-app --sync-policy automated --auto-prune Ainsi, nous avons réussi à transférer sous gestion GitOps une application qui n'utilisait initialement pas GitOps.
Source : habr.com
