

Cet article examine plusieurs méthodes pour déterminer l'équation mathématique de la ligne de régression simple (bivariée).
Toutes les méthodes abordées ici pour résoudre l'équation reposent sur la méthode des moindres carrés. Nous désignerons les méthodes comme suit :
- Solution analytique
- Descente de gradient
- Descente de gradient stochastique
Pour chacune des méthodes de résolution de l'équation de la droite, l'article fournit diverses fonctions, principalement divisées entre celles qui sont écrites sans utiliser de bibliothèque NumPy et celles qui utilisent pour les calculs. NumPyIl est considéré qu'une utilisation habile de NumPy permettra de réduire les coûts de calcul.
Tout le code présenté dans l'article est écrit en python 2.7 à l'aide de Jupyter Notebook. Le code source et le fichier de données échantillonnées sont disponibles sur
L'article est davantage orienté à la fois vers les débutants et vers ceux qui commencent déjà à s'initier à un domaine très vaste de l'intelligence artificielle : l'apprentissage automatique.
Pour illustrer le matériel, nous utiliserons un exemple très simple.
Conditions de l'exemple
Nous avons cinq valeurs qui caractérisent la dépendance Y à partir de X (Tableau n°1) :
Tableau n°1 « Conditions de l'exemple »
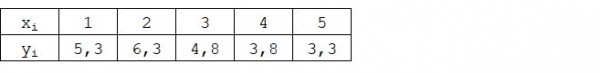
Considérons que les valeurs  sont les mois de l'année, et que
 correspond au chiffre d'affaires de ce mois. En d'autres termes, le chiffre d'affaires dépend des mois de l'année, et
 est le seul facteur dont dépend le chiffre d'affaires.
L'exemple n'est pas très pertinent tant du point de vue de la dépendance conditionnelle du chiffre d'affaires par rapport au mois de l'année que du point de vue du nombre de valeurs, qui est très faible. Toutefois, cette simplification permettra d'expliquer, de manière intuitive, un matériel qui n'est pas toujours facilement assimilé par les novices. De plus, la simplicité des chiffres permettra à ceux qui le souhaitent de résoudre l'exemple sur « papier » sans trop d'effort.
Supposons que la dépendance présentée dans l'exemple peut être assez bien approchée par une équation mathématique de la ligne de régression simple (bivariée) de la forme :

où  — est le mois au cours duquel le chiffre d'affaires a été réalisé,
 — est le chiffre d'affaires correspondant au mois,
 et
 — sont les coefficients de régression de la ligne estimée.
Notons que le coefficient  est souvent appelé coefficient angulaire ou gradient de la ligne estimée ; il représente la quantité par laquelle change
 lorsqu'il y a un changement.
 .
Il est évident que notre tâche dans cet exemple est de choisir dans l'équation des coefficients  et
 , pour lesquels les écarts entre nos valeurs calculées de revenus mensuels et les vraies réponses, c'est-à-dire les valeurs présentées dans l'échantillon, seront minimaux.
La méthode des moindres carrés
Selon la méthode des moindres carrés, l'écart doit être calculé en le mettant au carré. Cela permet d'éviter l'annulation des écarts, dans le cas où ils ont des signes opposés. Par exemple, si dans un cas, l'écart est +5 (plus cinq), et dans l'autre -5 (moins cinq), la somme des écarts s'annule et devient 0 (zéro). On peut aussi ne pas élever l'écart au carré, mais utiliser la propriété de la valeur absolue, et dans ce cas, tous nos écarts seront positifs et s'accumuleront. Nous ne nous attarderons pas sur ce point en détail, mais simplement noter que, pour des calculs pratiques, il est habituel d'élever l'écart au carré.
Voici à quoi ressemble la formule, avec laquelle nous déterminerons la plus petite somme des carrés des écarts (erreurs) :

où  — c'est une fonction d'approximation des vraies réponses (c'est-à-dire notre revenu calculé),
 — ce sont les vraies réponses (le revenu fourni dans l'échantillon),
 — c'est l'indice de l'échantillon (le numéro du mois où se produit la détermination de l'écart)
Nous allons différencier la fonction, définir les équations des dérivées partielles et être prêts à passer à la solution analytique. Mais d'abord, faisons une petite excursion sur ce qu'est la différentiation et rappelons le sens géométrique de la dérivée.
Différentiation
La différentiation est l'opération consistant à trouver la dérivée d'une fonction.
À quoi sert la dérivée ? La dérivée d'une fonction caractérise la vitesse de changement de la fonction et indique sa direction. Si la dérivée en un point donné est positive, alors la fonction augmente, sinon — la fonction diminue. Plus la valeur de la dérivée est grande en valeur absolue, plus la vitesse de changement des valeurs de la fonction est élevée, ainsi que l'angle d'inclinaison du graphique de la fonction.
Par exemple, dans les conditions d'un système de coordonnées cartésien, la valeur de la dérivée au point M(0,0) égal +25 signifie qu'en un point donné, avec un déplacement de la valeur  vers la droite d'une unité conventionnelle, la valeur
 augmente de 25 unités conditionnelles. Sur le graphique, cela ressemble à un angle d'élévation assez abrupt des valeurs.
 à partir d'un point donné.
Un autre exemple. La valeur de la dérivée est égale à -0,1 ce qui signifie qu'en se déplaçant  d'une unité conditionnelle, la valeur
 diminue de seulement 0,1 unité conditionnelle. Cela dit, sur le graphique de la fonction, nous pouvons observer une légère pente descendante. En faisant une analogie avec une montagne, nous descendons très lentement sur une pente douce, contrairement à l'exemple précédent où nous devions grimper des sommets très escarpés :)
Ainsi, en procédant à la différentiation de la fonction  par rapport aux coefficients
 et
 , nous déterminerons les équations des dérivées partielles de premier ordre. Après avoir défini les équations, nous obtiendrons un système de deux équations, en résolvant lequel nous pourrons choisir des valeurs pour les coefficients
 et
 , pour lesquelles les valeurs des dérivées correspondantes changent d'une quantité très, très faible aux points donnés, et dans le cas d'une solution analytique, elles ne changent pas du tout. En d'autres termes, la fonction d'erreur avec les coefficients trouvés atteindra un minimum, car les valeurs des dérivées partielles à ces points seront égales à zéro.
Ainsi, selon les règles de la différentiation, l'équation de la dérivée partielle de premier ordre par rapport à  sera de la forme :

l'équation de la dérivée partielle de premier ordre par rapport à  sera de la forme :

En fin de compte, nous avons obtenu un système d'équations qui a une solution analytique assez simple :
begin{équation*}
begin{cas}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a +bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cas}
end{équation*}
Avant de résoudre l'équation, nous allons d'abord charger, vérifier la validité du téléchargement et formater les données.
Chargement et formatage des données
Il convient de noter qu'en raison du fait que pour la solution analytique, et ensuite pour la descente de gradient et la descente de gradient stochastique, nous utiliserons le code en deux variantes : avec l'utilisation de la bibliothèque NumPy et sans son utilisation, nous aurons besoin d'un formatage approprié des données (voir le code).
Code de chargement et de traitement des données
# импортируем все нужные нам библиотеки
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import math
import pylab as pl
import random

# графики отобразим в Jupyter
%matplotlib inline

# укажем размер графиков
from pylab import rcParams
rcParams['figure.figsize'] = 12, 6

# отключим предупреждения Anaconda
import warnings
warnings.simplefilter('ignore')

# загрузим значения
table_zero = pd.read_csv('data_example.txt', header=0, sep='t')

# посмотрим информацию о таблице и на саму таблицу
print table_zero.info()
print '********************************************'
print table_zero
print '********************************************'

# подготовим данные без использования NumPy

x_us = []
[x_us.append(float(i)) for i in table_zero['x']]
print x_us
print type(x_us)
print '********************************************'

y_us = []
[y_us.append(float(i)) for i in table_zero['y']]
print y_us
print type(y_us)
print '********************************************'

# подготовим данные с использованием NumPy

x_np = table_zero[['x']].values
print x_np
print type(x_np)
print x_np.shape
print '********************************************'

y_np = table_zero[['y']].values
print y_np
print type(y_np)
print y_np.shape
print '********************************************'
Visualisation
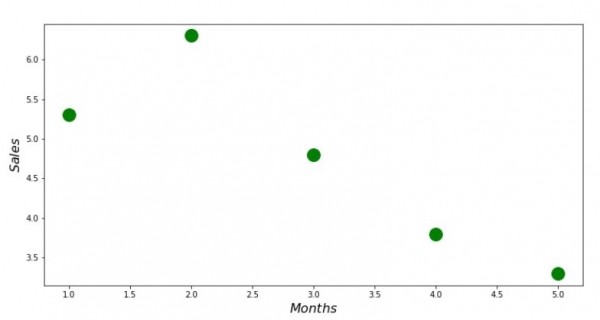
Maintenant, après que nous avons, premièrement, chargé les données, deuxièmement, vérifié la validité du téléchargement et enfin formaté les données, nous procéderons à la première visualisation. On utilise souvent pour cela la méthode pairplot bibliothèques Seaborn. Dans notre exemple, en raison de la limitation des chiffres, il n'est pas judicieux d'utiliser une bibliothèque. Seaborn. Nous allons utiliser une bibliothèque standard. Matplotlib et nous ne regarderons que le nuage de points.
Code du nuage de points
print 'Graphique n°1 "Relation entre les revenus et le mois de l'année"'

plt.plot(x_us,y_us,'o',color='green',markersize=16)
plt.xlabel('$Months$', size=16)
plt.ylabel('$Sales$', size=16)
plt.show()
Graphique n°1 « Relation entre les revenus et le mois de l'année »
Solution analytique
Utilisons les outils les plus simples dans python et résolvons le système d'équations :
begin{équation*}
begin{cas}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a +bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cas}
end{équation*}
Selon la règle de Cramer nous allons trouver le déterminant général ainsi que les déterminants par  et par
 , après quoi, en divisant le déterminant par
 par le déterminant général, nous allons trouver le coefficient
 , de même, nous allons trouver le coefficient
 .
Code de la solution analytique
# определим функцию для расчета коэффициентов a и b по правилу Крамера
def Kramer_method (x,y):
        # сумма значений (все месяца)
    sx = sum(x)
        # сумма истинных ответов (выручка за весь период)
    sy = sum(y)
        # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x[i]*y[i]) for i in range(len(x))]
    sxy = sum(list_xy)
        # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x[i]**2) for i in range(len(x))]
    sx_sq = sum(list_x_sq)
        # количество значений
    n = len(x)
        # общий определитель
    det = sx_sq*n - sx*sx
        # определитель по a
    det_a = sx_sq*sy - sx*sxy
        # искомый параметр a
    a = (det_a / det)
        # определитель по b
    det_b = sxy*n - sy*sx
        # искомый параметр b
    b = (det_b / det)
        # контрольные значения (прооверка)
    check1 = (n*b + a*sx - sy)
    check2 = (b*sx + a*sx_sq - sxy)
    return [round(a,4), round(b,4)]

# запустим функцию и запишем правильные ответы
ab_us = Kramer_method(x_us,y_us)
a_us = ab_us[0]
b_us = ab_us[1]
print ' 33[1m' + ' 33[4m' + "Оптимальные значения коэффициентов a и b:"  + ' 33[0m'
print 'a =', a_us
print 'b =', b_us
print

# определим функцию для подсчета суммы квадратов ошибок
def errors_sq_Kramer_method(answers,x,y):
    list_errors_sq = []
    for i in range(len(x)):
        err = (answers[0] + answers[1]*x[i] - y[i])**2
        list_errors_sq.append(err)
    return sum(list_errors_sq)

# запустим функцию и запишем значение ошибки
error_sq = errors_sq_Kramer_method(ab_us,x_us,y_us)
print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений" + ' 33[0m'
print error_sq
print

# замерим время расчета
# print ' 33[1m' + ' 33[4m' + "Время выполнения расчета суммы квадратов отклонений:" + ' 33[0m'
# % timeit error_sq = errors_sq_Kramer_method(ab,x_us,y_us)
Voici ce que nous avons obtenu :
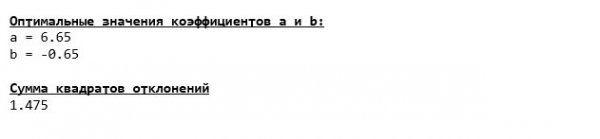
Ainsi, les valeurs des coefficients ont été trouvées, la somme des carrés des écarts a été établie. Traçons sur l'histogramme un droit correspondant aux coefficients trouvés.
Code de la ligne de régression
# определим функцию для формирования массива рассчетных значений выручки
def sales_count(ab,x,y):
    line_answers = []
    [line_answers.append(ab[0]+ab[1]*x[i]) for i in range(len(x))]
    return line_answers

# построим графики
print 'Грфик№2 "Правильные и расчетные ответы"'
plt.plot(x_us,y_us,'o',color='green',markersize=16, label = '$True$ $answers$')
plt.plot(x_us, sales_count(ab_us,x_us,y_us), color='red',lw=4,
         label='$Function: a + bx,$ $where$ $a='+str(round(ab_us[0],2))+',$ $b='+str(round(ab_us[1],2))+'$')
plt.xlabel('$Months$', size=16)
plt.ylabel('$Sales$', size=16)
plt.legend(loc=1, prop={'size': 16})
plt.show()
Graphique n°2 « Réponses correctes et calculées »
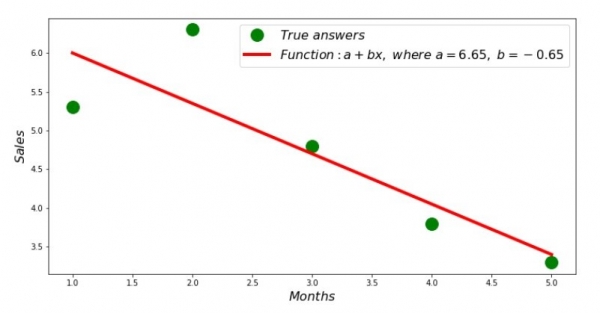
On peut examiner le graphique des écarts pour chaque mois. Dans notre cas, il n'y a pas vraiment de valeur pratique significative à en tirer, mais cela satisfera notre curiosité sur la manière dont l'équation de régression linéaire simple caractérise la relation entre les revenus et le mois de l'année.
Code du graphique des écarts
# определим функцию для формирования массива отклонений в процентах
def error_per_month(ab,x,y):
    sales_c = sales_count(ab,x,y)
    errors_percent = []
    for i in range(len(x)):
        errors_percent.append(100*(sales_c[i]-y[i])/y[i])
    return errors_percent

# построим график
print 'График№3 "Отклонения по-месячно, %"'
plt.gca().bar(x_us, error_per_month(ab_us,x_us,y_us), color='brown')
plt.xlabel('Months', size=16)
plt.ylabel('Calculation error, %', size=16)
plt.show()
Graphique n°3 « Écarts, % »
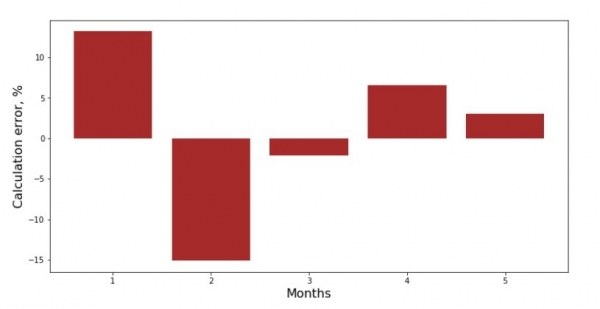
Ce n'est pas parfait, mais nous avons réussi notre tâche.
Écrivons une fonction pour déterminer les coefficients  et
 utilise la bibliothèque NumPy, plus précisément, écrivons deux fonctions : l'une utilisant la pseudo-inverse (non recommandé en pratique en raison de la complexité computationnelle et de l'instabilité), l'autre utilisant l'équation matricielle.
Code de la solution analytique (NumPy)
# для начала добавим столбец с не изменяющимся значением в 1.
# Данный столбец нужен для того, чтобы не обрабатывать отдельно коэффицент a
vector_1 = np.ones((x_np.shape[0],1))
x_np = table_zero[['x']].values # на всякий случай приведем в первичный формат вектор x_np
x_np = np.hstack((vector_1,x_np))

# проверим то, что все сделали правильно
print vector_1[0:3]
print x_np[0:3]
print '***************************************'
print

# напишем функцию, которая определяет значения коэффициентов a и b с использованием псевдообратной матрицы
def pseudoinverse_matrix(X, y):
    # задаем явный формат матрицы признаков
    X = np.matrix(X)
    # определяем транспонированную матрицу
    XT = X.T
    # определяем квадратную матрицу
    XTX = XT*X
    # определяем псевдообратную матрицу
    inv = np.linalg.pinv(XTX)
    # задаем явный формат матрицы ответов
    y = np.matrix(y)
    # находим вектор весов
    return (inv*XT)*y

# запустим функцию
ab_np = pseudoinverse_matrix(x_np, y_np)
print ab_np
print '***************************************'
print

# напишем функцию, которая использует для решения матричное уравнение
def matrix_equation(X,y):
    a = np.dot(X.T, X)
    b = np.dot(X.T, y)
    return np.linalg.solve(a, b)

# запустим функцию
ab_np = matrix_equation(x_np,y_np)
print ab_np
Comparons le temps consacré à déterminer les coefficients  et
 , selon les 3 méthodes présentées.
Code pour calculer le temps des calculs
print ' 33[1m' + ' 33[4m' + "Temps d'exécution du calcul des coefficients sans utiliser la bibliothèque NumPy :" + ' 33[0m'
% timeit ab_us = Kramer_method(x_us,y_us)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Temps d'exécution du calcul des coefficients avec la pseudo-inverse :" + ' 33[0m'
%timeit ab_np = pseudoinverse_matrix(x_np, y_np)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Temps d'exécution du calcul des coefficients avec l'équation matricielle :" + ' 33[0m'
%timeit ab_np = matrix_equation(x_np, y_np)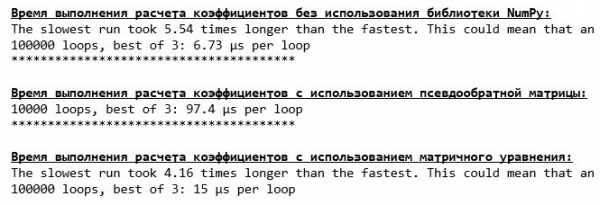
Avec un petit ensemble de données, c'est une fonction « sur mesure » qui émerge, trouvant les coefficients par la méthode de Cramer.
Nous pouvons maintenant passer à d'autres méthodes pour trouver les coefficients.  et
 .
Descente de gradient
Commençons par définir ce qu'est un gradient. En termes simples, un gradient est un segment qui indique la direction de la croissance maximale d'une fonction. Par analogie avec l'ascension d'une montagne, l'endroit où pointe le gradient indique la pente la plus raide vers le sommet de la montagne. En développant cet exemple de montagne, nous devons en réalité chercher la descente la plus abrupte pour atteindre le fond, c'est-à-dire le minimum — l'endroit où la fonction n'augmente ni ne diminue. À cet endroit, la dérivée sera égale à zéro. Par conséquent, nous avons besoin non pas d'un gradient, mais d'un anti-gradient. Pour trouver l'anti-gradient, il suffit de multiplier le gradient par -1 (-1).
Notons que la fonction peut avoir plusieurs minima et qu'en descendant dans l'un d'eux par l'algorithme proposé, nous ne pourrons pas trouver un autre minimum qui pourrait être plus bas que celui trouvé. Rassurons-nous, ce risque ne nous concerne pas ! Dans notre cas, nous traitons avec un seul minimum, car notre fonction  sur le graphique représente une parabole ordinaire. Et comme nous le savons tous très bien grâce à nos cours de mathématiques au lycée, une parabole n'a qu'un seul minimum.
Après avoir déterminé pourquoi nous avions besoin d'un gradient et aussi que le gradient est un segment, c'est-à-dire un vecteur avec des coordonnées spécifiques, qui représentent précisément ces coefficients  et
 nous pouvons mettre en œuvre la descente de gradient.
Avant de commencer, je vous propose de lire quelques phrases sur l'algorithme de descente :
- Nous définissons aléatoirement les coordonnées des coefficients
 et . Dans notre exemple, nous allons définir les coefficients près de zéro. C'est une pratique courante, mais pour chaque cas, une pratique spécifique peut être prévue.
- De la coordonnée nous soustrayons la valeur de la dérivée partielle du 1er ordre au point. . Ainsi, si la dérivée est positive, la fonction augmente. Par conséquent, en soustrayant la valeur de la dérivée, nous allons dans le sens inverse de la croissance, c'est-à-dire vers la baisse. Si la dérivée est négative, cela signifie que la fonction diminue à ce point et en soustrayant la valeur de la dérivée, nous allons vers la baisse.
- Nous effectuons une opération similaire avec la coordonnée : nous soustrayons la valeur de la dérivée partielle en ce point .
- Pour ne pas dépasser le minimum et ne pas s'envoler dans l'espace lointain, il est nécessaire de définir la taille du pas dans la direction de la descente. En général, on pourrait écrire tout un article sur la manière de déterminer correctement la taille du pas et comment la modifier pendant le processus de descente pour réduire les coûts de calcul. Mais nous avons maintenant une tâche légèrement différente, et par la méthode scientifique du 'tâtonnement', ou comme on dit dans le langage courant, de manière empirique, nous allons établir la taille du pas.
- Après avoir soustrait les valeurs des dérivées des coordonnées données et , nous obtenons de nouvelles coordonnées et . Nous faisons le prochain pas (soustraction), déjà à partir des coordonnées calculées. Et ainsi, le cycle redémarre encore et encore, jusqu'à ce que la convergence requise soit atteinte.
 et
 . Dans notre exemple, nous allons définir les coefficients près de zéro. C'est une pratique courante, mais pour chaque cas, une pratique spécifique peut être prévue.
 nous soustrayons la valeur de la dérivée partielle du 1er ordre au point.
 . Ainsi, si la dérivée est positive, la fonction augmente. Par conséquent, en soustrayant la valeur de la dérivée, nous allons dans le sens inverse de la croissance, c'est-à-dire vers la baisse. Si la dérivée est négative, cela signifie que la fonction diminue à ce point et en soustrayant la valeur de la dérivée, nous allons vers la baisse.
 : nous soustrayons la valeur de la dérivée partielle en ce point
 .
 et
 , nous obtenons de nouvelles coordonnées
 et
 . Nous faisons le prochain pas (soustraction), déjà à partir des coordonnées calculées. Et ainsi, le cycle redémarre encore et encore, jusqu'à ce que la convergence requise soit atteinte.
C'est tout ! Maintenant, nous sommes prêts à partir à la recherche du plus profond canyon de la fosse des Mariannes. Commençons.
Code pour la descente de gradient
# напишем функцию градиентного спуска без использования библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = sum(x_us)
    # сумма истинных ответов (выручка за весь период)
    sy = sum(y_us)
    # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x_us[i]*y_us[i]) for i in range(len(x_us))]
    sxy = sum(list_xy)
    # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x_us[i]**2) for i in range(len(x_us))]
    sx_sq = sum(list_x_sq)
    # количество значений
    num = len(x_us)
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = [a,b]
        errors.append(errors_sq_Kramer_method(ab,x_us,y_us))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)


print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print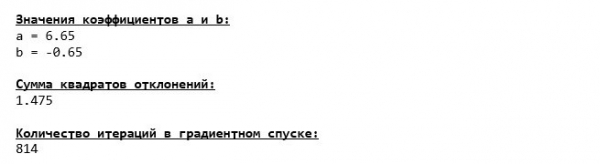
Nous avons plongé au fond de la fosse des Mariannes et y avons trouvé les mêmes valeurs de coefficients  et
 , ce qui était en fait attendu.
Faisons une autre plongée, mais cette fois, l'équipement de notre appareil sous-marin sera doté d'autres technologies, à savoir la bibliothèque NumPy.
Code pour la descente de gradient (NumPy)
# перед тем определить функцию для градиентного спуска с использованием библиотеки NumPy,
# напишем функцию определения суммы квадратов отклонений также с использованием NumPy
def error_square_numpy(ab,x_np,y_np):
    y_pred = np.dot(x_np,ab)
    error = y_pred - y_np
    return sum((error)**2)

# напишем функцию градиентного спуска с использованием библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = float(sum(x_np[:,1]))
    # сумма истинных ответов (выручка за весь период)
    sy = float(sum(y_np))
    # сумма произведения значений на истинные ответы
    sxy = x_np*y_np
    sxy = float(sum(sxy[:,1]))
    # сумма квадратов значений
    sx_sq = float(sum(x_np[:,1]**2))
    # количество значений
    num = float(x_np.shape[0])
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = np.array([[a],[b]])
        errors.append(error_square_numpy(ab,x_np,y_np))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print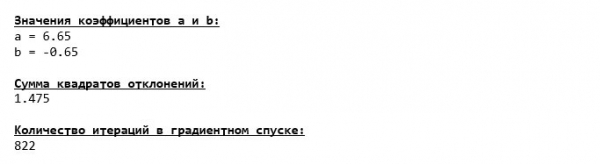
Les valeurs des coefficients  et
 restent inchangées.
Voyons comment l'erreur a fluctué pendant la descente de gradient, c'est-à-dire comment la somme des carrés des écarts a varié à chaque étape.
Code pour le graphique des sommes des carrés des écarts
print 'Graphique n°4 "Somme des carrés des écarts par étape"'
plt.plot(range(len(list_parametres_gradient_descence[1])), list_parametres_gradient_descence[1], color='red', lw=3)
plt.xlabel('Étapes (Itération)', size=16)
plt.ylabel('Somme des carrés des écarts', size=16)
plt.show()
Graphique n°4 « Somme des carrés des écarts lors de la descente de gradient »
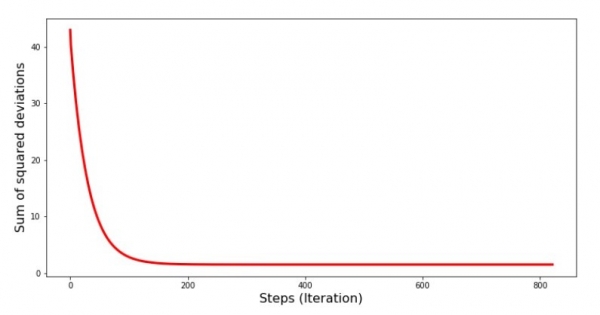
Sur le graphique, nous voyons qu'à chaque étape, l'erreur diminue, et après un certain nombre d'itérations, une ligne presque horizontale apparaît.
Enfin, évaluons la différence de temps d'exécution du code :
Code pour déterminer le temps d'exécution de la descente de gradient
print ' 33[1m' + ' 33[4m' + "Temps d'exécution de la descente de gradient sans utiliser la bibliothèque NumPy:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' + "Temps d'exécution de la descente de gradient en utilisant la bibliothèque NumPy:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)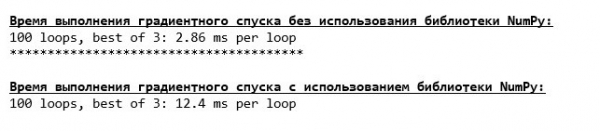
Peut-être que nous faisons quelque chose de mal, mais encore une fois, une fonction «maison» simple qui n'utilise pas de bibliothèque NumPy dé-passe en temps d'exécution la fonction qui utilise la bibliothèque NumPy.
Mais nous ne restons pas inactifs et nous nous dirigeons vers l'exploration d'un autre moyen fascinant de résoudre l'équation de la régression linéaire simple. Voici !
Descente de gradient stochastique
Pour mieux comprendre le principe du fonctionnement de la descente de gradient stochastique, il est préférable de déterminer ses différences par rapport à la descente de gradient ordinaire. Dans le cas de la descente de gradient, nous avons dans les équations des dérivées de  et
 utilisé les sommes des valeurs de toutes les caractéristiques et des réponses réelles présentes dans l'échantillon (c'est-à-dire les sommes de toutes
 et
 ). Dans la descente de gradient stochastique, nous n'utiliserons pas toutes les valeurs présentes dans l'échantillon, mais à la place, nous sélectionnerons de manière pseudo-aléatoire ce qu'on appelle l'indice de l'échantillon et utiliserons ses valeurs.
Par exemple, si l'indice s'est déterminé au numéro 3 (trois), nous prenons les valeurs  et
 , ensuite nous substituons les valeurs dans les équations des dérivées et déterminons de nouvelles coordonnées. Puis, ayant défini les coordonnées, nous déterminons à nouveau de manière pseudo-aléatoire l'indice de l'échantillon, substituons les valeurs correspondant à l'indice dans les équations des dérivées partielles, et redéfinissons les coordonnées
 et
 etc. jusqu'à la convergence. À première vue, cela peut sembler se demander comment cela peut fonctionner, mais ça fonctionne. Certes, il faut noter que l'erreur ne diminue pas à chaque étape, mais la tendance est indubitable.
Quels sont les avantages de la descente de gradient stochastique par rapport à la descente de gradient ordinaire ? Lorsqu'on dispose d'un échantillon très large mesuré en dizaines de milliers de valeurs, il est beaucoup plus simple de traiter, disons, un millier aléatoire d'entre elles plutôt que l'ensemble de l'échantillon. C'est dans ce cas que la descente de gradient stochastique est lancée. Dans notre cas, nous ne verrons certainement pas de grande différence.
Regardons le code.
Code pour la descente de gradient stochastique
# определим функцию стох.град.шага
def stoch_grad_step_usual(vector_init, x_us, ind, y_us, l):
#     выбираем значение икс, которое соответствует случайному значению параметра ind
# (см.ф-цию stoch_grad_descent_usual)
    x = x_us[ind]
#     рассчитывыаем значение y (выручку), которая соответствует выбранному значению x
    y_pred = vector_init[0] + vector_init[1]*x_us[ind]
#     вычисляем ошибку расчетной выручки относительно представленной в выборке
    error = y_pred - y_us[ind]
#     определяем первую координату градиента ab
    grad_a = error
#     определяем вторую координату ab
    grad_b = x_us[ind]*error
#     вычисляем новый вектор коэффициентов
    vector_new = [vector_init[0]-l*grad_a, vector_init[1]-l*grad_b]
    return vector_new


# определим функцию стох.град.спуска
def stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800):
#     для самого начала работы функции зададим начальные значения коэффициентов
    vector_init = [float(random.uniform(-0.5, 0.5)), float(random.uniform(-0.5, 0.5))]
    errors = []
#     запустим цикл спуска
# цикл расчитан на определенное количество шагов (steps)
    for i in range(steps):
        ind = random.choice(range(len(x_us)))
        new_vector = stoch_grad_step_usual(vector_init, x_us, ind, y_us, l)
        vector_init = new_vector
        errors.append(errors_sq_Kramer_method(vector_init,x_us,y_us))
    return (vector_init),(errors)


# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])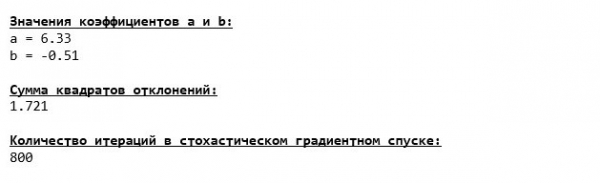
Regardons attentivement les coefficients et nous nous posons la question : « Comment cela se fait-il ? ». Nous avons obtenu d'autres valeurs pour les coefficients.  et
 . Peut-être que la descente de gradient stochastique a trouvé des paramètres plus optimaux pour l'équation ? Hélas, non. Il suffit de regarder la somme des carrés des écarts et de constater qu'avec les nouvelles valeurs des coefficients, l'erreur est plus grande. Ne désespérons pas. Traçons le graphique de l'évolution de l'erreur.
Code pour le graphique de la somme des carrés des écarts lors de la descente de gradient stochastique
print 'Graphique n°5 "Somme des carrés des écarts en étapes"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Étapes (Itération)', size=16)
plt.ylabel('Somme des carrés des écarts', size=16)
plt.show()
Graphique n°5 « Somme des carrés des écarts lors de la descente de gradient stochastique »
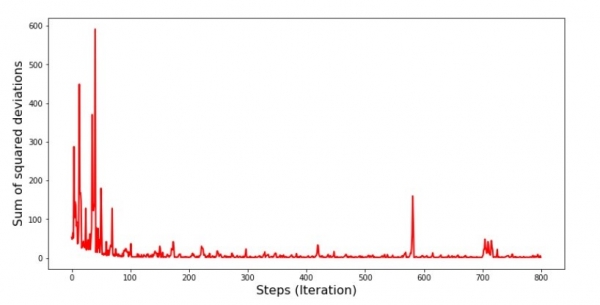
En regardant le graphique, tout devient clair et nous allons maintenant tout corriger.
Alors, que s'est-il passé ? La situation est la suivante. Lorsque nous choisissons un mois au hasard, notre algorithme s'efforce de réduire l'erreur dans le calcul des revenus pour le mois choisi. Ensuite, nous choisissons un autre mois et répétons le calcul, mais nous réduisons l'erreur pour le deuxième mois choisi. Maintenant, rappelons-nous que nos deux premiers mois s'écartent considérablement de la ligne de l'équation de régression linéaire simple. Cela signifie que lorsque l'un de ces deux mois est choisi, en réduisant l'erreur pour chacun d'eux, notre algorithme augmente sérieusement l'erreur sur l'ensemble de l'échantillon. Que faire alors ? La réponse est simple : il faut réduire le pas de descente. En effet, en réduisant le pas de descente, l'erreur cessera aussi de « sauter » de haut en bas. En fait, l'erreur ne cessera pas de « sauter », mais le fera avec moins d'agilité :) Vérifions.
Code pour lancer la SGD avec un pas plus petit
# запустим функцию, уменьшив шаг в 100 раз и увеличив количество шагов соответсвующе
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])

print 'График №6 "Сумма квадратов отклонений по-шагово"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Steps (Iteration)', size=16)
plt.ylabel('Sum of squared deviations', size=16)
plt.show()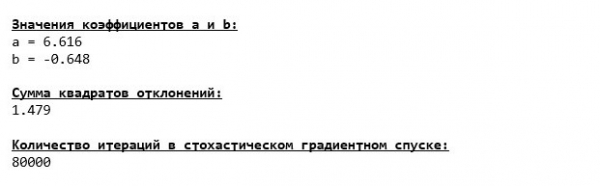
Graphique n°6 « Somme des carrés des écarts lors de la descente de gradient stochastique (80 000 étapes) »
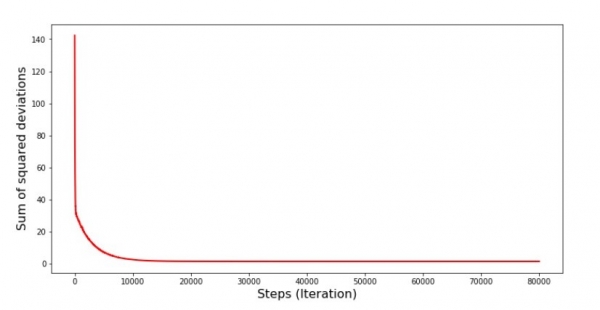
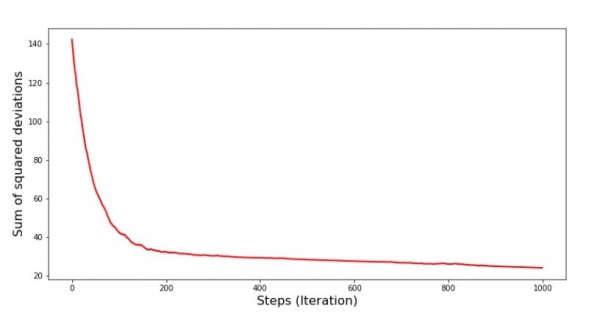
Les valeurs des coefficients se sont améliorées, mais restent encore loin d’être idéales. Hypothétiquement, cela pourrait être corrigé de cette manière : prenons, par exemple, les valeurs des coefficients des 1000 dernières itérations, où l'erreur a été minimale. Cependant, pour cela, nous devrons également enregistrer les valeurs des coefficients eux-mêmes. Nous ne ferons pas cela, mais plutôt prêterons attention au graphique. Il semble lisse, et l'erreur semble diminuer uniformément. En réalité, ce n'est pas le cas. Examinons les 1000 premières itérations et comparons-les aux dernières.
Code pour le graphique SGD (premiers 1000 pas)
print 'Graphique №7 "Somme des carrés des écarts étape par étape. Premiers 1000 itérations"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][:1000])),
         list_parametres_stoch_gradient_descence[1][:1000], color='red', lw=2)
plt.xlabel('Étapes (Itération)', size=16)
plt.ylabel('Somme des carrés des écarts', size=16)
plt.show()

print 'Graphique №7 "Somme des carrés des écarts étape par étape. Derniers 1000 itérations"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][-1000:])),
         list_parametres_stoch_gradient_descence[1][-1000:], color='red', lw=2)
plt.xlabel('Étapes (Itération)', size=16)
plt.ylabel('Somme des carrés des écarts', size=16)
plt.show()
Graphique №7 «Somme des carrés des écarts SGD (premiers 1000 pas)»
Graphique №8 «Somme des carrés des écarts SGD (derniers 1000 pas)»
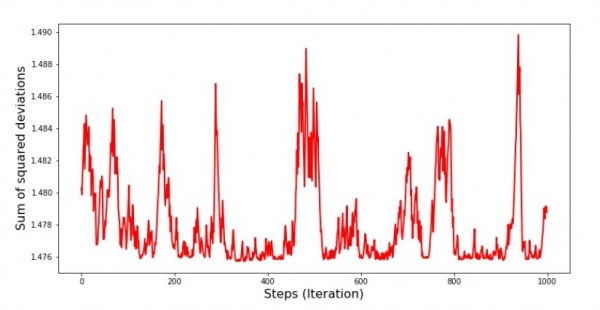
Au début de la descente, nous observons une diminution assez uniforme et raide de l'erreur. Lors des dernières itérations, nous voyons que l'erreur oscille autour d'une valeur de 1,475 et, par moments, elle atteint même cette valeur optimale, mais finit par remonter… Je le répète, nous pouvons enregistrer les valeurs des coefficients.  et
 , puis choisir celles pour lesquelles l'erreur est minimale. Cependant, un problème plus sérieux s'est posé : nous avons dû effectuer 80 000 pas (voir le code) pour obtenir des valeurs proches de l'optimal. Cela contredit déjà l'idée d'économiser du temps de calcul lors de la descente de gradient stochastique par rapport à celle de gradient. Que peut-on corriger et améliorer ? Il n'est pas difficile de remarquer qu'au début des itérations, nous descendons avec assurance. Par conséquent, nous devrions conserver un grand pas pendant les premières itérations et diminuer ce pas au fur et à mesure de notre progression. Nous ne le ferons pas dans cet article — il est déjà suffisamment long. Ceux qui le souhaitent peuvent réfléchir à comment le faire, ce n'est pas difficile 🙂
Maintenant, exécutons la descente de gradient stochastique en utilisant la bibliothèque NumPy (et nous ne trébucherons pas sur les pierres que nous avons identifiées plus tôt)
Code pour la descente de gradient stochastique (NumPy)
# для начала напишем функцию градиентного шага
def stoch_grad_step_numpy(vector_init, X, ind, y, l):
    x = X[ind]
    y_pred = np.dot(x,vector_init)
    err = y_pred - y[ind]
    grad_a = err
    grad_b = x[1]*err
    return vector_init - l*np.array([grad_a, grad_b])

# определим функцию стохастического градиентного спуска
def stoch_grad_descent_numpy(X, y, l=0.1, steps = 800):
    vector_init = np.array([[np.random.randint(X.shape[0])], [np.random.randint(X.shape[0])]])
    errors = []
    for i in range(steps):
        ind = np.random.randint(X.shape[0])
        new_vector = stoch_grad_step_numpy(vector_init, X, ind, y, l)
        vector_init = new_vector
        errors.append(error_square_numpy(vector_init,X,y))
    return (vector_init), (errors)

# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])
print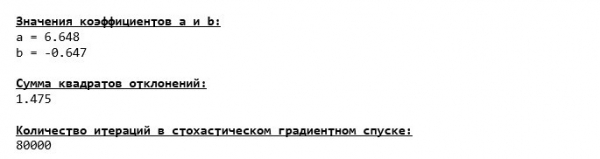
Les valeurs obtenues étaient presque les mêmes que lors de la descente sans utilisation NumPy. C'est néanmoins logique.
Voyons combien de temps nos descentes de gradient stochastiques ont pris.
Code pour déterminer le temps de calcul de la SGD (80 000 étapes)
print ' 33[1m' + ' 33[4m' +
"Temps d'exécution de la descente de gradient stochastique sans utiliser la bibliothèque NumPy:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' +
"Temps d'exécution de la descente de gradient stochastique en utilisant la bibliothèque NumPy:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)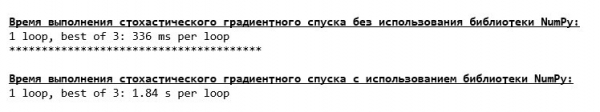
Plus on s'enfonce dans les bois, plus les nuages deviennent sombres : encore une formule « maison » montre un meilleur résultat. Tout cela nous amène à penser qu'il doit exister des moyens encore plus subtils d'utiliser la bibliothèque NumPy, qui améliorent réellement la vitesse des opérations de calcul. Dans cet article, nous n'allons pas les découvrir. Ce sera matière à réflexion pendant votre temps libre :)
Résumons
Avant de résumer, j'aimerais répondre à la question qui a probablement surgi chez notre cher lecteur. Pourquoi donc ce genre de « souffrances » avec les descentes, pourquoi devons-nous gravir la colline vers le haut et vers le bas (principalement vers le bas) pour trouver la précieuse vallée, alors que nous avons un outil si puissant et simple, sous la forme d'une solution analytique, qui nous téléporte instantanément au bon endroit ?
La réponse à cette question est évidente. Nous venons d'examiner un exemple très simple, où la réponse réelle  dépend d'un seul critère
 . Dans la vie, cela arrive rarement, alors imaginons que nous avons 2, 30, 50 critères ou plus. Ajoutons à cela des milliers, voire des dizaines de milliers de valeurs pour chaque critère. Dans ce cas, la solution analytique peut ne pas supporter l'épreuve et échouer. En revanche, la descente de gradient et ses variations nous rapprocheront lentement mais sûrement de l'objectif — le minimum de la fonction. Et en ce qui concerne la vitesse, ne vous inquiétez pas — nous examinerons certainement à nouveau des moyens qui nous permettront de définir et de réguler la taille du pas (c'est-à-dire la vitesse).
Et maintenant, voici en réalité un bref résumé.
Tout d'abord, j'espère que le contenu de l'article aidera les nouveaux « data scientists » à comprendre comment résoudre des équations de régression linéaire simple (et pas seulement).
Deuxièmement, nous avons examiné plusieurs méthodes pour résoudre l'équation. Maintenant, en fonction de la situation, nous pouvons choisir celle qui convient le mieux à la tâche à accomplir.
Troisièmement, nous avons constaté la puissance des réglages supplémentaires, à savoir la longueur du pas de la descente de gradient. Ce paramètre ne doit pas être négligé. Comme indiqué précédemment, afin de réduire les coûts de calcul, il est judicieux de modifier la longueur du pas lors de la descente.
Quatrièmement, dans notre cas, les fonctions « faites maison » ont montré le meilleur temps de calcul. Cela est probablement dû à une utilisation pas tout à fait professionnelle des capacités de la bibliothèque. NumPy. Quoi qu'il en soit, la conclusion qui s'impose est la suivante. D'une part, il vaut parfois la peine de remettre en question les opinions établies, et d'autre part, il n'est pas toujours nécessaire de compliquer les choses — parfois, une méthode plus simple s'avère plus efficace. Puisque notre objectif était d'examiner trois approches pour résoudre l'équation de régression linéaire simple, l'utilisation de fonctions « faites maison » nous a suffi.
Bibliographie (ou quelque chose comme ça)
1. Régression linéaire
2. Méthode des moindres carrés
3. Dérivée
4. Gradient
5. Descente de gradient
6. Bibliothèque NumPy
Source : habr.com
