

Dans le cadre de leur travail, les développeurs sont souvent confrontés à des situations où ils écrivent une requête en pensant «la base de données est intelligente, elle s'en sortira seule! »«
Dans certains cas (partiellement à cause d'une méconnaissance des capacités de la base de données, partiellement à cause d'optimisations prématurées), cette approche mène à la création de « monstres ».
Tout d'abord, je vais donner un exemple de cette requête :
-- pour chaque paire clé, nous trouvons les valeurs associées des champs
WITH RECURSIVE cte_bind AS (
  SELECT DISTINCT ON (key_a, key_b)
    key_a a
  , key_b b
  , fld1 bind_fld1
  , fld2 bind_fld2
  FROM
    tbl
)
-- nous trouvons les valeurs min/max pour chaque première clé
, cte_max AS (
  SELECT
    a
  , max(bind_fld1) bind_fld1
  , min(bind_fld2) bind_fld2
  FROM
    cte_bind
  GROUP BY
    a
)
-- nous relions par la première clé les paires clés et les valeurs min/max
, cte_a_bind AS (
  SELECT
    cte_bind.a
  , cte_bind.b
  , cte_max.bind_fld1
  , cte_max.bind_fld2
  FROM
    cte_bind
  INNER JOIN
    cte_max
      ON cte_max.a = cte_bind.a
)
SELECT * FROM cte_a_bind;
Pour évaluer le quality de la requête, créons un ensemble de données arbitraire :
CREATE TABLE tbl AS
SELECT
  (random() * 1000)::integer key_a
, (random() * 1000)::integer key_b
, (random() * 10000)::integer fld1
, (random() * 10000)::integer fld2
FROM
  generate_series(1, 10000);
CREATE INDEX ON tbl(key_a, key_b);
Il s'avère que la lecture des données a pris moins d'un quart de tout le temps d'exécution de la requête : Démêlons les détails
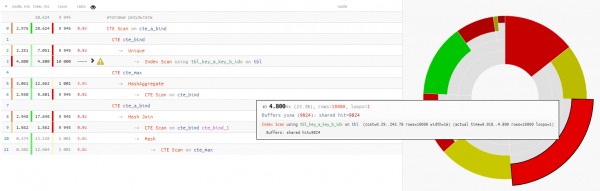
Examinons de près la requête, et posons-nous la question :
Pourquoi utiliser WITH RECURSIVE, s'il n'y a pas de CTE récursifs ?
- Pourquoi regrouper les valeurs min/max dans un CTE séparé, alors qu'elles se lient ensuite à l'échantillon d'origine ?
- +25% de temps
Pourquoi utiliser à nouveau la lecture de la CTE précédente via un ‘SELECT * FROM’ inconditionnel à la fin ? - +14% de temps
Dans ce cas, nous avons eu de la chance que l'algorithme de hachage ait été choisi pour la jointure et non la boucle imbriquée, sinon nous aurions eu non pas un seul passage de CTE Scan, mais 10K !
un peu sur CTE Scan
Il faut se rappeler quele CTE Scan est l'équivalent du Seq Scan — donc aucune indexation, seulement un balayage complet qui nécessiterait 10K x 0.3ms = 3000ms pour les itérations sur cte_max 1K x 1.5ms = ou 1500ms pour les itérations sur cte_bind En fait, que voulions-nous obtenir en résultat ?!
Ah, généralement, une telle question surgit vers la cinquième minute d'analyse des requêtes « à trois niveaux ». Nous voulions afficher pour chaque paire de clés unique
les valeurs min/max du groupe par key_a Alors, utilisons des.
fonctions de fenêtre :
SÉLECTIONNER DISTINCT SUR(key_a, key_b)
	key_a a
,	key_b b
,	max(fld1) OVER(w) bind_fld1
,	min(fld2) OVER(w) bind_fld2
DE
	tbl
FENÊTRE
w COMME (PARTITIONNER PAR key_a); 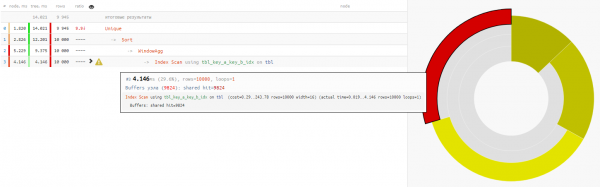
Comme la lecture des données dans les deux cas prend environ 4 à 5 ms, notre gain de temps total -32% — est pur et simple la charge retirée du CPU de la base, si une telle requête est exécutée suffisamment souvent.
En général, il ne faut pas forcer la base à « porter du rond, rouler du carré ».
Source : habr.com
