

Méfiez-vous des opérations, des buffers apportant...
Prenons un exemple d'une petite requête pour examiner certaines approches universelles pour optimiser les requêtes sur PostgreSQL. Les utiliser ou non - c'est à vous de décider, mais il est bon d'en avoir connaissance.
Dans certaines versions ultérieures de PG, la situation pourrait évoluer avec l'intelligence croissante du planificateur, mais pour 9.4/9.6, cela semble à peu près identique, comme le montrent les exemples ici.
Prenons une requête tout à fait réelle :
SELECT
  TRUE
FROM
  "Document" d
INNER JOIN
  "DocumentExtension" doc_ex
    USING("@Document")
INNER JOIN
  "DocumentType" t_doc ON
    t_doc."@DocumentType" = d."DocumentType"
WHERE
  (d."Person3" = 19091 or d."Employee" = 19091) AND
  d."$Draft" IS NULL AND
  d."Deleted" IS NOT TRUE AND
  doc_ex."State"[1] IS TRUE AND
  t_doc."DocumentType" = 'WorkPlan'
LIMIT 1;
sur les noms de tables et de champsOn peut avoir des opinions différentes sur les noms de champs et de tables « russes », mais c'est une question de goût. Étant donné que n'avons pas de développeurs étrangers, et PostgreSQL nous permet de donner des noms même en idéogrammes, à condition qu'ils soient entourés de guillemets, nous préférons nommer les objets de manière claire et explicite, pour éviter les ambiguïtés.
Jetons un œil au plan obtenu :
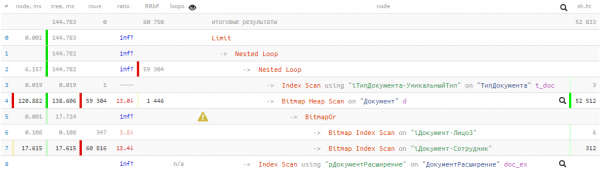
144ms et presque 53K buffers — c'est-à-dire plus de 400 Mo de données ! Et nous aurons de la chance si tout cela se trouve dans le cache au moment de notre requête, sinon elle prendra des fois plus de temps à être lue depuis le disque.
L'algorithme est le plus important !
Pour optimiser une requête, il faut d'abord comprendre ce qu'elle est censée faire.
Laissons pour l'instant de côté le développement de la structure même de la base de données, et convenons que nous pouvons relativement « facilement » réécrire la requête et/ou ajouter à la base certains indices dont nous avons besoin Donc, la requête :.
— vérifie l'existence d'un document
— dans l'état souhaité et de type spécifique
— où l'auteur ou l'exécutant est l'employé dont nous avons besoin
JOIN + LIMIT 1
Il est assez fréquent qu'un développeur préfère écrire une requête dans laquelle il fait d'abord des jointures entre de nombreuses tables, puis il ne reste qu'un seul enregistrement de ce grand ensemble. Mais ce qui est plus facile pour le développeur n'est pas toujours plus efficace pour la base de données.
Dans notre cas, il n'y avait que 3 tables - et quel effet…
Commençons par éliminer la jointure avec la table « DocumentType », et au passage indiquons à la base de données que
l'enregistrement de type est unique (nous le savons, mais le planificateur ne s'en doute pas encore) : (nous le savons, mais le planificateur ne le soupçonne pas encore) :
AVEC T COMME (
  SÉLECTIONNER
    "@TypeDeDocument"
  DE
    "TypeDeDocument"
  OÙ
    "TypeDeDocument" = 'PlanDeTravail'
  LIMIT 1
)
...
OÙ
  d."TypeDeDocument" = (TABLE T)
...
Oui, si la table/CTE consiste en un seul champ d'un seul enregistrement, alors dans PG, on peut même écrire ainsi, au lieu de
d."TypeDeDocument" = (SÉLECTIONNER "@TypeDeDocument" DE T LIMIT 1)Calculs « paresseux » dans les requêtes PostgreSQL
BitmapOr vs UNION
Dans certains cas, le Bitmap Heap Scan peut nous coûter très cher — par exemple ici, où beaucoup d'enregistrements répondent à la condition requise. Nous avons obtenu cela à cause de la condition OR, devenue BitmapOr- opération dans le plan.
Revenons à la tâche initiale — il faut trouver un enregistrement correspondant à n'importe lequel des conditions — c'est-à-dire qu'il n'est pas nécessaire de chercher tous les 59K enregistrements selon les deux conditions. Il y a un moyen de traiter une condition, puis de passer à la seconde seulement si rien n'a été trouvé dans la première.Nous aidera une telle construction :
(
  SÉLECTIONNER
    ...
  LIMIT 1
)
UNION ALL
(
  SÉLECTIONNER
    ...
  LIMIT 1
)
LIMIT 1
« LIMIT 1 extérieur » garantit que la recherche s'arrêtera dès que le premier enregistrement sera trouvé. Et s'il est trouvé dans le premier bloc, le second ne sera pas exécuté (never executed dans le plan).
« Cacher sous CASE » des conditions complexes
Dans la requête initiale, il y a un point très gênant — la vérification de l'état dans la table liée « DocumentExtension ». Indépendamment de la véracité des autres conditions dans l'expression (par exemple, d.«Supprimé» IS NOT TRUE), cette jointure est toujours effectuée et « consomme des ressources ». Plus ou moins, cela dépend du volume de cette table.
Mais on peut modifier la requête de sorte que la recherche de l'enregistrement lié se fasse uniquement lorsque c'est réellement nécessaire :
SÉLECTIONNER
  ...
DE
  "Document" d
OÙ
  ...
  /*index cond*/ ET
  CASE
    QUAND "$Brouillon" EST NULL ET "Supprimé" IS NOT TRUE ALORS (
      SÉLECTIONNER
        "État"[1] IS TRUE
      DE
        "DocumentExtension"
      OÙ
        "@Document" = d."@Document"
    )
  FIN
Puisque nous n'avons besoin d'aucun des champs de la table liée pour le résultat, nous avons la possibilité de transformer la JOIN en condition par sous-requête.
Nous laisserons les champs indexables « en dehors » du CASE, nous mettons les conditions simples dans le bloc WHEN — et maintenant, la requête « lourde » n'est exécutée que lorsqu'on entre dans le THEN.
Mon nom de famille est « Total »
Nous rassemblons la requête résultante avec tous les mécanismes décrits ci-dessus :
AVEC T COMME (
  SÉLECTIONNEZ
    "@TypeDocument"
  DE
    "TypeDocument"
  OÙ
    "TypeDocument" = 'PlanTravail'
)
  (
    SÉLECTIONNEZ
      VRAI
    À PARTIR DE
      "Document" d
    OÙ
      ("Personne3", "TypeDocument") = (19091, (TABLE T)) ET
      CAS
        QUAND "$Brouillon" EST NULL ET "Supprimé" N'EST PAS VRAI ALORS (
          SÉLECTIONNEZ
            "État"[1] EST VRAI
          DE
            "DocumentExtension"
          OÙ
            "@Document" = d."@Document"
        )
      FIN
    LIMIT 1
  )
UNION ALL
  (
    SÉLECTIONNEZ
      VRAI
    À PARTIR DE
      "Document" d
    OÙ
      ("TypeDocument", "Employé") = ((TABLE T), 19091) ET
      CAS
        QUAND "$Brouillon" EST NULL ET "Supprimé" N'EST PAS VRAI ALORS (
          SÉLECTIONNEZ
            "État"[1] EST VRAI
          DE
            "DocumentExtension"
          OÙ
            "@Document" = d."@Document"
        )
      FIN
    LIMIT 1
  )
LIMIT 1;
Adapté [à] des index
Un œil averti a remarqué que les conditions indexées dans les sous-blocs UNION varient légèrement — c'est parce que nous avons déjà des index appropriés sur la table. Et s'il n'y en avait pas — il vaudrait mieux les créer : Document(Personne3, TypeDocument) et Document(TypeDocument, Employé).
sur l'ordre des champs dans les conditions ROWDu point de vue du planificateur, bien sûr, il est également possible d'écrire (A, B) = (constA, constB)et (B, A) = (constB, constA). Mais lors de l'écriture dans l'ordre des champs dans l'index, cette requête est tout simplement plus facile à déboguer.
Qu'est-ce au programme ?
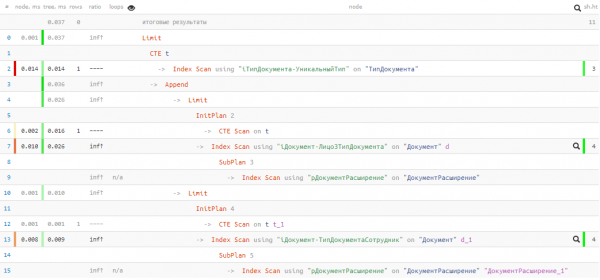
Malheureusement, nous n'avons pas eu de chance, et rien n'a été trouvé dans le premier bloc UNION, donc le second a finalement été exécuté. Mais même dans ce cas — seulement 0,037 ms et 11 buffers!
Nous avons accéléré la requête et réduit le "traitement" des données en mémoire de plusieurs milliers de fois, en utilisant des méthodes assez simples — un bon résultat avec peu de copier-coller. 🙂
Source : habr.com
