

Bonjour, utilisateurs de Habr. Les cours de la première groupe commencent aujourd'hui. . À ce sujet, nous souhaitons vous parler de la manière dont s'est déroulé le webinaire ouvert sur ce cours.
Dans nous avons discuté des défis auxquels les bases de données SQL sont confrontées à l'ère des clouds et de Kubernetes. Nous avons également examiné comment les bases de données SQL s'adaptent et évoluent face à ces défis.
Le webinaire a été dirigé par , Google Cloud Practice Delivery Manager chez EPAM Systems.
Quand les arbres étaient petits…
Pour commencer, rappelons-nous comment le choix des SGBD a commencé à la fin du XXe siècle. Cela ne devrait pas être difficile, car le choix des SGBD à cette époque commençait et se terminait par Oracle.
À la fin des années 90 et au début des années 2000, il n'y avait essentiellement pas de choix, pour ce qui est des bases de données évolutives industrielles. Oui, il y avait IBM DB2, Sybase et quelques autres bases de données qui apparaissaient et disparaissaient, mais dans l'ensemble, elles étaient moins remarquables face à Oracle. Par conséquent, les compétences des ingénieurs de cette époque étaient inévitablement liées à ce seul choix qui existait.
Un DBA Oracle devait savoir :
- installer Oracle Server à partir d'un distributeur ;
- configurer Oracle Server :
- init.ora ;
- listener.ora ;
— créer :
- espace de tables ;
- schémas ;
- utilisateurs ;
— effectuer des sauvegardes et des restaurations ;
— effectuer un suivi ;
— lutter contre les requêtes non optimales.
Cependant, on n'attendait pas particulièrement d'un DBA Oracle :
- d'être capable de choisir le SGBD optimal ou une autre technologie de stockage et de traitement des données ;
- de garantir une haute disponibilité et une évolutivité horizontale (ce n'était pas toujours une question pour le DBA) ;
- de bien connaître le domaine, l'infrastructure, l'architecture applicative, le système d'exploitation ;
- d'effectuer le chargement et le déchargement des données, la migration des données entre différents SGBD.
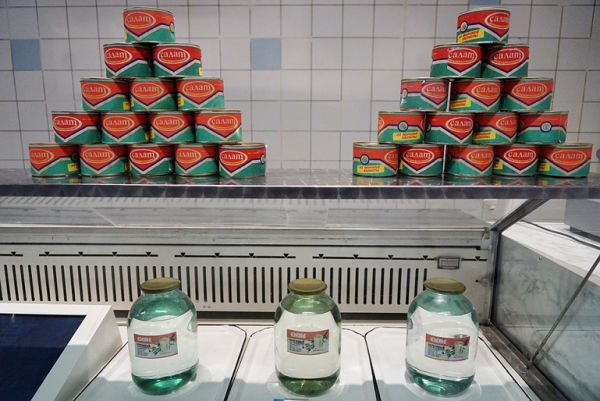
En gros, si l'on parle des choix de cette époque, cela rappele le choix dans un magasin soviétique à la fin des années 80 :
Notre époque
Depuis, en effet, les arbres ont grandi, le monde a changé et cela a évolué comme suit :
Le marché des SGBD a également changé, ce qui est bien visible dans le dernier rapport de Gartner :
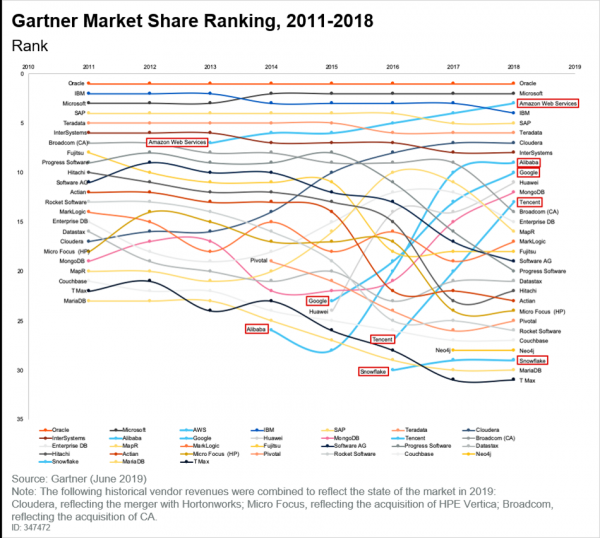
Et il est impossible de ne pas noter que les clouds ont trouvé leur niche, dont la popularité augmente. Si l'on lit le même rapport de Gartner, on y voit les conclusions suivantes :
- Beaucoup de clients sont en train de migrer leurs applications vers le cloud.
- Les nouvelles technologies apparaissent d'abord dans le cloud, et il n'est pas certain qu'elles passent un jour à une infrastructure non cloud.
- Le modèle de tarification au principe du pay-as-you-go est devenu habituel. Tout le monde souhaite ne payer que pour ce qu'il utilise, et ce n'est même plus une tendance, mais simplement un constat.
Et maintenant ?
Aujourd'hui, nous sommes tous dans le cloud. Les questions qui se posent sont des questions de choix. Et ce choix est énorme, même si l'on parle uniquement des technologies de SGBD en mode On-premises. De plus, nous avons des services gérés et du SaaS. Ainsi, le choix ne fait que devenir plus complexe chaque année.
En parallèle des questions de choix, il existe aussi des facteurs limitants:
- le prix. De nombreuses technologies coûtent encore de l'argent ;
- les compétences. Si nous parlons de logiciels libres, la question des compétences se pose, car les logiciels gratuits demandent aux personnes qui les déploient et les exploitent une compétence suffisante ;
- les fonctionnalités. Tous les services disponibles dans le cloud, même construits sur la base de Postgres, ne possèdent pas les mêmes fonctionnalités que Postgres On-premises. C'est un facteur essentiel à connaître et à comprendre. De plus, ce facteur revêt une importance croissante par rapport à la connaissance de certaines fonctionnalités cachées d'un SGBD donné.
Ce que l'on attend actuellement des DA/DE :
- une bonne compréhension du domaine d'activité et de l'architecture applicative ;
- la capacité à choisir correctement la technologie de SGBD en fonction de la tâche assignée ;
- la capacité à sélectionner la méthode d'implémentation optimale de la technologie choisie dans le contexte des contraintes existantes ;
- la capacité à effectuer des transferts et des migrations de données ;
- la capacité à réaliser et exploiter les solutions choisies.
L'exemple ci-dessous basé sur GCP démontre comment le choix d'une technologie de traitement des données est influencé par leur structure :
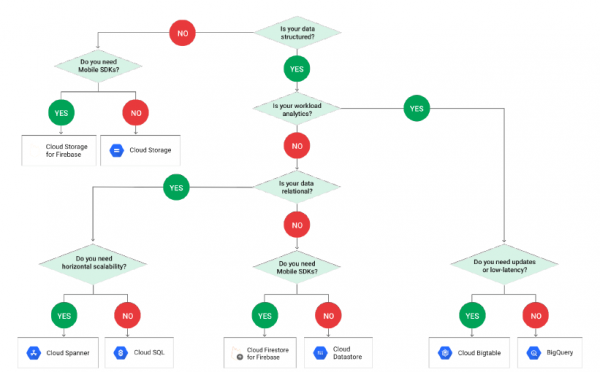
Notez que dans le schéma, PostgreSQL est absent, car il est caché derrière la terminologie Cloud SQL. Et lorsque nous accédons à Cloud SQL, nous devons à nouveau faire un choix :
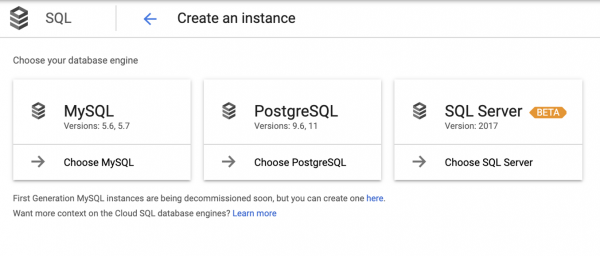
Il convient de noter que ce choix n'est pas toujours clair, c'est pourquoi les développeurs d'application se basent souvent sur leur intuition.
Total :
- Plus on avance, plus la question du choix devient pertinente. Et même en se concentrant uniquement sur GCP, les services gérés et le SaaS, on ne mentionne les SGBD relationnels qu'à la quatrième étape (et là, Spanner est à côté). De plus, le choix de PostgreSQL n'apparaît qu'à la cinquième étape, avec MySQL et SQL Server juste à côté, ce qui signifie qu'il y a beaucoup d'options, mais il faut faire un choix.
- Il ne faut pas oublier les limitations face aux tentations. En général, tout le monde veut Spanner, mais il est coûteux. Au final, une demande typique ressemble à ceci : « Faites-nous, s'il vous plaît, un Spanner mais au prix de Cloud SQL, vous êtes des professionnels après tout ! »
Et que faire alors ?
Sans prétendre avoir la vérité absolue, disons ceci :
Il faut changer d'approche en matière de formation :
- former comme on formait auparavant les DBA n'a pas de sens ;
- la connaissance d'un seul produit est désormais insuffisante ;
- et connaître des dizaines de produits au niveau d'un seul est impossible.
Il faut savoir non seulement quel produit, mais aussi :
- les cas d'utilisation de son application ;
- les différentes méthodes de déploiement ;
- les avantages et les inconvénients de chaque méthode ;
- des produits similaires et alternatifs, afin de faire un choix éclairé et optimal et pas toujours en faveur d'un produit familier.
Et il faut également savoir migrer les données et comprendre les principes de base de l'intégration avec l'ETL.
Un cas réel
Dans un passé récent, j'ai dû créer le backend d'une application mobile. Au moment où j'ai commencé à travailler dessus, le backend était déjà développé et prêt à être intégré, et l'équipe de développeurs avait passé environ deux ans sur ce projet. Les tâches suivantes avaient été définies :
- mettre en place un CI/CD ;
- réaliser une revue de l'architecture ;
- mettre tout cela en production.
L'application elle-même était microservices, et le code en Python/Django avait été développé de zéro et directement dans GCP. En ce qui concerne le public cible, on supposait qu'il y aurait deux régions - les États-Unis et l'UE, et le trafic était réparti via un équilibreur de charge global. Tous les Workloads et la charge de calcul fonctionnaient dans Google Kubernetes Engine.
Concernant les données, il y avait trois structures :
- Cloud Storage ;
- Datastore ;
- Cloud SQL (PostgreSQL).
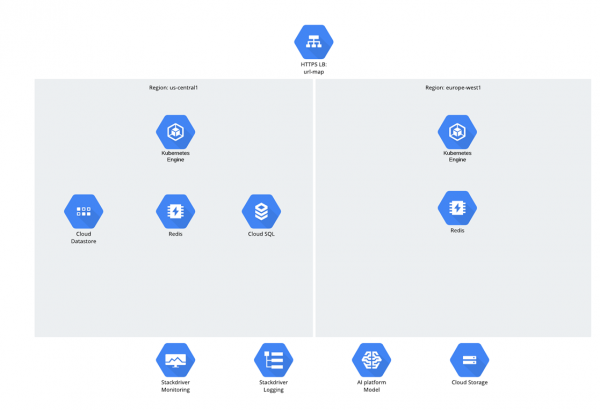
On peut se demander pourquoi Cloud SQL a été choisi ? Pour être honnête, une telle question crée une sorte de malaise ces dernières années - on a l'impression que les gens commencent à avoir honte des bases de données relationnelles, mais néanmoins, elles continuent d'être activement utilisées ;-).
Pour notre cas, Cloud SQL a été choisi pour les raisons suivantes :
- Comme mentionné, l'application a été développée avec Django, et elle dispose d'un modèle qui affiche des données persistantes depuis une base de données SQL sous forme d'objets Python (Django ORM).
- Le framework prend en charge une liste finale assez limitée de SGBD :
- PostgreSQL ;
- MariaDB ;
- MySQL ;
- Oracle ;
- SQLite.
Par conséquent, PostgreSQL a été choisi intuitivement parmi cette liste (après tout, il n'était pas question de choisir Oracle).
Ce qui manquait :
- l'application n'était déployée que dans 2 régions, et un 3ème (Asie) était prévu ;
- la base de données se trouvait en région nord-américaine (Iowa) ;
- le client avait des inquiétudes concernant d'éventuels retards d'accès en provenance d'Europe et d'Asie et des interruptions de service en cas de temps d'arrêt de la SGBD.
Bien que Django puisse travailler avec plusieurs bases de données en parallèle et les séparer par lecture et écriture, le nombre d'écritures dans l'application n'était pas si élevé (plus de 90 % étant des lectures). En général, s'il était possible de créer une réplication de lecture de la base principale en Europe et en Asie,ce serait une solution de compromis. Et qu'est-ce qui est si compliqué ?
La difficulté résidait dans le fait que le client ne voulait pas renoncer à l'utilisation des services gérés et de Cloud SQL. Les capacités de Cloud SQL sont actuellement limitées. Cloud SQL prend en charge la haute disponibilité (HA) et la réplication de lecture (RR), mais la RR n'est prise en charge que dans une seule région. En créant une base de données dans la région américaine, il n'est pas possible de faire une réplication de lecture dans la région européenne avec les outils de Cloud SQL, bien que PostgreSQL le permette. La correspondance avec les employés de Google n'a abouti à rien et s'est terminée par des promesses du type « nous connaissons le problème et travaillons dessus, la question sera résolue un jour ».
Pour énumérer les capacités de Cloud SQL en bullet points, cela ressemblerait approximativement à :
1. Haute disponibilité (HA) :
- dans une seule région ;
- via la réplication des disques ;
- les mécanismes de PostgreSQL ne sont pas utilisés ;
- gestion automatique et manuelle possible — basculement/retour ;
- lors du basculement, la SGBD est inaccessible pendant plusieurs minutes.
2. Réplication de lecture (RR) :
- dans une seule région ;
- hot standby ;
- réplication en continu de PostgreSQL.
De plus, comme c'est souvent le cas, lors du choix d'une technologie, on se heurte à certaines limitations:
- le client ne voulait pas créer de nouvelles entités et utiliser l'IaaS, sauf par le biais de GKE ;
- le client ne souhaitait pas déployer PostgreSQL/MySQL en libre-service ;
- En fait, Google Spanner conviendrait parfaitement, si ce n'était son prix. Cependant, il ne peut pas être utilisé avec Django ORM, mais c'est tout de même un bon outil.
Compte tenu de la situation, le client a posé une question originale : « Pouvez-vous faire quelque chose de similaire, qui fonctionne comme Google Spanner, mais qui fonctionne aussi avec Django ORM ? »
Option de solution n° 0
La première pensée qui m'est venue :
- rester dans le cadre de CloudSQL ;
- il n'y aura pas de réplication intégrée entre les régions, sous aucune forme ;
- essayer d'ajouter une réplique à l'existant Cloud SQL basé sur PostgreSQL ;
- installer quelque part une instance PostgreSQL, mais ne pas toucher au minimum à la master.
Malheureusement, il s'est avéré que cela n'était pas possible car il n'y a pas d'accès au serveur (il se trouve dans un autre projet) - pg_hba et ainsi de suite, et en plus, il n'y a pas d'accès en tant que superutilisateur.
Option de solution n° 1
Après d'autres réflexions et en tenant compte des circonstances précédentes, le raisonnement a quelque peu changé :
- nous essayons toujours de rester dans le cadre de CloudSQL, mais nous passons à MySQL, car Cloud SQL basé sur MySQL a un master externe, qui :
— sert de proxy pour un MySQL externe ;
— ressemble à une instance de MySQL ;
— a été conçu pour la migration de données depuis d'autres clouds ou sur site.
Comme la configuration de la réplication MySQL ne nécessite pas d'accès au serveur, cela a généralement fonctionné, mais très de manière instable et peu pratique. Et lorsque nous avons progressé, cela est devenu effrayant, car nous déployions toute la structure avec terraform, et s'est avéré que le master externe n'était pas supporté par terraform. Oui, Google a un CLI, mais curieusement, cela fonctionnait parfois — parfois il se créait, parfois non. Peut-être parce que le CLI a été conçu pour la migration de données depuis l'extérieur et non pour les répliques.
Il est donc devenu clair que Cloud SQL ne convient pas du tout. Comme on dit, nous avons fait tout ce que nous pouvions.
Option de solution n° 2
Puisque nous n'avons pas pu rester dans le cadre de Cloud SQL, nous avons essayé de formuler les exigences pour une solution de compromis. Les exigences étaient les suivantes :
- fonctionnement dans Kubernetes, utilisation maximale des ressources et des capacités de Kubernetes (DCS,...) et GCP (LB,...) ;
- absence de ballast avec une multitude de choses inutiles dans le cloud comme HA proxy ;
- possibilité de lancer HA PostgreSQL ou MySQL dans la région principale ; dans les autres régions - HA des RR de la région principale plus sa copie (pour la fiabilité) ;
- multi master (bien que nous ne voulions pas trop nous y attacher, ce n'était pas très essentiel)
.
En résultat de ces exigences, enfin, une apparition de poptions de SGBD appropriés et de liaison:
- MySQL Galera;
- CockroachDB;
- outils PostgreSQL
:
— pgpool-II;
— Patroni.
MySQL Galera
La technologie MySQL Galera a été développée par Codership et constitue un plugin pour InnoDB. Caractéristiques :
- multi maître;
- réplication synchrone;
- lecture depuis n'importe quel nœud;
- écriture sur n'importe quel nœud;
- mécanisme HA intégré;
- il existe un chart Helm de Bitnami.
CockroachDB
De la description, c'est un projet absolument incroyable et représente un projet open source, écrit en Go. Le participant principal est Cockroach Labs (fondé par des anciens de Google). Ce SGBD relationnel a été conçu dès le départ pour être distribué (avec un scaling horizontal ‘out-of-the-box’) et tolérant aux pannes. Ses auteurs ont affirmé vouloir « combiner la richesse des fonctionnalités SQL avec la disponibilité horizontale, typique des solutions NoSQL ».
Comme avantage agréable — support du protocole de connexion PostgreSQL.
Pgpool
C'est une surcouche à PostgreSQL, en réalité, une nouvelle entité, prenant en charge toutes les connexions et les traitant. Dispose de son propre load balancer et parser, licencié sous la licence BSD. Offre de larges possibilités, mais paraît un peu effrayant, car la présence d'une nouvelle entité pouvait devenir une source de complications supplémentaires.
Patroni
C'est le dernier sur quoi j'ai jeté mon dévolu, et il s'avère que ce n'était pas en vain. Patroni est un utilitaire open source qui est, en réalité, un daemon en Python, permettant de gérer automatiquement des clusters PostgreSQL avec différents types de réplication et un basculement automatique des rôles. Ça s'est révélé très intéressant, car ça s'intègre bien avec Kubernetes et n'implique pas de nouvelles entités.
Donc, que soumettons-nous ?
Le choix n'a pas été facile :
- CockroachDB — génial, mais risqué;
- MySQL Galera — pas mal non plus, utilisé dans de nombreux endroits, mais MySQL;
- Pgpool — beaucoup d'entités superflues, intégration médiocre avec le cloud et K8s;
- Patroni — excellente intégration avec K8s, pas d'entités superflues, bien intégré avec GCP LB.
Ainsi, le choix s'est porté sur Patroni.
Conclusions
Il est temps de faire un bref résumé. Oui, le monde des infrastructures IT a considérablement changé, et ce n'est que le début. Et si auparavant, les clouds n'étaient qu'un autre type d'infrastructure, maintenant c'est tout différent. De plus, les innovations dans les clouds apparaissent constamment, et resteront, et peut-être qu'elles n'apparaîtront que dans les clouds et seront ensuite, par la force des startups, transférées en On-premises.
En ce qui concerne SQL, SQL est là pour rester. Cela signifie qu'il est nécessaire de connaître et de savoir travailler avec PostgreSQL et MySQL, mais il est encore plus important de savoir les appliquer correctement.
Source : habr.com
