

Il est connu que la compétence d'un CTO ne se vérifie qu'à la deuxième prise de sa fonction. Car il y a une différence entre travailler plusieurs années dans une entreprise, évoluer avec elle et, restant dans le même contexte culturel, obtenir progressivement plus de responsabilités. Et il en est tout autre de devenir tout de suite CTO dans une entreprise avec un héritage de problèmes et une multitude de soucis soigneusement dissimulés sous le tapis.
Dans ce sens, l'expérience de Léon Fayer, dont il a partagé les détails sur , n'est pas vraiment unique, mais multipliée par ses années d'expérience et les différents rôles qu'il a endossés pendant 20 ans, elle s'avère très utile. Ci-dessous, vous trouverez la chronologie des événements sur 90 jours et de nombreuses anecdotes amusantes, qui, bien qu'elles soient agréables à écouter chez les autres, ne sont pas si réjouissantes à vivre soi-même.
Léon raconte avec beaucoup de couleurs en russe, donc si vous avez 35-40 minutes, je recommande de regarder la vidéo. La version texte pour gagner du temps est ci-dessous.
La première version du rapport était une description bien structurée du travail avec les personnes et les processus, contenant des recommandations utiles. Mais elle ne reflétait pas toutes les surprises rencontrées en chemin. C'est pourquoi j'ai changé de format et exposé les problèmes qui surgissaient dans la nouvelle entreprise comme un diable de sa boîte, ainsi que les méthodes pour les résoudre, dans un ordre chronologique.
Un mois avant
Comme beaucoup de bonnes histoires, celle-ci a commencé avec de l'alcool. Nous étions assis dans un bar avec des connaissances, et comme il se doit dans le milieu des informaticiens, chacun se plaignait de ses problèmes. L'un d'eux venait de changer de travail et parlait de ses difficultés, qu'elles soient techniques, humaines ou liées à son équipe. Plus j'écoutais, plus je réalisais qu'il devait simplement m'embaucher, car c'étaient précisément les types de problèmes que j'avais résolus ces 15 dernières années. Je lui ai dit cela, et le lendemain, nous nous sommes rencontrés dans un cadre professionnel. L'entreprise s'appelait Teaching Strategies.
Teaching Strategies est le leader sur le marché des programmes éducatifs pour les très jeunes enfants — de la naissance à trois ans. L'entreprise « traditionnelle » existe depuis 40 ans, tandis que la version SaaS numérique de la plateforme a 10 ans. Récemment, le processus d'adaptation de la technologie numérique aux normes de l'entreprise a commencé. La « nouvelle » version a été lancée en 2017 et était presque identique à l'ancienne, à la seule différence qu'elle fonctionnait moins bien.
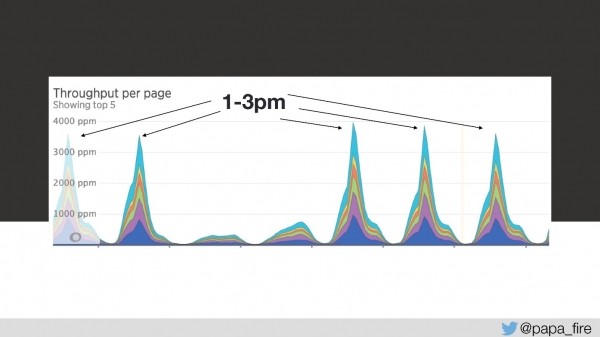
Ce qui est le plus intéressant, c'est que le trafic de cette entreprise est très prévisible — jour après jour, année après année, il est très facile de prévoir combien de personnes viendront et quand. Par exemple, entre 13h et 15h, tous les enfants des crèches font la sieste, tandis que les enseignants commencent à saisir des informations. Cela se reproduit chaque jour, sauf le week-end, car presque personne ne travaille le week-end.
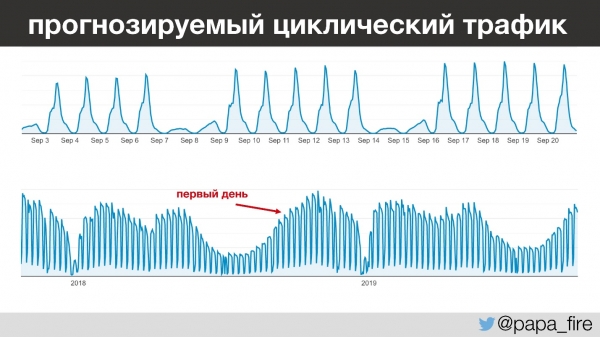
Pour anticiper un peu, je tiens à préciser que j'ai commencé mon travail pendant la période de trafic annuel le plus élevé, ce qui est intéressant pour différentes raisons.
La plateforme, qui semblait n'avoir que 2 ans, avait une stack plutôt singulière : ColdFusion et SQL Server 2008. ColdFusion, si vous ne le savez pas, et il y a de fortes chances que vous ne le sachiez pas, est une sorte de PHP d'entreprise qui est apparu au milieu des années 90, et depuis, je n'en avais pas entendu parler. Il y avait aussi : Ruby, MySQL, PostgreSQL, Java, Go, Python. Mais le monolithe principal fonctionnait sur ColdFusion et SQL Server.
Problèmes
Plus je parlais avec les employés de l'entreprise de leur travail et des problèmes rencontrés, plus je comprenais que les problèmes n'étaient pas seulement d'ordre technique. Bien sûr, la technologie est ancienne — et nous avons déjà travaillé sur des systèmes similaires, mais il y avait des problèmes avec l'équipe et les processus, et l'entreprise commençait à comprendre cela.
Traditionnellement, les techniciens étaient dans un coin et faisaient leur propre travail. Mais de plus en plus de l'activité passait par la version numérique. Ainsi, dans l'année précédant le début de mon travail, de nouveaux postes avaient été créés dans l'entreprise : conseil d'administration, CTO, CPO et directeur QA. Cela signifie que l'entreprise a commencé à investir dans le domaine technologique.
Les traces d'un lourd héritage n'étaient pas seulement présentes dans les systèmes. L'entreprise avait des processus hérités, des personnes héritées, une culture héritée. Tout cela devait être changé. J'ai pensé que je ne m'ennuierais certainement pas, et j'ai décidé d'essayer.
Deux jours avant
Deux jours avant le début de mon nouveau travail, je suis arrivé au bureau, j'ai rempli les derniers documents, j'ai rencontré l'équipe et j'ai découvert que l'équipe était en train de lutter avec un problème. Celui-ci consistait à ce que le temps de chargement moyen des pages avait grimpé à 4 secondes, soit le double.
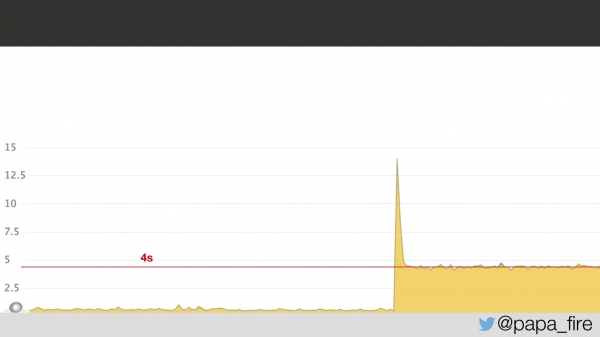
À en juger par le graphique, il était évident que quelque chose s'était passé, et il était difficile de dire quoi. Il s'est avéré que le problème était dû à une latence réseau dans le datacenter : 5 ms de latence dans le datacenter se traduisaient par 2 secondes pour les utilisateurs. Pourquoi cela s'était produit, je ne le savais pas, mais en tout cas, il est devenu clair que le problème venait du datacenter.
Jour un
Deux jours ont passé, et le premier jour de travail, j'ai découvert que le problème était toujours présent.
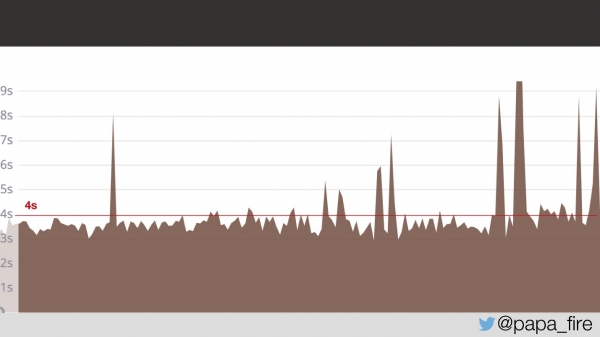
Pendant deux jours, les pages avaient un temps de chargement moyen de 4 secondes. Je demande s'ils ont trouvé d'où venait le problème.
— Oui, nous avons ouvert un ticket.
— Et ?
— Eh bien, ils ne nous ont pas encore répondu.
À ce moment-là, j'ai compris que tout ce qu'on m'avait dit jusqu'à présent n'était que le petit sommet de l'iceberg qu'il fallait affronter.
Il y a une bonne citation qui convient parfaitement à ce cas :
« Parfois, pour changer la technologie, il faut changer l'organisation. »
Mais comme j'ai commencé à travailler pendant la période la plus chargée de l'année, je devais envisager les deux solutions au problème : rapide et à long terme. Et commencer par ce qui était critique immédiatement.
Troisième jour
Ainsi, le chargement dure 4 secondes, et de 13h à 15h, les pics sont les plus élevés.
Le troisième jour, à cette période, la vitesse de chargement était la suivante :
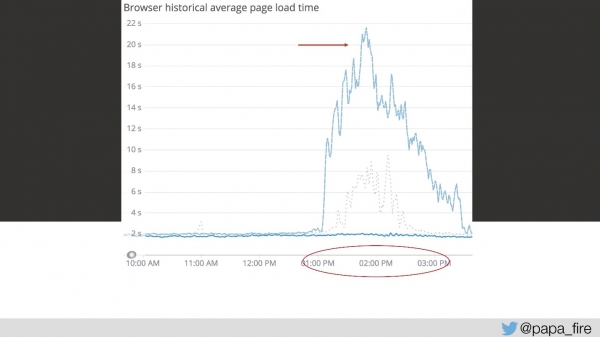
De mon point de vue, rien ne fonctionnait vraiment. Du point de vue de tout le monde, cela fonctionnait un peu plus lentement que d'habitude. Mais ça ne peut pas être si simple — c'est un problème sérieux.
J'ai essayé de convaincre l'équipe, mais on m'a répondu qu'il fallait simplement plus de serveurs. C'est évidemment une solution au problème, mais ce n'est pas toujours la seule et la plus efficace. J'ai demandé pourquoi il manquait des serveurs, quel était le volume de trafic. J'ai extrapolé les données et obtenu qu'il y avait environ 150 requêtes par seconde, ce qui reste raisonnable.
Mais il ne faut pas oublier qu'avant d'obtenir la bonne réponse, il faut poser la bonne question. Ma question suivante était : combien avons-nous de serveurs frontaux ? La réponse m'a « un peu surpris » — nous avions 17 serveurs frontaux !
— Je suis un peu gêné de demander, 150 divisé par 17, cela fait environ 8 ? Vous voulez dire que chaque serveur traite 8 requêtes par seconde, et si demain il y a 160 requêtes par seconde, il nous faudrait 2 serveurs supplémentaires ?
Bien sûr, nous n'avions pas besoin de serveurs supplémentaires. La solution se trouvait dans le code, et elle était évidente :
var currentClass = classes.getCurrentClass();
return currentClass;
Il y avait une fonction getCurrentClass(), car tout sur le site fonctionne dans le contexte de la classe — c'est exact. Et cette seule fonction sur chaque page générait plus de 200 requêtes.
Ainsi, la solution était très simple, il suffisait de ne pas redemander la même information.
if ( !isDefined("REQUEST.currentClass") ) {
    var classes = new api.private.classes.base();
   REQUEST.currentClass = classes.getCurrentClass();
}
return REQUEST.currentClass;
J'étais très heureux car j'ai décidé qu'au troisième jour, j'avais trouvé le principal problème. Comme j'étais naïf, c'était juste un des nombreux problèmes.
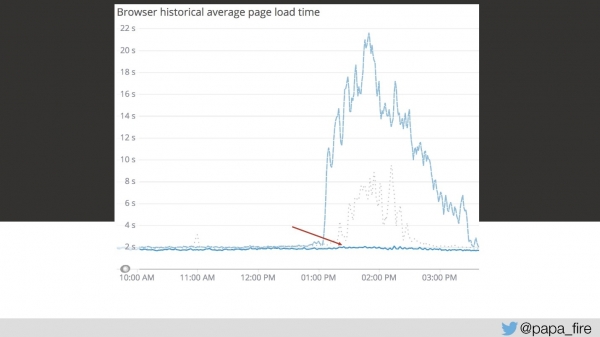
Mais la résolution de ce premier problème a fait baisser considérablement le calendrier.
En même temps, nous travaillions sur d'autres optimisations. Il y avait beaucoup de choses à réparer. Par exemple, le même troisième jour, j'ai découvert qu'il y avait effectivement un cache dans le système (au début, je pensais que toutes les requêtes venaient directement de la base de données). Quand je pense au cache, j'imagine les standards Redis ou Memcached. Mais c'était seulement moi qui pensais ainsi, car pour la mise en cache dans ce système, MongoDB et SQL Server étaient utilisés — celui dont nous venions juste de lire les données.
Dixième jour
La première semaine, je m'occupais des problèmes qui devaient être résolus immédiatement. Vers le deuxième semaine, je suis venu pour la première fois à un stand-up pour discuter avec l'équipe, voir ce qui se passait et comment se déroulait tout le processus.
On a encore découvert quelque chose d'intéressant. L'équipe était composée de : 18 développeurs ; 8 testeurs ; 3 chefs de projet ; 2 architectes. Et tous participaient aux rituels collectifs, c'est-à-dire que plus de 30 personnes se réunissaient chaque matin pour le stand-up et racontaient ce qu'elles avaient fait. Il était évident que la réunion ne durait pas 5 ou 15 minutes. Personne n'écoutait vraiment, car tout le monde travaillait sur des systèmes différents. Dans ce format, 2-3 tickets par heure lors de la session de grooming étaient déjà un bon résultat.
La première chose que nous avons faite a été de diviser l'équipe en plusieurs groupes par ligne de produits. Pour différentes sections et systèmes, nous avons formé des équipes distinctes, comprenant des développeurs, des testeurs, des chefs de produit, et des analystes métiers.
En résultat, nous avons obtenu :
- Réduction des stand-ups et des réunions.
- Connaissance approfondie du produit.
- Sentiment de propriété. Avant, lorsque les gens étaient constamment affectés aux systèmes, ils savaient que c'était probablement quelqu'un d'autre qui devrait travailler sur leurs bugs, et non eux-mêmes.
- Collaboration entre les groupes. Il n'est pas nécessaire de dire que QA et les programmeurs ne communiquaient pas beaucoup auparavant, le chef de produit faisait son propre travail, etc. Maintenant, ils ont un point de responsabilité commun.
Nous nous sommes principalement concentrés sur l'efficacité, la performance et la qualité — ce sont exactement les problèmes que nous avons tenté de résoudre en transformant l'équipe.
Onzième jour
Dans le processus de changement de la structure de l'équipe, j'ai découvert comment ils comptent HistoirePoints. 1 SP équivalait à un jour, et chaque ticket contenait des SP pour le développement et pour la QA, soit au moins 2 SP.
Comment l'ai-je découvert ?
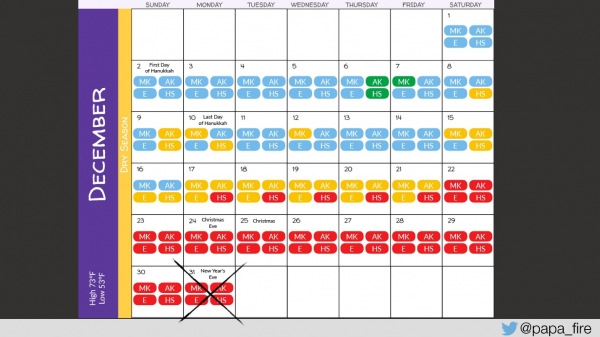
Nous avons trouvé un bug : dans l'un des rapports où la date de début et de fin de la période pour laquelle le rapport est demandé est saisie, le dernier jour n'est pas pris en compte. Il semblait donc qu'il y avait un < dans la requête au lieu de <=. On m'a dit que cela représentait trois Story Points, soit 3 jours.
Après cela, nous :
- Nous avons révisé le système d'évaluation des Story Points. Désormais, la correction des petits bugs, qui peuvent être rapidement intégrés dans le système, atteint plus vite l'utilisateur.
- Nous avons commencé à regrouper les tickets liés au développement et aux tests. Auparavant, chaque ticket, chaque bug, était un écosystème isolé, non connecté à autre chose. Modifier trois boutons sur une page pouvait représenter trois tickets différents avec trois processus de QA différents au lieu d'un test automatisé sur la page.
- Nous avons commencé à travailler avec les développeurs sur l'approche à adopter pour évaluer les efforts. Prendre trois jours pour changer un seul bouton — ce n'est pas drôle.
Vingtième jour
Vers le milieu du premier mois, la situation s'est légèrement stabilisée, j'ai compris ce qui se passait principalement et j'ai commencé à envisager l'avenir et à penser à des solutions à long terme.
Objectifs à long terme :
- Une plateforme gérée. Des centaines de requêtes sur chaque page — ce n'est pas sérieux.
- Tendances prévisibles. Il y avait des pics périodiques de trafic qui, à première vue, ne corrélait pas avec d'autres métriques — il fallait comprendre pourquoi cela se produisait et apprendre à prédire.
- Expansion de la plateforme. L'entreprise continue de croître, de nouveaux utilisateurs arrivent et le trafic augmente.
Dans le passé, on disait souvent : « Réécrivons tout en [langage/framework], tout fonctionnera mieux ! »
Dans la plupart des cas, cela ne fonctionne pas, et c'est un miracle si la version réécrite fonctionne du tout. Donc, nous devions créer une feuille de route — une stratégie concrète, illustrant étape par étape comment les objectifs commerciaux seront atteints (ce que nous allons faire et pourquoi), qui :
- réflecte la mission et les objectifs du projet ;
- priorise les principaux objectifs ;
- contient un graphique de leurs réalisations.
Avant cela, personne n'a jamais discuté avec l'équipe des raisons pour lesquelles des changements sont effectués. Cela nécessite des indicateurs de succès appropriés. Pour la première fois dans l'histoire de l'entreprise, nous avons établi des KPI pour l'équipe technique, et ces indicateurs sont liés à l'organisation.
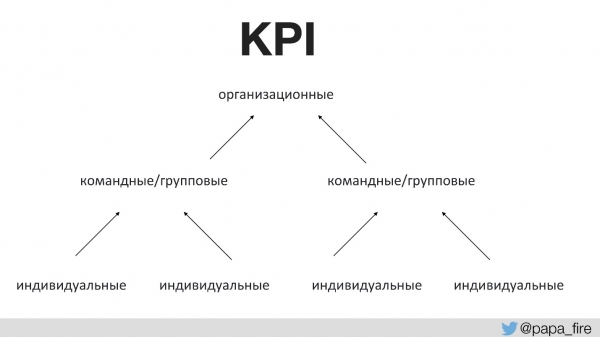
Autrement dit, les KPI organisationnels sont soutenus par les équipes, tandis que les KPI des équipes sont soutenus par des individus. Sinon, si les KPI technologiques ne correspondent pas aux KPI organisationnels, chacun tire la couverture à soi.
Par exemple, l'un des KPI organisationnels est l'augmentation de la part de marché grâce à de nouveaux produits.
Que pouvons-nous faire pour soutenir l'objectif d'avoir davantage de nouveaux produits ?
- Tout d'abord, nous souhaitons consacrer plus de temps au développement de nouveaux produits plutôt qu'à corriger des défauts. C'est une solution logique et facilement mesurable.
- Deuxièmement, nous voulons soutenir l'augmentation du volume des transactions, car plus nous avons de parts de marché, plus il y a d'utilisateurs et, par conséquent, plus il y a de trafic.
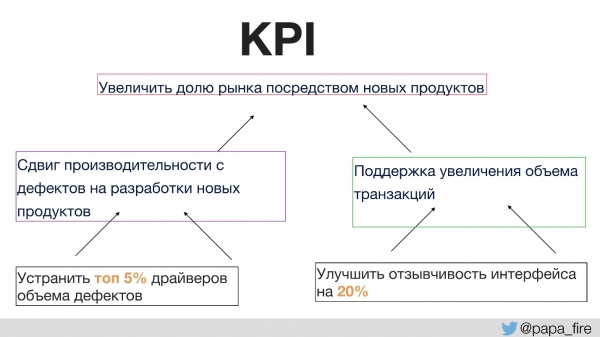
Alors, les KPI individuels, qui peuvent être mis en œuvre au sein du groupe, seront, par exemple, ceux venant des principales sources de défauts. Si nous nous concentrons précisément sur cette section, nous pouvons réduire considérablement le nombre de défauts, et alors nous aurons plus de temps pour le développement de nouveaux produits et à nouveau pour soutenir les KPI organisationnels.
Ainsi, chaque décision, y compris la réécriture de code, doit soutenir des objectifs concrets que l'entreprise nous a fixés (croissance de l'organisation, nouvelles fonctionnalités, recrutement de personnel).
Au cours de ce processus, une chose intéressante a été révélée, qui est devenue une nouvelle non seulement pour les techniciens, mais pour l'ensemble de l'entreprise : tous les tickets doivent être orientés vers au moins un KPI. Cela signifie que si un product owner dit qu'il veut développer une nouvelle fonctionnalité, la première question à poser doit être : « Quel KPI cette fonctionnalité soutient-elle ? » S'il n'y en a aucun, désolé — cela semble être une fonctionnalité inutile.
Jour trente
À la fin du mois, j'ai découvert un autre aspect, à savoir que personne de mon équipe Ops n'avait jamais vu les contrats que nous signons avec les clients. Vous pouvez demander, pourquoi faut-il voir ces contrats.
- Tout d'abord, parce que les SLA sont stipulés dans les contrats.
- Deuxièmement, les SLA varient. Chaque client arrive avec ses propres exigences, et le service commercial signe sans réfléchir.
Un autre point intéressant est que dans le contrat avec l'un de nos plus grands clients, il est stipulé que toutes les versions du logiciel prises en charge par la plateforme doivent être n-1, c'est-à-dire pas la dernière version, mais l'avant-dernière.
Il est évident que nous étions loin de n-1, puisque la plateforme était sur ColdFusion et SQL Server de 2008, qui ne sont plus du tout pris en charge depuis juillet.
Le jour quarante-cinq
Vers le milieu du deuxième mois, j'ai eu suffisamment de temps pour m'asseoir et faire valuestreammapping complètement sur l'ensemble du processus. Ce sont des étapes nécessaires à entreprendre, de la création du produit à sa livraison au consommateur, et il faut les décrire le plus en détail possible.
On décompose le processus en petites parties et on cherche ce qui prend trop de temps, ce qui peut être optimisé, amélioré, etc. Par exemple, combien de temps prend une demande depuis le produit, le passage par le grooming, jusqu'à ce qu'elle arrive au ticket que le développeur peut prendre, QA, etc. On examine chaque étape en détail et on réfléchit à ce qui peut être optimisé.
Lorsque je faisais cela, deux choses m'ont sauté aux yeux :
- un pourcentage élevé de retour des tickets de QA aux développeurs ;
- les révisions des pull requests prenaient trop de temps.
Le problème était que ces conclusions étaient du genre : il semble que cela prenne beaucoup de temps, mais nous ne sommes pas sûrs de la quantité exacte.
« On ne peut pas améliorer ce qui ne peut pas être mesuré ».
Comment justifier la gravité du problème ? Est-ce que cela prend des jours ou des heures ?
Pour mesurer cela, nous avons ajouté quelques étapes au processus Jira : « prêt pour le dev » et « prêt pour QA », afin de mesurer combien de temps chaque ticket attend et combien de fois il revient à une étape donnée.
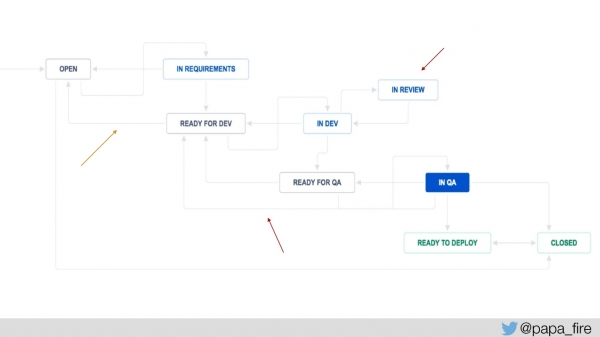
Nous avons également ajouté « en révision », pour savoir combien de temps, en moyenne, les tickets passent en révision, et à partir de là, on peut travailler. Nous avions des métriques système, et maintenant nous avons ajouté de nouvelles métriques et avons commencé à mesurer :
- Efficacité du processus : productivité et planifié/livré.
- Qualité du processus : nombre de défauts, défauts venant de QA.
Cela aide vraiment à comprendre ce qui fonctionne bien et ce qui ne fonctionne pas.
Le jour cinquante
Tout cela est bien et intéressant, mais vers la fin du deuxième mois, il s'est passé ce qui était en principe prévisible, bien que je n'aie pas anticipé une telle ampleur. Les gens ont commencé à partir, car il y a eu un changement au sommet. De nouvelles personnes sont arrivées à la direction, qui ont commencé à tout changer, et les anciennes se sont faites licencier. Dans une entreprise qui existe depuis plusieurs années, en général, tout le monde est ami et tout le monde se connaît.
C'était prévisible, mais l'ampleur des départs était inattendue. Par exemple, en une semaine, deux team leaders ont soudainement déposé leur démission. J'ai donc dû non seulement mettre de côté d'autres problèmes, mais me concentrer sur la création d'une équipe. C'est un problème long et difficile à résoudre, mais il fallait s'en occuper, car je voulais préserver les personnes qui étaient restées (ou la plupart d'entre elles). Il fallait réagir d'une manière ou d'une autre à ceux qui sont partis, afin de maintenir le moral dans l'équipe.
En théorie, c'est une bonne idée : un nouvel arrivant arrive avec un blanc-seing complet, capable d'évaluer les compétences de l'équipe et de remplacer les effectifs. En réalité, il n'est pas possible d'introduire de nouvelles personnes aussi simplement pour de nombreuses raisons. Il faut toujours un équilibre.
- Entre l'ancien et le nouveau. Il est nécessaire de conserver les anciens qui peuvent évoluer et soutenir la mission. Mais en même temps, il faut apporter du sang neuf, nous en parlerons un peu plus tard.
- D'expérience. J'ai beaucoup parlé avec de bons juniors, passionnés et désireux de travailler chez nous. Mais je ne pouvais pas les recruter, car il n'y avait pas assez de seniors pour encadrer les juniors et agir en tant que mentors. Il fallait d'abord renforcer le sommet et ensuite accueillir les jeunes.
- De la carotte et du bâton.
Je n'ai pas de bonne réponse à la question de savoir quel équilibre est correct, comment le maintenir, combien de personnes garder et à quel point être ferme. C'est un processus purement individuel.
Le cinquante et unième jour
J'ai commencé à observer l'équipe pour comprendre qui j'avais, et j'ai de nouveau réalisé :
« La plupart des problèmes viennent des personnes ».
J'ai découvert qu'il y avait trois grands problèmes au sein de l'équipe, tant chez les développeurs que chez les Ops :
- La satisfaction vis-à-vis de l'état actuel des choses.
- L'absence de responsabilité — car personne n'a jamais lié les résultats du travail des exécutants à l'impact sur les affaires.
- La peur du changement.
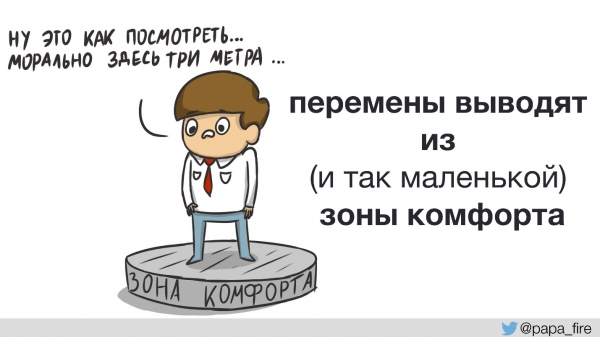
Les changements sortent toujours de la zone de confort, et plus les gens sont jeunes, moins ils aiment les changements, car ils ne comprennent pas pourquoi et comment. La réponse la plus fréquente que j'ai entendue était : « Nous ne l'avons jamais fait comme ça ». Cela a même conduit à l'absurde — les moindres changements ne se faisaient pas sans qu'il y ait une protestation. Peu importe que les changements concernent leur propre travail, les gens disaient : « Non, pourquoi ? Ça ne fonctionnera pas ».
Mais on ne peut pas s'améliorer sans rien changer.
J'ai eu une conversation totalement absurde avec un collègue, je lui exposais mes idées d'optimisation, à quoi il m'a répondu :
— Ah, tu n'as pas vu ce qu'on avait l'année dernière !
— Et alors ?
— C'est bien mieux qu'avant.
— Alors, ça ne peut pas être encore mieux ?
— Pourquoi faire ?
Bonne question — pourquoi ? Comme si, parce que c'est mieux maintenant qu'avant, cela signifiait que tout était déjà bien suffisant. Cela conduit à un manque de responsabilité, ce qui est en principe totalement normal. Comme je l'ai dit, l'équipe technique était un peu mise à l'écart. Dans l'entreprise, on considérait qu'elle devait être présente, mais personne n'a jamais établi de normes. Au support technique, personne n'a jamais vu de SLA, donc pour l'équipe, il était tout à fait « acceptable » (et c'est ce qui m'a le plus frappé) :
- 12 secondes de chargement;
- 5-10 minutes d'interruption à chaque version;
- la résolution des problèmes critiques prend des jours et des semaines;
- absence de garde 24/7 / en astreinte.
Personne n'a jamais essayé de se demander pourquoi nous ne pouvions pas faire cela mieux, et personne n'a jamais compris que cela ne devait pas être ainsi.
En bonus, il y avait un autre problème : le manque d'expérience. Les seniors sont partis, et l'équipe jeune restante a grandi dans l'ancien cadre et en a été empoisonnée.
De plus, les gens avaient peur de l'échec, de paraître incompétents. Cela se manifeste par le fait qu'ils, premièrement, ne demandaient jamais d'aide dans aucune circonstance.Combien de fois avons-nous discuté en groupe et individuellement, et j'ai dit : « Posez une question si vous ne savez pas comment faire quelque chose ». J'ai confiance en moi et je sais que je peux résoudre n'importe quel problème, mais cela prendra du temps. Donc, si je peux demander à quelqu'un qui sait comment le résoudre en 10 minutes, je demanderai. Moins on a d'expérience, plus on a peur de demander, parce qu'on pense qu'on va être considéré comme incompétent.
Cette appréhension de poser une question prend des formes intéressantes. Par exemple, vous demandez : « Où en est cette tâche ? » — « Il me reste quelques heures, je suis presque fini ». Le lendemain, vous redemandez, on vous répond que tout va bien, mais qu'un petit problème est survenu, et que ce sera prêt d'ici la fin de la journée. Un jour passe encore, et tant que vous ne les poussez pas au mur et ne les forcez pas à en parler, tout reste en l'état. La personne veut résoudre le problème elle-même, elle pense que si elle ne le fait pas, ce sera un grand échec.
C'est pourquoi les développeurs exagèrent les estimations. C'était vraiment une blague lorsque nous discutions d'une tâche spécifique et qu'on m'a donné un chiffre qui m'a beaucoup surpris. On m'a alors répondu que dans les estimations, le développeur incluait aussi le temps que le ticket passerait en QA, car ils y trouveraient des erreurs, ainsi que le temps que prendrait la révision, et le temps que mettraient les personnes qui devaient le examiner — c'est-à-dire tout ce qui est possible.
D'autre part, les gens qui ont peur de paraître incompétents, analysent trop. Quand vous dites ce qu'il faut faire exactement, cela commence par : « Non, et si nous réfléchissons ici ? » Dans ce sens, notre entreprise n'est pas unique, c'est un problème standard de la jeunesse.
En réponse, j'ai introduit les pratiques suivantes :
- Règle des 30 minutes. Si vous ne pouvez pas résoudre le problème en une demi-heure, demandez de l'aide à quelqu'un. Cela fonctionne avec un succès variable, car les gens n'en font toujours pas la demande, mais au moins le processus a commencé.
- Exclure tout sauf l'essentiel, dans l'estimation du temps d'exécution de la tâche, c'est-à-dire ne compter que le temps nécessaire à l'écriture du code.
- Apprentissage continu pour ceux qui analysent trop. C'est simplement un travail constant avec les gens.
Jour soixantième
Pendant que je m'occupais de tout cela, il était temps de s'occuper du budget. Bien sûr, j'ai découvert beaucoup de choses intéressantes sur la façon dont nous dépensions notre argent. Par exemple, nous avions un rack entier dans un data center séparé, sur lequel se trouvait un serveur FTP, utilisé par un seul client. Il s'est avéré que « … nous avions déménagé, et il était resté là, nous ne l'avons pas changé ». C'était il y a 2 ans.
Un intérêt particulier était suscité par la facture des services de cloud. Je suis convaincu que la principale raison de la forte augmentation de cette facture cloud est due aux développeurs, qui pour la première fois de leur vie ont un accès illimité aux serveurs. Ils n'ont pas besoin de demander : « Donnez-moi, s'il vous plaît, un serveur de test », ils peuvent le prendre eux-mêmes. De plus, les développeurs veulent toujours construire un système si impressionnant que Facebook et Netflix en seraient jaloux.
Mais les développeurs n'ont pas d'expérience dans l'achat de serveurs et ne savent pas toujours quelle taille de serveur est nécessaire, car cela ne leur a pas été nécessaire auparavant. En général, ils ne comprennent pas vraiment la différence entre scalabilité et performance.
Résultats de l'inventaire :
- Sorti d'un centre de données.
- Contrat résilié avec 3 services log. Parce que nous en avions 5 — chaque développeur qui se mettait à expérimenter prenait un nouveau serveur.
- 7 systèmes AWS ont été éteints. Encore une fois, aucun projet abandonné n’a été stoppé, ils ont tous continué à fonctionner.
- Réduction des dépenses en logiciels de 6 fois.
Jour soixante-quinze
Le temps passait, et après deux mois et demi, j'avais une réunion avec le conseil d'administration. Notre conseil d'administration n'est pas meilleur ni pire que les autres, il veut savoir tout, comme tous les conseils d'administration. Les gens investissent de l'argent et veulent comprendre comment ce que nous faisons s'aligne avec les KPI fixés.
Le conseil d'administration reçoit beaucoup d'informations chaque mois : le nombre d'utilisateurs, leur croissance, les services qu'ils utilisent et comment, la performance et la productivité, enfin, la vitesse moyenne de chargement des pages.
Le problème, c'est que je considère que la moyenne est un mal pur. Mais il est très difficile d'expliquer cela au conseil d'administration. Ils sont habitués à travailler avec des chiffres agrégés, plutôt qu'avec, par exemple, la dispersion des temps de chargement en secondes.
À cet égard, il y avait des moments intéressants. Par exemple, j'ai dit qu'il fallait diviser le trafic entre différents serveurs web en fonction du type de contenu.
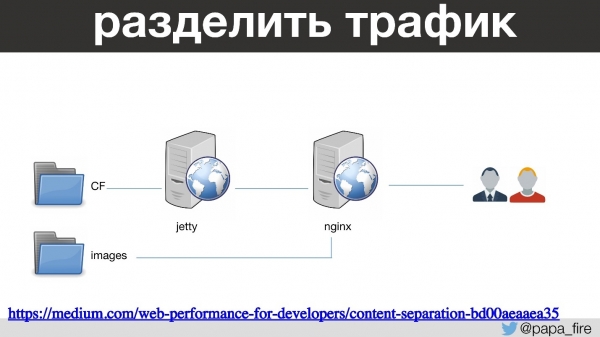
C'est-à-dire que ColdFusion passe par Jetty et nginx pour exécuter les pages. Alors que les images, JS et CSS passent par un nginx séparé avec ses propres configurations. C'est une pratique plutôt standard, dont j'ai parlé il y a quelques années. En conséquence, les images se chargent beaucoup plus rapidement, et… la vitesse moyenne de chargement a augmenté de 200 ms.
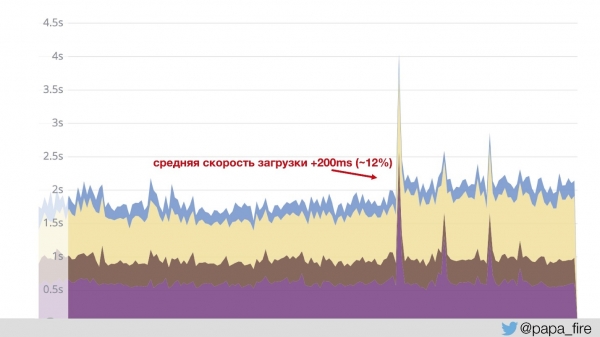
Cela s'est produit parce que le graphique est construit sur la base des données provenant de Jetty. En d'autres termes, le contenu rapide n'est pas pris en compte — la moyenne a augmenté. Nous l'avons compris, nous avons ri, mais comment expliquer au conseil d'administration pourquoi nous avons fait quelque chose et que cela s'est empiré de 12 % ?
Quatre-vingt-cinquième jour
À la fin du troisième mois, j'ai compris qu'une chose à laquelle je ne m'étais pas du tout préparé — c'était le temps. Tout ce dont j'ai parlé prend du temps.
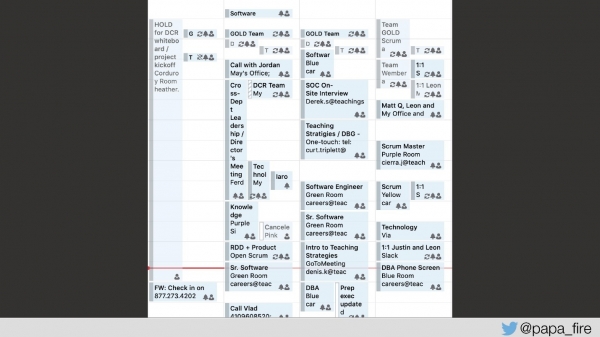
Voici mon véritable calendrier pour la semaine — juste une semaine de travail, pas trop chargée. Je n'ai pas assez de temps pour tout. Donc, encore une fois, nous devons recruter des personnes qui pourront aider à résoudre les problèmes.
Conclusion
Ce n'est pas tout. Dans cette histoire, je n'ai même pas encore abordé comment nous avons travaillé avec le produit et essayé de nous accorder sur une même longueur d'onde, ou comment nous avons intégré le support technique, ou comment nous avons résolu d'autres problèmes techniques. Par exemple, j'ai découvert par hasard que dans les plus grandes tables de la base de données, nous ne faisons pas usage de SÉQUENCE. Nous avons une fonction personnalisée nextID, et elle n'est pas utilisée dans la transaction.
Il y avait encore un million de choses similaires dont on pourrait parler longuement. Mais le plus important à mentionner, c'est la culture.
C'est cette culture, ou son absence, qui mène à tous les autres problèmes. Nous essayons de construire une culture où les gens :
- n'ont pas peur de l'échec ;
- apprennent de leurs erreurs ;
- collaborent avec d'autres équipes ;
- font preuve d'initiative ;
- prennent leurs responsabilités ;
- accueillent le résultat comme un objectif ;
- célébrent le succès.
Avec cela, tout le reste viendra.
Leon Fire , et en .
En ce qui concerne l'héritage, il existe deux stratégies : éviter à tout prix de travailler avec, ou bravement surmonter les difficultés qui l'accompagnent. Nous choisissons la seconde option, en changeant les processus et les approches. Rejoignez-nous sur , et , et ensemble, implantons la culture DevOps.
Source : habr.com
