

L'article est composé de deux parties :
- Une brève description de certaines architectures de réseaux pour la détection d'objets sur les images et la segmentation d'images avec des liens que j'ai trouvés les plus clairs. J'ai essayé de choisir des vidéos explicatives, de préférence en russe.
- La deuxième partie consiste à tenter de comprendre la direction de l'évolution des architectures de réseaux neuronaux et des technologies qui en découlent.
Figure 1 – Comprendre les architectures des réseaux neuronaux n'est pas simple.
Tout a commencé par le développement de deux applications de démonstration pour la classification et la détection d'objets sur un téléphone Android :
- , où les données sont traitées sur le serveur et envoyées au téléphone. Classification d'images (image classification) de trois types d'ours : brun, noir et en peluche.
- , où les données sont traitées directement sur le téléphone. Détection d'objets (object detection) de trois types : noisette, figue et datte.
Il y a une différence entre les tâches de classification d'images, de détection d'objets sur les images et . C'est pourquoi il est devenu nécessaire d'apprendre quelles architectures de réseaux neuronaux détectent des objets sur les images et lesquelles peuvent segmenter. J'ai trouvé les exemples suivants d'architectures avec les liens que j'ai jugés les plus clairs :
- Une série d'architectures basées sur R-CNN (Régions avec Convolution Neural Nréseau features) : R-CNN, Fast R-CNN, , . Pour détecter un objet sur une image, un mécanisme de Region Proposal Network (RPN) met en évidence des régions limitées (bounding boxes). Initialement, un mécanisme plus lent, Selective Search, était utilisé à la place de RPN. Ensuite, les régions limitées mises en surbrillance sont envoyées en entrée d'un réseau neuronal classique pour classification. Dans l'architecture R-CNN, il y a des boucles 'for' explicites pour parcourir les régions limitées, atteignant jusqu'à 2000 passages via le réseau interne AlexNet. En raison de ces boucles 'for' explicites, la vitesse de traitement des images est ralentie. Le nombre de boucles explicites et le passage à travers le réseau neuronal interne diminuent avec chaque nouvelle version de l'architecture, et des dizaines d'autres modifications sont également réalisées pour augmenter la vitesse et pour remplacer la tâche de détection d'objets par la segmentation d'objets dans Mask R-CNN.
- (You Only Look Once) – le premier réseau de neurones capable de reconnaître des objets en temps réel sur des appareils mobiles. Sa caractéristique distinctive : la distinction des objets en un seul passage (il suffit de regarder une fois). Cela signifie qu'il n'y a pas de boucles explicites « for » dans l'architecture YOLO, ce qui permet un fonctionnement rapide. Par exemple, une analogie : dans NumPy, lors des opérations sur des matrices, il n'y a également pas de boucles « for » explicites, qui sont réalisées à des niveaux d'architecture plus bas par le biais du langage de programmation C. YOLO utilise une grille d'ouvertures prédéfinies. Pour qu'un même objet ne soit pas identifié plusieurs fois, un coefficient de recouvrement des ouvertures (IoU, Iintersection osupérieur Uunion). Cette architecture fonctionne sur une large gamme et possède une haute : le modèle peut être entraîné sur des photographies, tout en travaillant bien sur des peintures dessinées.
- (Ssingle Sshot MultiBox Ddetector) – utilise les hacks les plus efficaces de l'architecture YOLO (comme la suppression de maximum non-nul) et en ajoute de nouveaux pour que le réseau de neurones fonctionne plus rapidement et avec plus de précision. Caractéristique distinctive : la distinction des objets en un seul passage à l'aide d'une grille d'ouvertures définies (default box) sur une pyramide d'images. La pyramide d'images est codée dans des tenseurs convolutifs lors des opérations consécutives de convolution et de pooling (lors de l'opération de max-pooling, la dimension spatiale diminue). De cette manière, des objets à la fois grands et petits sont définis en un seul passage du réseau.
- MobileSSD (MobileNetV2 + SSD) – combinaison de deux architectures de réseaux de neurones. Le premier réseau fonctionne rapidement et augmente la précision de reconnaissance. MobileNetV2 est utilisé à la place de VGG-16, qui était initialement utilisée dans . Le deuxième réseau SSD détermine l'emplacement des objets sur l'image.
- – un réseau de neurones très compact mais précis. Par lui-même, il ne résout pas la tâche de détection d'objets. Toutefois, il peut être utilisé en combinaison avec différentes architectures. Et être utilisé sur des appareils mobiles. Sa caractéristique distinctive est que les données sont d'abord comprimées à quatre filtres convolutifs 1×1, puis étendues à quatre filtres 1×1 et quatre filtres 3×3. Une telle itération de compression-extension des données est appelée « Fire Module ».
- (Segmentation sémantique d'image avec des réseaux de neurones convolutifs profonds) – segmentation d'objets dans une image. La particularité de l'architecture est la convolution dilatée, qui préserve la résolution spatiale. Ensuite, une étape de post-traitement des résultats est réalisée à l'aide d'un modèle probabiliste graphique, ce qui permet d'éliminer de petites bruits dans la segmentation et d'améliorer la qualité de l'image segmentée. Derrière le terme « modèle probabiliste graphique » se cache un simple filtre gaussien, qui est approximé sur cinq points.
- J'ai essayé de comprendre le fonctionnement (Single-Shot Refinement Neural Network for Object Detection), mais je n'ai pas compris grand-chose.
- J'ai aussi regardé comment fonctionne la technologie de l'« attention » (attention) : , , . La particularité de l'architecture « attention » est la détection automatique des régions d'attention accrue dans l'image (RoI, Regions of Interest) à l'aide d'un réseau de neurones appelé Attention Unit. Les régions d'attention accrue ressemblent à des régions délimitées mais, contrairement à celles-ci, ne sont pas figées dans l'image et peuvent avoir des bords flous. Ensuite, des caractéristiques (features) sont extraites des régions d'attention accrue et « nourries » à des réseaux de neurones récurrents avec des architectures . Les réseaux de neurones récurrents peuvent analyser les relations entre les caractéristiques dans une séquence. Initialement, les réseaux de neurones récurrents étaient utilisés pour traduire des textes dans d'autres langues, et maintenant ils le sont aussi pour traduire et .
En étudiant ces architectures j'ai compris que je ne comprenais rien.. Et ce n'est pas que mon réseau de neurones ait des problèmes avec le mécanisme d'attention. La création de toutes ces architectures ressemble à un énorme hackathon, où les auteurs se livrent à des hacks. Hack est une solution rapide à un problème logiciel difficile. Cela signifie qu'il n'y a pas de lien logique visible et compréhensible entre toutes ces architectures. Tout ce qui les relie est un ensemble de hacks réussis qu'ils empruntent les uns aux autres, plus une opération de convolution rétroactive commune à tous pensée systémique ! Il n'est pas clair ce qu'il faut changer et comment optimiser les réalisations existantes.
En raison de l'absence de lien logique entre les hacks, il est extrêmement difficile de les mémoriser et de les appliquer dans la pratique. Ce sont des connaissances fragmentées. Dans le meilleur des cas, quelques moments intéressants et inattendus sont mémorisés, mais la plupart des éléments compris ou incompris disparaissent de la mémoire au bout de quelques jours. Il serait déjà bien si au bout d'une semaine on se souvenait au moins du nom de l'architecture. Pourtant, plusieurs heures, voire plusieurs jours de temps de travail ont été consacrés à la lecture d'articles et au visionnage de vidéos d'introduction !
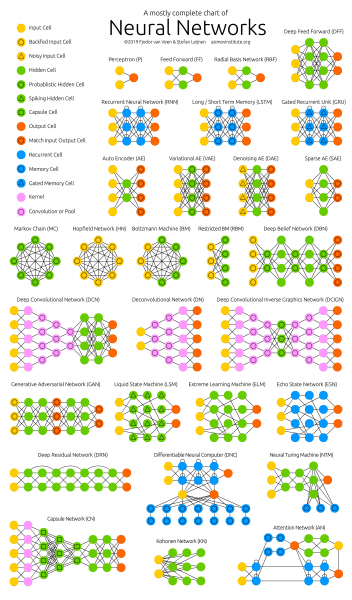
Figure 2 –
La plupart des auteurs d'articles scientifiques, à mon avis personnel, font tout pour que même ces connaissances fragmentées ne soient pas comprises par le lecteur. Mais les participes présents dans des phrases de dix lignes avec des formules tirées « du plafond » – c'est un sujet pour un article à part (problème ).
Pour cette raison, il est devenu nécessaire de systématiser l'information sur les réseaux de neurones et, de cette manière, d'augmenter la qualité de la compréhension et de la mémorisation. Ainsi, le sujet principal de l'analyse de certaines technologies et architectures des réseaux neuronaux artificiels est devenu la tâche suivante : savoir où tout cela va, et non le fonctionnement d'un réseau neuronal particulier.
Où tout cela va. Principaux résultats :
- Le nombre de startups dans le domaine de l'apprentissage automatique a chuté de façon drastique ces deux dernières années . Une raison possible : « les réseaux neuronaux ne sont plus quelque chose de nouveau ».
- Chacun pourra créer un réseau neuronal fonctionnel pour résoudre une tâche simple. Pour cela, il prendra un modèle prêt à l'emploi dans le « zoo de modèles » (model zoo) et entraînera la dernière couche du réseau neuronal () sur des données prêtes provenant de ou de dans le cloud gratuit .
- Les grands fabricants de réseaux neuronaux ont commencé à créer des « zoos de modèles » (model zoo). Grâce à eux, on peut rapidement créer une application commerciale : pour TensorFlow, pour PyTorch, pour Caffe2, pour Chainer et .
- Réseaux neuronaux fonctionnant en temps réel (real-time) sur des appareils mobiles. De 10 à 50 images par seconde.
- Utilisation des réseaux neuronaux dans les téléphones (TF Lite), dans les navigateurs (TF.js) et dans (IoT, IInternet of desChoses). En particulier dans les téléphones qui prennent déjà en charge les réseaux neuronaux au niveau « matériel » (accélérateurs neuronaux).
- «Chaque appareil, vos vêtements et peut-être même la nourriture auront une adresse IP-v6 et communiqueront entre eux» – .
- La croissance des publications sur l'apprentissage automatique a commencé (doublement tous les deux ans) depuis 2015. Il est évident que des réseaux neuronaux sont nécessaires pour analyser les articles.
- Les technologies suivantes gagnent en popularité :
- PyTorch – la popularité augmente rapidement et semble dépasser TensorFlow.
- Ajustement automatique des hyperparamètres AutoML – la popularité augmente lentement.
- Diminution progressive de la précision et augmentation de la vitesse de calcul : , algorithmes , calculs imprecis (approximatifs), quantification (lorsque les poids du réseau neuronal sont convertis en nombres entiers et quantifiés), neuroaccélérateurs.
- Traduction et .
- Création , désormais en temps réel.
- L'essentiel en DL, c'est beaucoup de données, mais les collecter et les annoter n'est pas facile. C'est pourquoi l'automatisation de l'annotation se développe () pour les réseaux neuronaux à l'aide de réseaux neuronaux.
- Avec les réseaux neuronaux, l'informatique est soudainement devenue une science expérimentale et un .
- L'argent IT et la popularité des réseaux neuronaux sont apparus simultanément, lorsque le calcul est devenu une valeur marchande. L'économie passant du monétaire à la monétaire-computationnelle.. Consultez mon article sur et la raison de l'apparition de l'argent IT.
Une nouvelle (Machine Learning & Deep Learning), qui repose sur la représentation d'un programme comme un ensemble de modèles neuronaux entraînés.
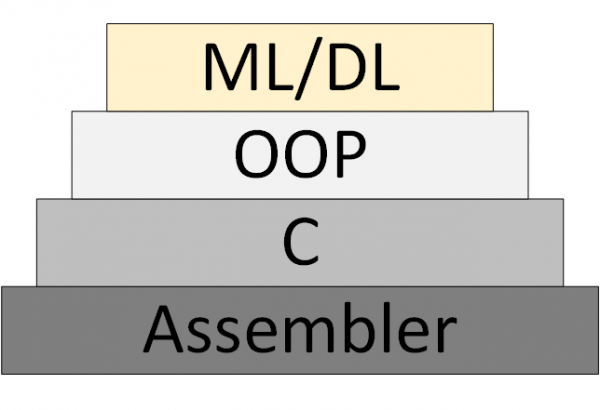
Figure 3 – ML/DL comme nouvelle méthodologie de programmation
Cependant, il n'est toujours pas apparu «théorie des réseaux neuronaux», dans le cadre de laquelle on peut penser et travailler de manière systématique. Ce qui est appelé «théorie» est en réalité des algorithmes expérimentaux et heuristiques.
Liens vers mes ressources et d'autres :
- Newsletter sur le Data Science. Principalement sur le traitement d'images. Ceux qui souhaitent recevoir peuvent envoyer un e-mail (foobar167<ouf-ouf>gmail<point>com). Les liens vers des articles et vidéos sont envoyés au fur et à mesure de l'accumulation de matériel.
- Liste générale , que j'ai suivis et que j'aimerais suivre.
- , par où commencer pour étudier les réseaux neuronaux. Plus une brochure .
- , où chacun peut trouver quelque chose d'intéressant pour lui.
- Les chaînes vidéo sur l'analyse des articles scientifiques sur la Data Science se sont révélées extrêmement utiles. Trouvez-les, abonnez-vous et partagez les liens avec vos collègues et moi aussi. Exemples :
- aka avec des instructions étape par étape et du code source ouvert.
Merci de votre attention !
Source : habr.com
