

est un système de gestion de bases de données colonnes pour le traitement analytique des requêtes en ligne (OLAP) à code source ouvert, créé par Yandex. Il est utilisé par Yandex, CloudFlare, VK.com, Badoo et d'autres services dans le monde entier pour le stockage de véritables volumes de données (insertion de milliers de lignes par seconde ou pétaoctets de données stockées sur disque).
Dans une base de données « relationnelle », comme MySQL, Postgres ou MS SQL Server, les données sont stockées dans l'ordre suivant :
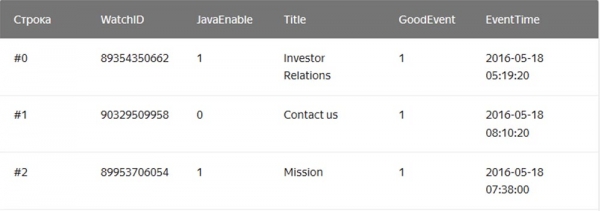
Les valeurs appartenant à une même ligne sont physiquement stockées côte à côte. Dans les bases de données colonnes, les valeurs de différentes colonnes sont stockées séparément, et les données d'une même colonne sont regroupées :
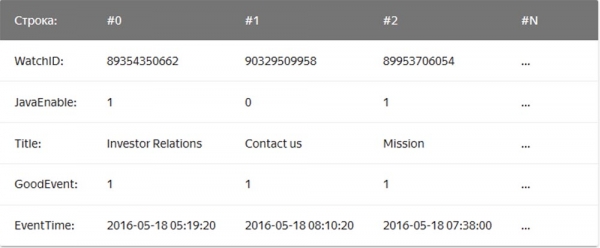
Des exemples de bases de données colonnes incluent Vertica, Paraccel (Actian Matrix, Amazon Redshift), Sybase IQ, Exasol, Infobright, InfiniDB, MonetDB (VectorWise, Actian Vector), LucidDB, SAP HANA, Google Dremel, Google PowerDrill, Druid, kdb+.
La société – transmetteur de mails a commencé à utiliser Clickhouse en 2018 pour établir des rapports et a été très impressionnée par sa simplicité, sa scalabilité, son support SQL et sa rapidité. La vitesse de cette base de données frôlait la magie.
Simplicité
Clickhouse s'installe sur Ubuntu avec une seule commande. Si vous connaissez SQL, vous pouvez immédiatement commencer à utiliser Clickhouse selon vos besoins. Toutefois, cela ne signifie pas que vous pouvez effectuer un « show create table » dans MySQL et copier-coller le SQL dans Clickhouse.
Comparé à MySQL, cette base de données a d'importantes différences de types de données dans les définitions de schémas de tables, donc pour un travail confortable, vous devrez tout de même prendre le temps de modifier les définitions de schémas de tables et d'étudier les moteurs de tables.
Clickhouse fonctionne très bien sans logiciels supplémentaires, mais si vous souhaitez utiliser la réplication, vous devrez installer ZooKeeper. L'analyse des performances des requêtes montre d'excellents résultats – les tables système contiennent toutes les informations, et toutes les données peuvent être récupérées avec le vieux et ennuyeux SQL.
Performance
- comparant Clickhouse à Vertica et MySQL sur un serveur configuré avec : deux sockets Intel® Xeon® CPU E5-2650 v2 @ 2.60GHz ; 128 GiB RAM ; md RAID-5 sur 8 disques durs SATA de 6 To, ext4.
- comparant Clickhouse à l'entrepôt de données cloud Amazon RedShift.
- Extraits du blog :
La base de données ClickHouse présente un design très simple : tous les nœuds du cluster ont la même fonctionnalité et n'utilisent que ZooKeeper pour la coordination. Nous avons construit un petit cluster composé de plusieurs nœuds et réalisé des tests durant lesquels nous avons découvert que le système offre des performances impressionnantes, conformes aux avantages déclarés dans les benchmarks des SGBD analytiques. Nous avons décidé d'examiner plus en détail le concept sous-jacent de ClickHouse. Le premier obstacle à notre recherche fut le manque d'outils et la faible taille de la communauté ClickHouse, nous avons donc approfondi le design de ce SGBD pour comprendre son fonctionnement.
ClickHouse ne prend pas en charge la réception de données directement depuis Kafka, car c'est simplement une base de données. Nous avons donc écrit notre propre service d'adaptateurs en Go. Il lisait les messages codés Cap’n Proto depuis Kafka, les transformait en TSV et les insérait dans ClickHouse par paquets via une interface HTTP. Par la suite, nous avons réécrit ce service pour utiliser la bibliothèque Go en conjonction avec l'interface propre à ClickHouse afin d'améliorer les performances. En évaluant la performance de la réception des paquets, nous avons découvert une chose importante : les performances de ClickHouse dépendent fortement de la taille du paquet, c'est-à-dire du nombre de lignes insérées simultanément. Pour comprendre pourquoi cela se produisait, nous avons étudié la manière dont ClickHouse stocke les données.
Le principal moteur, ou plutôt la famille de moteurs pour les tables, utilisée par ClickHouse pour le stockage des données est MergeTree. Ce moteur est conceptuellement similaire à l'algorithme LSM utilisé dans Google BigTable ou Apache Cassandra, mais il évite de construire une table tampon intermédiaire et écrit les données directement sur le disque. Cela lui confère une excellente bande passante d'écriture, car chaque paquet inséré est trié uniquement par la « clé primaire » primary key, compressé et écrit sur le disque pour former un segment.
L'absence de table de mémoire ou de tout concept de "fraîcheur" des données signifie également qu'elles ne peuvent qu'être ajoutées, le système ne supportant pas leur modification ou suppression. À ce jour, la seule façon de supprimer des données est de les supprimer par tranches mensuelles, car les segments ne traversent jamais la limite d'un mois. L'équipe de ClickHouse travaille activement pour rendre cette fonction personnalisable. Par ailleurs, cela rend l'écriture et la fusion des segments sans conflit, permettant ainsi d'augmenter linéairement la bande passante d'insertion au fur et à mesure que le nombre d'inserts parallèles augmente, jusqu'à saturation de l'I/O ou des cœurs.
Cependant, cette circonstance signifie également que le système n'est pas adapté aux petits paquets, c'est pourquoi des services comme Kafka et des insérters sont utilisés pour le buffering. De plus, ClickHouse continue d'effectuer en arrière-plan une fusion constante des segments, de sorte que de nombreuses petites informations seront combinées et écrites plusieurs fois, augmentant ainsi l'intensité des écritures. Cependant, trop de parties non liées entraînera une réduction agressive des insertions tant que la fusion se poursuit. Nous avons constaté que le meilleur compromis entre la réception de données en temps réel et les performances d'insertion est de limiter le nombre d'inserts par seconde dans la table.
La clé de la performance de lecture des tables réside dans l'indexation et la disposition des données sur le disque. Peu importe la rapidité du traitement, quand le moteur doit scanner des téraoctets de données sur le disque et n'utilise qu'une partie de celles-ci, cela prend du temps. ClickHouse est un entrepôt de données en colonnes, chaque segment contenant un fichier pour chaque colonne, avec des valeurs triées pour chaque ligne. Ainsi, des colonnes entières, absentes de la requête, peuvent d'abord être ignorées, puis plusieurs cellules peuvent être traitées en parallèle grâce à l'exécution vectorisée. Pour éviter un scan complet, chaque segment a un petit fichier d'index.
Étant donné que toutes les colonnes sont triées par « clé primaire », le fichier d'index contient uniquement des marqueurs (lignes capturées) de chaque Nème ligne, afin de pouvoir les stocker en mémoire même pour de très grandes tables. Par exemple, on peut définir les paramètres par défaut pour « marquer chaque 8192ème ligne », alors qu'un index minimal d'une table de 1 trillion de lignes, qui tient facilement en mémoire, ne nécessitera que 122 070 caractères.
Développement du système
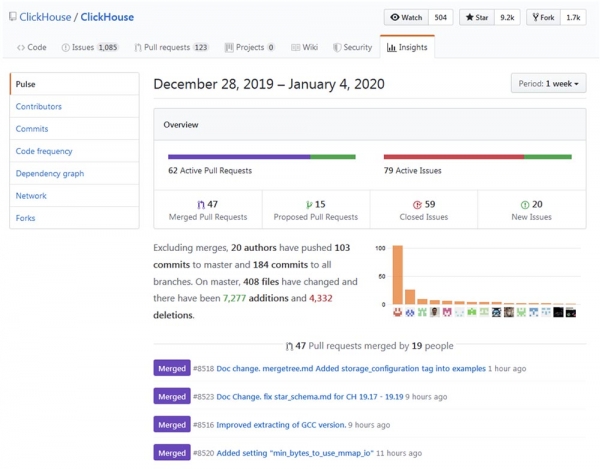
Le développement et l'amélioration de Clickhouse peuvent être suivis sur et il est possible de s'assurer que le processus de « maturation » se déroule à un rythme impressionnant.
Popularité
Il semble que la popularité de Clickhouse augmente de manière exponentielle, surtout au sein de la communauté russophone. La conférence High load 2018 de l'année dernière (Moscou, 8-9 novembre 2018) a montré que des géants tels que vk.com et Badoo utilisent Clickhouse, permettant d'insérer des données (comme des journaux) depuis des dizaines de milliers de serveurs simultanément. Dans une vidéo de 40 minutes, . Nous mettrons bientôt en ligne la transcription sur Habr pour faciliter le travail avec le matériel.
Domaines d'application
Après avoir passé un certain temps à faire des recherches, je pense qu'il existe des secteurs dans lesquels ClickHouse peut être utile ou peut entièrement remplacer d'autres solutions plus traditionnelles et populaires, telles que MySQL, PostgreSQL, ELK, Google Big Query, Amazon RedShift, TimescaleDB, Hadoop, MapReduce, Pinot et Druid. Voici des détails sur l'utilisation de ClickHouse pour moderniser ou remplacer complètement les bases de données mentionnées ci-dessus.
Extension des capacités de MySQL et PostgreSQL
Récemment, nous avons partiellement remplacé MySQL par ClickHouse pour la plateforme de bulletins d'information Le problème résidait dans le fait que MySQL, en raison d'une conception peu réfléchie, enregistrait chaque e-mail envoyé ainsi que chaque lien dans cet e-mail avec un hachage base64, créant une énorme table MySQL (email_stats). Après l'envoi de seulement 10 millions d'e-mails aux abonnés du service, cette table occupait 150 Go d'espace de fichiers, et MySQL commençait à 'ralentir' lors des requêtes simples. Pour résoudre le problème d'espace de fichiers, nous avons utilisé avec succès la compression de la table InnoDB, ce qui a réduit sa taille par 4. Cependant, il n'est toujours pas judicieux de stocker plus de 20 à 30 millions d'e-mails dans MySQL simplement pour lire l'historique, car toute requête simple, qui pour une raison quelconque doit effectuer un scan complet, entraîne de l'échange et une forte charge sur l'I/O, ce pour quoi nous recevions régulièrement des alertes Zabbix.
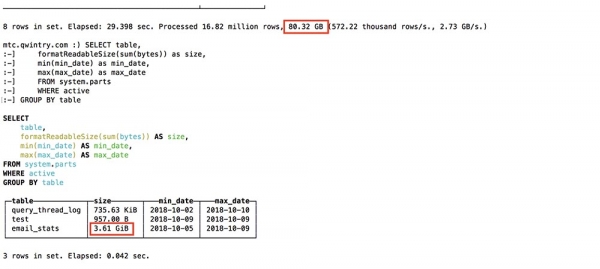
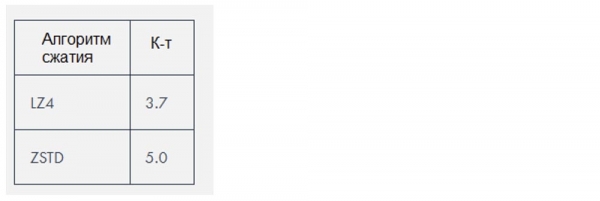
Clickhouse utilise deux algorithmes de compression, qui réduisent le volume de données d'environ , mais dans ce cas particulier, les données étaient particulièrement 'compressibles'.
Remplacement de l'ELK
D'après mon expérience, la pile ELK (ElasticSearch, Logstash et Kibana, dans ce cas ElasticSearch) nécessite beaucoup plus de ressources pour fonctionner que nécessaire pour stocker les journaux. ElasticSearch est un excellent moteur si vous avez besoin d'une bonne recherche en texte intégral dans les journaux (et je ne pense pas que vous en ayez réellement besoin), mais je me demande pourquoi il est devenu de facto le moteur standard pour la journalisation. Sa performance de réception, associée à Logstash, nous a causé des problèmes même avec des charges relativement faibles et nécessitait un ajout d'un volume croissant de mémoire vive et d'espace disque. En tant que base de données, Clickhouse est meilleur qu'ElasticSearch pour les raisons suivantes :
- Support du dialecte SQL ;
- Meilleur taux de compression des données stockées ;
- Support de la recherche par expressions régulières Regex au lieu de la recherche en texte complet ;
- Planification des requêtes améliorée et performances globales supérieures.
Actuellement, le principal problème qui se pose lors de la comparaison de ClickHouse avec l'ELK est le manque de solutions pour l'expédition des journaux, ainsi que le manque de documentation et de tutoriels sur le sujet. Chaque utilisateur peut cependant configurer l'ELK en suivant le guide de Digital Ocean, ce qui est crucial pour l'adoption rapide de telles technologies. Il existe un moteur de base de données ici, mais il n'y a pas encore de Filebeat pour ClickHouse. Oui, il existe et système pour travailler avec les logs , il existe un outil pour injecter des données de fichiers log dans ClickHouse, mais tout cela nécessite plus de temps. Cependant, ClickHouse reste en tête grâce à sa simplicité, permettant même aux débutants de l'installer et de commencer à l'utiliser entièrement en seulement 10 minutes.
Préférant des solutions minimalistes, j'ai essayé d'utiliser FluentBit, un outil pour l'envoi de logs avec une très faible consommation de mémoire, en combinaison avec ClickHouse, tout en m'efforçant d'éviter l'utilisation de Kafka. Cependant, il est nécessaire de résoudre quelques incompatibilités, comme , avant que cela puisse être fait sans une couche proxy qui transforme les données de FluentBit en ClickHouse.
Comme alternative à Kibana, il est possible d'utiliser ClickHouse en tant que backend pour . D'après ce que j'ai compris, cela peut entraîner des problèmes de performance lors du rendu d'un grand nombre de points de données, notamment avec les versions plus anciennes de Grafana. Chez Qwintry, nous n'avons pas encore essayé cela, mais des plaintes à ce sujet apparaissent de temps en temps sur le canal de support de ClickHouse sur Telegram.
Remplacement de Google Big Query et Amazon RedShift (solution pour grandes entreprises)
Le scénario idéal pour BigQuery est de charger 1 To de données JSON et d'effectuer des requêtes analytiques. Big Query est un excellent produit, dont l'évolutivité est difficile à surestimer. C'est un logiciel beaucoup plus complexe que ClickHouse, fonctionnant sur un cluster interne, mais du point de vue du client, il a beaucoup en commun avec ClickHouse. BigQuery peut rapidement devenir coûteux dès que vous commencez à payer pour chaque SELECT, ce qui en fait une véritable solution SaaS avec tous ses avantages et inconvénients.
ClickHouse est le meilleur choix lorsque vous exécutez de nombreuses requêtes coûteuses en calcul. Plus vous effectuez de requêtes SELECT chaque jour, plus il est pertinent de remplacer Big Query par ClickHouse, car ce remplacement peut vous faire économiser des milliers de dollars si vous traitez des téraoctets de données. Cela ne s'applique pas aux données stockées, dont le traitement dans Big Query coûte relativement peu cher.
Dans un article du co-fondateur de la société Altinity, Alexandre Zaïtsev il parle des avantages de cette migration de base de données.
Remplacement de TimescaleDB
TimescaleDB est une extension de PostgreSQL qui optimise le traitement des séries temporelles dans une base de données ordinaire., ).
Bien que ClickHouse ne soit pas un concurrent sérieux dans le domaine des séries temporelles, sa structure en colonnes et son exécution vectorisée des requêtes le rendent, dans la plupart des cas de traitement des requêtes analytiques, beaucoup plus rapide que TimescaleDB. De plus, les performances de traitement des données par lots de ClickHouse sont environ trois fois supérieures, et il utilise également vingt fois moins d'espace disque, ce qui est vraiment important pour le traitement de grands volumes de données historiques..
Contrairement à ClickHouse, le seul moyen d'économiser un peu d'espace disque dans TimescaleDB est d'utiliser ZFS ou des systèmes de fichiers similaires.
Les mises à jour à venir de ClickHouse introduiront probablement la compression delta, ce qui le rendra encore plus adapté pour le traitement et le stockage des données temporelles. TimescaleDB peut devenir un meilleur choix que le ClickHouse « nu » dans les cas suivants :
- petites installations avec très peu de mémoire vive (<3 Go) ;
- un grand nombre de petites INSERT que vous ne souhaitez pas mettre en tampon en gros fragments ;
- meilleure cohérence, uniformité et exigences ACID ;
- support de PostGIS ;
- intégration avec des tables PostgreSQL existantes, car TimescaleDB est essentiellement PostgreSQL.
Concurrence avec les systèmes Hadoop et MapReduce
Hadoop et d'autres produits MapReduce peuvent effectuer de nombreux calculs complexes, mais ils fonctionnent généralement avec de grandes latences. ClickHouse corrige ce problème en traitant des téraoctets de données et en fournissant des résultats presque instantanément. Ainsi, ClickHouse est beaucoup plus efficace pour réaliser des recherches analytiques rapides et interactives, ce qui devrait intéresser les spécialistes du traitement des données.
Concurrence avec Pinot et Druid
Les concurrents les plus proches de ClickHouse sont les produits open source évolutifs linéairement en colonnes Pinot et Druid. Un excellent travail de comparaison entre ces systèmes a été publié dans l'article du 1er février 2018.
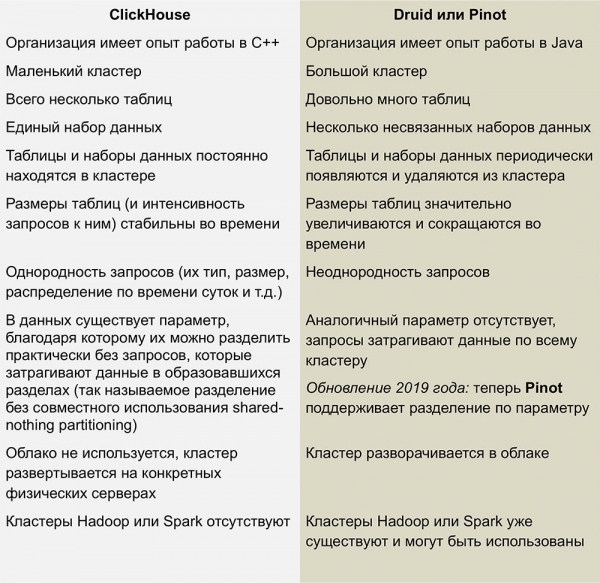
Cet article nécessite une mise à jour - il indique que ClickHouse ne prend pas en charge les opérations UPDATE et DELETE, ce qui n'est pas tout à fait vrai dans les dernières versions.
Nous n'avons pas suffisamment d'expérience avec ces SGBD, mais je n'aime pas du tout la complexité de l'infrastructure requise pour exécuter Druid et Pinot — il s'agit d'un véritable tas de « pièces mobiles » entourées de Java de tous les côtés.
Druid et Pinot sont des projets incubés par Apache, dont le développement est largement documenté par Apache sur les pages de leurs projets GitHub. Pinot a été introduit dans l'incubateur en octobre 2018, tandis que Druid est né huit mois plus tôt – en février.
Le manque d'informations sur le fonctionnement d'AFS suscite en moi certaines interrogations, peut-être même absurdes. Je me demande si les auteurs de Pinot ont remarqué que la fondation Apache est plus encline à Druid, et si cela n'a pas suscité un sentiment d'envie envers leur concurrent ? Le développement de Druid ralentira-t-il et celui de Pinot s'accélérera-t-il si les sponsors soutenant le premier s'intéressent tout à coup au second ?
Inconvénients de ClickHouse
Immaturité : il est évident que c'est encore une technologie émergente, mais en tout cas, rien de similaire n'est observé dans d'autres SGBD en colonnes.
Les petites insertions fonctionnent mal à grande vitesse : les insertions doivent être regroupées en gros morceaux, car la performance des petites insertions diminue proportionnellement au nombre de colonnes dans chaque ligne. C'est ainsi que les données sont stockées sur disque dans ClickHouse — chaque colonne représente 1 fichier ou plus, donc pour insérer 1 ligne contenant 100 colonnes, il faut ouvrir et écrire au moins 100 fichiers. C'est pourquoi un intermédiaire est nécessaire pour le tamponnement des insertions (à moins que le client lui-même ne gère le tamponnage) — il s'agit généralement de Kafka ou d'un système de gestion de files d'attente. Il est également possible d'utiliser le moteur Buffer table pour copier plus tard de grands blocs de données dans des tables MergeTree.
Les jointures de tables sont limitées par la mémoire vive du serveur, mais au moins, elles existent ! Par exemple, Druid et Pinot n'ont pas de telles jointures, car il est difficile de les mettre en œuvre dans des systèmes distribués qui ne prennent pas en charge le déplacement de gros blocs de données entre les nœuds.
Conclusions
Dans les années à venir, nous prévoyons d'utiliser largement ClickHouse chez Qwintry, car ce SGBD offre un excellent équilibre entre performance, faibles coûts, évolutivité et simplicité. Je suis presque sûr qu'il commencera à se répandre rapidement une fois que la communauté ClickHouse trouvera plus de façons de l'utiliser sur des installations petites et moyennes.
Un peu de publicité 🙂
Merci de rester avec nous. Aimez-vous nos articles ? Voulez-vous voir plus de contenu intéressant ? Soutenez-nous en passants une commande ou en nous recommandant à des amis, , un équivalent unique des serveurs d'entrée de gamme, conçu pour vous : (options disponibles avec RAID1 et RAID10, jusqu'à 24 cœurs et jusqu'à 40 Go DDR4).
Dell R730xd deux fois moins cher dans le data center Equinix Tier IV à Amsterdam ? Uniquement chez nous aux Pays-Bas ! Dell R420 — 2x E5-2430 2.2GHz 6C 128Go DDR3 2x960Go SSD 1Gbps 100To — à partir de 99 $ ! Lisez sur
Source : habr.com
