

Les vacances sont terminées et nous revenons avec notre deuxième article de la série sur le Maillage de Services Istio.
Le sujet d'aujourd'hui est le Circuit Breaker, qui en russe signifie «disjoncteur», un terme populaire pour désigner un «automate de protection». Cependant, dans Istio, cet automate ne coupe pas un circuit court-circuité ou surchargé, mais des conteneurs défectueux.
Comment cela devrait fonctionner en théorie
Lorsque les microservices sont gérés par Kubernetes, par exemple dans le cadre de la plateforme OpenShift, ils sont automatiquement redimensionnés en fonction de la charge. Étant donné que les microservices fonctionnent dans des pods, plusieurs instances d'un microservice conteneurisé peuvent coexister à un même point final, et Kubernetes va router les requêtes et équilibrer la charge entre eux. Et, en théorie, tout cela devrait fonctionner parfaitement.
Nous devons garder à l'esprit que les microservices sont petits et éphémères. Cette éphémérité, qui désigne ici la facilité de création et de suppression, est souvent sous-estimée. La naissance et la mort d'une instance de microservice dans un pod sont des événements tout à fait attendus, OpenShift et Kubernetes gèrent cela avec brio, et tout fonctionne impeccablement – mais toujours en théorie.
Comment cela fonctionne en pratique
Imaginez maintenant qu'une instance particulière de microservice, c'est-à-dire un conteneur, soit défaillante : soit elle ne répond pas (erreur 503), soit – ce qui est pire – elle répond, mais trop lentement. Autrement dit, elle a des accrocs ou ne répond pas aux requêtes, mais elle n'est pas automatiquement retirée du pool. Que faire dans ce cas ? Réessayer ? La retirer du schéma de routage ? Et que signifie «trop lentement» – combien cela fait en chiffres, et qui les détermine ? Peut-être que l'on peut simplement lui donner une pause et essayer plus tard ? Si oui, dans combien de temps ?
Qu'est-ce que l'Ejection de Pool dans Istio
C'est ici qu'Istio intervient avec ses automates de protection Circuit Breaker, qui retirent temporairement les conteneurs défectueux du pool de ressources de routage et d'équilibrage de charge, mettant en œuvre la procédure d'Ejection de Pool.
En utilisant la stratégie de détection des anomalies, Istio identifie les pods déviants qui se démarquent du reste, et les retire du pool de ressources pendant un certain temps, connu sous le nom de «fenêtre de sommeil».
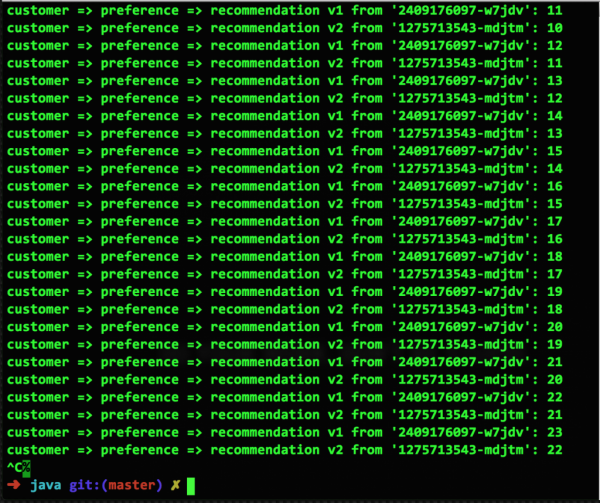
Pour montrer comment cela fonctionne dans Kubernetes sur la plateforme OpenShift, commençons par une capture d'écran de microservices fonctionnant normalement depuis un exemple dans le dépôt. . Ici, nous avons deux pods, v1 et v2, chacun exécutant un conteneur. Lorsque les règles de routage d'Istio ne sont pas utilisées, Kubernetes applique par défaut un routage cyclique équilibré de manière uniforme :
Préparation à la défaillance
Avant de procéder à l'éjection de pool, il faut créer une règle de routage Istio. Supposons que nous souhaitions répartir les requêtes entre les pods à hauteur de 50/50. En outre, nous allons augmenter le nombre de conteneurs v2 d'un à deux, comme ceci :
oc scale deployment recommendation-v2 --replicas=2 -n tutorial
Nous définissons maintenant une règle de routage pour que le trafic soit distribué entre les pods à hauteur de 50/50.
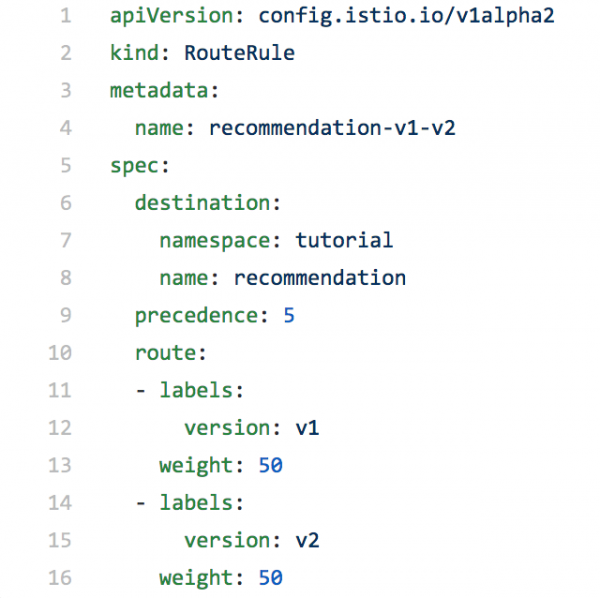
Voici à quoi ressemble le résultat de cette règle :
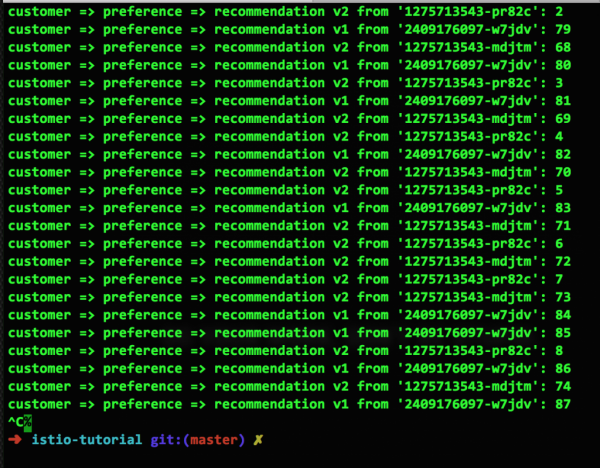
On pourrait arguer que sur cette capture d'écran ce n'est pas 50/50, mais 14:9, mais la situation devrait se réguler avec le temps.
Provoquer une défaillance
Nous allons maintenant mettre hors d'état de marche un des deux conteneurs v2, de sorte que nous ayons un conteneur v1 fonctionnel, un conteneur v2 fonctionnel et un conteneur v2 défaillant :
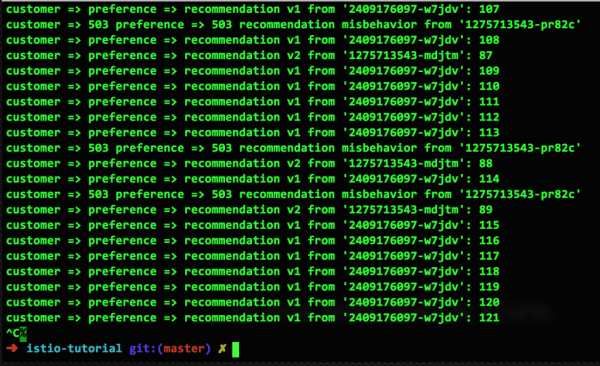
Réparer la défaillance
Ainsi, nous avons un conteneur défaillant, et il est temps d'effectuer l'éjection de pool. Avec une configuration très simple, nous exclurons ce conteneur défaillant de tout schéma de routage pendant 15 secondes en espérant qu'il se rétablisse (soit par redémarrage, soit en restaurant ses performances). Voici à quoi ressemble cette configuration et les résultats de son exécution :
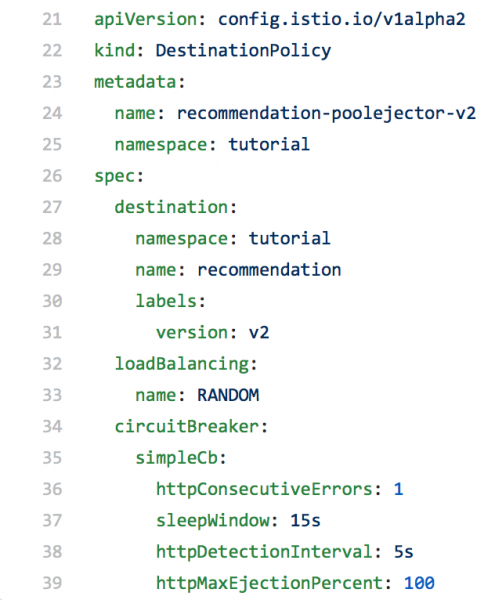
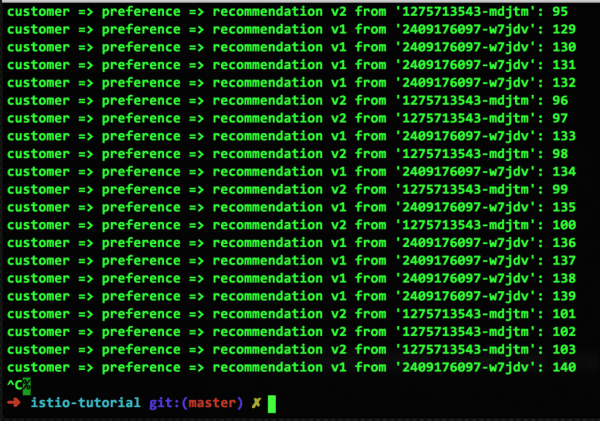
Comme on peut le voir, le conteneur défaillant v2 n'est plus utilisé pour le routage des requêtes, car il a été retiré du pool. Cependant, après 15 secondes, il reviendra automatiquement dans le pool. En fait, nous venons de démontrer comment fonctionne l'éjection de pool.
Commencer à construire l'architecture
L'éjection de pool combinée aux capacités de surveillance d'Istio permet de commencer à établir un cadre d'automatisation du remplacement des conteneurs défaillants, afin de réduire ou même d'éliminer les temps d'arrêt et les défaillances.
La NASA a un célèbre slogan : Failure Is Not an Option, attribué au directeur des opérations de vol. . En français, cela peut être traduit par « L'échec n'est pas une option », et l'idée ici est que tout peut fonctionner avec suffisamment de volonté. Cependant, dans la réalité, les échecs ne se produisent pas seulement, ils sont inévitables, partout et dans tout. Comment gérer cela dans le cas des microservices ? À notre avis, il vaut mieux compter non pas sur la volonté, mais sur les capacités des conteneurs. , et .
Istio, comme nous l'avons déjà mentionné, met en œuvre un concept de disjoncteurs automatiques qui a fait ses preuves dans le monde physique. Tout comme un disjoncteur électrique déconnecte la partie problématique d'un circuit, le Circuit Breaker d'Istio interrompt la connexion entre le flux de requêtes et le conteneur problématique, lorsqu'il y a un problème avec le point final, par exemple, lorsque le serveur est tombé ou commence à ralentir.
De plus, dans le second cas, les problèmes ne font que s'aggraver, car les ralentissements d'un conteneur provoquent non seulement un cascade de délais dans les services qui y font appel, ce qui réduit la performance globale du système, mais génèrent également des requêtes répétées vers un service déjà lent, ce qui aggrave encore la situation.
Circuit Breaker en théorie
Le Circuit Breaker est un proxy qui contrôle le flux des requêtes vers un point final. Lorsque ce point cesse de fonctionner ou, en fonction des paramètres définis, commence à ralentir, le proxy rompt la connexion avec le conteneur. Le trafic est alors redirigé vers d'autres conteneurs, simplement pour équilibrer la charge. La connexion reste ouverte (open) pendant une période d'attente définie, disons deux minutes, puis est considérée comme semi-ouverte (half-open). Une tentative d'envoyer la requête suivante détermine l'état ultérieur de la connexion. Si tout va bien avec le service, la connexion revient à l'état de travail et redevient fermée (closed). En revanche, si le service présente toujours des problèmes, la connexion est à nouveau rompue et une nouvelle période d'attente est lancée. Voici à quoi ressemble un diagramme simplifié de l'état du Circuit Breaker :
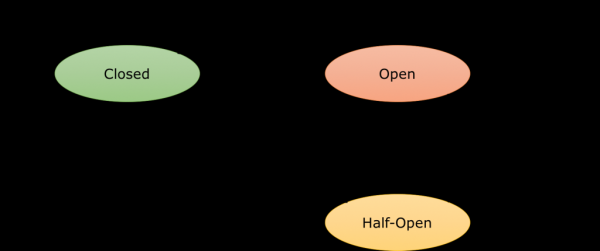
Il est important de noter que tout cela se passe au niveau, disons, de l'architecture système. Par conséquent, à un moment donné, vous devrez apprendre à vos applications à travailler avec le Circuit Breaker, par exemple en fournissant une valeur par défaut en réponse ou, si possible, en ignorant l'existence du service. Pour cela, le modèle bulkhead est utilisé, mais il dépasse le cadre de cet article.
Circuit Breaker en pratique
Par exemple, nous allons lancer sur OpenShift deux versions de notre microservice de recommandations. La version 1 fonctionnera normalement, tandis que dans v2, nous intégrerons un délai pour simuler des lenteurs sur le serveur. Un outil sera utilisé pour visualiser les résultats. :
siege -r 2 -c 20 -v customer-tutorial.$(minishift ip).nip.io
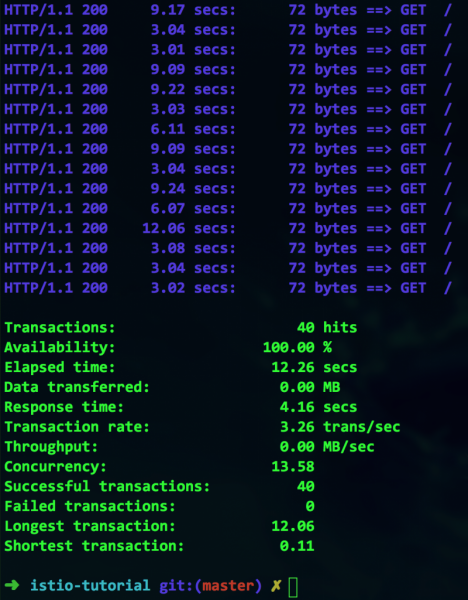
Tout semble fonctionner, mais à quel prix ? À première vue, nous avons 100 % de disponibilité, mais regardez de plus près – la durée maximale de la transaction est de 12 secondes. C'est clairement un goulet d'étranglement, et il doit être élargi.
Pour cela, nous exclurons les appels aux conteneurs lents avec Istio. Voici à quoi ressemble la configuration correspondante avec le Circuit Breaker :
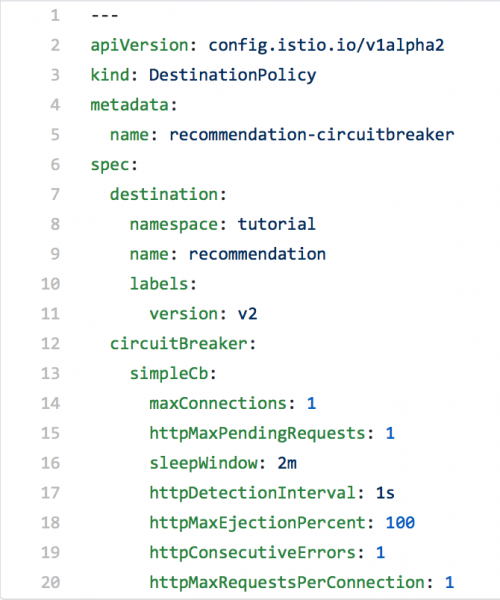
La dernière ligne avec le paramètre httpMaxRequestsPerConnection indique que la connexion doit être coupée lors de la tentative de création d'une nouvelle connexion – la seconde – en plus de la connexion déjà existante. Comme notre conteneur simule un service lent, de telles situations se produiront périodiquement, et dans ce cas, Istio retournera une erreur 503, et voici ce que montrera siege :
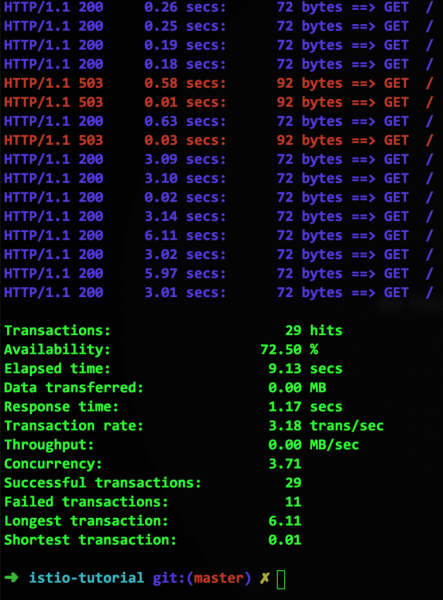
D'accord, nous avons le Circuit Breaker, que faire ensuite ?
Ainsi, nous avons implémenté la désactivation automatique, sans toucher au code source des services eux-mêmes. En utilisant le Circuit Breaker et la procédure d'Ejection de Pool décrite ci-dessus, nous pouvons retirer du pool de ressources les conteneurs lents jusqu'à ce qu'ils reviennent à la normale et vérifier leur état à intervalles réguliers – dans notre exemple, cela prend deux minutes (paramètre sleepWindow).
Notez que la capacité de l'application à réagir à une erreur 503 est toujours définie au niveau de son code source. Il existe de nombreuses stratégies de gestion du Circuit Breaker qui sont appliquées selon la situation.
Dans le prochain article : nous parlerons de la traçabilité et de la surveillance, qui sont déjà intégrées ou facilement ajoutées à Istio, ainsi que des manières d'introduire intentionnellement des erreurs dans le système.
Source : habr.com
