

Artem Denisov ( , )
Badoo est le plus grand site de rencontres au monde. Actuellement, nous avons environ 330 millions d'utilisateurs enregistrés dans le monde entier. Mais ce qui est encore plus important dans le cadre de notre discussion aujourd'hui, c'est que nous stockons environ 3 pétaoctets de photos d'utilisateurs. Chaque jour, nos utilisateurs téléchargent environ 3,5 millions de nouvelles photos, et la charge de lecture est d'environ 80 000 requêtes par seconde. C'est déjà beaucoup pour notre backend, et il arrive que cela pose des problèmes.
Je vais parler de la conception de ce système qui stocke et fournit les photos dans l'ensemble, et je donnerai un aperçu de son évolution du point de vue du développeur. Il y aura un bref retour d'expérience, où je marquerai les principales étapes, mais je parlerai plus en détail des solutions que nous utilisons actuellement.
Et maintenant, commençons.
Comme je l'ai déjà dit, ce sera un retour d'expérience, et pour commencer, prenons l'exemple le plus banal.
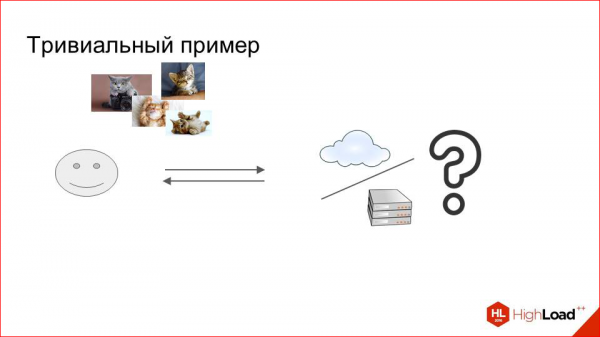
Nous avons une tâche générale, nous devons recevoir, stocker et fournir les photos des utilisateurs. Dans cette formulation, la tâche est générale, nous pouvons utiliser n'importe quoi :
- un stockage cloud moderne,
- une solution clé en main, d'ailleurs, il y en a beaucoup en ce moment ;
- nous pouvons configurer plusieurs machines dans notre centre de données et y installer de grands disques durs pour y stocker les photos.
Badoo vit historiquement - et maintenant, comme à l'époque où cela a été créé - sur ses propres serveurs, à l'intérieur de nos propres centres de données. Donc, pour nous, cette option était optimale.
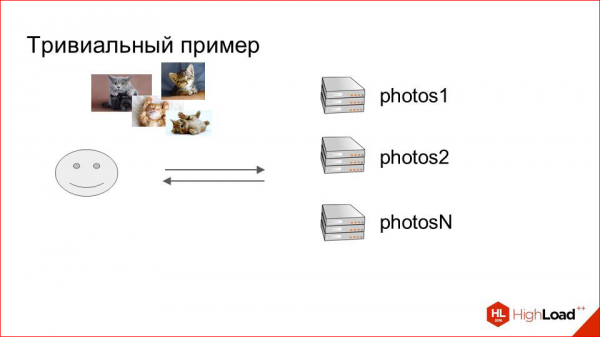
Nous avons simplement pris plusieurs machines, les avons appelées « photos », et nous avons créé un cluster qui stocke les photos. Mais il semble qu'il manque quelque chose. Pour que tout cela fonctionne, il faut d'une manière ou d'une autre déterminer sur quelle machine quelles photos nous allons stocker. Et là aussi, pas besoin de réinventer la roue.
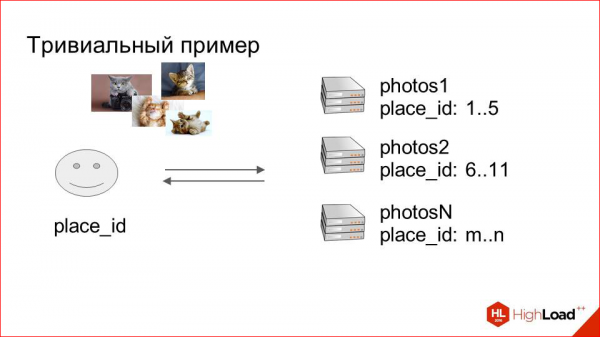
Nous ajoutons à notre stockage avec les informations sur les utilisateurs un champ. Ce sera la clé de partitionnement. Dans notre cas, nous l'avons appelé place_id, et cet id de lieu indique où sont stockées les photos des utilisateurs. Nous établissons des cartes.
Au début, cela peut même se faire manuellement : nous disons que la photo de cet utilisateur avec cet emplacement sera enregistrée sur ce serveur. Grâce à cette carte, nous savons toujours quand un utilisateur télécharge une photo, où la sauvegarder, et d'où la délivrer.
C'est un schéma absolument trivial, mais il présente suffisamment d'avantages. D'abord, c'est simple, comme je l'ai déjà mentionné, et ensuite, avec cette approche, nous pouvons facilement évoluer horizontalement, simplement en ajoutant de nouveaux serveurs et en les intégrant à la carte. Il n'est pas nécessaire de faire autre chose.
Et c'est resté comme ça pendant un certain temps.
C'était vers 2009. Nous avons livré des machines, livré...
Et à un certain moment, nous avons commencé à remarquer que ce schéma avait certains inconvénients. Quels inconvénients ?
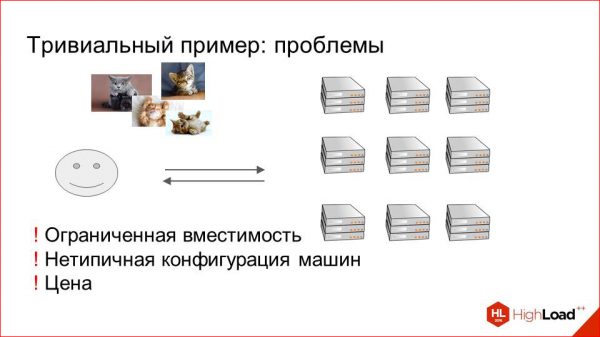
Tout d'abord, c'est une capacité limitée. Nous ne pouvons pas mettre autant de disques durs que nous le souhaiterions sur un seul serveur physique. Avec le temps et la croissance du dataset, cela est devenu un problème.
Et deuxièmement. C'est une configuration atypique de machines, car il est difficile de les réutiliser dans d'autres clusters, elles sont assez spécifiques, c'est-à-dire qu'elles doivent être peu performantes, mais en même temps avoir un grand disque dur.
Tout cela était valable en 2009, mais en principe, ces exigences sont toujours d'actualité aujourd'hui. Nous avons une rétrospective, donc en 2009, tout cela était déjà problématique.
Et le dernier point - c'est le prix.
À l'époque, le prix était très élevé, et nous devions chercher des alternatives. C'est-à-dire que nous devions mieux utiliser à la fois l'espace dans les centres de données et les serveurs physiques sur lesquels tout cela était hébergé. Nos ingénieurs systèmes ont entrepris une grande étude, où ils ont réévalué de nombreuses options. Ils ont examiné des systèmes de fichiers en cluster, comme PolyCeph et Lustre. Il y avait des problèmes de performance et une exploitation assez complexe. Ils ont abandonné cette idée. Ils ont essayé de monter l'ensemble du dataset via NFS sur chaque machine, afin de tenter de le mettre à l'échelle. La lecture n'a pas bien fonctionné non plus, ils ont essayé différentes solutions de différents fournisseurs.
Et finalement, nous avons décidé d'utiliser ce qu'on appelle un Storage Area Network.
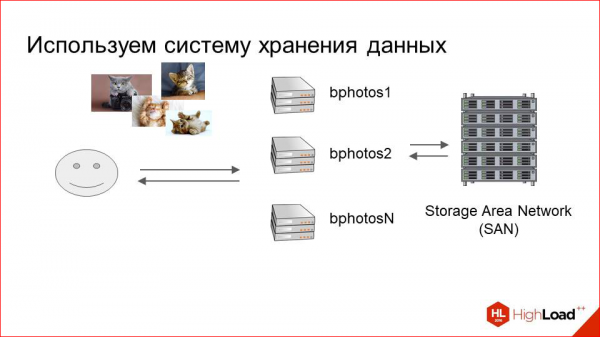
Ce sont de grands systèmes de stockage de données (SHD) qui sont spécialement conçus pour le stockage de volumes importants de données. Ils se composent de racks avec des disques montés sur des machines de sortie finales via fibre optique. Ainsi, nous avons un certain pool de machines, relativement petit, et ces SHD, qui sont transparents pour notre logique de sortie, c'est-à-dire pour notre nginx ou tout autre service, traitent les requêtes concernant ces photos.
Cette solution présente des avantages évidents. Il s'agit de SHD. Elle est orientée vers le stockage de photos. Cela revient moins cher que d'équiper simplement des machines avec des disques durs.
Le deuxième avantage.
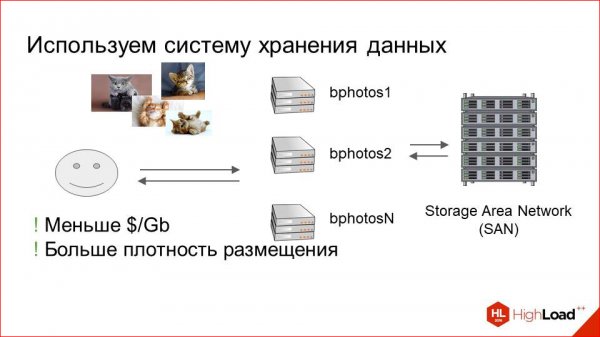
C'est que la capacité est devenue beaucoup plus grande, c'est-à-dire que nous pouvons maintenant héberger beaucoup plus de stockage dans un volume beaucoup plus petit.
Mais il y avait aussi des inconvénients qui se sont rapidement manifestés. Avec l'augmentation du nombre d'utilisateurs et la charge sur ce système, des problèmes de performance ont commencé à apparaître. Et le problème est assez évident : tout SHD destiné à stocker de nombreuses photos dans un petit volume souffre généralement d'intensité de lecture. Cela est en fait valable pour tout stockage cloud, et peu importe quoi. Actuellement, nous n'avons pas de stockage idéal qui soit infiniment évolutif, dans lequel nous pourrions mettre tout ce que nous voulons, et qui supporterait très bien les lectures, en particulier les lectures aléatoires.
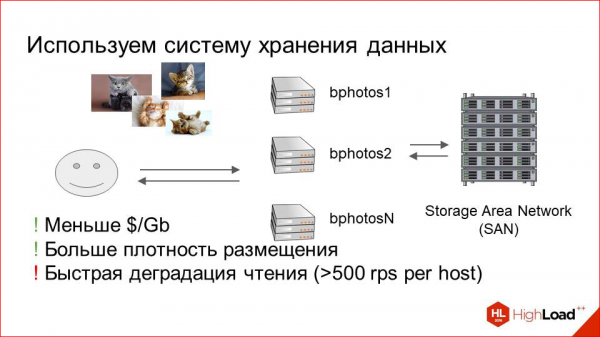
Comme dans le cas de nos photos, car les photos sont demandées de manière non séquentielle, ce qui affecte fortement leur performance.
Même avec les chiffres d'aujourd'hui, si nous dépassons environ 500 RPS pour les photos sur la machine à laquelle le stockage est connecté, des problèmes commencent déjà à apparaître. Et c'était un problème pour nous, car le nombre d'utilisateurs augmente, tout ne peut que s'aggraver. Nous devons optimiser cela d'une manière ou d'une autre.
Pour optimiser, à l'époque, nous avons décidé, évidemment, d'examiner le profil de charge - que se passe-t-il, ce qui doit être optimisé.
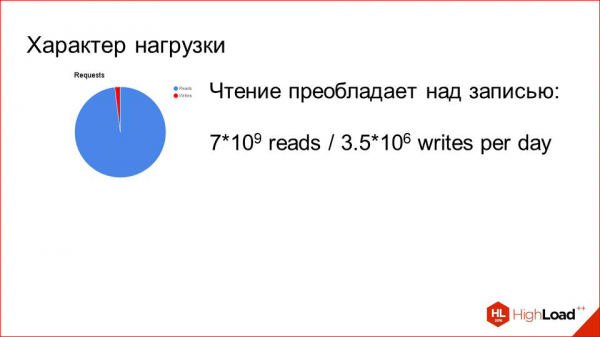
Et ici, tout joue en notre faveur.
J'ai déjà dit dans ma première diapositive : nous avons 80 000 requêtes par seconde en lecture pour seulement 3,5 millions de téléchargements par jour. Donc, il y a une différence de trois ordres de grandeur. Il est clair qu'il faut optimiser la lecture et c'est pratiquement compréhensible comment.
Il y a aussi un petit détail. La spécificité du service est telle qu'une personne s'inscrit, télécharge une photo, puis commence à consulter activement d'autres personnes, à les liker, et elle est montrée à d'autres utilisateurs. Ensuite, elle trouve ou ne trouve pas de partenaire, cela dépend, et pour un certain temps, elle arrête d'utiliser le service. À ce moment-là, lorsque son utilisation est active, ses photos sont très demandées - elles sont vues par beaucoup de gens. Dès qu'elle arrête, elle sort rapidement de ces affichages intensifs, comme avant, et ses photos sont pratiquement moins demandées.
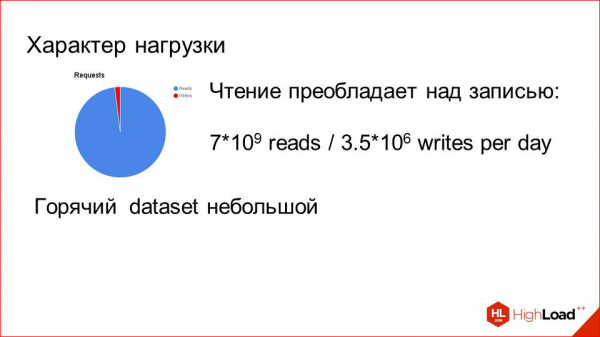
C'est-à-dire que nous avons un très petit dataset actif. Mais il y a en même temps beaucoup de demandes à son égard. Il s'impose donc de manière évidente d'ajouter un cache.
Un cache avec LRU résoudra tous nos problèmes. Que faisons-nous ?
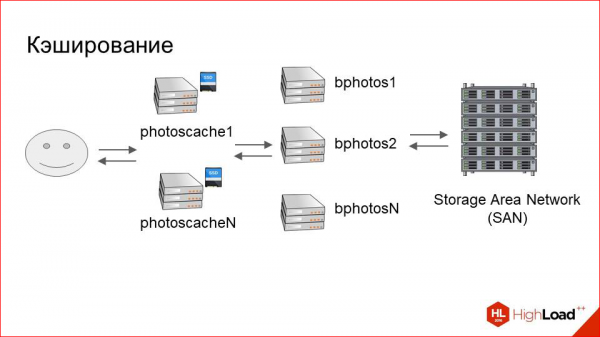
Nous ajoutons devant notre grand cluster de stockage un autre cluster relativement petit, que nous appelons les photokéshes (photoscache). C'est en fait juste un proxy de mise en cache.
Comment cela fonctionne-t-il de l'intérieur ? Voici notre utilisateur, voici le stockage. Tout est comme avant. Que rajoutons-nous entre eux ?
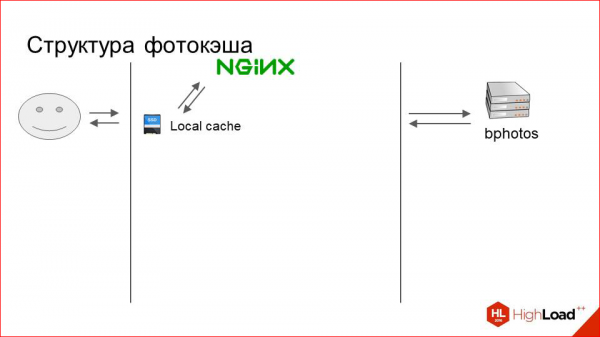
C'est simplement une machine avec un disque local physique qui est rapide. C'est avec un SSD, par exemple. Et sur ce disque, il y a un cache local.
À quoi cela ressemble-t-il ? L'utilisateur envoie une demande pour une photo. NGINX la cherche d'abord dans le cache local. Si ce n'est pas là, il fait simplement un proxy_pass vers notre stockage, télécharge la photo de là-bas et la donne à l'utilisateur.
Mais c'est très banal et il n'est pas clair ce qui se passe à l'intérieur. Cela fonctionne plus ou moins comme ça.
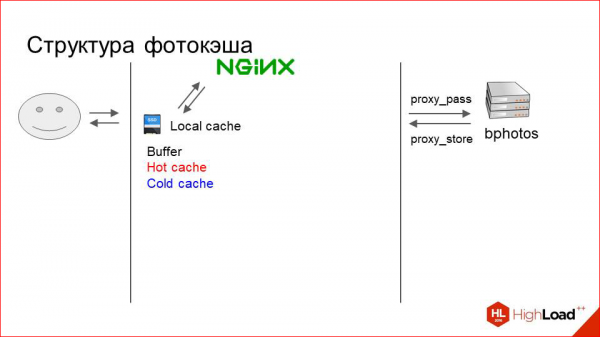
Le cache est logiquement divisé en trois couches. Quand je dis « trois couches », cela ne signifie pas qu'il y a un système complexe. Non, ce sont simplement trois répertoires dans le système de fichiers :
- C'est un buffer où atterrissent les photos nouvellement téléchargées du proxy.
- C'est un cache chaud, où se trouvent les photos qui sont actuellement activement demandées.
- Et un cache froid, où les photos sont progressivement poussées hors du chaud lorsque le nombre de requêtes diminue.
Pour que cela fonctionne, nous devons gérer ce cache, remettre les photos dans celui-ci, etc. C'est aussi un processus très primitif.
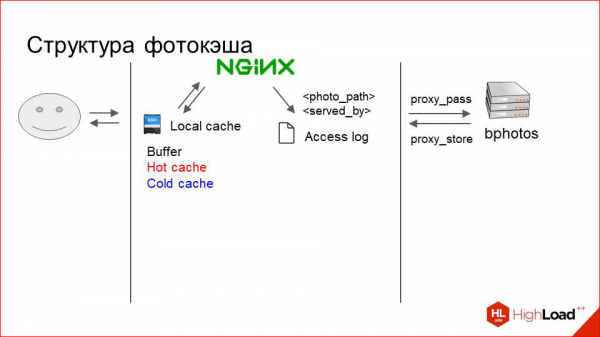
Nginx écrit simplement sur le RAMDisk access.log pour chaque requête, indiquant le chemin de la photo qu'il sert actuellement (un chemin relatif, bien sûr), ainsi que le segment qui l'a servi. Par exemple, il pourrait être écrit « photo 1 » et ensuite soit le tampon, soit le cache chaud, soit le cache froid, soit un proxy.
En fonction de cela, nous devons prendre une décision sur ce qu'il faut faire avec la photo.
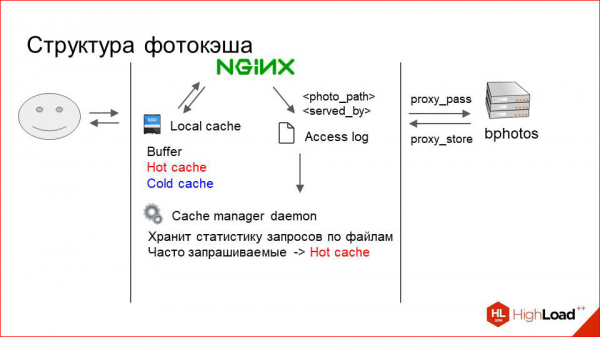
Sur chaque machine, un petit démon fonctionne en permanence, lisant ce log et stockant dans sa mémoire des statistiques sur l'utilisation de certaines photos.
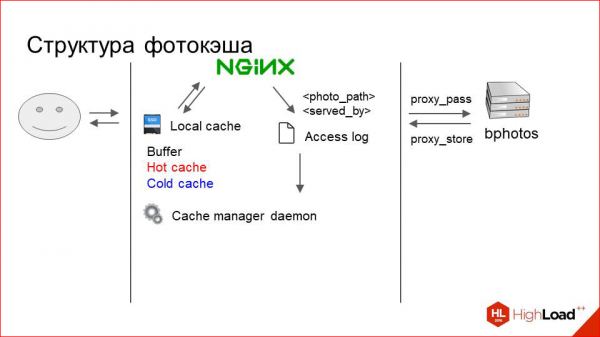
Il collecte simplement ces données, maintient des compteurs et effectue périodiquement les actions suivantes. Les photographies très demandées, qui reçoivent de nombreuses requêtes, sont déplacées vers le cache chaud, peu importe où elles se trouvent.
Les photos qui sont rarement demandées et qui ont commencé à être moins demandées sont progressivement poussées du cache chaud vers le cache froid.
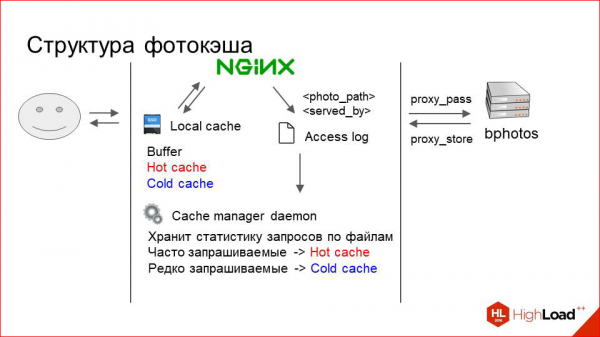
Et quand l'espace dans notre cache est épuisé, nous commençons simplement à supprimer tout du cache froid sans discernement. Et cela, d'ailleurs, fonctionne assez bien.
Pour que la photo soit immédiatement enregistrée lors du proxy dans le tampon, nous utilisons la directive proxy_store, et le tampon est également un RAMDisk, c'est-à-dire que pour l'utilisateur, cela fonctionne très rapidement. C'est en ce qui concerne les entrailles du serveur de cache lui-même.
Il reste la question de savoir comment répartir les requêtes entre ces serveurs.
Disons qu'il y a un cluster de vingt machines de stockage et trois serveurs de cache (c'est ainsi que les choses se sont passées).
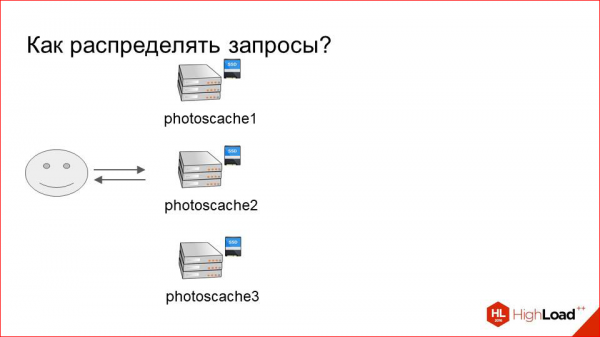
Nous devons trouver un moyen de déterminer quelles requêtes concernent quelles photos et où les diriger.
La manière la plus simple serait de faire un Round Robin. Ou de le faire au hasard ?
Cela présente évidemment un certain nombre d'inconvénients, car nous allons utiliser le cache de manière très inefficace dans cette situation. Les requêtes seront dirigées vers des machines aléatoires : ici, elle est en cache, mais sur la machine voisine, elle n'y est déjà plus. Et tout cela, si cela fonctionne, fonctionnera très mal, même avec un petit nombre de machines dans le cluster.
Nous devons nécessairement déterminer sur quel serveur diriger chaque requête.
Il existe une méthode simple. Nous prenons le hachage de l'URL ou le hachage de notre clé de partitionnement, qui se trouve dans l'URL, et nous le divisons par le nombre de serveurs. Cela fonctionnera-t-il ? Oui.
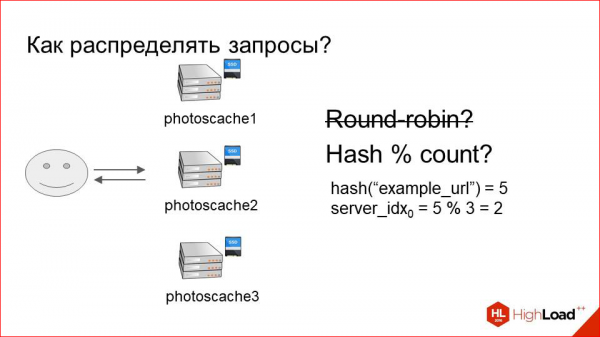
C'est-à-dire qu'il y a toujours un request à 100 % pour une « example_url » qui atterrit sur le serveur avec l'index « 2 », et le cache est constamment utilisé de manière optimale.
Mais un problème survient avec le resharding dans ce schéma. Par resharding, j'entends le changement du nombre de serveurs.
Supposons que notre cluster de cache ne parvienne plus à suivre, et que nous avons décidé d'ajouter une machine supplémentaire.
Ajoutons-en une.
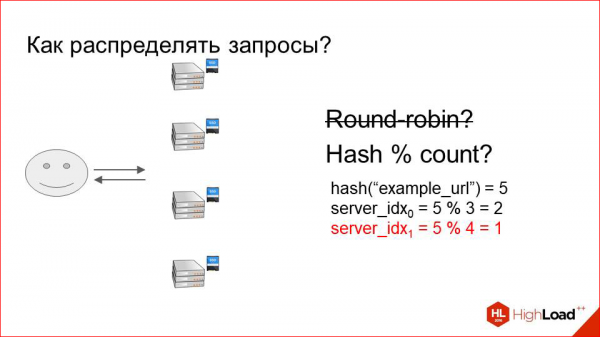
Nous avons désormais tout divisé non plus par trois, mais par quatre. Ainsi, presque toutes les clés que nous avions auparavant, presque toutes les URL, se trouvent désormais sur d'autres serveurs. Tout le cache a été invalidé instantanément. Toutes les requêtes se sont dirigées vers notre cluster de stockage, il a commencé à avoir des problèmes, avec des pannes de service et des utilisateurs mécontents. Nous ne voulons vraiment pas que cela se produise.
Cette option ne nous convient pas non plus.
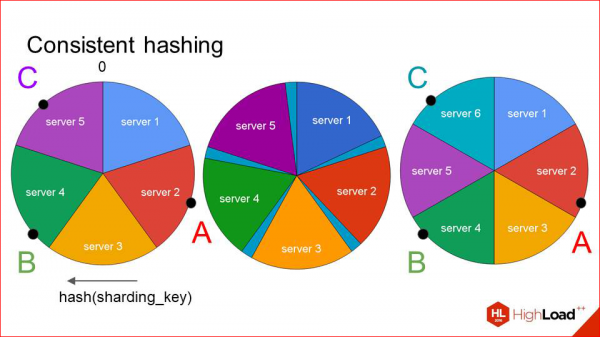
Donc, que devons-nous faire ? Nous devons d'une manière ou d'une autre utiliser le cache efficacement, atterrissant constamment une requête sur le même serveur, tout en restant résilients au resharding. Et il existe une solution, qui n'est pas si compliquée. Elle s'appelle le consistent hashing.
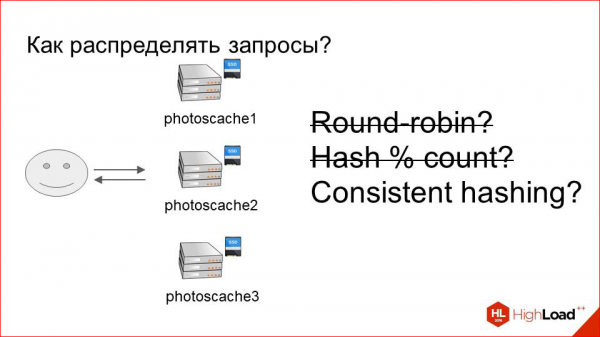
À quoi cela ressemble-t-il ?
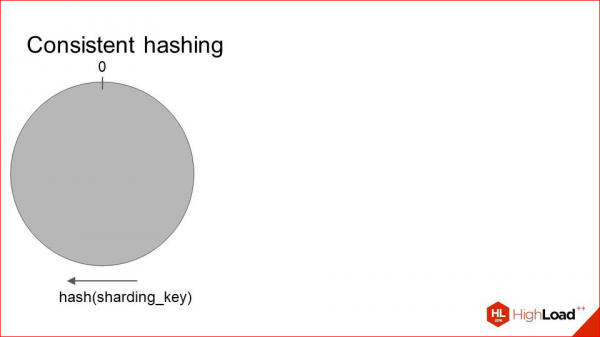
Nous prenons une certaine fonction de la clé de sharding et étalons toutes ses valeurs sur un cercle. Autrement dit, au point 0, nous avons ses valeurs minimales et maximales qui se rejoignent. Ensuite, nous plaçons tous nos serveurs sur ce même cercle de manière à ce que :
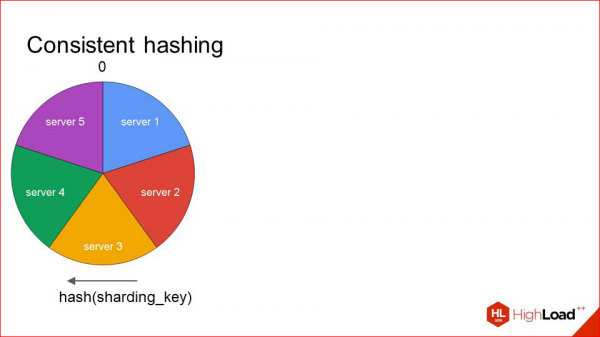
Chaque serveur est déterminé par un point, et le secteur qui mène jusqu'à lui dans le sens horaire est donc géré par cet hôte. Lorsque nous recevons des requêtes, nous voyons immédiatement que, par exemple, la requête A a un hash comme celui-ci — et elle est traitée par le serveur 2. La requête B — par le serveur 3. Et ainsi de suite.
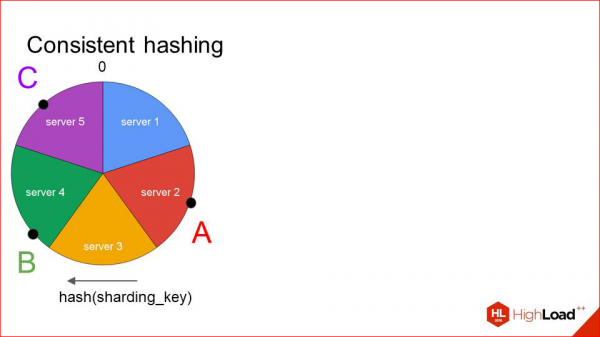
Que se passe-t-il dans cette situation lors du resharding ?
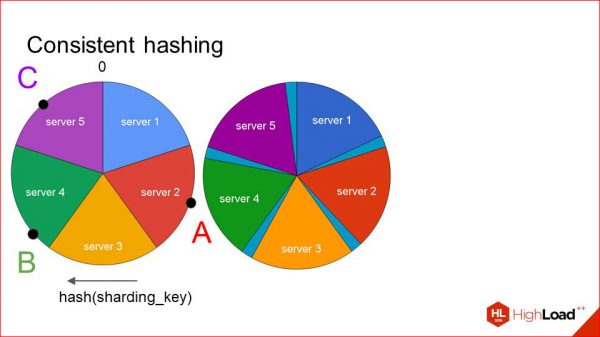
Nous n'invalidons pas tout le cache, comme auparavant, et nous ne déplaçons pas toutes les clés, mais nous déplaçons chaque secteur sur une courte distance de telle sorte que l'espace libéré, pour ainsi dire, puisse accueillir notre sixième serveur que nous voulons ajouter, et nous l'ajoutons là.
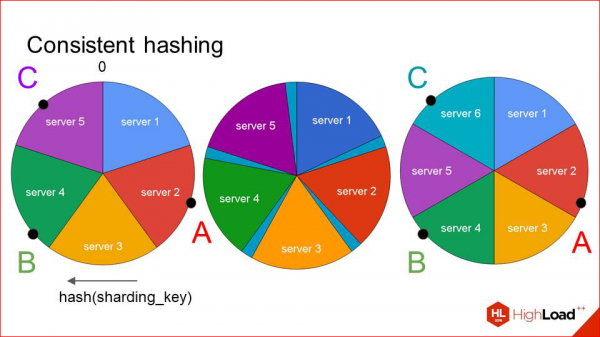
Bien sûr, dans une telle situation, les clés sont également affectées. Mais elles le sont beaucoup moins qu'auparavant. Nous voyons que nos deux premières clés sont restées sur leurs serveurs, et que seul le serveur de mise en cache a changé pour la dernière clé. Cela fonctionne assez efficacement, et si vous ajoutez progressivement de nouveaux hôtes, il n'y a pas de gros problème ici. Vous ajoutez petit à petit, attendez que le cache se remplisse à nouveau, et tout fonctionne correctement.
Une seule question demeure en cas de pannes. Supposons qu'une de nos machines soit tombée en panne.
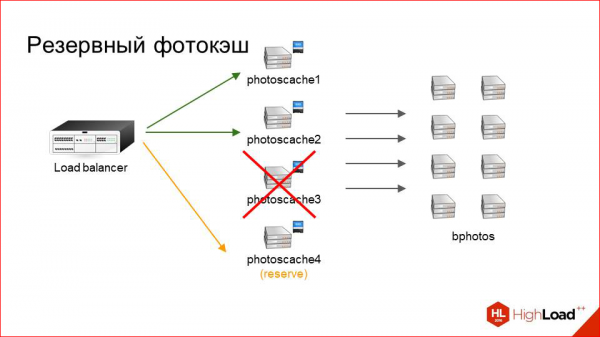
Et nous préférerions ne pas avoir à régénérer cette carte à ce moment-là, à invalider une partie du cache, etc., si, par exemple, la machine redémarre, et que nous devons traiter les requêtes. Nous maintenons simplement un cache photo de secours sur chaque site, qui joue le rôle de remplacement pour toute machine qui est actuellement hors service. Et si soudainement un de nos serveurs devient indisponible, le trafic est redirigé vers celui-ci. Bien entendu, il n'y a pas de cache là-bas, c'est-à-dire qu'il est froid, mais au moins les requêtes des utilisateurs sont traitées. Si c'est un court intervalle, nous le gérons très bien. Il y a juste une charge accrue sur le stockage. Si l'intervalle est long, nous pouvons alors décider de retirer ce serveur de la carte ou non, ou peut-être de le remplacer par un autre.
C'est concernant le système de mise en cache. Voyons les résultats.
Il semblerait qu'il n'y ait rien de compliqué ici. Mais cette méthode de gestion du cache nous a donné un taux de réussite d'environ 98 %. C'est-à-dire que sur ces 80 000 requêtes par seconde, seulement 1600 atteignent les stockages, et cela représente une charge tout à fait normale, qu'ils gèrent sans souci, nous avons toujours une marge.
Nous avons placé ces serveurs dans trois de nos DC, et nous avons obtenu trois points de présence - Prague, Miami et Hong Kong.
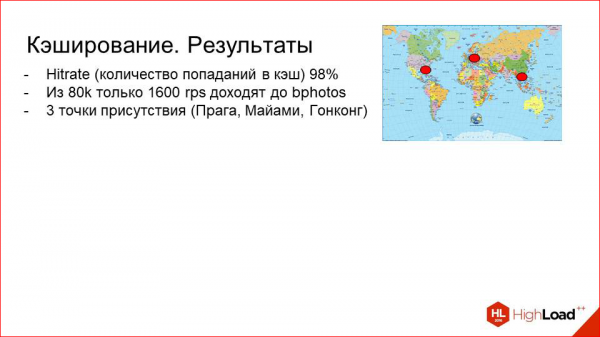
Ainsi, ils sont plus ou moins situés localement par rapport à chacun de nos marchés cibles.
Et en bonus, nous avons obtenu ce proxy de mise en cache, dont le CPU est en fait sous-utilisé, car pour la restitution du contenu, il n'est pas si nécessaire. Et là, grâce à NGINX + Lua, nous avons réalisé beaucoup de logique utilitaire.
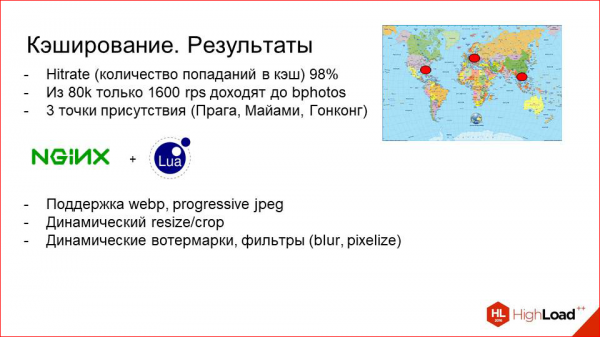
Par exemple, nous pouvons expérimenter avec le webp ou le jpeg progressif (ce sont des formats modernes et efficaces), observer comment cela affecte le trafic, prendre des décisions, les activer pour certains pays, etc. ; effectuer un redimensionnement dynamique ou un recadrage des photos à la volée.
C'est un bon cas d'utilisation, lorsque vous avez par exemple une application mobile qui affiche des photos, et l'application mobile ne veut pas utiliser le CPU du client pour demander une grande photo et la redimensionner ensuite à une certaine taille pour l'insérer dans la vue. Nous pouvons simplement spécifier dynamiquement certains paramètres dans l'URL, disons dans UPort, et le cache des photos redimensionnera la photo lui-même. En règle générale, il choisira la taille qui est physiquement disponible sur le disque, la plus proche de celle demandée, et la réduira dans des coordonnées spécifiques.
Au fait, nous avons rendu publiques les vidéos des cinq dernières années des conférences sur les systèmes à forte charge. . Regardez, étudiez, partagez et abonnez-vous à .
Nous pouvons également y ajouter beaucoup de logique produit. Par exemple, nous pouvons ajouter différents filigranes selon les paramètres de l'URL, nous pouvons flouter les photos, les rendre floues ou pixelisées. C'est quand nous voulons montrer la photo d'une personne, mais nous ne voulons pas montrer son visage, cela fonctionne très bien, tout cela est implémenté ici.
Qu'avons-nous obtenu ? Nous avons obtenu trois points de présence, un bon taux de réussite, et en même temps, notre CPU sur ces machines ne reste pas inactif. Il est désormais, bien sûr, plus important qu'auparavant. Nous devons mettre en place des machines plus puissantes, mais cela en vaut la peine.
En ce qui concerne la distribution des photos, tout cela est assez clair et évident. Je pense que je ne fais pas découvrir l'Amérique, cela fonctionne pratiquement avec n'importe quel CDN.
Et, probablement, l'auditeur averti pourrait se demander : pourquoi ne pas simplement tout remplacer par un CDN ? Cela donnerait à peu près le même résultat, tous les CDN modernes savent faire cela. Et ici, plusieurs raisons sont à considérer.
La première concerne les photos.
C'est l'un des points clés de notre infrastructure, et nous avons besoin d'un maximum de contrôle sur elles. Si c'est une solution d'un vendeur tiers, et que vous n'avez aucun pouvoir sur celle-ci, cela va être assez difficile à gérer lorsque vous avez un grand ensemble de données et un très grand volume de requêtes utilisateurs.
Je vais donner un exemple. Actuellement, sur notre infrastructure, nous pouvons, par exemple, en cas de problèmes ou de vibrations souterraines, accéder à la machine, faire un débogage, pour ainsi dire. Nous pouvons ajouter la collecte de certaines métriques qui ne nous concernent que, nous pouvons expérimenter d'une manière ou d'une autre, voir comment cela affecte les graphiques, et ainsi de suite. Aujourd'hui, beaucoup de statistiques sont collectées sur ce cluster de mise en cache. Nous les examinons périodiquement et étudions en profondeur certaines anomalies. Si cela se passait du côté du CDN, ce serait beaucoup plus difficile à contrôler. Ou, par exemple, en cas d'accident, nous savons ce qui s'est passé, nous savons comment y faire face et comment y remédier. Voici la première conclusion.
La deuxième conclusion est plutôt historique, car le système évolue depuis longtemps, et de nombreuses exigences commerciales ont existé à différentes étapes, et elles ne correspondent pas toujours à la conception du CDN.
Et le point qui découle de ce qui précède –
C'est que sur les caches photo, nous avons beaucoup de logiques spécifiques, que l'on ne peut pas toujours ajouter sur demande. Il est peu probable qu'un CDN ajoute des choses personnalisées à votre demande. Par exemple, le cryptage des URLs, si vous ne voulez pas que le client puisse modifier quoi que ce soit. Vous souhaitez changer l'URL sur le serveur et la crypter, puis passer ici certains paramètres dynamiques.
Quelle conclusion s'impose ? Dans notre cas, le CDN n'est pas une très bonne alternative.
Et dans votre cas, si vous avez des exigences commerciales spécifiques, vous pouvez tout à fait mettre en œuvre ce que je vous ai montré. Et cela fonctionnera très bien avec un profil de charge similaire.
Mais si vous avez une solution générale, et que le problème n'est pas très particulier, vous pouvez tout à fait opter pour un CDN. Ou si pour vous, le temps et les ressources sont bien plus importants que le contrôle.
Et les CDN modernes ont pratiquement tout ce dont je vous ai parlé maintenant. À l'exception de plus ou moins certaines fonctionnalités.
Cela concerne la livraison des photographies.
Passons maintenant un peu plus loin dans notre rétrospective et parlons du stockage.
L'année 2013 avançait.
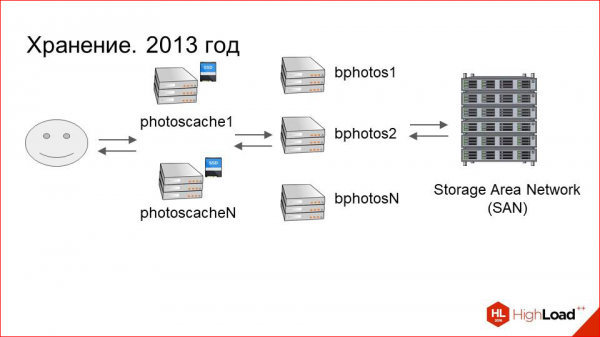
Les serveurs de cache ont été ajoutés, les problèmes de performance ont disparu. Tout va bien. Le dataset augmente. En 2013, nous avions environ 80 serveurs connectés aux systèmes de stockage, et environ 40 serveurs de cache dans chaque centre de données. Cela représente 560 téraoctets de données par centre de données, soit environ un pétaoctet au total.
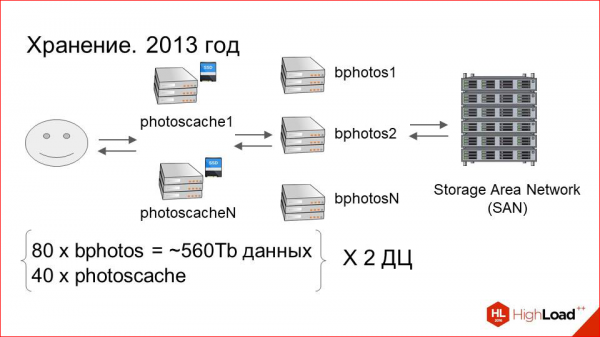
Avec la croissance du dataset, les coûts opérationnels ont également commencé à augmenter considérablement. Comment cela se manifestait-il ?
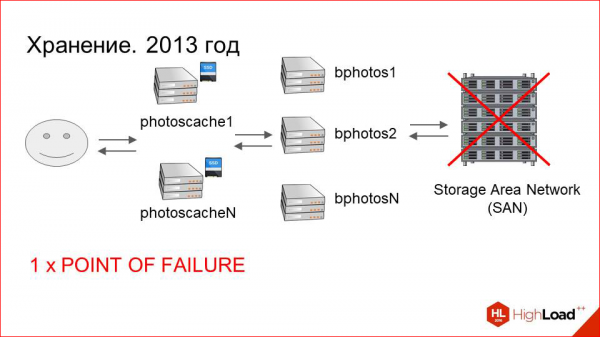
Dans ce schéma, qui est illustré — avec le SAN, les machines connectées à celui-ci et les caches — il y a de nombreux points de défaillance. Si nous avons déjà réussi à gérer les défaillances des serveurs de cache, qui sont plutôt prévisibles et compréhensibles, la situation du côté du stockage était beaucoup plus problématique.
Tout d'abord, le Storage Area Network (SAN) lui-même peut tomber en panne.
Deuxièmement, il est connecté par fibre optique aux machines finales. Il peut y avoir des problèmes avec les cartes optiques et les commutateurs.
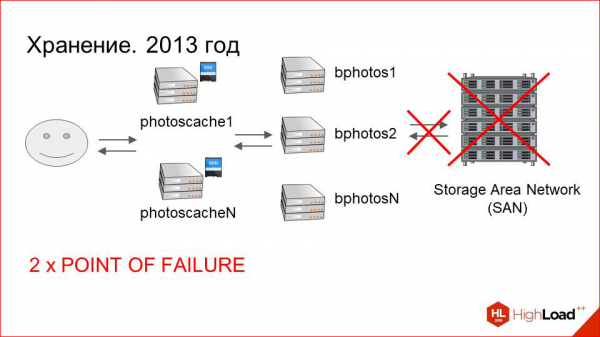
Bien sûr, il n'y en a pas autant qu'avec le SAN lui-même, mais ce sont tout de même des points de défaillance.
Ensuite, il y a la machine elle-même, qui est connectée au stockage. Elle peut également tomber en panne.
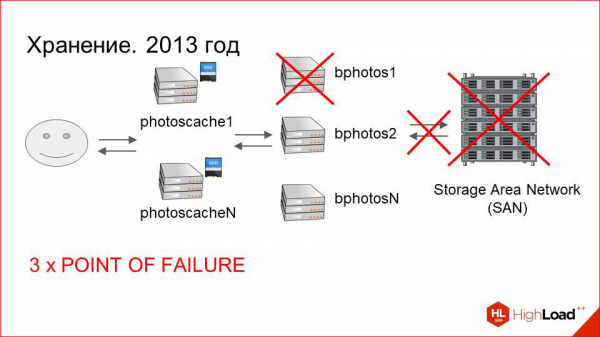
Nous avons donc un total de trois points de défaillance.
En plus des points de défaillance, il y a la gestion lourde des systèmes de stockage.
C'est un système complexe multi-composants, et il est difficile pour les ingénieurs systèmes d'y faire face.
Et enfin, le point le plus important. Si l'une de ces trois points rencontre une défaillance, nous avons une probabilité non nulle de perdre des données utilisateur, car le système de fichiers peut être endommagé.
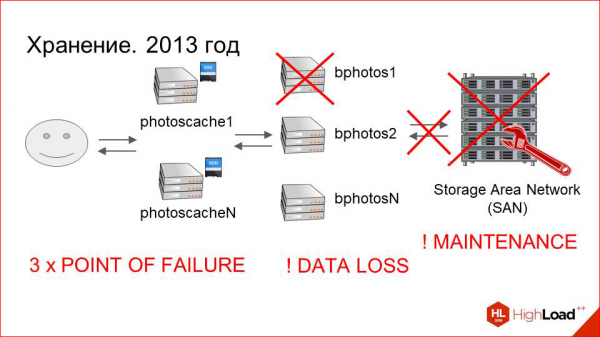
Supposons que notre système de fichiers ait été endommagé. Sa récupération prend, tout d'abord, beaucoup de temps — cela peut prendre une semaine avec un grand volume de données. Et ensuite, nous obtiendrons probablement un tas de fichiers incompréhensibles, qu'il faudra d'une manière ou d'une autre faire correspondre aux photos des utilisateurs. Et nous risquons de perdre des données. Le risque est suffisamment élevé. Plus de telles situations se produisent souvent, et plus il y a de problèmes dans toute cette chaîne, plus ce risque augmente.
Il fallait faire quelque chose. Et nous avons décidé qu'il fallait simplement sauvegarder les données. C'est en fait une solution évidente et bonne. Que avons-nous fait ?
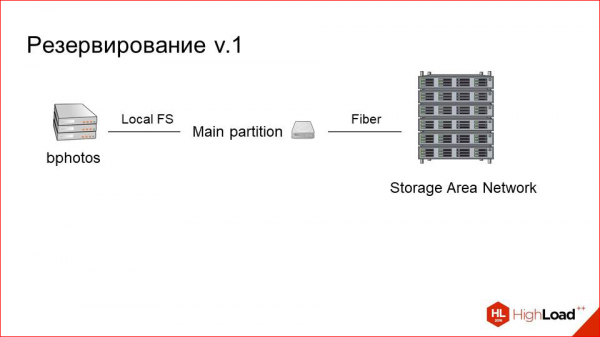
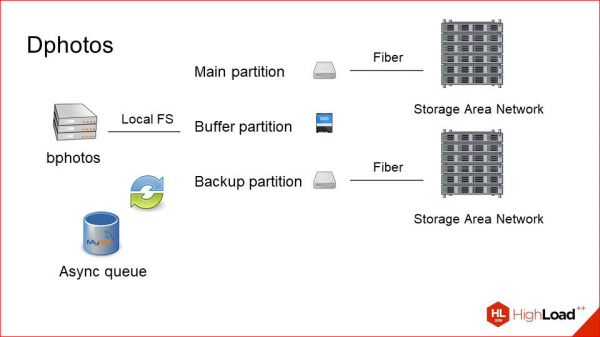
Voici à quoi ressemblait notre serveur, qui était connecté au stockage auparavant. C'est une seule partition principale, c'est simplement un dispositif de bloc qui représente en fait un montage sur un stockage distant par fibre optique.
Nous avons simplement ajouté une seconde partition.
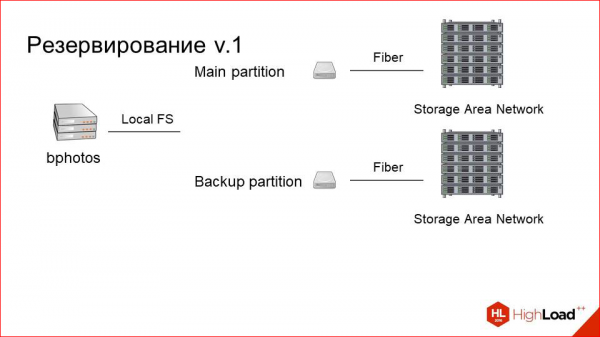
Nous avons installé un deuxième stockage à côté (heureusement, ce n'est pas si coûteux), et nous l'avons appelé section de sauvegarde. Il est également connecté par fibre optique, sur la même machine. Mais nous devons somehow synchroniser les données entre eux.
Ici, nous créons simplement une file d'attente asynchrone à côté.
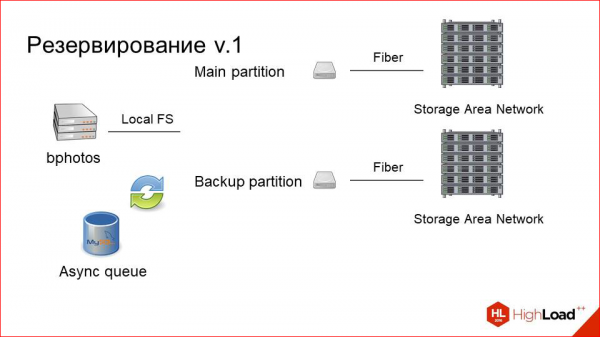
Elle n'est pas très chargée. Nous savons que nous avons peu d'enregistrements. La file d'attente est simplement un tableau dans MySQL, où s'écrivent des lignes du type «il faut sauvegarder cette photo». À chaque changement ou lors d'un upload, nous copions de la section principale vers la sauvegarde avec un worker asynchrone ou simplement un worker d'arrière-plan.
Et ainsi, nous avons toujours deux sections cohérentes. Même si une partie de ce système tombe en panne, nous pouvons toujours échanger la section principale avec la sauvegarde, et tout continue de fonctionner.
Mais à cause de cela, la charge de lecture augmente considérablement, car en plus des clients qui lisent à partir de la section principale, puisque d'abord ils regardent la photo là (elle est plus récente), puis ils cherchent sur la sauvegarde, si ils ne la trouvent pas (mais c'est simplement NGINX qui le fait), notre système de sauvegarde lit également à partir de la section principale. Ce n'est pas une goulot d'étranglement, mais nous ne voulions pas augmenter la charge, simplement pour rien.
Et nous avons ajouté un troisième disque, qui est un petit SSD, et nous l'avons appelé buffer.
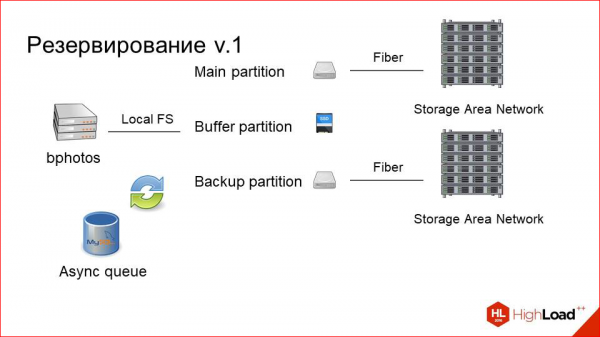
Comment cela fonctionne maintenant.
L'utilisateur upload une photo sur le buffer, ensuite un événement est envoyé dans la file d'attente disant qu'il faut la copier sur les deux sections. Elle est copiée, et la photo vit un certain temps (disons, un jour) sur le buffer, puis est purgée. Cela améliore considérablement l'expérience utilisateur, car généralement, après avoir téléchargé la photo, les requêtes commencent à arriver immédiatement, ou il actualise la page lui-même. Mais cela dépend de l'application qui effectue l'upload.
Ou, par exemple, d'autres personnes qui commencent à la voir envoient immédiatement des requêtes pour cette photo. Elle n'est pas encore en cache, la première requête se produit très rapidement. En fait, c'est la même chose qu'avec le cache photo. Le stockage lent n'est pas du tout impliqué. Et quand elle sera purgée après un jour, elle sera soit déjà mise en cache sur notre couche de mise en cache, soit elle n'est probablement plus nécessaire. C'est-à-dire que l'expérience utilisateur ici s'est considérablement améliorée grâce à ces simples manipulations.
Eh bien, et surtout : nous avons cessé de perdre des données.
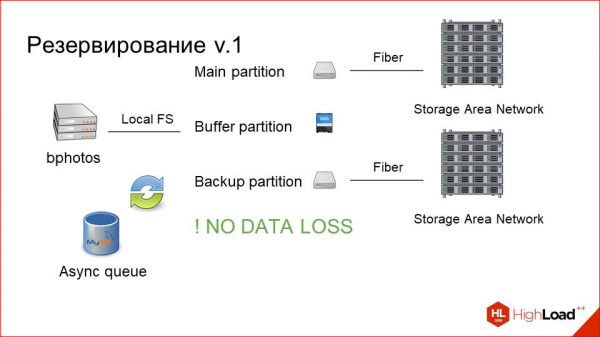
Disons simplement que nous avons cessé potentiellement perdre des données, car nous ne les avons pas vraiment perdues. Mais le risque était là. Nous voyons que cette solution, bien qu'elle soit évidente, ressemble un peu à un simple apaisement des symptômes du problème, au lieu de le résoudre complètement. Et il reste encore certains problèmes ici.
Tout d'abord, il y a le point de défaillance du serveur physique sur lequel tout ce matériel fonctionne, il n'a pas disparu.
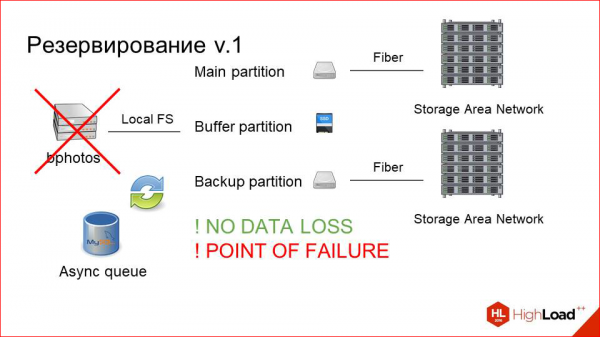
Deuxièmement, il y a encore des problèmes avec les SAN, leur maintenance lourde, etc. Ce n'était pas un facteur critique, mais nous voulions essayer de vivre sans cela.
Et nous avons fait une troisième version (en réalité, c'est la deuxième version) — une version de sauvegarde. À quoi cela ressemblait-il ?
C'est ce qui était -
Nos principaux problèmes viennent du fait que c'est un hôte physique.
Tout d'abord, nous éliminons les SAN, car nous voulons expérimenter, essayer simplement avec des disques durs locaux.
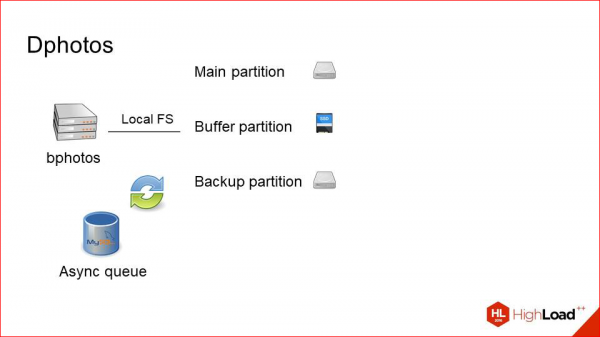
C'est déjà en 2014-2015, et à ce moment-là, la situation avec les disques et leur capacité dans un hôte est devenue bien meilleure. Nous avons décidé, pourquoi ne pas essayer.
Ensuite, nous prenons simplement notre partition de sauvegarde et la transférons physiquement sur une machine distincte.
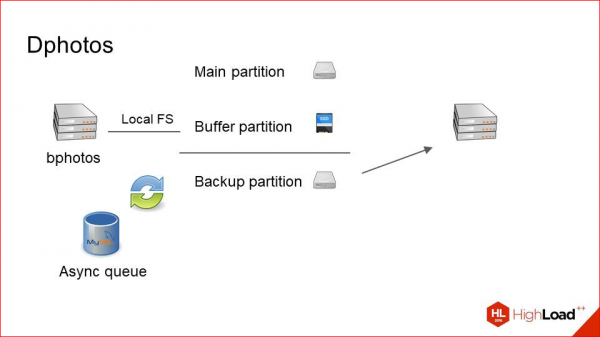
Ainsi, nous obtenons ce schéma. Nous avons deux machines qui stockent les mêmes ensembles de données. Elles se sauvegardent complètement mutuellement et synchronisent les données via un réseau à travers une file d'attente asynchrone dans le même MySQL.
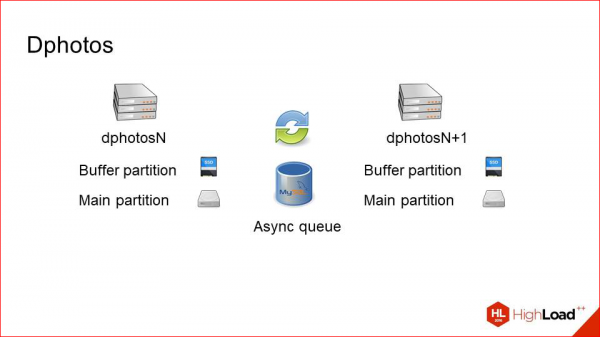
Pourquoi cela fonctionne bien — parce que nous avons peu d'écritures. Autrement dit, si l'écriture était équivalente à la lecture, nous aurions probablement rencontré une certaine surcharge réseau et des problèmes. Peu d'écritures, beaucoup de lectures — cette méthode fonctionne bien, c'est-à-dire que nous copions assez rarement des photos entre ces deux serveurs.
Comment cela fonctionne, si nous regardons un peu plus en détail.
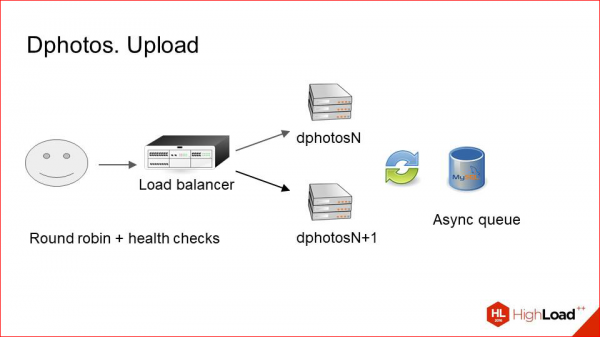
Upload. L'équilibreur de charge choisit simplement des hôtes aléatoires avec une paire et effectue un téléchargement sur celui-ci. En même temps, il fait naturellement des vérifications de santé, s'assurant que la machine ne tombe pas. C'est-à-dire qu'il télécharge des photos uniquement sur un serveur actif, puis via une file d'attente asynchrone, tout cela est copié chez son voisin. Le téléchargement est très simple.
La tâche est un peu plus complexe.
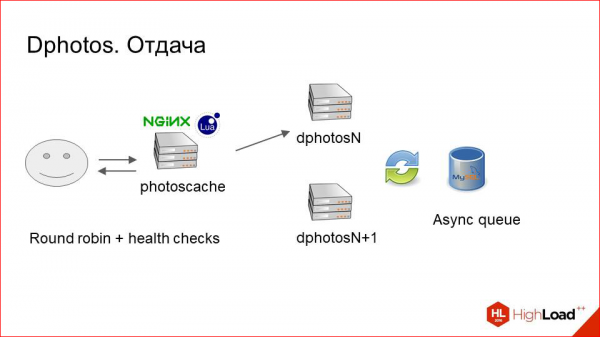
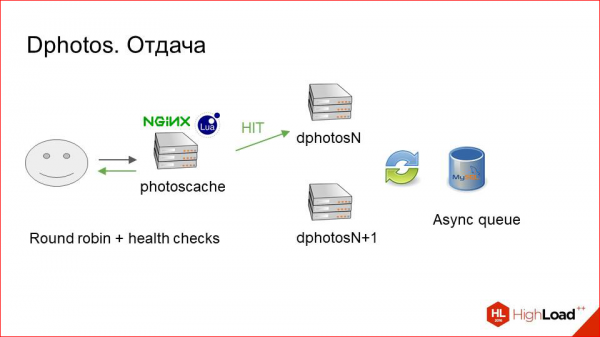
Ici, Lua nous a aidés, car il est parfois difficile de mettre en place une telle logique avec NGINX en version vanilla. Nous envoyons d'abord une requête au premier serveur pour voir s'il y a une photo là-bas, car elle peut potentiellement avoir été uploadée, par exemple, chez un voisin, et ne pas être encore arrivée ici. Si la photo est là, c'est bon. Nous la transmettons immédiatement au client et, peut-être, nous la mettons en cache.
S'il n'y en a pas, nous faisons simplement une requête au voisin et nous l'obtenons là-bas de manière garantie.
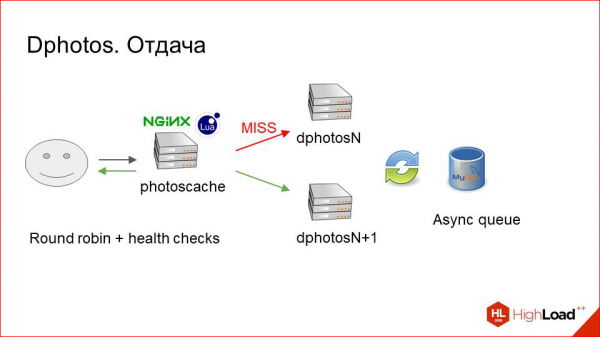
Ainsi, on peut de nouveau dire : il peut y avoir des problèmes de performance, car les allers-retours constants — la photo a été uploadée, elle n'est pas ici, nous faisons deux requêtes au lieu d'une, cela devrait fonctionner lentement.
Dans notre situation, cela ne fonctionne pas lentement.
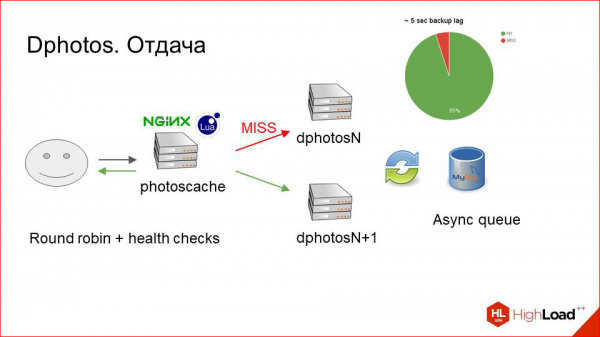
Nous collectons une tonne de métriques sur ce système, et le taux de réussite conditionnel de ce mécanisme est d'environ 95 %. Autrement dit, le temps d'attente de cette sauvegarde est minime, et grâce à cela, nous récupérons pratiquement toujours la photo dès la première demande et nous ne faisons pas deux fois le trajet.
Ainsi, qu'avons-nous encore obtenu, et c'est très intéressant ?
Auparavant, nous avions une principale partition de sauvegarde, et nous lisions à partir de celle-ci de manière séquentielle. Autrement dit, nous cherchions toujours d'abord sur le principal, puis sur la sauvegarde. C'était un seul passage.
Maintenant, nous utilisons la lecture de deux machines à la fois. Nous répartissons les demandes en Round Robin. Dans un petit pourcentage de cas, nous faisons deux demandes. Mais au total, nous avons maintenant deux fois plus de capacité de lecture que nous avions auparavant. Et la charge a considérablement diminué, tant sur les machines de livraison que sur les stockages qui étaient aussi disponibles à ce moment-là.
En ce qui concerne la tolérance aux pannes. C'est ce pour quoi nous nous sommes principalement battus. La tolérance aux pannes ici a très bien fonctionné.
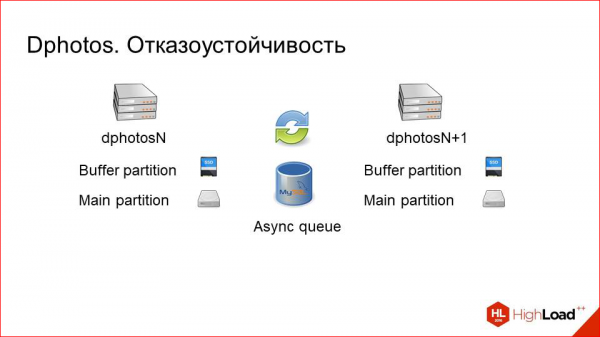
Une machine tombe en panne.
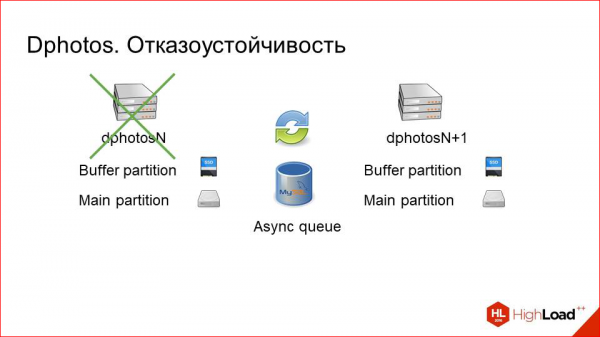
Pas de problème ! L'ingénieur système peut même ne pas se réveiller la nuit, il peut attendre le matin, il n'y aura rien de grave.
Même si, lors de la panne de cette machine, la file d'attente s'est arrêtée, ce n'est pas non plus un problème – le journal sera d'abord accumulé sur la machine fonctionnelle, puis il ira dans la file d'attente, pour enfin être traité par la machine qui redémarrera après un certain temps.
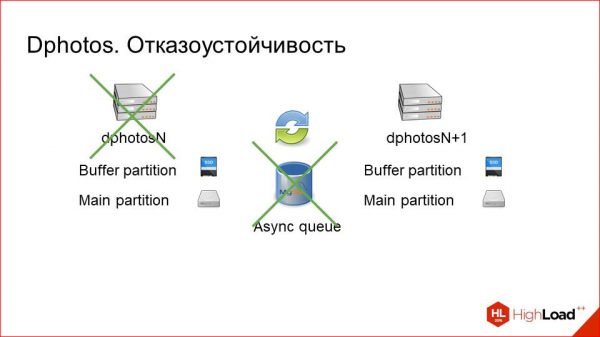
Il en va de même pour la maintenance. Nous éteignons simplement une des machines, la retirons manuellement de tous les pools, elle ne reçoit plus de trafic, nous effectuons une sorte de maintenance, nous apportons des modifications, puis nous la remettons en service et cette sauvegarde se rattrape assez rapidement. En d'autres termes, le temps d'arrêt d'une machine est compensé en quelques minutes au maximum sur une journée. C'est vraiment très peu. Concernant la résilience, je le répète, tout fonctionne très bien ici.
Quels peuvent être les conclusions tirées de ce schéma de redondance ?
Nous avons obtenu la résilience.
Exploitation simplifiée. Étant donné que les machines ont des disques durs locaux, cela est beaucoup plus pratique du point de vue des ingénieurs qui travaillent avec ça.
Nous avons obtenu une double capacité de lecture.
C'est un très bon bonus en plus de la résilience.
Mais il y a aussi des problèmes. Maintenant, le développement de certaines fonctionnalités liées à cela est beaucoup plus complexe, car le système est devenu 100 % éventuellement cohérent.
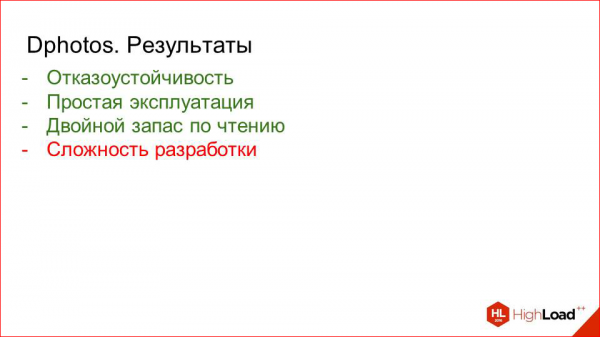
Nous devons, par exemple, dans un job d'arrière-plan, constamment penser : « Sur quel serveur sommes-nous actuellement ? », « Y a-t-il vraiment ici une photo à jour ? », etc. Cela, bien sûr, est enveloppé dans des abstractions et pour le développeur qui écrit la logique métier, c'est transparent. Néanmoins, cela a ajouté une couche complexe. Mais nous sommes prêts à vivre avec cela en échange des avantages que nous en avons tirés.
Et ici encore, un certain conflit apparaît.
J'ai d'abord dit qu'il était mauvais de tout stocker sur des disques durs locaux. Et maintenant je dis que nous avons aimé cela.
Oui, au fil du temps, la situation a beaucoup changé et maintenant cette approche a de nombreux avantages. D'une part, nous avons une exploitation beaucoup plus simple.
D'autre part, c'est plus performant, car nous n'avons pas ces contrôleurs automatiques, les connexions aux baies de disques.
Il y a une énorme machinerie là-bas, alors que ce ne sont que quelques disques qui sont spécifiquement assemblés ici en RAID.
Mais il y a aussi des inconvénients.
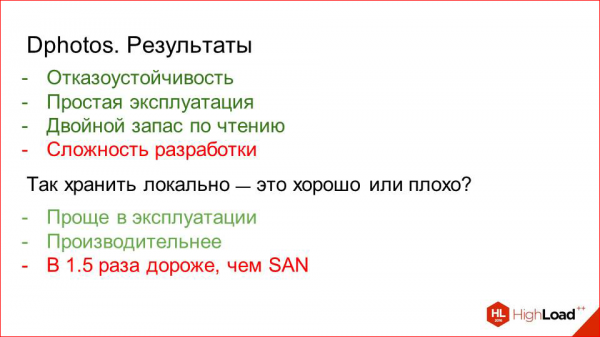
C'est environ 1,5 fois plus cher que d'utiliser des SAN même avec les prix d'aujourd'hui. C'est pourquoi nous n'avons pas décidé de convertir notre grand cluster en machines avec des disques durs locaux et avons décidé de garder une solution hybride.
La moitié de nos machines fonctionne avec des disques durs (en fait, pas tout à fait la moitié – peut-être 30 %). L'autre partie est constituée de vieux appareils qui étaient auparavant utilisés pour le premier schéma de sauvegarde. Nous les avons simplement remontés, car nous n'avons besoin ni de nouvelles données ni de quoi que ce soit d'autre, nous avons juste déplacé les montages d'un hôte physique à deux.
Nous avons donc une grande capacité de lecture, et nous avons agrandi nos ressources. Auparavant, nous montions un seul stockage par machine, maintenant nous en montons quatre par paire, par exemple. Et cela fonctionne très bien.
Faisons un bref résumé de ce que nous avons obtenu, de nos objectifs, et si nous avons réussi.
Résultats
Nous avons des utilisateurs – pas moins de 33 millions.
Nous avons trois points de présence – Prague, Miami, Hong Kong.
Ils contiennent un niveau de cache, constitué de machines avec des disques locaux rapides (SSD), sur lequel fonctionne une architecture simple avec NGINX, son access.log et des démons Python qui gèrent tout cela et gèrent le cache.
Si vous le souhaitez, dans votre projet, si les photos ne sont pas aussi critiques pour vous que pour nous, ou si le compromis entre le contrôle et la vitesse de développement de vos ressources penche dans l'autre sens, alors vous pouvez facilement le remplacer par un CDN, les CDN modernes le font très bien.
Ensuite, il y a le niveau de stockage, où nous avons des clusters de paires de machines qui se sauvegardent mutuellement, copiant des fichiers de l'un à l'autre de manière asynchrone à chaque modification.
Certaines de ces machines fonctionnent avec des disques durs locaux.
D'autres machines sont connectées à des SAN.
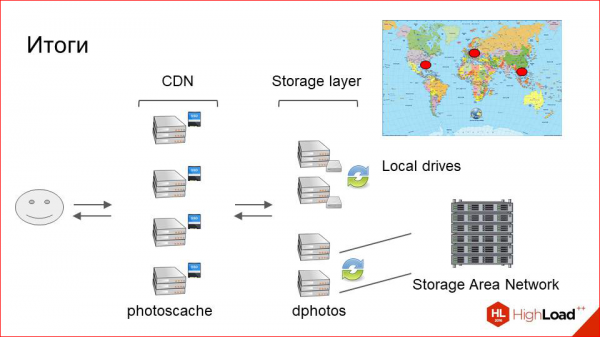
D'une part, c'est plus pratique en termes d'exploitation et légèrement plus performant, d'autre part, c'est avantageux en termes de densité de placement et de coût par gigaoctet.
C'est un aperçu rapide de l'architecture que nous avons obtenue et de son évolution.
Encore quelques conseils du chef, très simples.
Tout d'abord, si vous décidez soudainement que vous devez absolument améliorer votre infrastructure de photos, commencez par mesurer, car il se peut que rien ne doive être amélioré.
Je vais donner un exemple. Nous avons un cluster de machines qui délivre des photos depuis des pièces jointes dans des discussions, et le schéma fonctionne toujours comme en 2009, et personne ne souffre de cela. Tout le monde est content, tout le monde aime ça.
Pour commencer, définissez un ensemble de métriques, examinez-les puis décidez ce qui vous déplaît et ce qui doit être amélioré. Pour mesurer cela, nous avons un excellent outil appelé Pinba.
Il permet de collecter des statistiques détaillées depuis NGINX pour chaque requête, y compris les codes de réponse et la répartition des temps — tout ce dont vous avez besoin. Il dispose de liaisons avec divers systèmes d'analyse et vous pouvez visualiser toutes ces données de manière claire.
D'abord nous mesurons — ensuite nous améliorons.
Ensuite. Nous optimisons la lecture avec un cache, et l'écriture avec du sharding, mais c'est un point évident.
Par ailleurs, si vous commencez à construire votre système, il est bien préférable de traiter les photographies comme des fichiers immuables. Cela élimine immédiatement toute une série de problèmes liés à l'invalidation du cache, à la manière dont la logique doit retrouver la bonne version de la photographie, etc.
Supposons que vous ayez téléchargé une centaine de fichiers, puis que vous les ayez retournés, faites en sorte qu'il s'agisse d'un fichier physiquement différent. C'est-à-dire qu'il ne faut pas penser : 'Je vais économiser un peu d'espace en réécrivant dans le même fichier, en changeant la version.' Cela ne fonctionne généralement pas bien et engendre beaucoup de maux de tête par la suite.
Le point suivant. Concernant le redimensionnement à la volée.
Auparavant, lorsque les utilisateurs téléchargeaient une photo, nous générions d'emblée de nombreux formats pour tous les cas de figure, pour différents clients, qui étaient tous stockés sur le disque. Nous avons maintenant abandonné ça.
Nous avons seulement conservé trois tailles principales : petite, moyenne et grande. Tout le reste est simplement diminué à partir de la taille derrière celle demandée dans Uport, nous faisons juste un redimensionnement et remettons le tout à l’utilisateur.
Le coût des CPU pour la couche de cache est bien plus bas que si nous régénérions constamment ces tailles sur chaque stockage. Supposons que nous voulions en ajouter un nouveau, cela prendrait un mois — exécuter un script partout pour gérer cela soigneusement sans faire tomber le cluster. Donc, s'il est possible de choisir, il vaut mieux faire le moins de tailles physiques possible, tout en ayant un certain degré de répartition, disons trois. Et tout le reste peut simplement être redimensionné à la volée à l'aide de modules prêts à l'emploi. C'est très facile et accessible aujourd'hui.
Et une sauvegarde incrémentale asynchrone, c'est une bonne chose.
Comme le montre notre expérience, ce type de schéma fonctionne très bien avec la sauvegarde différée des fichiers modifiés.
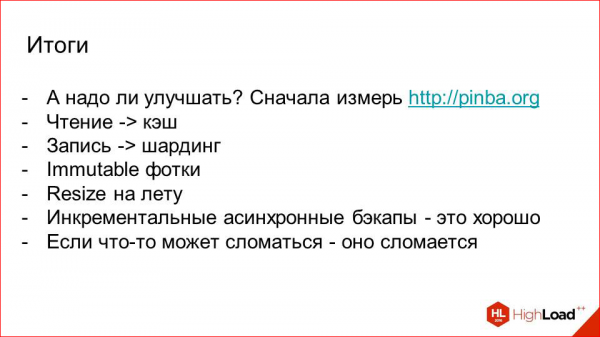
Le dernier point est également évident. Si votre infrastructure ne présente pas de problèmes pour le moment, mais qu'il y a quelque chose qui pourrait tomber en panne, cela se produira nécessairement lorsque la charge augmentera légèrement. Il est donc préférable d'y réfléchir à l'avance et d'éviter de rencontrer des difficultés. C'est tout pour moi.
Contacts
»
»
Ce rapport est la transcription d'une des meilleures présentations lors de la conférence des développeurs de systèmes à forte charge . Il reste moins d'un mois avant la conférence HighLoad++ 2017.
Nous avons déjà préparé , le programme est actuellement en cours d'élaboration.
Cette année, nous continuons à explorer le thème des architectures et de la mise à l'échelle :
- / Игорь Васильев
- / Дмитрий Егоров
- / Анатолий Пласковский
- / Роман Шеховцов, Алексей Громатчиков
- / Филипп Дельгядо
Certains de ces matériaux sont également utilisés dans notre cours en ligne sur le développement de systèmes à forte charge — c'est une série de lettres, articles, ressources et vidéos soigneusement sélectionnées. Notre manuel contient déjà plus de 30 matériaux uniques. Rejoignez-nous !
Source : habr.com
