

Comment traduire les exigences commerciales en structures de données concrètes, en prenant comme exemple la conception d'une base de données « de zéro » pour un messager.
- Partie 1 : conception du cadre de la base
Notre base ne sera pas aussi vaste et répartie que celle de ou , mais « juste ce qu'il faut » pour être efficace, rapide et tenable sur un seul serveur. PostgreSQL — afin de pouvoir déployer une instance séparée du service quelque part, par exemple.
C'est pourquoi nous ne traiterons pas des questions de sharding, de réplication et de systèmes géo-distribués, mais nous concentrerons sur des solutions schématiques à l'intérieur de la base de données.
Étape 1 : Un peu de spécificités commerciales
Nous allons concevoir notre système de messagerie non pas de manière abstraite, mais en l'intégrant à l'environnement Autrement dit, les gens ne « se contentent pas de discuter », mais interagissent dans le contexte de la résolution de certaines problématiques commerciales.
Quelles sont les besoins d'une entreprise ?... Prenons l'exemple de Vasily, le responsable du département de développement.
- « Nikolai, il faut déjà un patch pour cette tâche aujourd'hui ! »
Cela signifie que la conversation peut se dérouler dans le contexte de quelque chose document. - « Kolya, on se fait une partie de Dota ce soir ? »
Ainsi, même pour une seule paire de correspondants, la communication peut se faire simultanément sur différents sujets.. - « Petr, Nikolai, regardez dans le fichier joint le prix pour le nouveau serveur. »
Ainsi, un message peut avoir plusieurs destinataires.De plus, un message peut contenir des fichiers joints.. - « Semyon, toi aussi, jette un œil. »
Et il doit être possible d'inviter un nouveau participant à une conversation qui existe déjà..
Restons ici sur cette liste de besoins « évidents ».
Sans une compréhension des spécificités pratiques de la tâche et des contraintes qu'elle impose, il est pratiquement impossible de concevoir un schéma de base de données efficace pour sa résolution.
Étape 2 : Schéma logique minimal
Pour l'instant, le schéma ressemble beaucoup à une correspondance par email — un outil traditionnel pour mener des affaires. En effet, « algorithmique », de nombreuses tâches commerciales se ressemblent, donc les outils pour les résoudre seront structurés de manière similaire.
Fixons maintenant le schéma logique des relations des entités déjà obtenu. Pour simplifier la compréhension de notre modèle, utilisons la variante la plus primitive d'affichage sans complicer avec des notations UML ou IDEF :
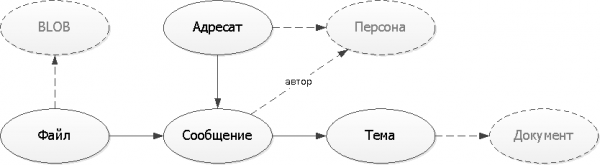
Dans notre exemple, la personne, le document et le corps binaire du fichier sont des entités "externes" qui existent de manière autonome, même sans notre service. Nous allons donc les considérer ultérieurement comme des liens "vers quelque part" par UUID.
Dessinez des diagrammes aussi simplement que possible — la plupart des gens à qui vous les montrerez ne sont pas des experts en lecture UML/IDEF. Mais, dessinez-les sans faute.
Étape 3 : Projeter la structure des tables
Concernant les noms de tables et de champsOn peut avoir des opinions différentes sur les noms de champs et de tables « russes », mais c'est une question de goût. Étant donné que n'avons pas de développeurs étrangers, et PostgreSQL nous permet de donner des noms même en idéogrammes, à condition qu'ils soient entourés de guillemets, nous préférons nommer les objets de manière claire et explicite, pour éviter les ambiguïtés.
Étant donné que de nombreuses personnes écrivent des messages simultanément, certaines d'entre elles peuvent le faire en mode hors ligne, la solution la plus simple est de utiliser des UUID comme identifiants non seulement pour les entités externes, mais aussi pour tous les objets dans notre service. En fait, ils peuvent même être générés du côté client — cela nous aidera à maintenir l'envoi de messages lors d'une brève indisponibilité de la base de données, et la probabilité de collision est extrêmement faible.
La structure de base des tables dans notre base de données ressemblera à ceci :
Tables : RU
CREATE TABLE "Thème"(
  "Thème"
    uuid
      PRIMARY KEY
, "Document"
    uuid
, "Titre"
    text
);

CREATE TABLE "Message"(
  "Message"
    uuid
      PRIMARY KEY
, "Thème"
    uuid
, "Auteur"
    uuid
, "DateHeure"
    timestamp
, "Texte"
    text
);

CREATE TABLE "Destinataire"(
  "Message"
    uuid
, "Personne"
    uuid
, PRIMARY KEY("Message", "Personne")
);

CREATE TABLE "Fichier"(
  "Fichier"
    uuid
      PRIMARY KEY
, "Message"
    uuid
, "BLOB"
    uuid
, "Nom"
    text
);
Tables : EN
CREATE TABLE theme(
  theme
    uuid
      PRIMARY KEY
, document
    uuid
, title
    text
);

CREATE TABLE message(
  message
    uuid
      PRIMARY KEY
, theme
    uuid
, author
    uuid
, dt
    timestamp
, body
    text
);

CREATE TABLE message_addressee(
  message
    uuid
, person
    uuid
, PRIMARY KEY(message, person)
);

CREATE TABLE message_file(
  file
    uuid
      PRIMARY KEY
, message
    uuid
, content
    uuid
, filename
    text
);
La chose la plus simple à faire en décrivant le format est de commencer par "développer" le graphique des relations à partir des tables qui ne référencent pas elles-mêmes qui que ce soit.
Étape 4 : Déterminer les besoins non évidents
Voilà, nous avons conçu une base dans laquelle il est possible d'écrire parfaitement et de quelque manière que ce soit de lire.
Mettons-nous à la place de l'utilisateur de notre service : que souhaitons-nous réaliser avec son aide ?
- Messages récents
C'est un registre « de mes » messages triés par ordre chronologique selon divers critères. Où je suis l'un des destinataires, où je suis l'auteur, où on m'a écrit et je n'ai pas répondu, où je n'ai pas reçu de réponse, ... - Participants à la conversation
Qui participe à cette longue conversation ?
Notre structure permet de résoudre ces deux problèmes « en général », mais rapidement - non. Le problème est qu'il est impossible de créer un index qui convienne à chaque participant (et il faudra extraire tous les enregistrements), et pour résoudre le second, il fautextraire tous les messages sur le sujet. Des tâches utilisateur non prévues peuvent mettre un coup dur à la performance.
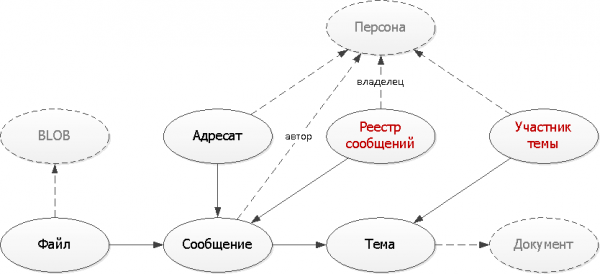
Étape 5 : Une dénormalisation raisonnée Nos deux problèmes pourront être résolus par des tables supplémentaires dans lesquelles nous allons.
dupliquer une partie des données
, nécessaires pour former des index adaptés à nos tâches. CREATE TABLE "MessageRegistry"( "Owner" uuid , "RegistryType" smallint , "DateTime" timestamp , "Message" uuid , PRIMARY KEY("Owner", "RegistryType", "Message") ); CREATE INDEX ON "MessageRegistry"("Owner", "RegistryType", "DateTime" DESC);CREATE TABLE "ThemeParticipant"( "Theme" uuid , "Person" uuid , PRIMARY KEY("Theme", "Person") );CREATE TABLE message_registry( owner uuid , registry smallint , dt timestamp , message uuid , PRIMARY KEY(owner, registry, message) ); CREATE INDEX ON message_registry(owner, registry, dt DESC);CREATE TABLE theme_participant( theme uuid , person uuid , PRIMARY KEY(theme, person) );
Tables : RU
Ici, nous avons appliqué deux approches typiques lors de la création de tables auxiliaires :Tables : EN
La multiplication des enregistrementsNous formons plusieurs enregistrements conséquences pour chaque enregistrement source de message dans différents types de registres pour différents propriétaires - tant pour l'expéditeur que pour le destinataire. Ainsi, chaque registre est maintenant mis à l'index - car dans la plupart des cas, nous voudrons voir seulement la première page.
- La création d'enregistrements uniques
Lors de l'envoi d'un message dans un thème spécifique, il suffit de vérifier si un tel enregistrement existe déjà. Si ce n'est pas le cas - nous l'ajoutons à notre « dictionnaire ». - La prochaine partie de l'article parlera de
l'implémentation du partitionnement
dans la structure de notre base de données. 🥇BD du messager (partie 1) : concevoir la structure de la base | ProHoster
Source : habr.com
