

Bonjour ! Je m'appelle Danil Lipovoy, notre équipe chez Sbertech a commencé à utiliser HBase comme stockage de données opérationnelles. Au cours de son étude, nous avons accumulé de l'expérience que nous souhaitions systématiser et décrire (nous espérons que cela sera utile à beaucoup). Toutes les expériences ci-dessous ont été réalisées avec les versions HBase 1.2.0-cdh5.14.2 et 2.0.0-cdh6.0.0-beta1.
- Architecture générale
- Écriture de données dans HBASE
- Lecture de données depuis HBASE
- Mise en cache des données
- Traitement par lots des données MultiGet / MultiPut
- Stratégie de partitionnement des tables en régions (sharding)
- Tolérance aux pannes, compactage et localité des données
- Configurations et performances
- Test de charge
- Conclusions
1. Architecture générale
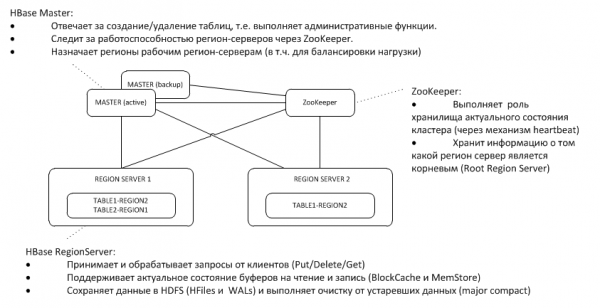
Un Master de secours écoute le heartbeat du maître actif sur le nœud ZooKeeper et, en cas de disparition, prend les fonctions du maître.
2. Écriture de données dans HBASE
Commençons par le cas le plus simple : écrire un objet clé-valeur dans une table à l'aide de put(rowkey). Le client doit d'abord déterminer où se trouve le serveur de région racine (Root Region Server - RRS) qui stocke la table hbase:meta. Cette information est obtenue auprès de ZooKeeper. Ensuite, il s'adresse au RRS et lit la table hbase:meta, d'où il extrait l'information sur le RegionServer (RS) responsable du stockage des données selon la clé rowkey donnée dans la table qui l'intéresse. Pour une utilisation ultérieure, la méta-table est mise en cache par le client et donc les accès suivants se font plus rapidement, directement auprès du RS.
Ensuite, le RS, ayant reçu la requête, écrit d'abord celle-ci dans le WriteAheadLog (WAL), ce qui est nécessaire pour la récupération en cas de panne. Il enregistre ensuite les données dans le MemStore. C'est un tampon en mémoire qui contient un ensemble de clés triées de cette région. La table peut être divisée en régions (partitions), chacune d'elles contenant un ensemble de clés disjointes. Cela permet, en plaçant les régions sur différents serveurs, d'obtenir des performances plus élevées. Cependant, malgré l'évidence de cette affirmation, nous verrons par la suite que cela ne fonctionne pas dans tous les cas.
Après avoir placé l'enregistrement dans le MemStore, le client reçoit une réponse indiquant que l'enregistrement a été enregistré avec succès. En réalité, il est uniquement stocké dans le tampon et ne sera écrit sur le disque qu'après un certain intervalle de temps ou lorsque celui-ci sera rempli de nouvelles données.
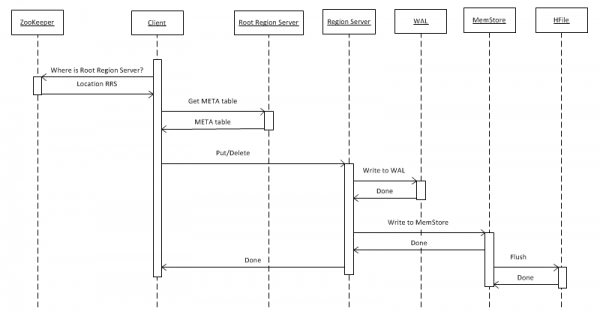
Lors de l'opération «Delete», il n'y a pas de suppression physique des données. Elles sont simplement marquées comme supprimées, et la destruction effective se produit lors de l'appel à la fonction major compact, dont les détails sont donnés au point 7.
Les fichiers au format HFile s'accumulent dans HDFS et de temps en temps, un processus de minor compact est lancé, qui fusionne simplement les petits fichiers en de plus gros, sans rien supprimer. Au fil du temps, cela devient un problème qui se manifeste uniquement lors de la lecture des données (nous y reviendrons un peu plus tard).
En plus du processus de chargement décrit ci-dessus, il existe une procédure beaucoup plus efficace, qui constitue sans doute le principal atout de cette base de données – BulkLoad. Elle consiste à former nous-mêmes des HFiles et à les déposer sur le disque, ce qui permet un excellent passage à l'échelle et d'atteindre des vitesses très satisfaisantes. En fait, la limite ici n'est pas HBase, mais les capacités matérielles. Ci-dessous, vous trouverez les résultats de chargement sur un cluster composé de 16 RegionServers et de 16 NodeManagers YARN (CPU Xeon E5-2680 v4 @ 2,40 GHz * 64 threads), version HBase 1.2.0-cdh5.14.2.
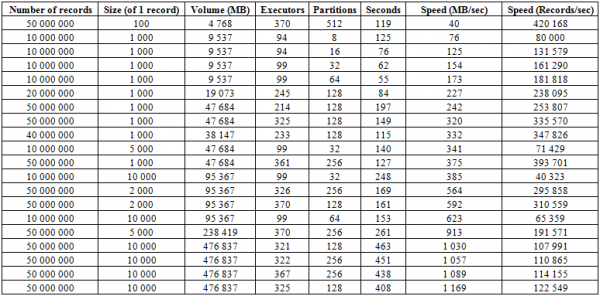
Ici, on constate qu'en augmentant le nombre de partitions (régions) dans la table, ainsi que le nombre d'exécuteurs Spark, on obtient une augmentation de la vitesse de chargement. La vitesse dépend également du volume d'écriture. Les gros blocs donnent un gain en termes de Mo/s, tandis que les petits blocs augmentent le nombre d'enregistrements insérés par unité de temps, toutes choses égales par ailleurs.
Il est également possible de lancer le chargement dans deux tables simultanément et de doubler la vitesse. Ci-dessous, on peut voir que l'écriture de blocs de 10 Ko dans deux tables se fait à une vitesse d'environ 600 Mo/s chacune (soit un total de 1275 Mo/s), ce qui correspond à la vitesse d'écriture dans une seule table de 623 Mo/s (voir n°11 ci-dessus).
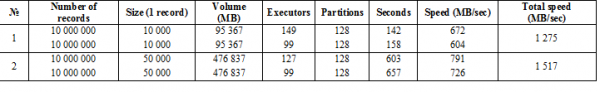
Lors du second lancement avec des écritures de 50 Ko, on constate que la vitesse de chargement n'augmente plus de manière significative, ce qui indique que l'on approche des valeurs limites. Il convient également de noter qu'il n'y a pratiquement pas de charge sur HBASE ici, tout ce qui est requis de lui est d'abord de renvoyer les données de hbase:meta, puis après le dépôt des HFiles, de vider les données du BlockCache et de sauvegarder le buffer MemStore sur le disque, s'il n'est pas vide.
3. Lecture des données depuis HBASE
Si l'on considère que toutes les informations de hbase:meta sont déjà disponibles pour le client (voir point 2), la requête est envoyée immédiatement au RS où la clé désirée est stockée. Tout d'abord, la recherche s'effectue dans MemCache. Que des données y soient présentes ou non, la recherche s'effectue également dans le tampon BlockCache et, si nécessaire, dans HFiles. Si des données sont trouvées dans le fichier, elles sont placées dans BlockCache et seront retournées plus rapidement lors de la prochaine requête. La recherche dans HFile se fait relativement rapidement grâce à l'utilisation du filtre de Bloom, c'est-à-dire qu'en lisant un petit volume de données, il détermine immédiatement si ce fichier contient la clé recherchée, et si ce n'est pas le cas, il passe au suivant.
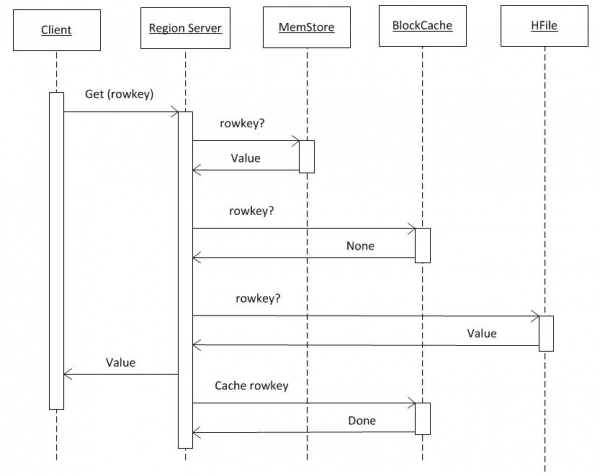
Après avoir obtenu des données de ces trois sources, le RS forme une réponse. En particulier, il peut transmettre plusieurs versions trouvées d'un objet si le client a demandé la gestion des versions.
4. Mise en cache des données
Les tampons MemStore et BlockCache occupent jusqu'à 80 % de la mémoire on-heap allouée au RS (le reste étant réservé aux tâches de service du RS). Si le mode d'utilisation typique est tel que les processus écrivent et lisent immédiatement ces mêmes données, il est judicieux de réduire BlockCache et d'augmenter MemStore, puisque lors de l'écriture, les données ne sont pas mises en cache pour la lecture, rendant l'utilisation de BlockCache moins fréquente. Le tampon BlockCache se compose de deux parties : LruBlockCache (toujours on-heap) et BucketCache (généralement off-heap ou sur SSD). BucketCache doit être utilisé lorsque les requêtes de lecture sont très nombreuses et qu'elles ne tiennent pas dans LruBlockCache, ce qui conduit à un travail actif du Garbage Collector. Cependant, il ne faut pas attendre une augmentation radicale des performances grâce à l'utilisation du cache de lecture, mais cela sera discuté plus en détail au point 8.
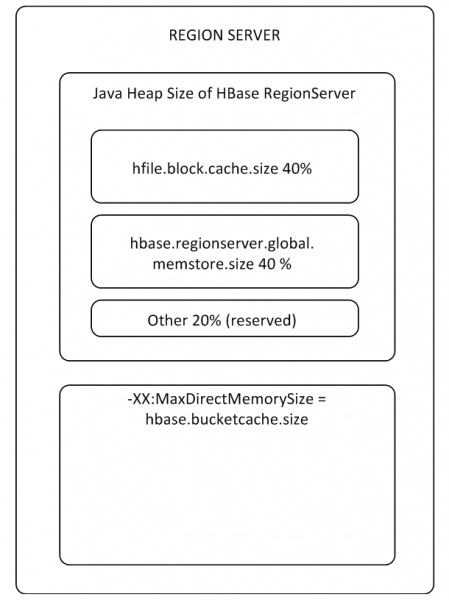
BlockCache est unique pour tout le RS, tandis que MemStore est spécifique à chaque table (un par Column Family).
Comment En théorie, lors de l'écriture, les données ne vont pas dans le cache et en effet, les paramètres CACHE_DATA_ON_WRITE pour la table et « Cache DATA on Write » pour le RS sont définis sur false. Cependant, en pratique, si l'on écrit des données dans MemStore, puis que l'on les vide sur disque (effaçant ainsi ce qu'il y a), puis que l'on supprime le fichier résultant, en effectuant la requête get, nous obtenons avec succès les données. Même si l'on désactive complètement BlockCache et que l'on remplit la table avec de nouvelles données, ensuite pour provoquer la vidange de MemStore sur disque, les supprimer et les requérir d'une autre session, elles seront quand même extraites de quelque part. Ainsi, HBase conserve non seulement des données, mais aussi des mystères mystérieux.
hbase(main):001:0> create 'ns:magic', 'cf'
Table ns:magic créée
Temps d'exécution 1.1533 secondes
hbase(main):002:0> put 'ns:magic', 'key1', 'cf:c', 'try_to_delete_me'
Temps d'exécution 0.2610 secondes
hbase(main):003:0> flush 'ns:magic'
Temps d'exécution 0.6161 secondes
hdfs dfs -mv /data/hbase/data/ns/magic/* /tmp/trash
hbase(main):002:0> get 'ns:magic', 'key1'
 cf:c      timestamp=1534440690218, value=try_to_delete_me
Le paramètre « Cache DATA on Read » est défini sur false. Si vous avez des idées, n'hésitez pas à en discuter dans les commentaires.
5. Traitement par lots de données MultiGet/MultiPut
Le traitement des requêtes individuelles (Get/Put/Delete) est une opération assez coûteuse, il est donc recommandé de les regrouper autant que possible dans une liste, ce qui permet d'obtenir un gain de performance significatif. Cela est particulièrement vrai pour les opérations d'écriture, tandis qu'il existe un inconvénient lors de la lecture. Le graphique ci-dessous montre le temps de lecture de 50 000 enregistrements depuis MemStore. La lecture a été effectuée en un seul thread et l'axe horizontal montre le nombre de clés dans la requête. Nous pouvons voir qu'en augmentant jusqu'à mille clés dans une requête, le temps d'exécution diminue, c'est-à-dire que la vitesse augmente. Cependant, en mode MSLAB par défaut, après ce seuil, il y a une chute radicale des performances, et plus le volume de données dans l'enregistrement est important, plus le temps d'exécution augmente.
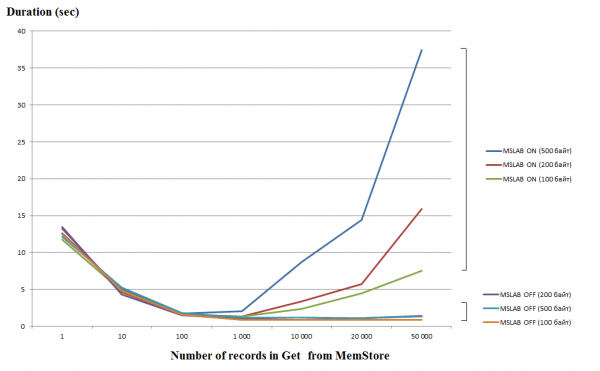
Les tests ont été réalisés sur une machine virtuelle, 8 cœurs, version HBase 2.0.0-cdh6.0.0-beta1.
Le mode MSLAB vise à réduire la fragmentation du tas, qui se produit à cause du mélange des données de générations nouvelles et anciennes. Comme solution à ce problème, lorsque MSLAB est activé, les données sont placées dans des cellules relativement petites (chunks) et traitées par lots. En conséquence, lorsque le volume du paquet de données demandé dépasse la taille allouée, les performances chutent rapidement. D'autre part, la désactivation de ce mode n'est pas souhaitable non plus, car cela entraînera des pauses dues au GC lors de moments de travail intensif avec les données. Une bonne solution consiste à augmenter les volumes des cellules, en cas d'écriture active par put en même temps que la lecture. Il convient de noter que le problème ne se pose pas si, après l'écriture, nous exécutons la commande flush qui pousse MemStore sur le disque ou si un chargement est effectué par BulkLoad. Le tableau ci-dessous montre que les requêtes provenant de MemStore de volumes de données plus importants (et d'un nombre identique) entraînent un ralentissement. Cependant, en augmentant la taille des chunks, nous ramenons le temps de traitement à la normale.
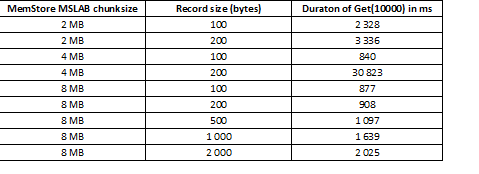
En plus d'augmenter le chunksize, le partitionnement des données par régions, c'est-à-dire le splitting des tables, aide. Cela signifie qu'un nombre réduit de requêtes est envoyé à chaque région, et si elles sont toutes placées dans une cellule, la réponse reste bonne.
6. Stratégie de partitionnement des tables par régions (splitting)
Étant donné qu'HBase est un stockage clé-valeur et que le partitionnement s'effectue selon la clé, il est essentiel de répartir les données de manière uniforme sur toutes les régions. Par exemple, le partitionnement d'une telle table en trois parties aura pour résultat que les données seront réparties sur trois régions :
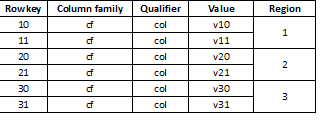
Il arrive que cela entraîne un ralentissement drastique si les données chargées par la suite se présentent sous la forme de valeurs long, majoritairement commençant par un même chiffre, par exemple :
1000001
1000002
…
1100003
Comme les clés sont stockées sous forme de tableau d'octets, toutes commenceront de la même manière et iront à la région #1 qui contient cette plage de clés. Il existe plusieurs stratégies de partitionnement :
HexStringSplit – Transforme la clé en une chaîne avec un encodage hexadécimal dans la plage «00000000» ⇒ «FFFFFFFF», en remplissant avec des zéros à gauche.
UniformSplit – Transforme la clé en un tableau d'octets avec un encodage hexadécimal dans la plage «00» ⇒ «FF», en remplissant avec des zéros à droite.
De plus, il est possible de spécifier n'importe quelle plage ou ensemble de clés pour le partitionnement et de configurer le splitting automatique. Cependant, l'une des approches les plus simples et efficaces est UniformSplit et l'utilisation de la concaténation de hachage, par exemple, la paire d'octets la plus significative provenant du passage de la clé par la fonction CRC32(rowkey) et la clé elle-même :
hash + rowkey
Ainsi, toutes les données seront réparties uniformément sur les régions. Lors de la lecture, les deux premiers octets sont simplement ignorés, et la clé d'origine reste. De plus, le RS contrôle le nombre de données et de clés dans une région et, si les limites sont dépassées, divise automatiquement celle-ci en parties.
7. Résilience et localité des données
Étant donné qu'un seul région est responsable de chaque ensemble de clés, la solution aux problèmes liés aux pannes de RS ou à la mise hors service consiste à stocker toutes les données nécessaires dans HDFS. En cas de panne de RS, le maître le détecte par l'absence de heartbeat sur le nœud ZooKeeper. Il assigne alors la région à un autre RS, et comme les HFiles sont stockés dans un système de fichiers distribué, le nouveau propriétaire les lit et continue à gérer les données. Cependant, comme certaines données peuvent être dans MemStore et n'ont pas encore été écrites dans HFiles, l'historique des opérations est restauré à l'aide de WAL, qui sont également stockés dans HDFS. Après l'application des modifications, le RS peut répondre aux requêtes, mais le transfert entraîne une séparation des données et des processus de gestion sur différents nœuds, ce qui diminue la locality.
La solution au problème est la compaction majeure – cette procédure déplace les fichiers vers les nœuds responsables (là où se trouvent leurs régions), ce qui entraîne une augmentation brutale de la charge sur le réseau et les disques durant cette procédure. Cependant, par la suite, l'accès aux données s'accélère considérablement. De plus, la major_compaction fusionne tous les HFiles en un seul fichier au sein de la région, et nettoie les données en fonction des paramètres de la table. Par exemple, il est possible de définir le nombre de versions d'objet à conserver ou la durée de vie après laquelle l'objet est physiquement supprimé.
Cette procédure peut avoir un impact très positif sur le fonctionnement d'HBase. L'image ci-dessous montre comment la performance a été dégradée en raison de l'écriture active de données. On voit ici 40 threads écrivant dans une table et 40 threads lisant des données simultanément. Les threads d'écriture génèrent de plus en plus de HFiles, qui sont ensuite lus par d'autres threads. En conséquence, de plus en plus de données doivent être supprimées de la mémoire, et finalement, le GC commence à s'exécuter, paralysant pratiquement tout le processus. Le lancement de la compaction majeure a permis de nettoyer les encombrements générés et de restaurer la performance.
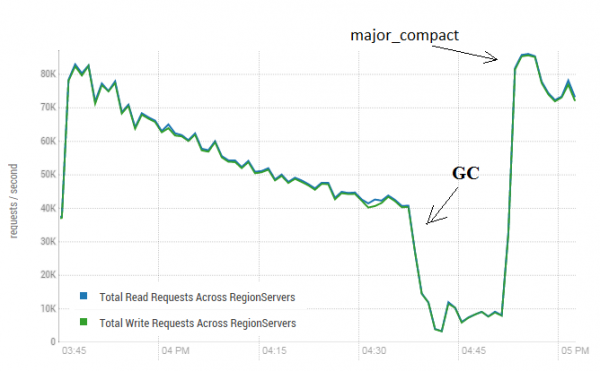
Le test a été réalisé sur 3 DataNodes et 4 RS (CPU Xeon E5-2680 v4 @ 2,40 GHz * 64 threads). Version HBase 1.2.0-cdh5.14.2
Il convient de noter que le lancement de la compaction majeure a été effectué sur une table "vivante", où des données étaient activement lues et écrites. Il a été avancé sur le réseau que cela pourrait entraîner une réponse incorrecte lors de la lecture des données. Un processus a été lancé pour générer de nouvelles données et les écrire dans la table. Ensuite, il lisait immédiatement et vérifiait si la valeur obtenue correspondait à celle qui avait été enregistrée. Pendant le fonctionnement de ce processus, la compaction majeure a été lancée environ 200 fois sans aucun échec enregistré. Il est possible que le problème se manifeste rarement et uniquement lors de charges élevées, il est donc préférable d'arrêter le processus d'écriture et de lecture de manière planifiée et d'effectuer l'entretien sans permettre de telles baisses du GC.
De plus, la compaction majeure n'affecte pas l'état du MemStore, pour le vider sur disque et le compacter, il faut utiliser flush (connection.getAdmin().flush(TableName.valueOf(tblName))).
8. Paramètres et performance
Comme mentionné précédemment, HBase montre le plus de succès là où il n'a rien à faire, lors de l'exécution du BulkLoad. Cela s'applique d'ailleurs à la plupart des systèmes et des personnes. Cependant, cet outil est plus adapté à l'insertion massive de données par gros blocs, alors que si le processus nécessite l'exécution de plusieurs requêtes concurrentes de lecture et d'écriture, les commandes Get et Put décrites ci-dessus sont utilisées. Afin de déterminer les paramètres optimaux, des exécutions ont été réalisées avec différentes combinaisons de paramètres de tables et de configurations :
- 10 threads ont été lancés simultanément 3 fois de suite (appelons cela un bloc de threads).
- Le temps de fonctionnement de tous les threads dans le bloc était moyen et constituait le résultat final du bloc.
- Tous les threads travaillaient avec la même table.
- Avant chaque lancement du bloc de threads, une compaction majeure était effectuée.
- Chaque bloc ne réalisait qu'une des opérations suivantes :
— Put
— Get
— Get+Put
- Chaque bloc exécutait 50 000 répétitions de son opération.
- La taille d'enregistrement dans le bloc était de 100 octets, 1000 octets ou 10000 octets (aléatoire).
- Les blocs étaient lancés avec un nombre variable de clés demandées (soit une clé ou 10).
- Les blocs étaient lancés avec différentes configurations de table. Les paramètres ont été modifiés :
— BlockCache = activé ou désactivé
— BlockSize = 65 Ko ou 16 Ko
— Partitions = 1, 5 ou 30
— MSLAB = activé ou désactivé
Ainsi, le bloc se présente comme suit :
a. Le mode MSLAB était activé/désactivé.
b. Un tableau a été créé, pour lequel les paramètres suivants ont été définis : BlockCache = true/none, BlockSize = 65/16 Ko, Partitions = 1/5/30.
c. La compression GZ a été configurée.
d. 10 threads étaient lancés simultanément, effectuant 1/10 opérations put/get/get+put dans ce tableau avec des enregistrements de 100/1000/10000 octets, exécutant 50 000 requêtes consécutives (clés aléatoires).
e. Le point d a été répété trois fois.
f. Le temps de fonctionnement de tous les threads a été moyenné.
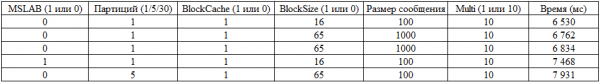
Toutes les combinaisons possibles ont été vérifiées. Il est prévisible qu'en augmentant la taille de l'enregistrement, la vitesse diminuera ou que la désactivation du cache entraînera un ralentissement. Cependant, l'objectif était de comprendre l'ampleur et l'importance de l'influence de chaque paramètre, donc les données collectées ont été soumises à une fonction de régression linéaire, ce qui permet d'évaluer la fiabilité à l'aide de la statistique t. Ci-dessous sont les résultats des blocs exécutant des opérations Put. L'ensemble complet de combinaisons est de 2*2*3*2*3 = 144 variantes + 72 car certaines ont été exécutées deux fois. Ainsi, au total, il y a eu 216 exécutions :
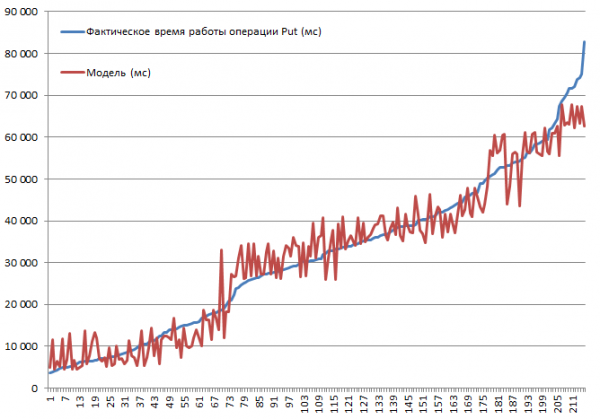
Les tests ont été réalisés sur un mini-cluster composé de 3 DataNodes et 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 threads). Version HBase 1.2.0-cdh5.14.2.
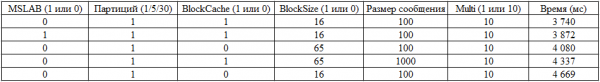
La vitesse d'insertion la plus élevée de 3,7 secondes a été obtenue en mode MSLAB désactivé, sur une table avec une seule partition, avec BlockCache activé, BlockSize = 16, des enregistrements de 100 octets en paquet de 10.
La vitesse d'insertion la plus basse de 82,8 secondes a été obtenue en mode MSLAB activé, sur une table avec une seule partition, avec BlockCache activé, BlockSize = 16, des enregistrements de 10000 octets par unité.
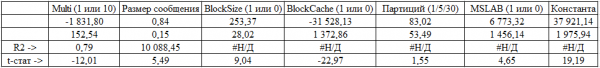
Voyons maintenant le modèle. Nous voyons une bonne qualité de modèle selon R2, mais il est clair que l'extrapolation est déconseillée ici. Le comportement réel du système lors de la variation des paramètres ne sera pas linéaire, ce modèle n'est pas destiné à des prévisions, mais à comprendre ce qui s'est produit dans les limites des paramètres donnés. Par exemple, ici nous voyons selon le critère de Student, que pour l'opération Put, les paramètres BlockSize et BlockCache n'ont pas d'importance (ce qui est assez prévisible) :
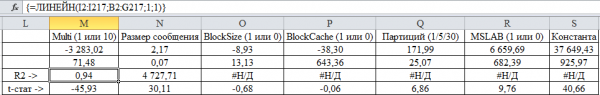
Il est quelque peu inattendu que l'augmentation du nombre de partitions entraîne une baisse des performances (nous avons déjà vu un impact positif de l'augmentation du nombre de partitions lors de BulkLoad), bien que cela soit explicable. Premièrement, le traitement nécessite de former des requêtes pour 30 régions au lieu d'une seule, et le volume de données n'est pas tel que cela en apporte un gain. Deuxièmement, le temps d'exécution total est déterminé par le RS le plus lent, et comme le nombre de DataNode est inférieur à celui des RS, certaines régions n'ont aucune localité. Regardons donc les cinq leaders :
Évaluons maintenant les résultats des blocs Get :
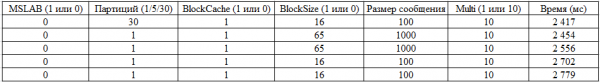
Le nombre de partitions a perdu de son importance, ce qui s'explique probablement par le fait que les données sont bien mises en cache et que le cache pour la lecture est le paramètre le plus significatif (statistiquement). Évidemment, l'augmentation du nombre de messages dans la requête est également très bénéfique pour les performances. Meilleurs résultats :
Enfin, examinons le modèle de bloc qui a d'abord exécuté get, puis put :
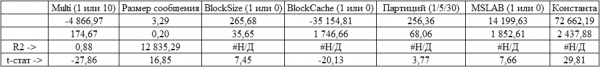
Tous les paramètres ici sont significatifs. Et les résultats des leaders :
9. Tests de charge
Enfin, exécutons une charge plus ou moins conséquente, mais c'est toujours plus intéressant quand il y a quelque chose à comparer. Sur le site de DataStax – le développeur clé de Cassandra, il y a des NT d'une série de stockages NoSQL, y compris HBase version 0.98.6-1. Le chargement s'est fait avec 40 flux, taille des données 100 octets, disques SSD. Le résultat des tests d'opérations Read-Modify-Write a montré tels résultats.
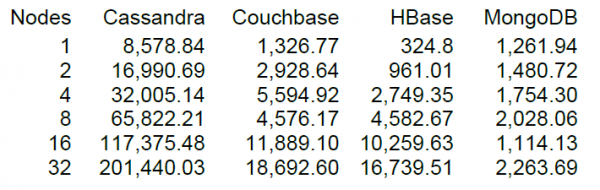
D'après ce que j'ai compris, la lecture était effectuée par blocs de 100 enregistrements et pour 16 nœuds, le test DataStax sur HBase a montré une performance de 10 000 opérations par seconde.
Il est heureux que notre cluster dispose également de 16 nœuds, mais il n'est pas très "heureux" que chacun ait 64 cœurs (flux), tandis que dans le test de DataStax, il n'y en avait que 4. D'un autre côté, ils ont des disques SSD, tandis que nous avons des HDD et une version HBase plus récente, et l'utilisation du CPU pendant la charge n'augmentait pratiquement pas (visuellement de 5 à 10 pour cent). Cependant, nous essayerons tout de même de démarrer avec cette configuration. Les paramètres des tables sont par défaut, la lecture se fait sur une plage de clés de 0 à 50 millions de manière aléatoire (c'est-à-dire à chaque fois un nouveau). Il y a 50 millions d'enregistrements dans la table, répartis sur 64 partitions. Les clés sont hachées par crc32. Les paramètres des tables sont par défaut, MSLAB est activé. Démarrage de 40 flux, chaque flux lit un ensemble de 100 clés aléatoires et écrit immédiatement 100 octets générés sur ces clés.
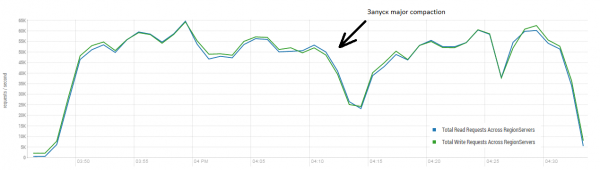
Stand: 16 DataNodes et 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 flux). Version HBase 1.2.0-cdh5.14.2.
Le résultat moyen est proche de 40 000 opérations par seconde, ce qui est nettement mieux que dans le test de DataStax. Cependant, dans un souci d'expérimentation, il est possible de modifier légèrement les conditions. Il est peu probable que tout le travail se fasse uniquement avec une seule table et seulement avec des clés uniques. Supposons qu'il existe un certain ensemble "chaud" de clés qui génère la principale charge. Nous allons donc essayer de créer une charge avec des enregistrements plus volumineux (10 Ko), également en paquets de 100, dans 4 tables différentes et en limitant la plage des clés demandées à 50 000. Le graphique ci-dessous montre le démarrage de 40 flux, chaque flux lit un ensemble de 100 clés et écrit immédiatement des 10 Ko aléatoires sur ces clés.
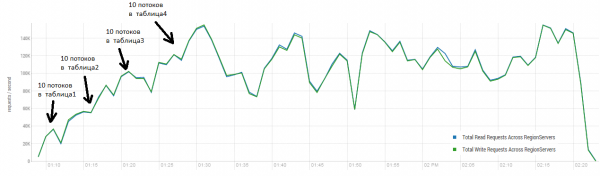
Stand: 16 DataNodes et 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 flux). Version HBase 1.2.0-cdh5.14.2.
Au cours de la charge, plusieurs exécutions de la compaction majeure ont été lancées, comme indiqué ci-dessus, sans cette procédure la performance se dégrade progressivement, mais durant l'exécution, une charge supplémentaire se produit également. Les baisses de performance sont causées par différentes raisons. Parfois, des flux terminaient leur travail et pendant qu'ils redémarraient, une pause survenait, parfois des applications tierces créaient une charge sur le cluster.
La lecture et l'écriture simultanées constituent l'un des scénarios de travail les plus exigeants pour HBase. Si vous faites uniquement des requêtes put de petite taille, par exemple de 100 octets, en les regroupant en lots de 10 à 50 000, vous pouvez obtenir des centaines de milliers d'opérations par seconde, et il en va de même pour les requêtes en lecture seule. Il convient de noter que les résultats sont radicalement meilleurs que ceux obtenus avec DataStax, principalement grâce aux requêtes en blocs de 50 000.
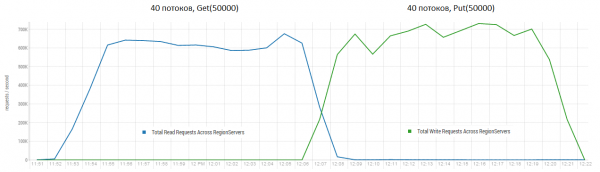
Stand: 16 DataNodes et 16 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 flux). Version HBase 1.2.0-cdh5.14.2.
10. Conclusions
Ce système est suffisamment flexible, mais l'influence d'un grand nombre de paramètres demeure encore inconnue. Certains d'entre eux ont été testés, mais n'ont pas été inclus dans l'ensemble de tests final. Par exemple, des expériences préliminaires ont montré que le paramètre DATA_BLOCK_ENCODING, qui code les informations en utilisant les valeurs des cellules voisines, a une signification légèrement insignifiante, ce qui est tout à fait explicable pour des données générées de manière aléatoire. Dans le cas où un grand nombre d'objets répétitifs est utilisé, le gain peut être significatif. En général, on peut dire qu'HBase donne l'impression d'être une base de données assez sérieuse et réfléchie, qui peut être suffisamment performante lors de l'exécution d'opérations sur de gros blocs de données, en particulier lorsqu'il est possible d'étalonner dans le temps les processus de lecture et d'écriture.
Si quelque chose ne vous semble pas assez clair, je suis prêt à en parler plus en détail. Nous vous invitons à partager vos expériences ou à discuter si vous n'êtes pas d'accord avec certains points.
Source : habr.com
