

Le principe d'incertitude d'Heisenberg stipule qu'il est impossible de mesurer simultanément la position d'un objet et sa vitesse. Si un objet est en mouvement, il n'a pas de position. Et si une position existe, cela signifie qu'il n'a pas de vitesse.
Concernant les microservices sur la plateforme Red Hat OpenShift (et gérés par Kubernetes), grâce aux logiciels open source appropriés, ils peuvent simultanément rapporter leurs performances ainsi que leur bon fonctionnement. Cela ne contredit pas le vieux Heisenberg, mais élimine l'incertitude lors du travail avec des applications cloud. Istio permet d'organiser facilement le suivi et la surveillance de ces applications, afin de garder le contrôle sur tout.
Définissons la terminologie
Sous suivi (Tracing) nous entendons l'enregistrement de l'activité systémique. Cela semble assez général, mais en réalité, l'une des règles principales ici est de déverser les données de suivi dans le stockage approprié, sans se soucier de leur formatage. Tout le travail de recherche et d'analyse des données est confié à leur consommateur. Dans Istio, le système de suivi Jaeger est utilisé, mettant en œuvre le modèle de données OpenTracing.
Traces (Traces, et le mot « traces » est utilisé ici dans le sens de « pistes », comme par exemple en expertise balistique) nous allons appeler les données qui décrivent entièrement le passage d'une requête ou d'une unité de travail, en d'autres termes, « de A à Z ». Par exemple, tout ce qui se passe dès que l'utilisateur appuie sur un bouton sur une page web, jusqu'au retour des données, en incluant tous les microservices impliqués. On peut dire qu'une trace décrit complètement (ou modélise) le passage d'une requête aller-retour. Dans l'interface de Jaeger, les traces sont décomposées en éléments le long d'un axe temporel, un peu comme une chaîne peut être décomposée en maillons distincts. Sauf qu'au lieu de maillons, une trace est composée de ce qu'on appelle des spans.
Span – est l'intervalle entre le début de l'exécution d'une unité de travail et son achèvement. En continuant l'analogie, on peut dire que chaque span représente un maillon distinct de la chaîne. Un span peut avoir (ou ne pas avoir) un ou plusieurs spans enfants. En conséquence, le span de plus haut niveau (root span) aura la même durée totale que la trace à laquelle il se rapporte.
Surveillance – il s'agit en fait de l'observation de votre système – à travers l'interface utilisateur ou par des moyens d'automatisation. La base du monitoring réside dans les données de traçage. Dans Istio, le monitoring est implémenté via Prometheus et dispose d'une interface utilisateur correspondante. Prometheus prend en charge le monitoring automatique avec des alertes Alerts et Alert Managers.
Nous faisons des marques
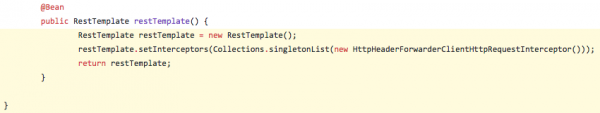
Pour que la traçabilité soit possible, l'application doit créer un ensemble de spans. Ensuite, il faut les exporter vers Jaeger, afin que ce dernier puisse créer une représentation visuelle de la traçabilité. Parmi d'autres choses, ces spans marquent le nom de l'opération ainsi que les horodatages de son début et de sa fin. Le transfert des spans se fait par une redirection des en-têtes HTTP destinés à Jaeger des requêtes entrantes vers les requêtes sortantes. Selon le langage de programmation utilisé, un léger ajustement du code source des applications peut être nécessaire. Voici un exemple de code en Java (en utilisant le framework Spring Boot) qui ajoute les en-têtes B3 (style Zipkin) à votre requête dans la classe de configuration Spring :
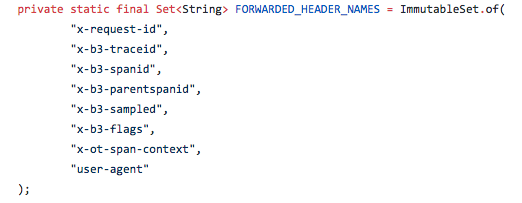
Les paramètres d'en-têtes suivants sont utilisés :
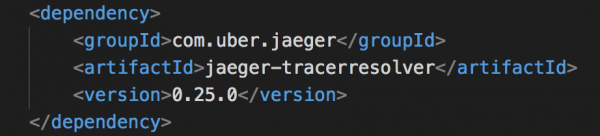
Si vous utilisez Java, vous n'avez pas besoin de modifier le code, mais il suffit d'ajouter quelques lignes dans le fichier POM de Maven et de définir des variables d'environnement. Voici les lignes à ajouter dans le fichier POM.XML pour intégrer Jaeger Tracer Resolver :
Les variables d'environnement correspondantes sont définies dans le Dockerfile :
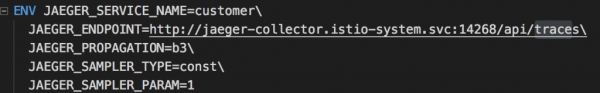
C'est tout, maintenant tout est configuré et nos microservices commenceront à générer des données de traçage.
Regardons dans les grandes lignes
Istio comprend un tableau de bord simple basé sur Grafana. Lorsque tout est configuré et fonctionne sur la plateforme Red Hat OpenShift PaaS (dans notre exemple, Red Hat OpenShift et Kubernetes sont déployés sur minishift), ce tableau de bord se lance avec la commande suivante :
open "$(minishift openshift service grafana -u)\/d\/1\/istio-dashboard?refresh=5⩝Id=1"
Le tableau de bord Grafana permet d'évaluer rapidement le fonctionnement du système. Un extrait de ce tableau de bord est montré sur l'image ci-dessous :
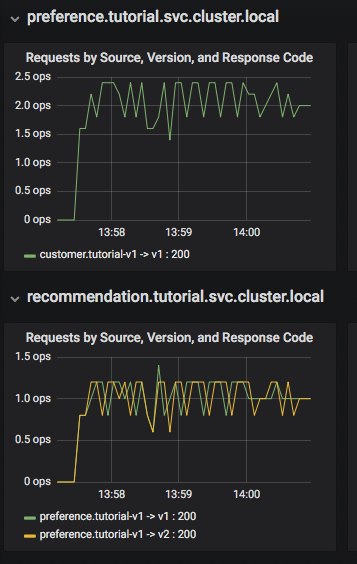
Ici, nous pouvons voir que le microservice customer appelle le microservice preference v1, qui, à son tour, appelle les microservices recommendation v1 et v2. Sur le tableau de bord Grafana, il y a un bloc Dashboard Row pour les métriques de haut niveau, telles que le nombre total de requêtes (Global Request Volume), le taux de réussite (success rates) et les erreurs 4xx. En outre, il y a une vue Server Mesh avec des graphiques pour chaque service et un bloc Services Row pour voir les détails de chaque conteneur pour chaque service.
Explorons maintenant plus en profondeur
Avec une traçabilité Istio correctement configurée, on peut dire qu'elle permet d'analyser la performance du système presque « out of the box ». Dans l'interface utilisateur de Jaeger, vous pouvez visualiser les traces et voir à quel point elles sont étendues et profondes, ainsi que localiser visuellement les goulets d'étranglement de performance. Lors de l'utilisation de Red Hat OpenShift sur la plateforme minishift, vous lancez l'interface Jaeger avec la commande suivante :
minishift openshift service jaeger-query --in-browser
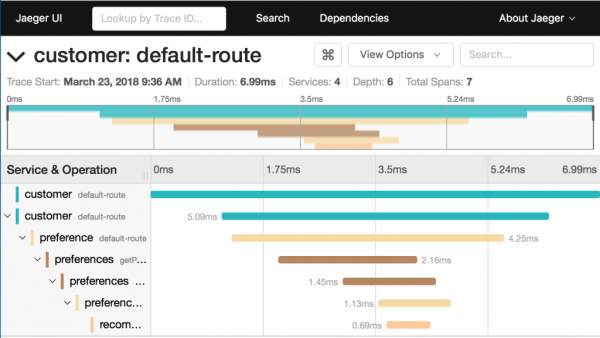
Que peut-on dire sur la traçabilité sur cette capture d'écran :
- Elle se divise en 7 spans.
- Le temps d'exécution total est de 6,99 ms.
- Le microservice recommendation, qui est le dernier de la chaîne, consomme 0,69 ms.
Des diagrammes de ce type permettent de comprendre rapidement une situation où un service fonctionnant mal nuit à la performance de tout le système.
Et maintenant, compliquons les choses et lançons deux instances du microservice recommendation:v2 avec la commande oc scale —replicas=2 deployment/recommendation-v2. Voici les pods que nous aurons après cela :
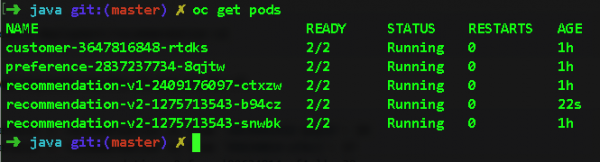
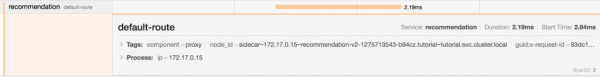
Si nous revenons maintenant à Jaeger et développons le span pour le service recommendation, nous verrons sur quel pod les requêtes sont routées. Ainsi, nous pouvons facilement localiser les ralentissements au niveau d'un pod spécifique. Il faut regarder le champ node_id :
Où et comment tout cela se déplace
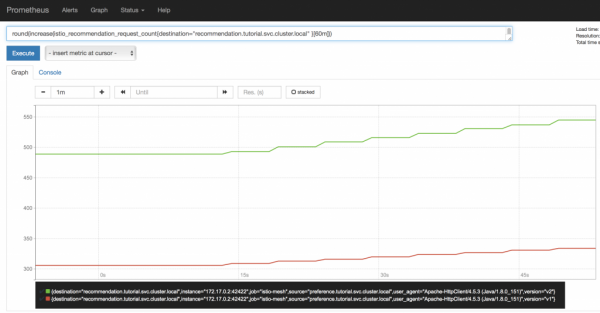
Nous passons maintenant à l'interface Prometheus et, comme prévu, nous constatons que les requêtes entre la deuxième et la première version du service recommendation sont partagées dans un rapport de 2:1, strictement selon le nombre de pods en fonctionnement. De plus, ce graphique changera dynamiquement lors de l'augmentation ou de la diminution des pods, ce qui sera particulièrement utile lors d'un déploiement Canary (nous aborderons cette méthode de déploiement plus en détail la prochaine fois).
Tout ne fait que commencer
Aujourd'hui, nous avons à peine effleuré la mine d'informations utiles sur Jaeger, Grafana et Prometheus. C'était en réalité notre objectif : vous orienter dans la bonne direction et vous ouvrir des perspectives sur Istio.
Et rappelez-vous, tout cela est déjà intégré dans Istio. Si vous utilisez certains langages de programmation (comme Java) et des frameworks (comme Spring Boot), vous pouvez tout mettre en œuvre sans toucher au code des applications. Oui, le code devra être légèrement modifié si vous utilisez d'autres langages, notamment Node.js ou C#. Mais étant donné que le traçage est l'une des exigences essentielles pour créer des systèmes cloud fiables, vous devrez donc de toute façon ajuster le code, que vous ayez Istio ou non. Alors pourquoi ne pas déployer vos efforts de manière plus judicieuse ?
Ne serait-ce que pour pouvoir répondre aux questions 'où ?' et 'à quelle vitesse ?' avec une certitude de 100%.
Ingénierie du chaos dans Istio : c'était l'idée originale
Savoir casser les choses aide à faire en sorte qu'elles ne se cassent pas.
Le test de logiciel est à la fois complexe et essentiel. D'un côté, tester la fonctionnalité (par exemple, si une fonction retourne le bon résultat) est une chose, mais tester en conditions de réseau peu fiable est une tout autre affaire (on suppose souvent que le réseau fonctionne sans interruption, et c'est l'une des plus grandes illusions concernant le calcul distribué). L'un des défis dans cette tâche est de simuler des pannes dans le système ou de les introduire intentionnellement, en pratiquant ce qu'on appelle l'injection de fautes. Cela peut se faire en modifiant le code source de l'application elle-même. Mais alors, vous ne testerez pas votre code initial, mais une version conçue pour simuler des échecs. Cela vous expose au risque de tomber dans les griffes mortelles de l'injection de fautes et d'être confronté aux geizenbugs – des bogues qui disparaissent lorsqu'on essaie de les détecter.
Nous allons maintenant montrer comment Istio aide à surmonter ces difficultés facilement.
À quoi cela ressemble quand tout fonctionne parfaitement.
Considérons le scénario suivant : nous avons deux pods pour notre microservice de recommandation, que nous avons pris dans un tutoriel sur Istio. Un pod est marqué comme v1 et l'autre comme v2. Comme vous pouvez le voir, tout fonctionne parfaitement pour l'instant :
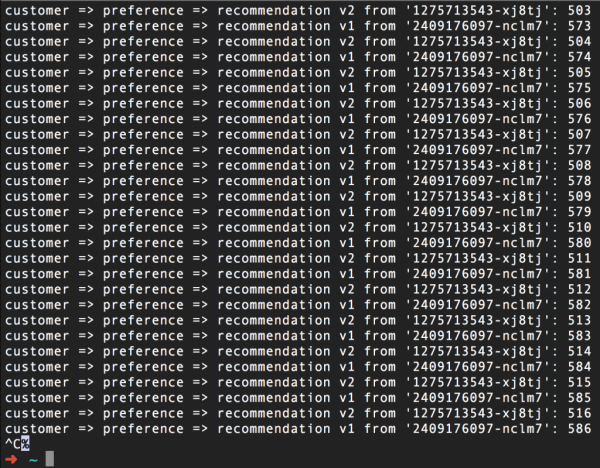
(Au fait, le chiffre à droite est simplement un compteur d'appels pour chaque pod.)
Mais ce n'est pas ce dont nous avons vraiment besoin, n'est-ce pas ? Eh bien, essayons de tout casser sans toucher au code source.
Nous provoquons des interruptions dans le service du microservice
Voici un fichier yaml pour une règle de routage Istio, qui échouera dans la moitié des cas (erreur de serveurs 503):
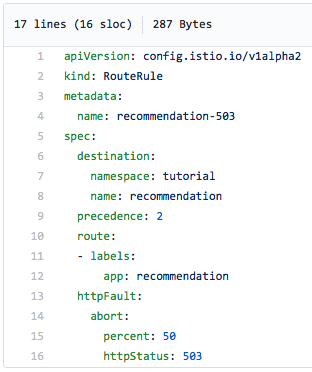
Notez que nous spécifions explicitement qu'une erreur 503 doit être retournée dans la moitié des cas.
Voici à quoi ressemblera la capture d'écran de la commande curl exécutée en boucle après avoir activé cette règle pour simuler des échecs. Comme nous le voyons, la moitié des requêtes retourne une erreur 503, quelle que soit la pod – v1 ou v2 – vers laquelle elles sont envoyées :
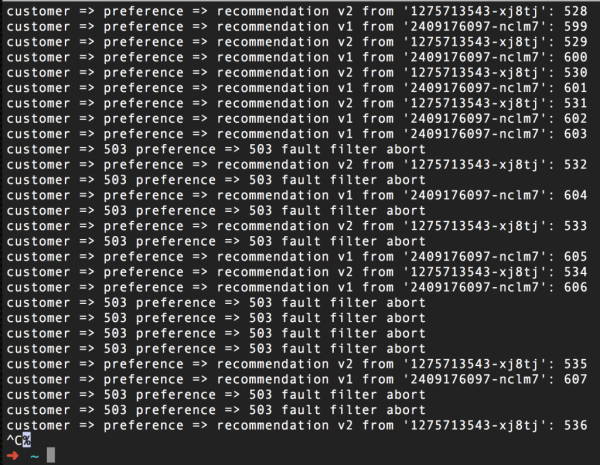
Pour restaurer le fonctionnement normal, il suffit de supprimer cette règle, dans notre cas avec la commande istioctl delete routerule recommendation-503 -n tutorial. Ici, Tutorial est le nom du projet Red Hat OpenShift dans lequel se déroule notre tutoriel sur Istio.
Nous introduisons des délais artificiels
Les erreurs 503 artificielles aident à tester la résilience du système face aux pannes, mais la capacité à prévoir et à gérer les délais devrait vous impressionner encore plus. En effet, les délais surviennent plus fréquemment dans la vie réelle que les pannes. Un microservice qui fonctionne lentement est un fardeau qui affecte l'ensemble du système. Grâce à Istio, vous pouvez tester le code relatif à la gestion des délais sans le modifier. Pour commencer, nous allons montrer comment procéder en cas de délais réseau introduits artificiellement.
Notez qu'après un tel test, vous pourriez avoir besoin (ou envie) d'améliorer votre code. La bonne nouvelle ici, c'est que, dans ce cas, vous agirez de manière proactive, plutôt que réactive. Voilà comment devrait se construire le cycle de développement : codage - test - feedback - codage - test…
Voici à quoi ressemble la règle qui… Mais vous savez quoi ? Istio est si simple, et ce fichier yaml est si compréhensible, que tout dans cet exemple parle de lui-même, jetez juste un œil :
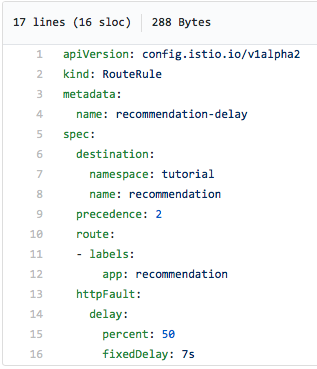
Dans la moitié des cas, nous aurons un délai de 7 secondes. Et ce n'est pas du tout la même chose que si nous avions inséré une commande sleep dans le code source, car Istio retarde réellement la requête de 7 secondes. Étant donné qu'Istio prend en charge le suivi Jaeger, ce délai est clairement observable dans l'interface utilisateur de Jaeger, comme le montre l'écran ci-dessous. Notez la longue requête dans le coin supérieur droit du graphique – sa durée est de 7,02 secondes :
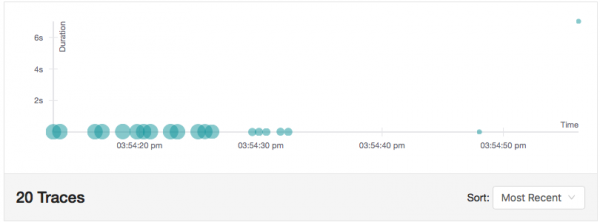
Ce scénario permet de tester le code dans des conditions de latence réseau. Et il est évident qu'en supprimant cette règle, nous éliminerons la latence artificielle. Répétons, mais nous avons encore fait tout cela sans toucher au code source.
Ne pas reculer et ne pas abandonner
Une autre fonctionnalité utile pour l'ingénierie du chaos d'Istio est la possibilité de réessayer d'appeler le service un nombre spécifié de fois. L'idée ici est de ne pas cesser les tentatives lorsque la première requête échoue avec une erreur 503 – et peut-être qu'à la N-ème tentative, nous aurons de la chance. Peut-être que le service était juste à plat pour une raison ou une autre. Oui, il faudrait découvrir et résoudre cette raison. Mais c'est pour plus tard, pour l'instant essayons de faire en sorte que le système continue de fonctionner.
Donc, nous voulons que le service génère de temps en temps une erreur 503, et qu'Istio essaie alors de se reconnecter. Il est clairement nécessaire de trouver un moyen de générer une erreur 503 sans toucher au code même...
Stop, attendez ! Nous venons juste de le faire.
Ce fichier fera en sorte que le service recommendation-v2 génère une erreur 503 dans la moitié des cas :
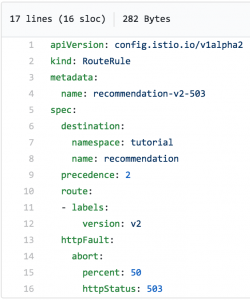
Il est évident qu'une partie des requêtes échouera :
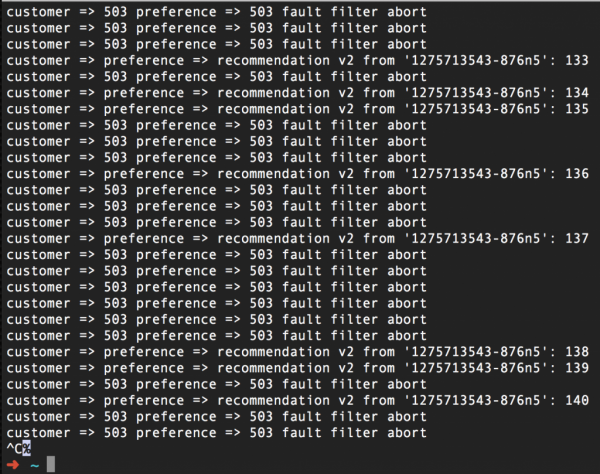
Et maintenant, utilisons la fonction Retry d'Istio :
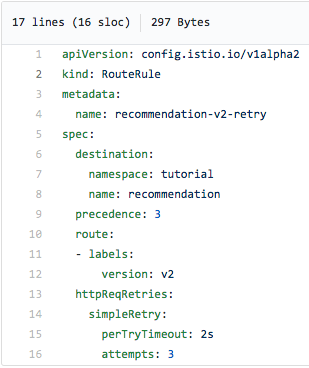
Cette règle de routage effectue trois tentatives avec un intervalle de deux secondes et devrait réduire (idéalement supprimer complètement) les erreurs 503 :
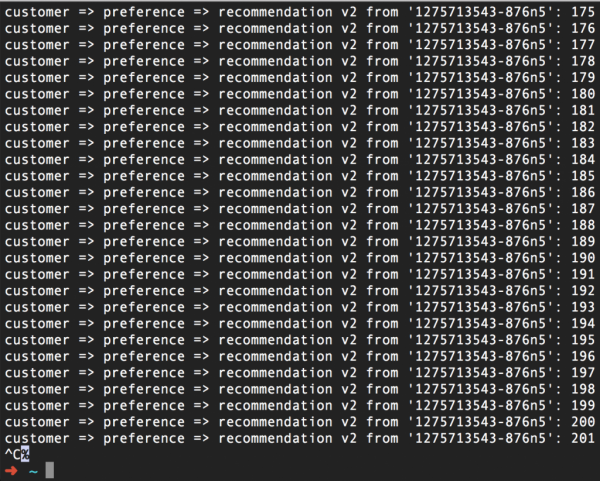
En résumé : nous avons fait en sorte qu'Istio, d'une part, génère une erreur 503 pour la moitié des requêtes. Et d'autre part, le même Istio effectue trois tentatives pour se reconnecter au service en cas d'erreur 503. En conséquence, tout fonctionne très bien. Ainsi, en utilisant la fonction Retry, nous avons tenu notre promesse de ne pas reculer et de ne pas abandonner.
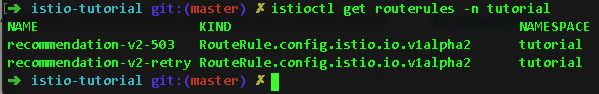
Et oui, nous l'avons encore fait, sans toucher au code. Tout ce dont nous avions besoin, ce sont deux règles de routage d'Istio :
Comment ne pas faire attendre l'utilisateur ou sept personnes ne pas attendre un autre
Et maintenant, retournons la situation et examinons le scénario où il est nécessaire de ne pas reculer ni abandonner, mais seulement pendant un certain temps fixe. Ensuite, il faut simplement cesser d'essayer de traiter la demande, pour ne pas faire attendre tout le monde à cause d'un service qui ralentit. En d'autres termes, nous ne protégerons pas une position perdue, mais nous reculerons vers un point de repli pour ne pas décevoir l'utilisateur du site et ne pas le forcer à rester dans l'incertitude.
Dans Istio, vous pouvez définir un timeout pour l'exécution d'une demande. Si le service dépasse ce timeout, une erreur 504 (Gateway Timeout) est renvoyée – encore une fois, tout cela se fait via la configuration d'Istio. Mais nous devrons ajouter une commande sleep dans le code source du service (et ensuite, bien sûr, effectuer un rebuild et un redeploy), afin d'imiter un fonctionnement lent du service. Malheureusement, c'est la seule solution.
Donc, nous avons inséré un sleep de trois secondes dans le code du service recommendation v2, recompilé l'image correspondante et effectué le redeploy du conteneur, et maintenant ajoutons un timeout à l'aide de la règle de routage Istio suivante :
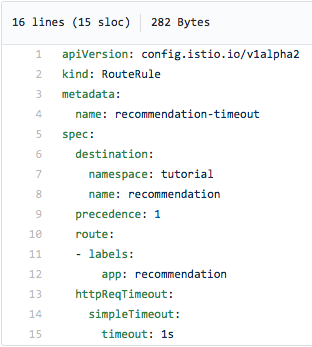
Dans l'écran ci-dessus, on voit que nous abandonnons la tentative de contact avec le service recommendation si nous ne recevons pas de réponse dans un délai d'une seconde, c'est-à-dire avant même que l'erreur 504 ne se produise. Après l'application de cette règle de routage (et l'ajout du sleep de trois secondes dans le code du service recommendation:v2), nous obtenons ce qui suit :
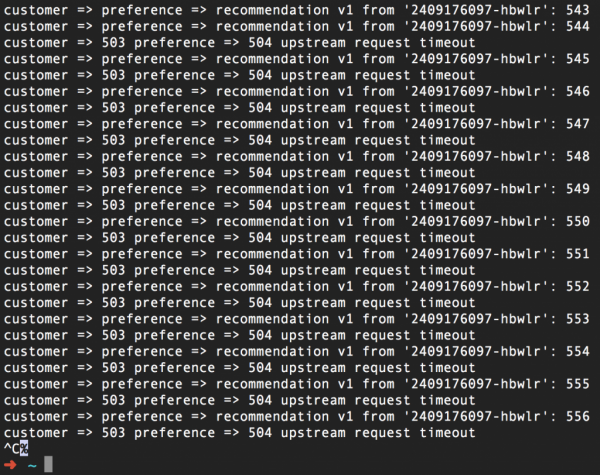
Encore une fois, nous le répétons, mais le timeout peut être défini sans toucher au code source. Un bonus supplémentaire ici est que vous pouvez désormais modifier votre code pour qu'il réagisse au timeout, et tester facilement ces améliorations avec Istio.
Et maintenant, tout ensemble
Introduire un peu de chaos avec Istio est un excellent moyen de tester votre code et la fiabilité de votre système dans son ensemble. Les modèles de fallback, de bulkhead et de circuit breaker, les mécanismes de création de pannes et de délais artificiels, ainsi que les appels répétés et les timeouts seront très utiles lors de la création de systèmes cloud résilients. En combinaison avec Kubernetes et Red Hat OpenShift, ces outils vous aideront à accueillir l'avenir avec confiance.
Source : habr.com
