

Cet article est la traduction de mon article sur Medium — , qui a été plutôt populaire, probablement en raison de sa simplicité. C'est pourquoi j'ai décidé de l'écrire en français et d'y ajouter quelques éléments, afin que le grand public, qui n'est pas expert en données, puisse comprendre ce qu'est un entrepôt de données (DW), et ce qu'est un Data Lake, ainsi que leur coexistence.
Pourquoi ai-je voulu écrire sur le Data Lake ? Je travaille dans le domaine des données et de l'analytique depuis plus de 10 ans, et aujourd'hui je travaille précisément avec des Big Data chez Amazon Alexa AI à Cambridge, près de Boston, bien que je vive à Victoria, sur l'île de Vancouver, et que je me rende souvent à Boston, Seattle, et Vancouver, et parfois même à Moscou pour des conférences. De plus, de temps en temps j'écris, mais principalement en anglais, ayant déjà rédigé , et j'ai également le besoin de partager les tendances en matière d'analytique en Amérique du Nord, et j'écris parfois sur .
J'ai toujours travaillé avec des entrepôts de données, et depuis 2015, je suis fortement impliqué avec Amazon Web Services, et en général je me suis tourné vers l'analytique dans le cloud (AWS, Azure, GCP). J'ai observé l'évolution des solutions d'analytique depuis 2007 et j'ai même travaillé pour un fournisseur d'entrepôts de données, Teradata, en l'implémentant au Sberbank, c'est à ce moment-là que le Big Data a émergé avec Hadoop. Tout le monde a commencé à dire que l'ère des entrepôts était révolue et que tout le monde était désormais sur Hadoop, puis on a commencé à parler de Data Lake, encore une fois en affirmant que l'entrepôt de données était bel et bien fini. Mais heureusement (peut-être pour certains, malheureusement pour ceux qui gagnaient beaucoup d'argent en configurant Hadoop), l'entrepôt de données n'a pas disparu.
Dans cet article, nous allons explorer ce qu'est un Data Lake. Cet article s'adresse aux personnes qui ont peu ou pas d'expérience avec les entrepôts de données.
Sur l'image se trouve le lac de Bled, l'un de mes lacs préférés, bien que je n'y sois allé qu'une seule fois, mais je m'en souviens toute ma vie. Mais nous allons parler d'un autre type de lac — du Data Lake. Peut-être que beaucoup d'entre vous ont déjà entendu parler de ce terme, mais une nouvelle définition ne fera de mal à personne.
Tout d'abord, voici les définitions les plus populaires du Data Lake :
"un dépôt de fichiers de tous types de données brutes, accessibles pour analyse par quiconque dans l'organisation" — Martin Fowler.
«Si vous pensez que le lac de données est comme une bouteille d'eau — purifiée, emballée et conditionnée pour un usage pratique, alors le lac de données est un grand réservoir d'eau à l'état naturel. Les utilisateurs peuvent puiser de l'eau, plonger en profondeur, explorer» — James Dickson.
Nous savons maintenant avec certitude que le lac de données est lié à l'analyse ; il nous permet de stocker de grands volumes de données dans leur forme originale et nous offre un accès nécessaire et pratique aux données.
J'aime souvent simplifier les choses. Si je peux expliquer un terme complexe avec des mots simples, cela signifie que j'ai compris son fonctionnement et son utilité. Un jour, alors que je fouillais dans les photos de mon iPhone, cela m'a frappé : c'est un véritable lac de données, j'ai même réalisé une diapositive pour des conférences :
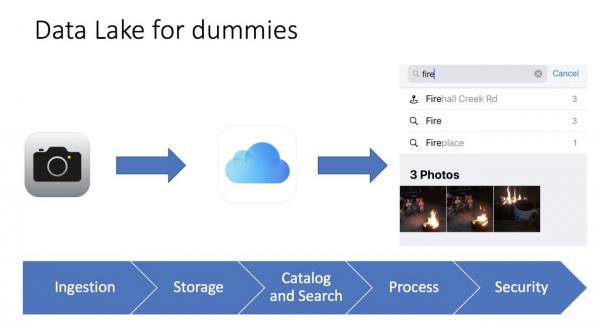
C'est très simple. Nous prenons une photo avec le téléphone, la photo est sauvegardée sur le téléphone et peut être sauvegardée dans iCloud (un stockage dans le cloud). De plus, le téléphone collecte des métadonnées de la photo : ce qui est représenté, la géolocalisation, l'heure. En conséquence, nous pouvons utiliser l'interface pratique de l'iPhone pour retrouver notre photo, et nous pouvons même voir des indicateurs, par exemple, quand je cherche des photos avec le mot feu (fire), je trouve 3 photos de feux de camp. Pour moi, c'est comme un outil de Business Intelligence qui fonctionne très rapidement et efficacement.
Et bien sûr, nous ne devons pas oublier la sécurité (autorisation et authentification), sinon nos données pourraient facilement devenir accessibles au public. Il y a beaucoup de nouvelles concernant de grandes entreprises et des startups dont les données ont été rendues publiques en raison de la négligence des développeurs et du non-respect de règles simples.
Même une image simple nous aide à comprendre ce qu'est un lac de données, ses différences par rapport à un entrepôt de données traditionnel et ses principaux éléments :
- Chargement des données (Ingestion) — un composant clé du lac de données. Les données peuvent entrer dans l'entrepôt de deux manières — par batch (chargement par intervalles) et par streaming (flux de données).
- Stockage de fichiers (Storage) — le principal composant du lac de données. Nous avons besoin que le stockage soit facilement évolutif, extrêmement fiable et à faible coût. Par exemple, dans AWS, c'est S3.
- Catalogue et Recherche (Catalogue et recherche) — pour éviter les marais de données (c'est lorsqu'on regroupe toutes les données en un seul endroit, rendant leur exploitation impossible), nous devons créer une couche de métadonnées pour classer les données, afin que les utilisateurs puissent facilement trouver les informations nécessaires à leur analyse. De plus, on peut utiliser des solutions de recherche supplémentaires, comme ElasticSearch. La recherche aide l'utilisateur à trouver les données requises via une interface conviviale.
- Traitement (Processus) — cette étape est responsable du traitement et de la transformation des données. Nous pouvons transformer les données, modifier leurs structures, les nettoyer et bien plus encore.
- Sécurité (Sécurité) — il est important de consacrer du temps à la conception de la sécurité de la solution. Par exemple, le chiffrement des données pendant le stockage, le traitement et le chargement. Il est essentiel d'utiliser des méthodes d'authentification et d'autorisation. En conclusion, un outil d'audit est nécessaire.
D'un point de vue pratique, nous pouvons caractériser un lac de données par trois attributs :
- Collectez et stockez tout ce que vous voulez — un lac de données contient toutes les données, qu'elles soient brutes et non traitées sur n'importe quelle période, ou des données traitées/nettoyées.
- Analyse approfondie — un lac de données permet aux utilisateurs d'explorer et d'analyser les données.
- Accès flexible — un lac de données offre un accès flexible à diverses données et différents scénarios.
Nous pouvons maintenant discuter de la différence entre un entrepôt de données et un lac de données. Les gens demandent souvent :
- Qu'en est-il de l'entrepôt de données ?
- Remplaçons-nous l'entrepôt de données par un lac de données ou l'étendons-nous ?
- Peut-on finalement se passer d'un lac de données ?
Pour résumer, il n'y a pas de réponse claire. Tout dépend de la situation spécifique, des compétences de l'équipe et du budget. Par exemple, la migration d'un entrepôt de données vers Oracle sur AWS et la création d'un lac de données par la filiale d'Amazon — Woot — .
D'autre part, le fournisseur Snowflake affirme que vous n'avez plus besoin de vous préoccuper d'un lac de données, car leur plateforme de données (jusqu'en 2020 c'était un entrepôt de données) vous permet de combiner à la fois un lac de données et un entrepôt de données. J'ai peu travaillé avec Snowflake, et c'est vraiment un produit unique qui peut faire cela. Le coût de l'affaire, c'est une autre question.
En conclusion, mon opinion personnelle est que nous avons toujours besoin d'un entrepôt de données comme source principale pour notre reporting, et tout ce qui ne peut pas être stocké y est conservé dans un lac de données. Le rôle de l'analytique est de fournir un accès facile aux entreprises pour la prise de décisions. Quoi qu'il en soit, les utilisateurs commerciaux travaillent plus efficacement avec un entrepôt de données qu'avec un lac de données. Par exemple, chez Amazon, il y a Redshift (un entrepôt de données analytique) et il y a Redshift Spectrum/Athena (une interface SQL pour le lac de données S3 basée sur Hive/Presto). Il en va de même pour d'autres solutions modernes d'entrepôts de données analytiques.
Examinons une architecture typique d'entrepôt de données :
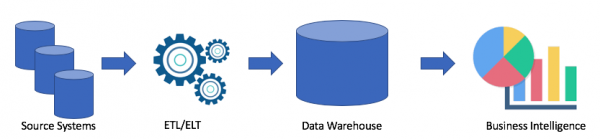
C'est une solution classique. Nous avons des systèmes sources, grâce à ETL/ELT, nous copions les données dans l'entrepôt de données analytique et les connectons à une solution de Business Intelligence (ma préférée est Tableau, et la vôtre ?).
Une telle solution présente les inconvénients suivants :
- Les opérations ETL/ELT nécessitent du temps et des ressources.
- En général, le stockage des données dans un entrepôt de données analytique n'est pas bon marché (comme Redshift, BigQuery, Teradata), car nous devons acheter un cluster complet.
- Les utilisateurs commerciaux ont accès à des données nettoyées et souvent agrégées, et ils n'ont pas la possibilité d'obtenir des données brutes.
Bien sûr, tout dépend de votre cas. Si vous n'avez pas de problèmes avec votre entrepôt de données, vous n'avez absolument pas besoin d'un lac de données. Mais lorsqu'il y a des problèmes de manque d'espace, de puissance ou lorsque le coût est un facteur clé, il peut être judicieux d'envisager un lac de données. C'est pourquoi les lacs de données sont très populaires. Voici un exemple d'architecture de lac de données :
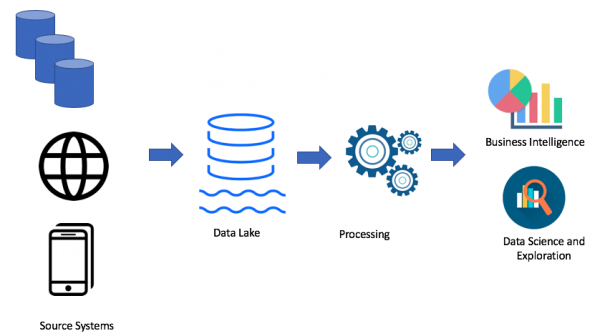
En utilisant l'approche du lac de données, nous chargeons des données brutes dans notre lac de données (par lots ou en streaming), puis nous traitons les données selon les besoins. Un lac de données permet aux utilisateurs commerciaux de créer leurs propres transformations de données (ETL/ELT) ou d'analyser des données dans des solutions de Business Intelligence (si le driver approprié est disponible).
L'objectif de toute solution analytique est de servir les utilisateurs commerciaux. Par conséquent, nous devons toujours travailler en fonction des exigences commerciales. (Chez Amazon, c'est l'un des principes — travailler à rebours).
En travaillant à la fois avec un entrepôt de données et un lac de données, nous pouvons comparer les deux solutions :
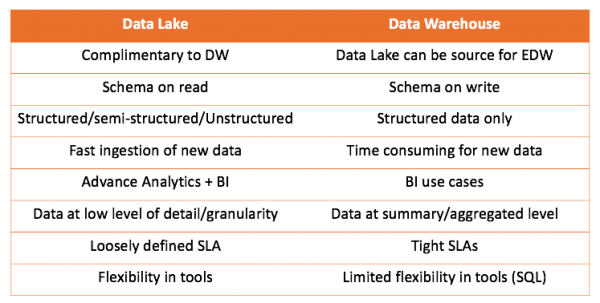
La principale conclusion à tirer est que le stockage des données ne concurrence en rien le lac de données, mais le complète plutôt. Cependant, c'est à vous de décider ce qui convient à votre cas. Il est toujours intéressant d'essayer par soi-même et de tirer les bonnes conclusions.
Je voudrais également parler d'un des cas où j'ai commencé à utiliser l'approche du lac de données. Tout est plutôt ordinaire, j'ai essayé d'utiliser un outil ELT (nous avions Matillion ETL) et Amazon Redshift, ma solution fonctionnait, mais ne correspondait pas aux exigences.
J'avais besoin de récupérer les logs web, de les transformer et de les agréger, afin de fournir des données pour 2 cas :
- L'équipe marketing voulait analyser l'activité des bots pour le SEO.
- L'IT voulait examiner les métriques de fonctionnement des sites.
Des logs très simples, très basiques. Voici un exemple :
https 2018-07-02T22:23:00.186641Z app/my-loadbalancer/50dc6c495c0c9188
192.168.131.39:2817 10.0.0.1:80 0.086 0.048 0.037 200 200 0 57
"GET https://www.example.com:443/ HTTP/1.1" "curl/7.46.0" ECDHE-RSA-AES128-GCM-SHA256 TLSv1.2
arn:aws:elasticloadbalancing:us-east-2:123456789012:targetgroup/my-targets/73e2d6bc24d8a067
"Root=1-58337281-1d84f3d73c47ec4e58577259" "www.example.com" "arn:aws:acm:us-east-2:123456789012:certificate/12345678-1234-1234-1234-123456789012"
1 2018-07-02T22:22:48.364000Z "authenticate,forward" "-" "-"
Un fichier pesait entre 1 et 4 mégaoctets.
Mais il y avait un problème. Nous avions 7 domaines à travers le monde, et chaque jour, 7000 fichiers étaient créés. Ce n'est pas très volumineux, seulement 50 giga-octets. Mais la taille de notre cluster Redshift était également petite (4 nœuds). Le chargement traditionnel d'un fichier prenait environ une minute. Donc, la tâche ne se résolvait pas directement. Et c'était le genre de situation où j'ai décidé d'utiliser l'approche du lac de données. La solution ressemblait à peu près à ceci :
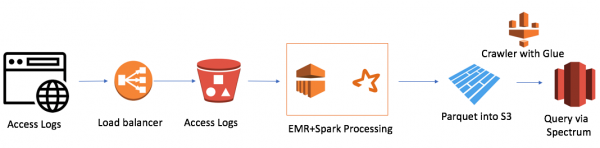
Elle est assez simple (je tiens à souligner que l'un des avantages de travailler dans le cloud est sa simplicité). J'ai utilisé :
- AWS Elastic Map Reduce (Hadoop) comme puissance de calcul.
- AWS S3 comme stockage de fichiers avec possibilité de chiffrer les données et de restreindre l'accès.
- Spark comme puissance de calcul InMemory et PySpark pour la logique et la transformation des données.
- Parquet comme résultat du travail de Spark.
- AWS Glue Crawler comme collecteur de métadonnées pour les nouvelles données et partitions.
- Redshift Spectrum comme interface SQL vers le lac de données pour les utilisateurs existants de Redshift.
Le plus petit cluster EMR+Spark traitait tous les fichiers en 30 minutes. Il existe également d'autres cas pour AWS, en particulier beaucoup liés à Alexa, où les données sont très volumineuses.
Récemment, j'ai découvert l'un des inconvénients d'un lac de données : le RGPD. Le problème survient lorsque le client demande la suppression, et que les données se trouvent dans l'un des fichiers, nous ne pouvons pas utiliser le Data Manipulation Language et l'opération DELETE comme dans une base de données.
J'espère que cet article a clarifié la différence entre un entrepôt de données et un lac de données. Si cela vous a intéressé, je peux traduire d'autres articles que j'ai écrits ou ceux de professionnels que je lis. Je peux également parler des solutions avec lesquelles je travaille et de leur architecture.
Source : habr.com
