

La prochaine conférence HighLoad++ aura lieu les 6 et 7 avril 2020 à Saint-Pétersbourg. Détails et billets. . HighLoad++ Moscou 2018. Salle « Moscou ». 9 novembre, 15h00. Résumés et .
* Surveillance - en ligne et analytique.
* Principales limites de la plateforme ZABBIX.
* Solution pour l'évolutivité du stockage analytique.
* Optimisation du serveur ZABBIX.
* Optimisation de l'UI.
* Expérience d'exploitation du système sous des charges dépassant 40k NVPS.
* En résumé, les conclusions.
Mikhail Makurov (ci-après - MM): – Bonjour à tous !
Maxime Tchernetsov (ci-après - MT): – Bonjour !
MM: – Permettez-moi de présenter Maxime. Maxime est un ingénieur talentueux, le meilleur spécialiste réseau que je connaisse. Maxime s'occupe des réseaux et des services, de leur développement et de leur exploitation.
MT: – Et j'aimerais parler de Mikhaïl. Mikhaïl est développeur en C. Il a écrit plusieurs solutions à fort trafic pour notre entreprise. Nous vivons et travaillons dans l'Oural, dans la ville des durs hommes de Tcheliabinsk, au sein de la société « Intersvyaz ». Notre entreprise est un fournisseur de services Internet et de télévision par câble pour un million de personnes dans 16 villes.
MM: – Et il convient de dire qu'« Intersvyaz » est bien plus qu'un simple fournisseur, c'est une entreprise IT. La plupart de nos solutions ont été réalisées par notre département IT.
A: des serveurs traitant le trafic, jusqu'au centre d'appel et à l'application mobile. Le département IT compte actuellement environ 80 personnes avec des compétences très variées.
À propos de Zabbix et de son architecture
MT: – Et maintenant, je vais essayer de battre un record personnel et de dire en une minute ce qu'est Zabbix (ci-après - « Zabbix »).
« Zabbix » se positionne comme un système de surveillance « clé en main » de niveau entreprise. Il contient de nombreuses fonctionnalités facilitant la vie : des règles d'escalade avancées, une API pour l'intégration, la groupement et la découverte automatique des hôtes et métriques. Dans « Zabbix », il existe ce que l'on appelle des outils d'évolutivité - des proxies. « Zabbix » est un système à code source ouvert.
En bref sur l'architecture. On peut dire qu'elle se compose de trois composants :
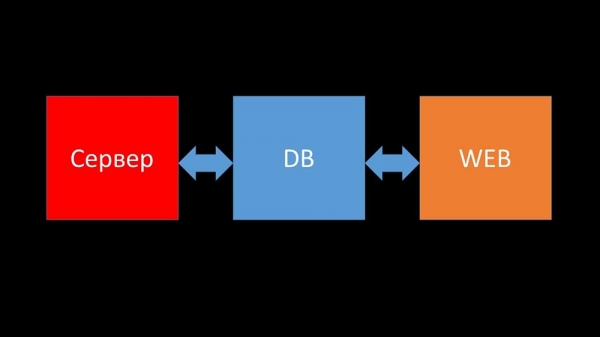
- Serveur. Écrit en C. Avec un traitement et une transmission d'informations entre les flux assez complexes. Tout le traitement se fait dans celui-ci : de la réception à la sauvegarde dans la base.
- Toutes les données sont stockées dans la base. « Zabbix » prend en charge MySQL, PostgreSQL et Oracle.
- L'interface web est écrite en PHP. Dans la plupart des systèmes, elle est fournie avec le serveur Apache, mais fonctionne de manière plus efficace en association avec nginx + php.
Aujourd'hui, nous aimerions partager avec vous une histoire de la vie de notre entreprise, liée à «Zabbix»...
Une histoire de la vie de l'entreprise «Intersvyaz». Qu'avons-nous et de quoi avons-nous besoin ?
Il y a 5 ou 6 mois. Un jour après le travail...
MT: – Misha, salut ! Content de t'avoir attrapé – j'ai quelque chose à te dire. Nous avons encore eu des problèmes avec la surveillance. Lors d'une grande panne, tout ralentissait et il n'y avait aucune information sur l'état du réseau. Malheureusement, cela ne se produit pas pour la première fois. J'ai besoin de ton aide. Faisons en sorte que notre système de surveillance fonctionne en toutes circonstances !
MM: – Mais d'abord, synchronisons-nous. Je n'ai pas regardé cela depuis quelques années. D'après ce que je me souviens, nous avons abandonné Nagios et sommes passés à «Zabbix» il y a environ 8 ans. Et maintenant, il me semble que nous avons 6 serveurs puissants et une dizaine de proxys. Je ne me trompe pas ?
MT: – Presque. 15 serveurs, dont certains sont des machines virtuelles. Le plus important, c'est que cela ne nous sauve pas au moment où nous en avons le plus besoin. Lors d'une panne, les serveurs ralentissent et rien n'est visible. Nous avons essayé d'optimiser la configuration, mais cela ne donne pas de gains de performance satisfaisants.
MM: – Je comprends. Avez-vous déjà analysé quelque chose, trouvé des éléments de diagnostic ?
MT: – La première chose avec laquelle il faut composer, c'est la base de données. MySQL est déjà constamment sollicité, conservant les nouvelles métriques, et quand «Zabbix» commence à générer une multitude d'événements, la base s'enferme littéralement pendant plusieurs heures. Je t'ai déjà parlé de l'optimisation de la configuration, mais cette année, nous avons mis à jour le matériel : les serveurs disposent de plus de cent Go de mémoire et de matrices de disques en RAID SSD – il n'y a plus de sens à agrandir cela linéairement. Que faisons-nous ?
MM: – Je comprends. En général, MySQL est une base de données LTP. Il semble qu'elle ne convienne plus pour stocker l'archive des métriques de notre taille. Commençons à examiner cela.
MT: – D'accord !
Intégration de Zabbix et Clickhouse comme résultat du hackathon
Après un certain temps, nous avons obtenu des données intéressantes :
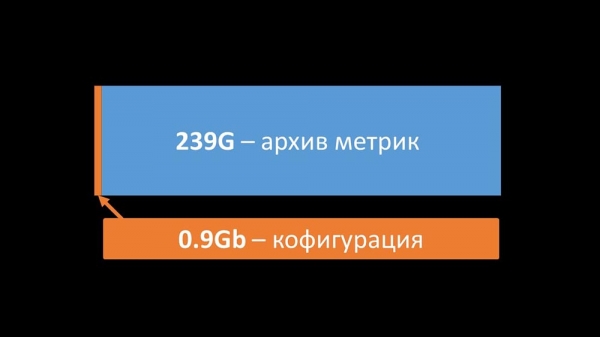
La plupart de l'espace dans notre base était occupé par l'archive des métriques et moins de 1 % était utilisé pour la configuration, les modèles et les paramètres. À ce moment-là, nous exploitons déjà une solution Big Data basée sur Clickhouse depuis plus d'un an. La direction à suivre pour nous était évidente. Lors de notre « Hackathon » printanier, j'ai écrit une intégration de Zabbix avec Clickhouse pour le serveur et le frontend. À l'époque, Zabbix avait déjà supporté ElasticSearch, et nous avons décidé de les comparer.
Comparaison Clickhouse et Elasticsearch
MM: – Pour la comparaison, nous avons généré une charge équivalente à celle fournie par le serveur Zabbix et observé comment les systèmes se comporteraient. Nous avons écrit des données par lots de 1000 lignes, en utilisant CURL. Nous supposions à l'avance que Clickhouse serait plus efficace pour le profil de charge généré par Zabbix. Les résultats ont même dépassé nos attentes :
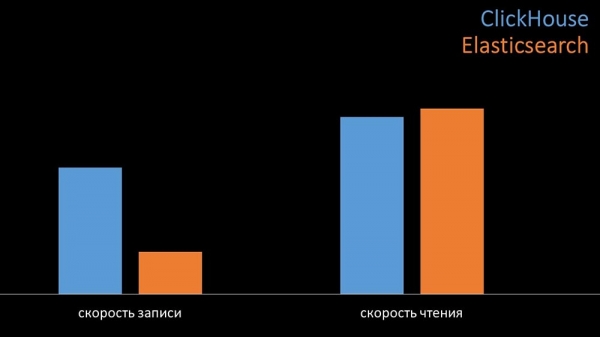
Dans des conditions identiques lors des tests, Clickhouse écrivait trois fois plus de données. Les deux systèmes consommaient très efficacement (peu de ressources) en lisant les données. Mais ElasticSearch nécessitait beaucoup de processeur lors de l'écriture :
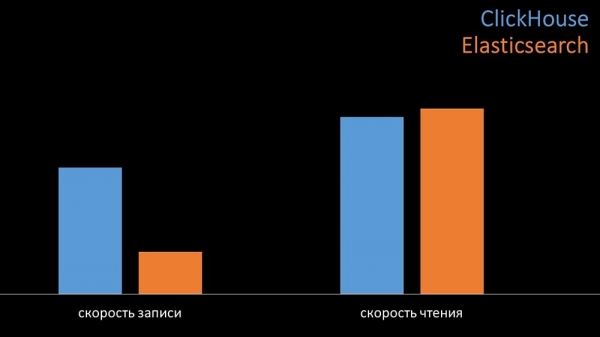
Au total, Clickhouse surpassait de manière significative ElasticSearch en termes de consommation de processeur et de vitesse. De plus, grâce à la compression des données, Clickhouse utilise 11 fois moins d'espace sur le disque dur et effectue environ 30 fois moins d'opérations disque :
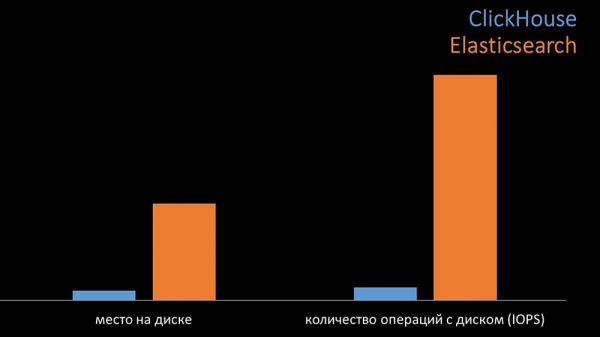
MT: – Oui, le travail avec le sous-système de stockage de Clickhouse est réalisé de manière très efficace. On peut utiliser d'énormes disques SATA pour les bases et obtenir une vitesse d'écriture de plusieurs centaines de milliers de lignes par seconde. Le système prend en charge le sharding et la réplication dès la sortie de la boîte, et est très simple à configurer. Nous sommes plus que satisfaits de son exploitation au cours de l'année.
Pour optimiser les ressources, on peut installer Clickhouse à côté de la base principale existante, économisant ainsi une quantité considérable de temps processeur et d'opérations disque. Nous avons déplacé l'archive des métriques vers les clusters Clickhouse déjà existants :
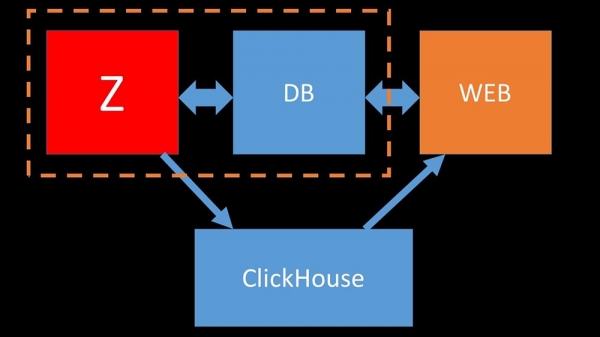
Nous avons tellement déchargé la base MySQL principale que nous avons pu la combiner sur une seule machine avec le serveur Zabbix et abandonner le serveur dédié pour MySQL.
Comment fonctionne le polling dans Zabbix ?
Il y a 4 mois
MM: – Alors, peut-on oublier les problèmes liés à la base ?
MT: – C'est sûr ! Une autre tâche que nous devons résoudre est la collecte de données lente. Maintenant, tous nos 15 serveurs proxy sont surchargés par des processus SNMP et de polling. Et il n'y a pas d'autre choix que de mettre en place de nouveaux serveurs.
MM: – Excellent. Mais dis-moi d'abord comment fonctionne le polling dans «Zabbix» ?
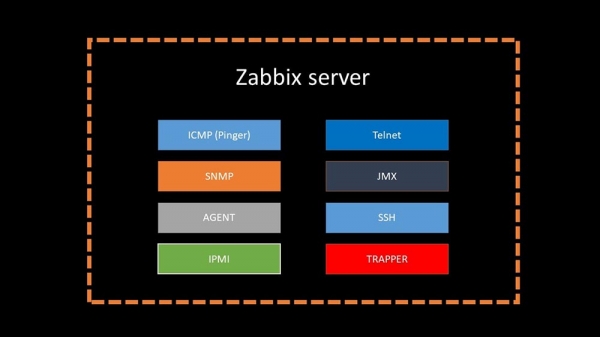
MT: – Pour faire court, il existe 20 types de métriques et une dizaine de façons de les obtenir. «Zabbix» peut collecter des données soit en mode «requête - réponse», soit attendre de nouvelles données via l'«Interface Trapper».
Il convient de noter que dans le «Zabbix» original, cette méthode (Trapper) est la plus rapide.
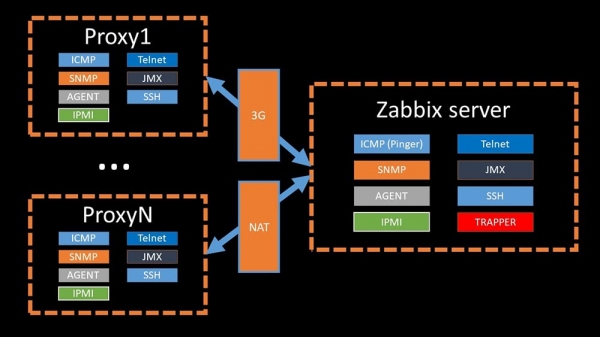
Il existe des serveurs proxy pour la répartition des charges :
Les proxies peuvent effectuer les mêmes fonctions de collecte que le serveur «Zabbix», recevant des tâches de celui-ci et envoyant les métriques collectées précisément via l'interface Trapper. C'est la méthode de répartition de charge officiellement recommandée. Les proxies sont également utiles pour surveiller l'infrastructure distante fonctionnant via NAT ou un canal lent :
MM: – L'architecture est claire. Nous devons regarder les sources…
Quelques jours plus tard
L'histoire de la façon dont nmap fping a triomphé
MM: – Il me semble que j'ai trouvé quelque chose.
MT: – Raconte-moi !
MM: – J'ai découvert que lors des vérifications de disponibilité, «Zabbix» teste un maximum de 128 hôtes simultanément. J'ai essayé d'augmenter ce chiffre à 500 et j'ai supprimé l'intervalle entre les paquets dans leur ping – cela a doublé la performance. Mais j'aimerais des chiffres plus élevés.
MT: – Dans ma pratique, il m'arrive parfois de vérifier la disponibilité de milliers d'hôtes, et je n'ai rien trouvé de plus rapide que nmap pour cela. Je suis sûr que c'est le moyen le plus rapide. Essayons-le ! Nous devons considérablement augmenter le nombre d'hôtes par itération.
MM: – Vérifier plus de cinq cents ? 600 ?
MT: – Au moins quelques milliers.
MM: – D'accord. La chose la plus importante que je voulais dire : j'ai constaté que la plupart des pollings dans «Zabbix» sont effectués de manière synchronisée. Nous devons absolument le convertir en mode asynchrone. Alors nous pourrons augmenter radicalement le nombre de métriques collectées par les pollers, surtout si nous augmentons le nombre de métriques par itération.
MT: – Génial ! Et quand ?
MM: – Comme d'habitude, hier.
MT: – Nous avons comparé les deux versions de fping et nmap :
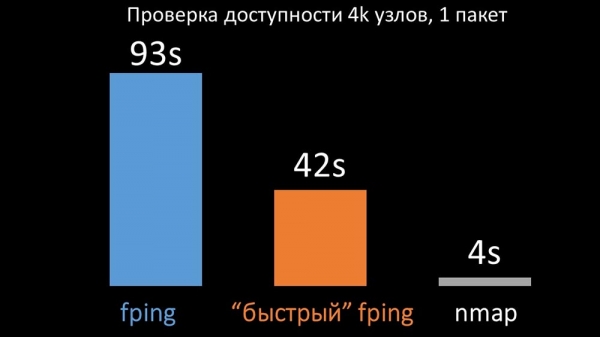
Sur un grand nombre d'hôtes, nmap s'est révélé jusqu'à cinq fois plus efficace que prévu. Étant donné que nmap vérifie uniquement la disponibilité et le temps de réponse, nous avons transféré le comptage des pertes dans des déclencheurs et considérablement réduit les intervalles de vérification de la disponibilité. Nous avons trouvé qu'un nombre optimal d'hôtes pour nmap se situe aux alentours de 4000 par itération. Nmap nous a permis de réduire par trois la consommation CPU pour les vérifications de disponibilité et de réduire l'intervalle de 120 secondes à 10.
Optimisation du polling
MM: – Nous nous sommes ensuite penchés sur les pollers. Nous étions principalement intéressés par le prélèvement SNMP et les agents. Dans "Zabbix", le polling est effectué de manière synchrone et des mesures spéciales ont été prises pour augmenter l'efficacité du système. En mode synchrone, l'indisponibilité des hôtes entraîne une dégradation significative du polling. Un véritable système d'états existe, ainsi que des processus spéciaux – les pollers dit inaccessibles, qui ne fonctionnent qu'avec des hôtes inaccessibles :

Ceci est un commentaire qui montre la matrice des états, toute la complexité des transitions nécessaires pour que le système reste efficace. De plus, le polling synchrone est assez lent :
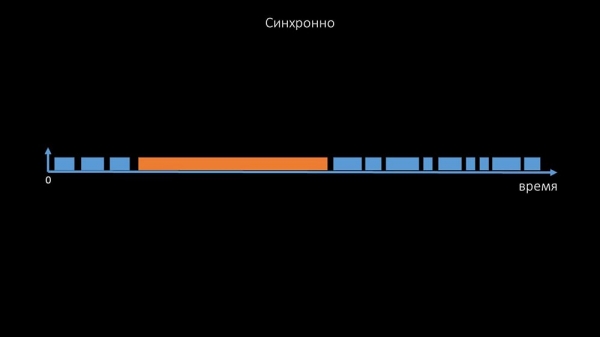
C'est pourquoi des milliers de threads de pollers sur une dizaine de proxy n'ont pas pu collecter le nombre de données dont nous avions besoin. La réalisation asynchrone a non seulement résolu les problèmes de nombre de threads, mais a également simplifié considérablement le système d'états pour les hôtes inaccessibles, car quel que soit le nombre vérifié lors d'une itération de polling, le temps d'attente maximum était d'un timeout :
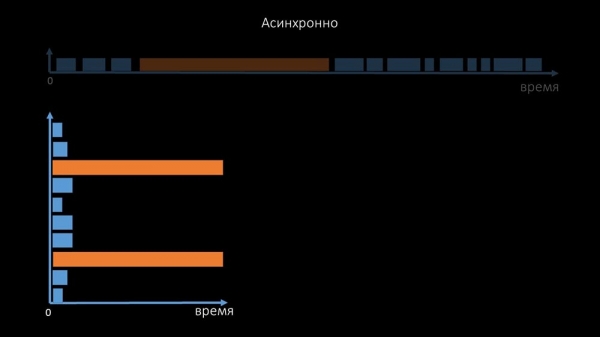
De plus, nous avons modifié et amélioré le système de polling pour les requêtes SNMP. En effet, la plupart ne peuvent pas répondre à plusieurs requêtes SNMP simultanément. C'est pourquoi nous avons créé un mode hybride, où le polling SNMP du même hôte est effectué de manière asynchrone :
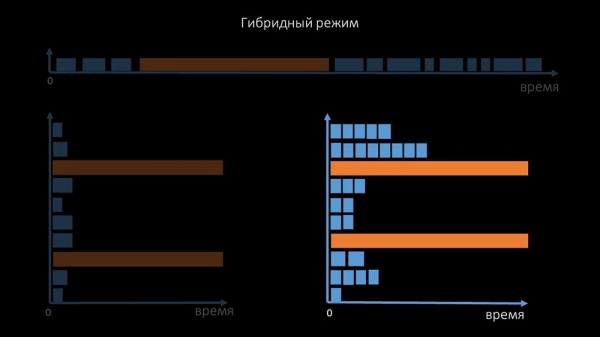
Cela se fait pour l'ensemble d'un lot d'hôtes. Ce mode n'est finalement pas plus lent qu'un mode entièrement asynchrone, car l'interrogation de 150 SNMP valeurs est de toute façon beaucoup plus rapide qu'un timeout.
Nos expériences ont montré que le nombre optimal de requêtes par itération est d'environ 8000 lors du polling SNMP. Au total, le passage au mode asynchrone a permis d'accélérer les performances de polling de 200 fois, plusieurs centaines de fois.
MT: Les optimisations de polling obtenues ont montré que nous pouvons non seulement nous débarrasser de tous les proxies, mais aussi réduire les intervalles pour de nombreux contrôles, rendant les proxies inutiles comme moyen de répartition de la charge.
Il y a environ trois mois
Change l'architecture – augmente la charge !
MM: Eh bien, Max, prêt pour la production ? J'ai besoin d'un puissant serveur et d'un bon ingénieur.
MT: Très bien, planifions-le. Il est temps de sortir du point mort à 5000 métriques par seconde.
Le matin après la mise à niveau
MT: Misha, nous avons mis à jour, mais nous sommes revenus en arrière d'ici le matin... Devine quelle vitesse nous avons réussi à atteindre ?
MM: Environ 20 000 au maximum.
MT: Ah, 25 ! Malheureusement, nous en sommes au même point, là où nous avons commencé.
MM: Pourquoi cela ? Avez-vous fait un diagnostic ?
MT: Oui, bien sûr ! Voici, par exemple, un top intéressant :
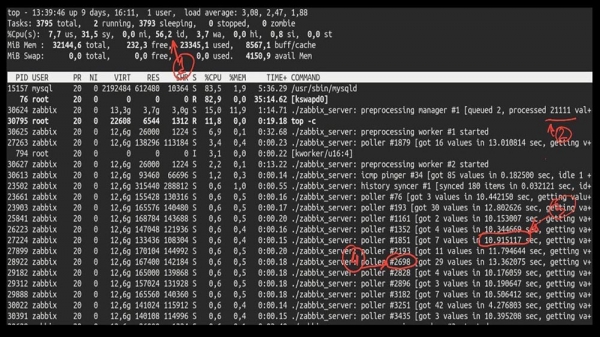
MM: Regardons. Je vois que nous avons essayé un grand nombre de fils de polling :
Mais nous n'avons pas pu utiliser le système même à moitié :
Et la performance globale est assez faible, environ 4 000 métriques par seconde :
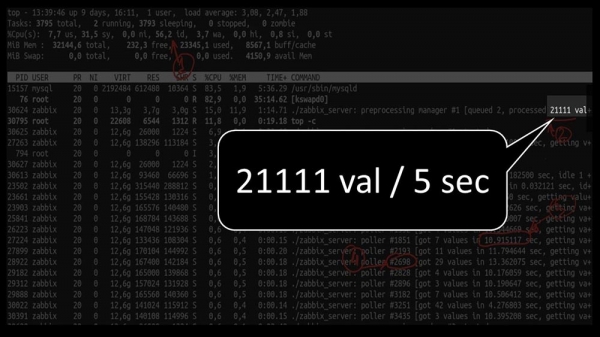
Y a-t-il autre chose ?
MT: Oui, strace d'un des pollers :
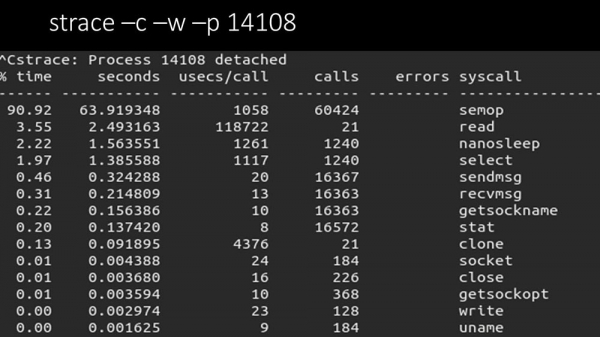
MM: Ici, on voit clairement que le processus de polling attend des « sémaphores ». Ce sont des blocages :
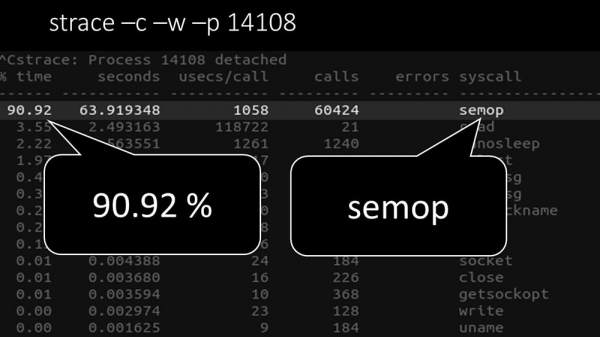
MT: Je ne comprends pas.
MM: Regarde, cela ressemble à une situation où de nombreux fils essaient de travailler avec une ressource avec laquelle une seule personne peut travailler à la fois. Donc, tout ce qu'ils peuvent faire est de partager cette ressource dans le temps :
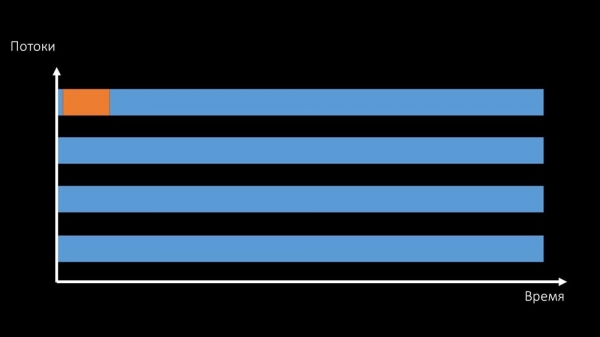
Et la performance totale du travail avec cette ressource est limitée par la vitesse d'un seul cœur :
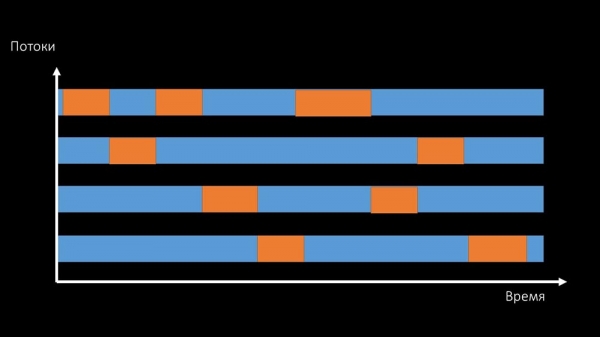
Il existe deux façons de résoudre ce problème.
Mettre à niveau le matériel de la machine, passer à des cœurs plus rapides :
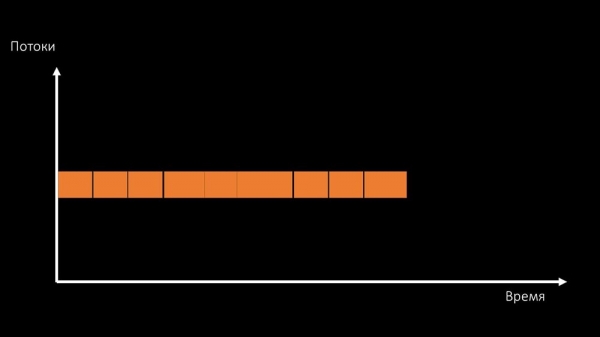
Ou changer l'architecture et parallèlement – la charge :
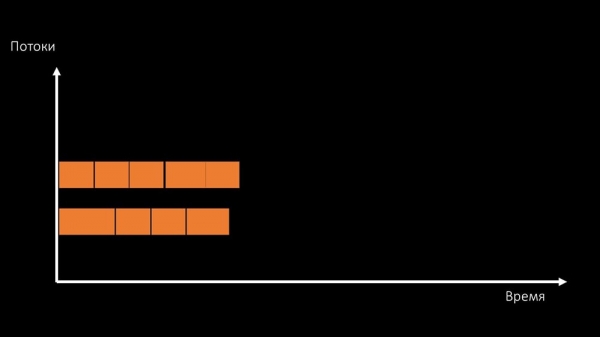
MT: Au fait, sur la machine de test, nous allons utiliser moins de cœurs que sur la production, mais ils sont environ 1,5 fois plus rapides par cœur !
MM: C'est clair ? Il faut examiner le code du serveur.
Le chemin des données dans le serveur Zabbix
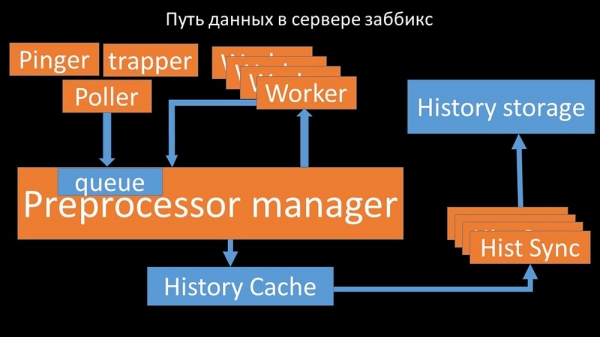
MT: Pour comprendre, nous avons commencé à analyser comment les données sont transmises à l'intérieur du serveur « Zabbix » :
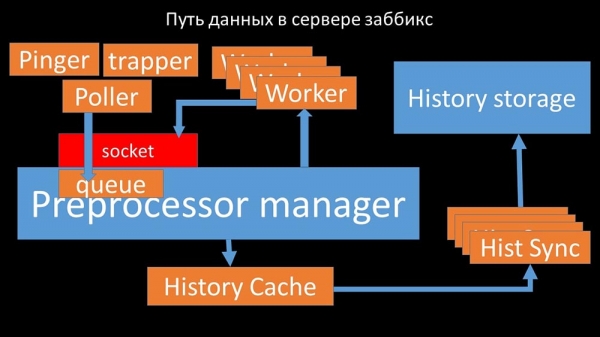
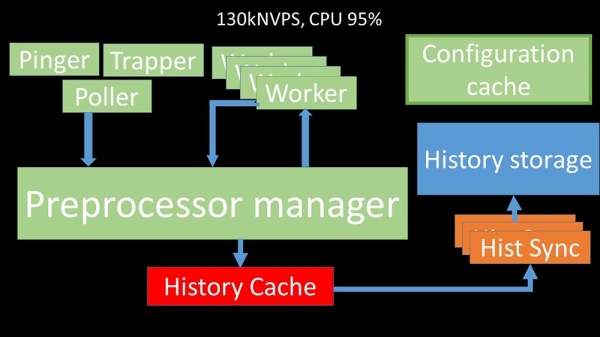
C'est une belle image, n'est-ce pas ? Alors, parcourons-la étape par étape pour éclaircir un peu plus. Il y a des fils et des services responsables de la collecte des données :
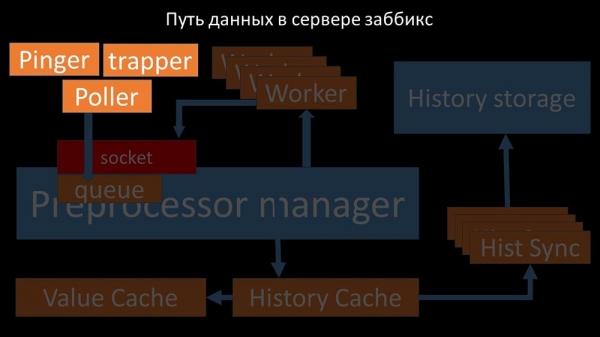
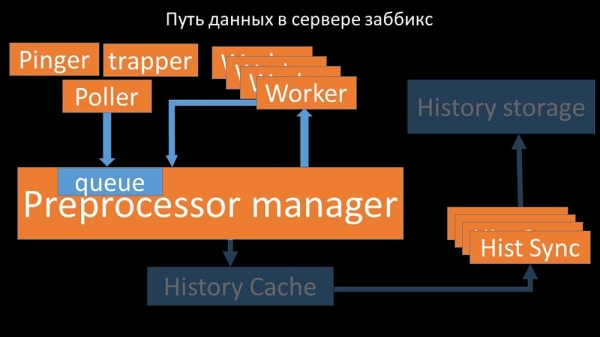
Les métriques collectées sont transmises via un socket au Preprocessor manager, où elles sont stockées dans une file d'attente :
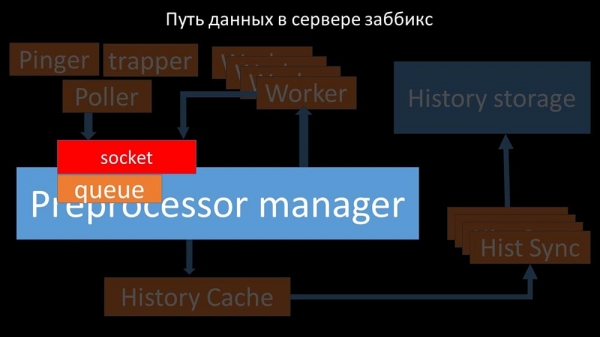
Le « gestionnaire de prétraitement » transmet les données à ses workers, qui exécutent des instructions de prétraitement et les renvoient par le même socket :
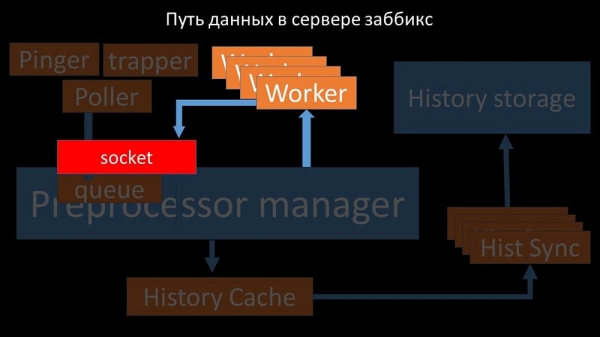
Après cela, le gestionnaire de prétraitement les enregistre dans le cache d'historique:
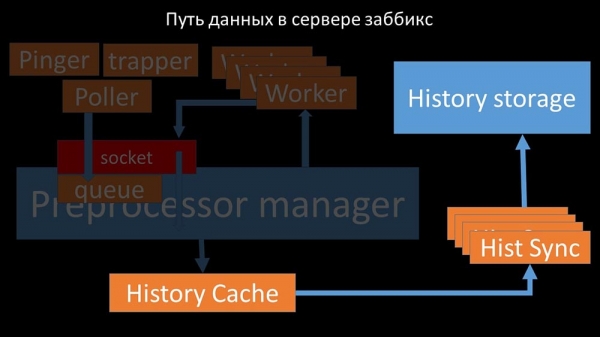
De là, ils sont récupérés par les synchroniseurs d'historique, qui effectuent de nombreuses fonctions, par exemple, le calcul des déclencheurs, le remplissage du cache de valeurs et, surtout, la sauvegarde des métriques dans le stockage d'historique. En général, le processus est complexe et assez confus.
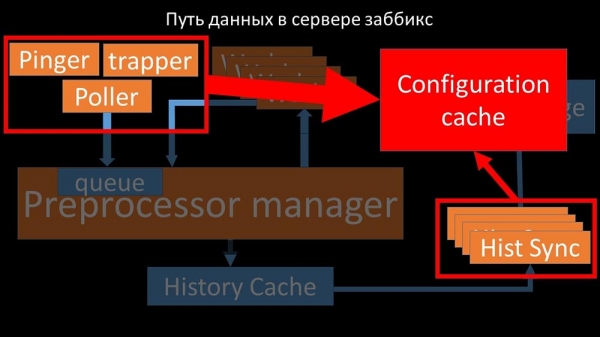
MM: – La première chose que nous avons remarquée est que la plupart des flux rivalisent pour ce qu'on appelle le « cache de configuration » (zone de mémoire où toutes les configurations du serveur sont stockées). Surtout, de nombreux blocages sont causés par les flux responsables de la collecte de données :
…car la configuration contient non seulement des métriques et leurs paramètres, mais aussi des files d'attente dont les pollers tirent des informations sur ce qu'ils doivent faire ensuite. Lorsque les pollers sont nombreux, et qu'un bloque la configuration, les autres attendent des requêtes :
Les pollers ne doivent pas entrer en conflit
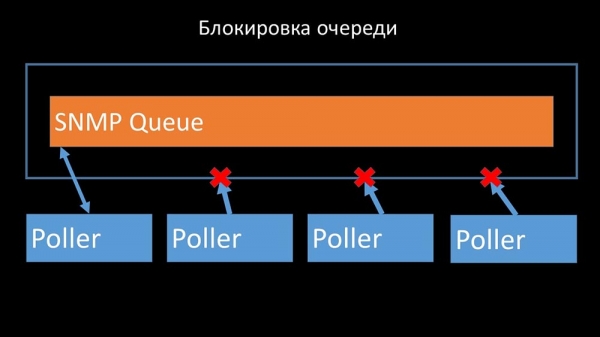
C'est pourquoi la première chose que nous avons faite a été de diviser la file d'attente en 4 parties et de permettre aux pollers de bloquer ces files dans des conditions sûres, ces parties simultanément :
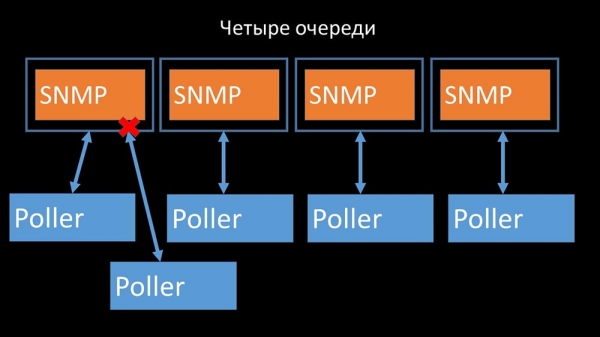
Cela a éliminé la concurrence pour le cache de configuration, et la vitesse de fonctionnement des pollers a considérablement augmenté. Mais ensuite, nous avons rencontré le problème que le gestionnaire de prétraitement avait commencé à accumuler une file d'attente de tâches :
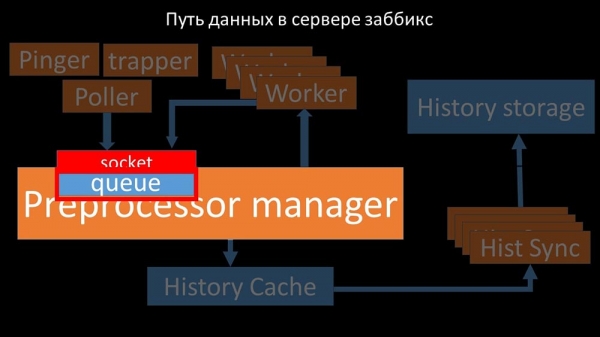
Le gestionnaire de prétraitement doit savoir établir des priorités
Cela se produisait dans les cas où il manquait de performance. Alors, tout ce qu'il pouvait faire était d'accumuler les requêtes des processus de collecte de données et de les stocker dans un tampon jusqu'à ce qu'il ait épuisé toute la mémoire et s'arrête :
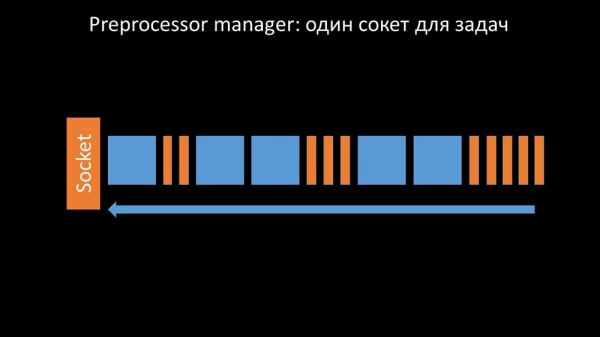
Pour résoudre ce problème, nous avons ajouté un deuxième socket, qui a été spécifiquement attribué aux workers :
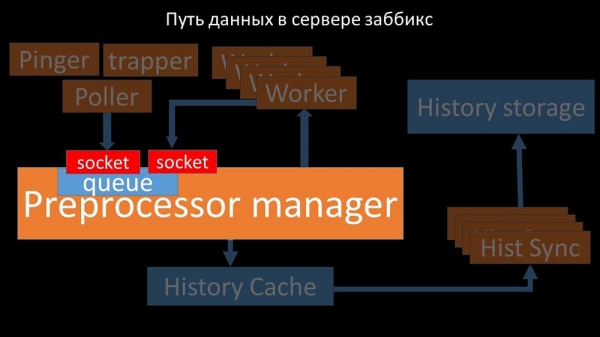
Ainsi, le gestionnaire de prétraitement a eu la possibilité de prioriser son travail et, en cas d'augmentation du tampon, de ralentir la collecte en laissant aux workers la possibilité de récupérer ce tampon :
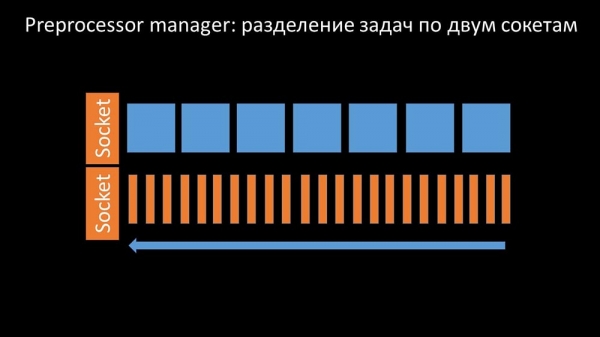
Ensuite, nous avons découvert qu'une des raisons du ralentissement était les workers eux-mêmes, car ils rivalisaient pour une ressource qui n'était pas du tout importante pour leur travail. Ce problème a été corrigé dans un correctif, et dans les nouvelles versions de « Zabbix », il est déjà résolu :
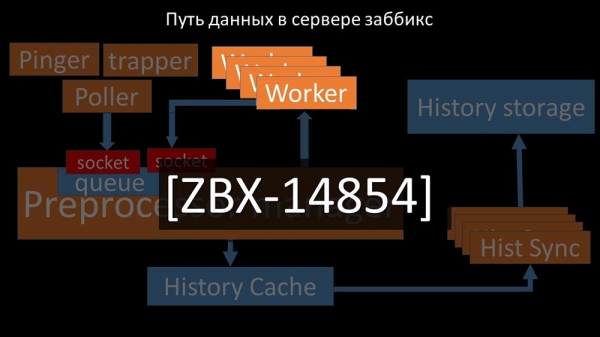
Nous augmentons le nombre de sockets - nous obtenons un résultat
Ensuite, le gestionnaire de prétraitement est devenu un goulot d'étranglement, car c'est un seul thread. Il atteignait la vitesse du noyau, donnant une vitesse maximale d'environ 70 000 métriques par seconde :
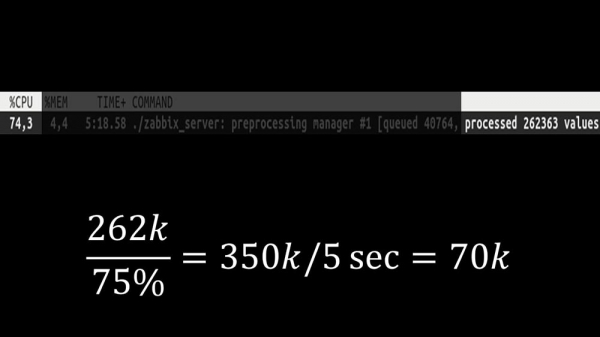
C'est pourquoi nous avons créé quatre ensembles de sockets, de workers :
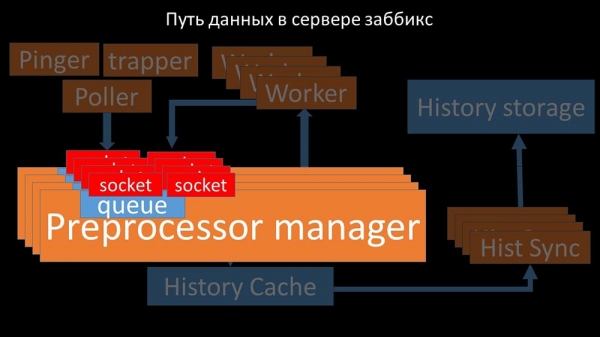
Et cela a permis d'augmenter la vitesse à environ 130 000 métriques :
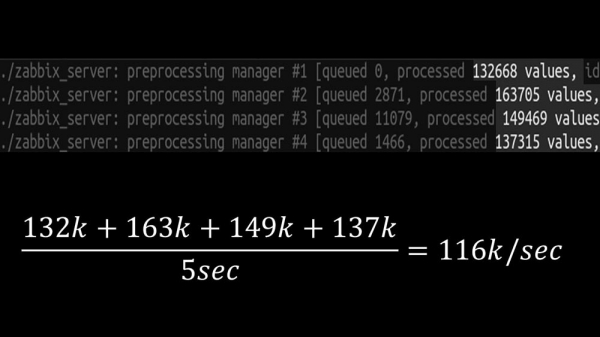
La non-linéarité de la croissance s'explique par le fait qu'il y avait une concurrence pour le cache d'historique. Quatre gestionnaires de prétraitement et des synchronisateurs d'historique concouraient pour cela. À ce moment-là, nous obtenions sur la machine de test environ 130 000 métriques par seconde, en utilisant environ 95 % de son processeur :
Il y a environ 2,5 mois
L'abandon de snmp-community a augmenté les NVPs d'1,5 fois
MM: – Max, j'ai besoin d'une nouvelle machine de test ! On ne peut plus en ajouter dans l'actuelle.
MT: – Que έχουμε maintenant ?
MM: – Actuellement – 130k NVPs et le processeur 'à sa capacité maximum'.
MT: – Wow ! Génial ! Attends, j'ai deux questions. D'après mes calculs, nos besoins sont d'environ 15 à 20 000 métriques par seconde. Pourquoi en avoir plus ?
MM: – J'aimerais finir ce que nous avons commencé. Je veux voir combien nous pouvons tirer de ce système.
MT: – Mais...
MM: – Mais c'est inutile pour l'entreprise.
MT: – Je comprends. Et la deuxième question : ce que nous avons maintenant, pourrons-nous le gérer nous-mêmes, sans l'aide d'un développeur ?
MM: – Je ne pense pas. Modifier le fonctionnement du cache de configuration est un problème. Cela implique des changements dans la plupart des flux et est assez complexe à maintenir. Il est probable qu'il sera très difficile de le soutenir.
MT: – Alors il faut une alternative.
MM: – Il y a cette option. Nous pourrions passer à des noyaux rapides, tout en abandonnant le nouveau système de verrouillage. Nous obtiendrons quand même des performances de 60 à 80 000 métriques. Tout le reste du code pourrait rester. 'ClickHouse', le polling asynchrone fonctionneront. Et cela sera facile à maintenir.
MT: – Excellent ! Je propose qu'on s'arrête là-dessus.
Après l'optimisation de la partie serveur, nous avons enfin pu déployer le nouveau code en production. Nous avons abandonné certaines modifications en faveur du passage à une machine avec des noyaux rapides et de la minimisation des changements dans le code. Nous avons également simplifié la configuration et, dans la mesure du possible, renoncé aux macros dans les éléments de données, car elles sont à l'origine de blocages supplémentaires.
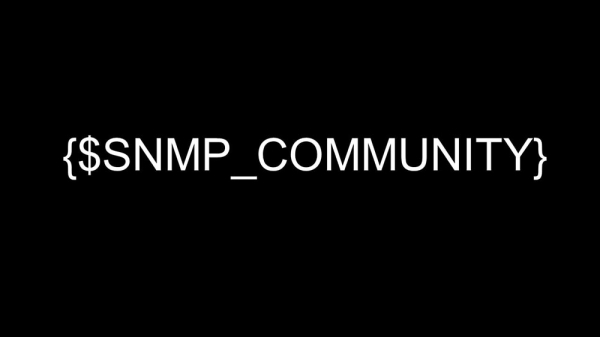
Par exemple, l'abandon du macro snmp-community, souvent utilisé dans la documentation et les exemples, a permis d'accélérer les NVPs d'environ 1,5 fois.
Après deux jours en production
Nous supprimons les fenêtres contextuelles de l'historique des incidents
MT: – Misha, nous utilisons le système depuis deux jours et tout fonctionne. Mais seulement quand tout fonctionne ! Nous avons eu des travaux planifiés avec le transfert d'un segment réseau assez large, et nous avons de nouveau vérifié manuellement ce qui s'est levé et ce qui ne l'est pas.
MM: – Ça ne peut pas être ! Nous avons tout vérifié dix fois. Le serveur gère même l'indisponibilité totale du réseau instantanément.
MT: – Je comprends tout : serveur, base, top, austat, logs – tout est rapide… Mais nous regardons l'interface web, et là – le processeur sur le serveur est en « stand-by » et voici cela :
MM: – D'accord. Regardons le web. Nous avons découvert que, dans des situations où il y avait un grand nombre d'incidents actifs, la plupart des widgets opérationnels commençaient à fonctionner très lentement :
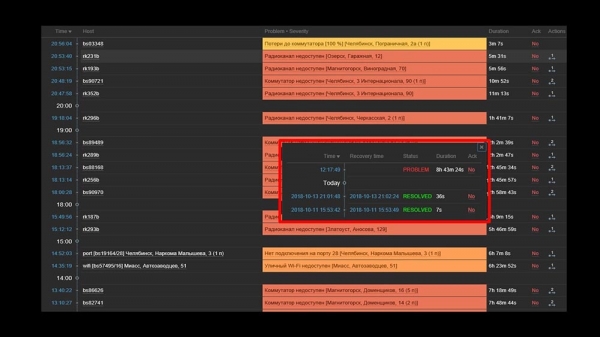
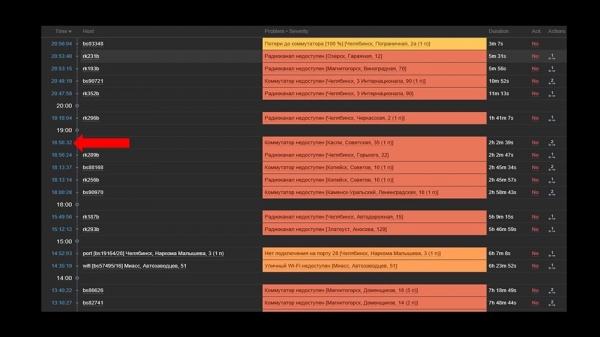
La raison en était la génération de pop-ups avec l'historique des incidents, qui sont générés pour chaque élément de la liste. Nous avons donc abandonné la génération de ces fenêtres (nous avons commenté 5 lignes dans le code), et cela a résolu nos problèmes.
Le temps de chargement des widgets, même en cas d'indisponibilité totale, a été réduit de plusieurs minutes à 10-15 secondes qui nous conviennent, et l'historique peut toujours être consulté en cliquant sur le temps :
Après le travail. Il y a 2 mois.
MT: – Misha, tu pars ? J'ai quelque chose à te dire.
MM: – Je ne prévoyais pas. Encore quelque chose avec « Zabbix » ?
MT: – Non, détends-toi ! Je voulais juste dire : tout fonctionne, merci ! Je t'invite à une bière.
Zabbix est efficace
« Zabbix » est un système assez universel et riche en fonctionnalités. Il peut tout à fait être utilisé pour de petites installations « prêtes à l'emploi », mais avec l'augmentation des besoins, il faut l'optimiser. Pour stocker un grand volume d'archives de métriques, utilisez un stockage adapté :
- vous pouvez utiliser les outils intégrés sous forme d'intégration avec « Elasticsearch » ou d'exportation de l'historique vers des fichiers texte (disponible à partir de la quatrième version) ;
- vous pouvez tirer parti de notre expérience et de l'intégration avec « ClickHouse ».
Pour augmenter radicalement la vitesse de collecte des métriques, collectez-les par des méthodes asynchrones et transmettez-les via l'interface trapper au serveur « Zabbix » ; ou vous pouvez utiliser un patch pour l'asynchronisme des pollers de « Zabbix » lui-même.
Zabbix est écrit en C et est assez efficace. Toutefois, la résolution de quelques points d'architecture étroits permet d'augmenter encore sa performance et, d'après notre expérience, d'obtenir plus de 100 000 métriques sur une machine à un processeur.
Le patch Zabbix
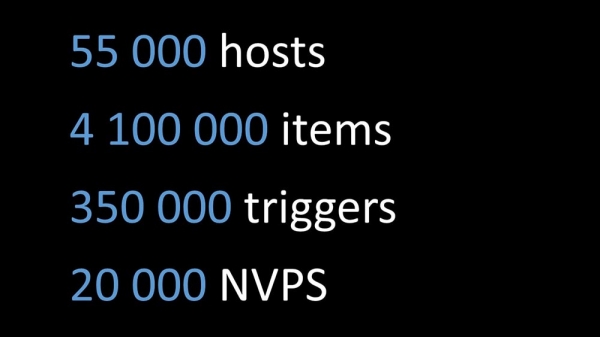
MM: – Je veux ajouter quelques points. Tous les rapports actuels, tous les tests, les chiffres sont basés sur la configuration que nous utilisons. Actuellement, nous recueillons environ 20 000 métriques par seconde. Si vous essayez de comprendre si cela fonctionnera pour vous, vous pouvez comparer. Ce qui a été présenté aujourd'hui est disponible sur GitHub sous forme de patch :
Le patch inclut :
- une intégration complète avec ClickHouse (pour le serveur Zabbix et le frontend) ;
- la résolution de problèmes avec le gestionnaire de préprocesseur ;
- le polling asynchrone.
Le patch est compatible avec toute la version 4, y compris la version lts. Il fonctionnera probablement sur la version 3.4 avec des modifications minimales.
Merci pour votre attention.
Questions
Question du public (A) : – Bonjour ! Pouvez-vous dire si vous avez des plans d'interaction intensive avec l'équipe de Zabbix ou eux avec vous, afin que ce ne soit pas un patch, mais un comportement normal de Zabbix ?
MM: – Oui, certaines modifications seront nécessairement intégrées. Certaines choses resteront dans le patch.
A: – Merci beaucoup pour cette excellente présentation ! Pouvez-vous nous dire, après l'application du patch, le support de Zabbix restera-t-il en place et comment se mettre à jour vers des versions plus récentes ? Y aura-t-il une possibilité de mettre à jour Zabbix après votre patch vers 4.2, 5.0 ?
MM: – En ce qui concerne le support, je ne peux pas dire. Si j’étais le support technique de Zabbix, je dirais probablement non, car c’est du code tiers. Concernant la base de code 4.2, notre position est la suivante : « Nous allons avancer avec le temps et nous mettrons à jour vers la prochaine version ». Donc, pendant un certain temps, nous publierons des patches pour les versions mises à jour. J'ai déjà mentionné dans la présentation : le nombre de changements avec les versions est encore relativement faible. Je pense que la transition de 3.4 à 4 a pris, il me semble, environ 15 minutes. Il s'est passé quelque chose, mais ce n'est pas très important.
A: – Donc vous prévoyez de maintenir votre patch et il est possible de l'installer en production, en recevant par la suite des mises à jour d'une manière ou d'une autre ?
MM: – Nous le recommandons catégoriquement. Cela résout beaucoup de nos problèmes.
MT: – Je voudrais encore une fois insister sur le fait que les modifications qui ne concernent pas l'architecture et ne concernent pas les blocages, les files d'attente – elles sont modulaires, elles sont dans des modules distincts. Même de manière autonome, avec des modifications mineures, elles peuvent être maintenues assez facilement.
MM: – Si vous êtes intéressé par les détails, alors « ClickHouse » utilise ce qu'on appelle une bibliothèque d'historique. Elle est déliée – c'est une copie de la prise en charge d'« Elasticsearch », c'est-à-dire qu'elle est modifiable en configuration. Le polling ne change que les pollers. Nous croyons que cela va fonctionner longtemps.
A: – Merci beaucoup. Pouvez-vous me dire s'il existe une documentation des modifications apportées ?
MM: – La documentation est le patch. Évidemment, avec l'introduction de « ClickHouse », et l'introduction de nouveaux types de pollers, de nouvelles options de configuration apparaissent. Le lien dans la dernière diapositive contient une brève description de son utilisation.
Concernant le remplacement de fping par nmap
A: – Comment avez-vous finalement réalisé cela ? Pouvez-vous donner des exemples concrets : avez-vous des strappers et un script externe ? Qu'est-ce qui vérifie si rapidement autant d'hôtes ? Comment obtenez-vous ces hôtes ? Faut-il les fournir à nmap d'une manière ou d'une autre, les récupérer d'une source, les placer, exécuter quelque chose ?
MM: – Génial. Très bonne question ! L'idée est la suivante. Nous avons modifié la bibliothèque (ICMP-ping, une composante de « Zabbix ») pour les vérifications ICMP, où il est spécifié que le nombre de paquets est une unité (1), et le code essaie d'utiliser nmap. Donc, c'est le fonctionnement interne de « Zabbix », cela est devenu le travail interne du pingeur. Par conséquent, aucune synchronisation ou utilisation de trap ne sont nécessaires. Cela a été fait délibérément pour garder le système intégral et ne pas se soucier de la synchronisation de deux systèmes de bases : quoi vérifier, le verser par le poller, et vérifier si le versement a échoué ?.. C'est beaucoup plus simple.
A: – Cela fonctionne-t-il aussi pour les proxies ?
MM: – Oui, mais nous n'avons pas vérifié. Le code de polling est identique dans « Zabbix » et sur le serveur. Cela devrait fonctionner. Je réitère : la performance du système est telle que nous n'avons pas besoin de proxy.
MT: – La bonne réponse à la question est : « Pourquoi avez-vous besoin de proxy dans un tel système ? » Seulement à cause du NAT ou pour surveiller via un canal lent...
A: – Utilisez-vous « Zabbix » comme alerteur, si j'ai bien compris. Ou vos graphiques (où la couche d'archives) sont-ils allés dans un autre système, comme Grafana ? Ou n'utilisez-vous pas cette fonctionnalité ?
MM: – Je le souligne encore une fois : nous avons réalisé une intégration complète. Nous transférons l'historique dans « ClickHouse », mais nous avons également modifié le frontend PHP. Le frontend PHP interroge « ClickHouse » et génère tous les graphiques à partir de là. En toute honnêteté, nous avons une partie qui génère des données dans d'autres systèmes de représentation graphique à partir des mêmes données de « Zabbix » venant de « ClickHouse ».
MT: – Y compris dans « Grafana ».
Comment la décision a-t-elle été prise concernant l'allocation des ressources ?
A: – Partagez un peu la cuisine interne. Comment la décision a-t-elle été prise de consacrer des ressources à une refonte sérieuse du produit ? Cela représente en fait des risques spécifiques. Et dites, s'il vous plaît, dans le contexte de ce que vous comptez faire pour maintenir les nouvelles versions : comment cette décision est-elle justifiée du point de vue de la gestion ?
MM: – Il semble que nous n'ayons pas très bien raconté le drame de l'histoire. Nous nous sommes retrouvés dans une situation où il fallait agir, et nous avons en fait suivi deux équipes parallèles :
- L'une s'occupait du lancement du système de surveillance avec de nouvelles méthodes : la surveillance comme service, ensemble standard de solutions open source, que nous combinons et essayons ensuite d'adapter le processus métier pour travailler avec le nouveau système de surveillance.
- En parallèle, nous avions un programmeur enthousiaste qui s'occupait de cela (de lui-même). Il se trouve qu'il a gagné.
A: – Quelle est la taille de l'équipe ?
MT: – Elle est devant vous.
A: – Donc, comme toujours, il faut un passionné ?
MM: – Je ne sais pas ce qu'est un passionné.
A: – Dans ce cas, apparemment, vous. Merci beaucoup, vous êtes formidables.
MM: – Merci.
Sur les patchs pour Zabbix
A: – Pour un système qui utilise des proxies (par exemple, dans certains systèmes distribués), est-il possible d'adapter votre solution et de patcher, disons, les pollers, les proxies et partiellement le préprocesseur de Zabbix lui-même ; et leur interaction ? Est-il possible d'optimiser les développements existants pour un système avec plusieurs proxies ?
MM: – Je sais que le serveur « Zabbix » est construit avec l'aide de proxies (il est compilé et le code est obtenu). Nous ne l'avons pas vérifié en production. Je ne suis pas sûr de cela, mais je pense que le gestionnaire de prétraitement n'est pas utilisé dans le proxy. La tâche du proxy est de prendre un ensemble de métriques provenant de « Zabbix », de les récupérer (il enregistre aussi la configuration, la base locale) et de les renvoyer au serveur « Zabbix ». Le prétraitement sera effectué par le serveur lui-même, une fois qu'il l'aura reçu.
L'intérêt pour les proxies est compréhensible. Nous allons examiner cela. C'est un sujet intéressant.
A: – L'idée était la suivante : si l'on peut patcher les pollers, on peut les patcher pour les proxies et adapter l'interaction avec le serveur, le préprocesseur n'étant que sur le serveur.
MM: – Je pense que c'est même plus simple. Vous prenez le code, vous appliquez le patch, puis vous le configurez comme vous le souhaitez – vous assemblez des serveurs proxy (par exemple, avec ODBC) et déployez le code patché dans les systèmes. Là où c'est nécessaire, vous assemblez des proxies, là où c'est nécessaire, des serveurs.
A: – Il ne sera probablement pas nécessaire de patcher davantage le transfert des proxies vers le serveur ?
MT: – Non, c'est standard.
MM: – En fait, l'une des idées n'a pas été éprouvée. Nous avons toujours veillé à maintenir un équilibre entre l'explosion d'idées et le nombre de changements, ainsi que la facilité de maintenance.
Un peu de publicité 🙂
Merci de rester avec nous. Aimez-vous nos articles ? Voulez-vous voir plus de contenu intéressant ? Soutenez-nous en passants une commande ou en nous recommandant à des amis, , un équivalent unique des serveurs d'entrée de gamme, conçu pour vous : (options disponibles avec RAID1 et RAID10, jusqu'à 24 cœurs et jusqu'à 40 Go DDR4).
Dell R730xd deux fois moins cher dans le data center Equinix Tier IV à Amsterdam ? Uniquement chez nous aux Pays-Bas ! Dell R420 — 2x E5-2430 2.2GHz 6C 128Go DDR3 2x960Go SSD 1Gbps 100To — à partir de 99 $ ! Lisez sur
Source : habr.com
