

Je vous invite à découvrir la transcription de la présentation d'Alexey Lesovski de Data Egret "Principes de la surveillance de PostgreSQL"
Dans cette présentation, Alexey Lesovski abordera les points clés de la statistique PostgreSQL, ce qu'ils signifient et pourquoi ils doivent être présents dans la surveillance ; il expliquera les graphiques nécessaires à la surveillance, comment les ajouter et comment les interpréter. Cette présentation sera utile aux administrateurs de bases de données, aux administrateurs système et aux développeurs intéressés par le dépannage de PostgreSQL.
Je m'appelle Alexey Lesovski, je représente la société Data Egret.
Quelques mots sur moi. J'ai commencé il y a longtemps en tant qu'administrateur système.
J'ai administré divers systèmes Linux, travaillé sur différentes tâches liées à Linux, c'est-à-dire la virtualisation, la surveillance, j'ai travaillé avec des proxys, etc. Mais à un moment donné, je me suis tourné vers les bases de données, PostgreSQL. J'ai beaucoup aimé ce système. Et petit à petit, je me suis consacré à PostgreSQL la majeure partie de mon temps de travail. Ainsi, progressivement, je suis devenu DBA PostgreSQL.
Tout au long de ma carrière, j'ai toujours été intéressé par les thèmes de la statistique, de la surveillance, et de la collecte de télémétrie. Lorsque j'étais administrateur système, j'ai travaillé de près sur Zabbix. J'ai écrit un petit ensemble de scripts comme . Il était assez populaire à l'époque. On pouvait y surveiller de nombreuses choses importantes, pas seulement Linux, mais aussi différents composants.
Maintenant, je me concentre sur PostgreSQL. J'écris un autre outil qui permet de travailler avec la statistique PostgreSQL. Il s'appelle (article sur Habr — ).
Une brève introduction. Quelles sont les situations que rencontrent nos clients ? Un incident survient dans la base de données. Et une fois que la base de données est restaurée, le responsable ou le chef de développement arrive et dit : « Les amis, il nous faut surveiller la base de données, car quelque chose de grave s'est produit et nous devons éviter que cela ne se reproduise à l'avenir ». C'est alors que commence un intéressant processus de sélection d'un système de surveillance ou d'adaptation du système de surveillance existant pour pouvoir monitorer sa base de données – PostgreSQL, MySQL ou d'autres. Les collègues commencent à suggérer : « J'ai entendu parler d'une telle base de données. Utilisons-la ». Les collègues commencent à débattre. En fin de compte, nous choisissons une base de données, mais la surveillance de PostgreSQL est plutôt limitée et il est toujours nécessaire de faire des ajustements. Il faut récupérer des dépôts depuis GitHub, les cloner, adapter les scripts, faire des réglages. Finalement, cela se traduit par un travail manuel.
Dans cette présentation, je vais essayer de vous fournir des connaissances sur la façon de choisir un système de surveillance non seulement pour PostgreSQL, mais aussi pour d'autres bases de données. Et donner les informations qui vous permettront d'améliorer votre surveillance, afin d'en retirer une certaine utilité, pour suivre votre base de données de manière efficace, afin de prévenir à temps des situations d'urgence potentielles qui pourraient survenir.
Les idées que je vais présenter dans ce rapport peuvent être directement adaptées à n'importe quelle base de données, qu'il s'agisse d'un SGBD ou d'une base noSQL. Ainsi, il ne s'agit pas seulement de PostgreSQL, mais il y aura de nombreuses recettes sur la manière d'opérer sur PostgreSQL. Des exemples de requêtes, des exemples d'entités disponibles dans PostgreSQL pour la surveillance. Et si votre SGBD dispose de fonctionnalités similaires qui vous permettent de les intégrer dans la surveillance, vous pouvez également les adapter, les ajouter et cela fonctionnera bien.
 Dans cette présentation, je ne vais pas
parler de la façon de collecter et de stocker des métriques. Je ne vais pas aborder la post-traitement des données et la présentation à l'utilisateur. Et je ne vais pas parler d'alerte.
Au fil de la narration, je vais montrer différents exemples de surveillance, et je vais les critiquer d'une manière ou d'une autre. Néanmoins, je vais essayer de ne pas nommer de marques pour ne pas faire de la publicité ou de l'anti-publicité à ces produits. Par conséquent, toute coïncidence est purement fortuite et laisse place à votre imagination.
Commençons par comprendre ce qu'est la surveillance. La surveillance est quelque chose de très important à avoir. Tout le monde le comprend. Mais en même temps, la surveillance n'est pas considérée comme un produit commercial et n'affecte pas directement les bénéfices de l'entreprise, c'est pourquoi on y consacre du temps de manière résiduelle. Si nous avons du temps, nous faisons de la surveillance ; si nous n'en avons pas, tant pis, nous mettrons cela dans notre backlog et reviendrons à ces tâches un jour.
Ainsi, d'après notre expérience, lorsque nous arrivons chez nos clients, la surveillance est souvent sous-développée et ne contient pas les éléments intéressants qui pourraient nous aider à travailler mieux avec la base de données. C'est pourquoi la surveillance doit toujours être améliorée.
Les bases de données sont des systèmes complexes qui doivent également être surveillés, car elles constituent un référentiel d'informations. Ces informations sont extrêmement importantes pour l'entreprise et ne doivent pas être perdues. Cependant, les bases de données sont également des morceaux de logiciels très complexes. Elles se composent de nombreux composants, dont beaucoup doivent être surveillés.
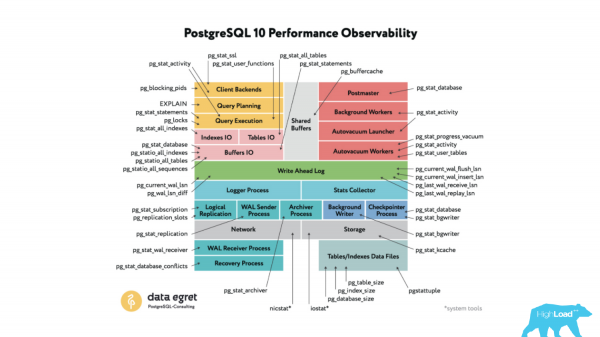 Si nous parlons spécifiquement de PostgreSQL, nous pouvons le représenter sous la forme d'un schéma composé de nombreux composants. Ces composants interagissent entre eux. En même temps, PostgreSQL dispose d'un sous-système appelé Stats Collector, qui permet de collecter des statistiques sur le fonctionnement de ces sous-systèmes et de fournir une interface à l'administrateur ou à l'utilisateur pour qu'il puisse consulter ces statistiques.
Ces statistiques sont présentées sous la forme d'un ensemble de fonctions et de vues. On peut également les appeler des tables. C'est-à-dire qu'avec un client psql classique, vous pouvez vous connecter à la base de données, faire une sélection sur ces fonctions et vues, et obtenir des chiffres spécifiques sur le fonctionnement des sous-systèmes de PostgreSQL.
Vous pouvez intégrer ces chiffres dans votre système de surveillance préféré, créer des graphiques, ajouter des fonctions et obtenir des analyses à long terme.
Cependant, dans ce rapport, je ne vais pas examiner toutes ces fonctions en détail, car cela pourrait prendre une journée entière. Je vais aborder littéralement deux à quatre éléments et expliquer comment ils aident à améliorer la surveillance.
Et en parlant de la surveillance de la base de données, que faut-il surveiller ? En premier lieu, il est essentiel de surveiller la disponibilité, car la base est un service qui fournit un accès aux données pour les clients, et nous devons surveiller la disponibilité, ainsi que certaines de ses caractéristiques qualitatives et quantitatives.
Il est également nécessaire de surveiller les clients qui se connectent à notre base de données, car ils peuvent être à la fois des clients normaux ou des clients nuisibles qui pourraient nuire à la base de données. Ils doivent également être surveillés et leur activité suivie.
Lorsque les clients se connectent à la base de données, il est évident qu'ils commencent à travailler avec nos données. Nous devons donc surveiller comment les clients interagissent avec les données : avec quelles tables, et dans une moindre mesure, avec quels index. En d'autres termes, nous devons évaluer la charge de travail (workload) générée par nos clients.
Mais cette charge de travail consiste évidemment en des requêtes. Les applications se connectent à la base de données et accèdent aux données via des requêtes, il est donc important d'évaluer les requêtes dans notre base de données, de suivre leur pertinence pour s'assurer qu'elles ne sont pas mal écrites, et que certaines options doivent être réécrites pour fonctionner plus rapidement et de manière plus performante.
Et puisque nous parlons de base de données, il est important de noter que la base de données est toujours accompagnée de processus en arrière-plan. Ces processus en arrière-plan permettent de maintenir la performance de la base de données à un bon niveau, et pour fonctionner, ils nécessitent une certaine quantité de ressources. En même temps, ils peuvent entrer en conflit avec les ressources des requêtes clients, donc un fonctionnement gourmand des processus en arrière-plan peut directement affecter la performance des requêtes des clients. Par conséquent, ils doivent également être surveillés et il faut s'assurer qu'il n'y a pas de déséquilibres concernant les processus en arrière-plan.
Toutes les informations concernant la surveillance de la base de données restent dans les métriques systèmes. Cependant, étant donné que notre infrastructure est principalement migrée vers le cloud, les métriques systèmes d'un hôte individuel passent souvent au second plan. Pourtant, elles restent pertinentes pour les bases de données, et il est également nécessaire de surveiller ces métriques systèmes.
Les métriques systèmes sont globalement bien couvertes, toutes les systèmes de surveillance modernes les prennent en charge. Toutefois, certaines composantes restent insuffisantes et il est nécessaire d'ajouter certaines informations. J'aborderai également ce sujet, quelques diapositives seront consacrées à cela.
Le premier point du plan est la disponibilité. Qu'est-ce que la disponibilité ? À mon avis, la disponibilité se réfère à la capacité d'une base de données à traiter des connexions, c'est-à-dire que la base est opérationnelle et accepte les connexions des clients. On peut évaluer cette disponibilité à l'aide de certaines caractéristiques. Ces caractéristiques sont très pratiques à afficher sur des tableaux de bord.
Tout le monde sait ce que sont des tableaux de bord. C'est lorsque vous jetez un œil à l'écran où les informations nécessaires sont centralisées. Vous pouvez immédiatement déterminer s'il y a un problème dans la base ou non.
Il est donc essentiel d'afficher la disponibilité de la base de données ainsi que d'autres caractéristiques clés sur des tableaux de bord, afin que ces informations soient à portée de main, toujours à votre disposition. Certains détails supplémentaires, qui aident lors d'enquêtes d'incidents ou de situations d'urgence, doivent plutôt être affichés sur des sous-tableaux de bord, ou dissimulés dans des liens de drilldown menant à d'autres systèmes de surveillance.
Voici un exemple d'un système de surveillance bien connu. C'est un système de surveillance très performant. Il collecte une multitude de données, mais à mon sens, il a une conception étrange des tableaux de bord. Il y a un lien « créer un tableau de bord ». Toutefois, lorsque vous créez un tableau de bord, vous réalisez une sorte de liste composée de deux colonnes, une liste de graphiques. Lorsque vous avez besoin de consulter quelque chose, vous commencez à cliquer, à faire défiler, à chercher le graphique souhaité. Cela prend du temps, c'est-à-dire qu'il n'y a pas de véritables tableaux de bord. Il n'y a que des listes de graphiques.
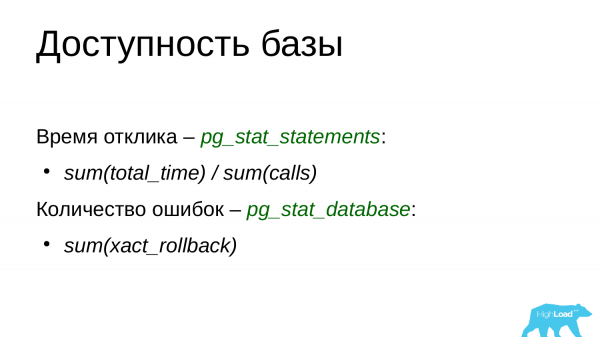
Que faut-il ajouter à ces tableaux de bord ? On peut commencer par une caractéristique telle que le temps de réponse. Dans PostgreSQL, il existe une vue pg_stat_statements. Par défaut, elle est désactivée, mais c'est l'une des vues système importantes qui doit toujours être activée et utilisée. Elle contient des informations sur toutes les requêtes exécutées dans la base de données.
Nous pouvons donc partir du principe que nous pouvons prendre le temps total d'exécution de toutes les requêtes et le diviser par le nombre de requêtes à l'aide des champs mentionnés ci-dessus. Mais cela représente une température moyenne à l'hôpital. Nous pouvons nous baser sur d'autres champs - le temps d'exécution minimum, maximum et médian. Nous pouvons même construire des percentiles, puisque PostgreSQL dispose de fonctions correspondantes à cet effet. Ainsi, nous pouvons obtenir des chiffres qui caractérisent le temps de réponse de notre base sur les requêtes déjà exécutées, c'est-à-dire que nous n'exécutons pas une requête fictive 'select 1' et ne regardons pas le temps de réponse, mais nous analysons le temps de réponse des requêtes déjà exécutées et nous traçons soit un chiffre distinct, soit un graphique.
Il est également important de suivre le nombre d'erreurs générées par le système à l'heure actuelle. Pour cela, on peut utiliser la vue pg_stat_database. Nous nous concentrons sur le champ xact_rollback. Ce champ montre non seulement le nombre de rollbacks se produisant dans la base, mais prend également en compte le nombre d'erreurs. Pour dire les choses simplement, nous pouvons afficher ce chiffre sur notre tableau de bord et voir combien d'erreurs nous avons en ce moment. Si le nombre d'erreurs est élevé, c'est déjà une bonne raison d'examiner les journaux et de voir quelles sont ces erreurs et pourquoi elles se produisent, puis d'investiguer et de résoudre le problème.
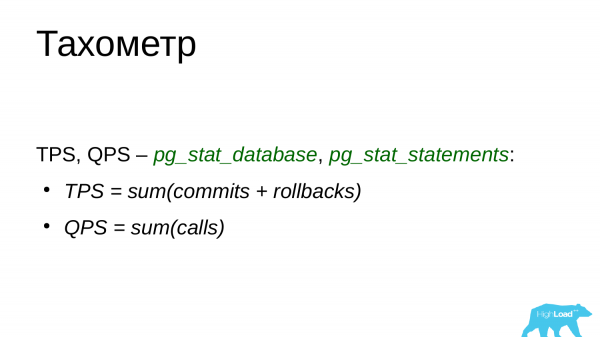
On peut ajouter quelque chose comme un tachymètre. C'est le nombre de transactions par seconde et le nombre de requêtes par seconde. En d'autres termes, vous pouvez utiliser ces chiffres comme performance actuelle de votre base de données et observer s'il y a des pics de requêtes, des pics de transactions ou, au contraire, si la base est sous-utilisée parce qu'un certains backends sont tombés en panne. Ce chiffre est toujours important à surveiller et il faut se rappeler que, pour notre projet, une telle performance est considérée comme normale, tandis que des valeurs plus élevées ou plus basses sont problématiques et difficiles à comprendre, ce qui signifie qu'il faut examiner pourquoi ces chiffres sont là.
Pour évaluer le nombre de transactions, nous pouvons à nouveau nous tourner vers la vue pg_stat_database. Nous pouvons additionner le nombre de commits et le nombre de rollbacks pour obtenir le nombre de transactions par seconde.
Tout le monde comprend qu'une transaction peut comprendre plusieurs requêtes ? C'est pourquoi le TPS et le QPS sont légèrement différents.
Le nombre de requêtes par seconde peut être obtenu via pg_stat_statements en faisant simplement la somme de toutes les requêtes exécutées. Il est clair que nous comparons la valeur actuelle avec la précédente, nous soustrayons, nous obtenons la différence, et ainsi le nombre.
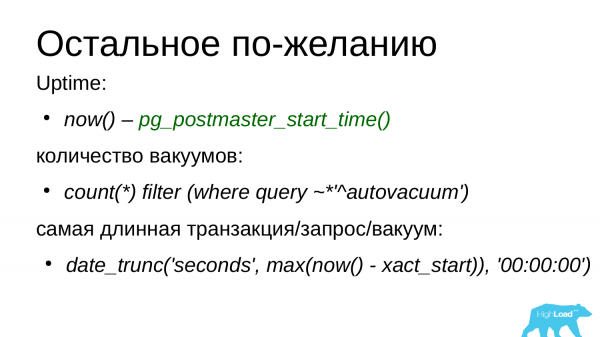
Il est possible d'ajouter d'autres métriques si voulu, qui aident également à évaluer la disponibilité de notre base de données et à suivre les périodes de downtime.
L'une de ces métriques est le uptime. Mais le uptime dans PostgreSQL est un peu un sujet délicat. Voici pourquoi. Lorsque PostgreSQL est lancé, le uptime commence à être compté. Mais si à un moment donné, par exemple la nuit, une tâche est exécutée, et que l'OOM-killer termine de force un processus fils de PostgreSQL, dans ce cas PostgreSQL ferme les connexions de tous les clients, vide l'espace de mémoire shardée et commence la récupération depuis le dernier point de contrôle. Et tant que cette récupération depuis le point de contrôle dure, la base n'accepte pas de connexions, c'est-à-dire que cette situation peut être considérée comme un downtime. Cependant, le compteur de uptime ne se réinitialisera pas, car il prend en compte le temps depuis le premier moment du démarrage du postmaster. Donc, ces situations peuvent être négligées.
Il convient également de surveiller le nombre de workers de vacuum. Tout le monde sait ce qu'est l'autovacuum dans PostgreSQL ? C'est un sous-système intéressant dans PostgreSQL. Beaucoup d'articles ont été écrits à son sujet, de nombreuses présentations ont été faites. Il y a beaucoup de discussions sur le vacuum, sur son fonctionnement. Beaucoup le considèrent comme un mal inévitable. Mais c'est le cas. C'est un équivalent du ramasseur de déchets, qui nettoie les anciennes versions de lignes qui ne sont nécessaires à aucune des transactions et libère de l'espace dans les tables et les index pour de nouvelles lignes.
Pourquoi faut-il le surveiller ? Parce que le vacuum peut parfois causer beaucoup de douleur. Il consomme une grande quantité de ressources et les requêtes clients en souffrent.
Il convient de le surveiller via la vue pg_stat_activity, dont je vais parler dans la section suivante. Cette vue montre l'activité actuelle dans la base de données. Grâce à cette activité, nous pouvons suivre le nombre de processus de vide qui fonctionnent en ce moment. Nous pouvons surveiller les processus de vide et constater que si nous dépassons la limite, cela nous incite à examiner les paramètres de PostgreSQL et à optimiser le fonctionnement du vide.
Une autre caractéristique de PostgreSQL est que le système souffre considérablement des longues transactions. Surtout, des transactions qui restent ouvertes sans rien faire. Ce sont ce que l'on appelle des stat idle-in-transaction. Une telle transaction maintient des verrouillages, elle empêche le processus de vide de fonctionner. Par conséquent, les tables gonflent et augmentent en taille. Les requêtes qui traitent ces tables commencent alors à fonctionner plus lentement, car il faut triompher toutes les anciennes versions des lignes de la mémoire vers le disque et vice versa. Par conséquent, il est également nécessaire de surveiller la durée des transactions les plus longues, des requêtes de vide les plus longues. Et si nous voyons des processus qui fonctionnent déjà très longtemps, plus de 10-20-30 minutes pour une charge OLTP, il faut y prêter attention et les terminer de force, ou optimiser l'application pour qu'elles ne soient pas appelées et ne restent pas suspendues si longtemps. Pour une charge analytique, 10-20-30 minutes, c'est normal, il peut même y en avoir de plus longues.
Ensuite, nous avons la possibilité de voir les clients connectés. Une fois que nous avons formé le tableau de bord et affiché les indicateurs clés de disponibilité, nous pouvons également ajouter des informations complémentaires sur les clients connectés.
Les informations sur les clients connectés sont importantes, car, du point de vue de PostgreSQL, les clients peuvent être différents. Il y a de bons clients et de mauvais clients.
Un exemple simple. Par client, j'entends une application. L'application s'est connectée à la base de données et commence immédiatement à y envoyer ses requêtes, la base de données les traite et les exécute, et renvoie les résultats au client. Ce sont de bons et de bons clients.
Il arrive que le client se connecte, maintienne la connexion, mais ne fasse rien. Il est dans un état d'inactivité.
Mais il y a des mauvais clients. Par exemple, ce client s'est connecté, a ouvert une transaction, a fait quelque chose dans la base puis est allé dans le code, disons, pour accéder à une source externe ou pour traiter les données obtenues. Cependant, il n'a pas fermé la transaction. Et la transaction reste en attente dans la base et bloque certaines lignes. C'est une mauvaise situation. Et si l'application échoue quelque part avec une exception, la transaction peut rester ouverte très longtemps. Cela a un impact direct sur les performances de PostgreSQL. PostgreSQL fonctionnera plus lentement. Il est donc important de surveiller ces clients et de forcer la fin de leur travail en temps voulu. Il est également nécessaire d'optimiser votre application pour éviter de telles situations.
Un autre type de mauvais client est celui des clients en attente. Mais ils deviennent mauvais en raison des circonstances. Par exemple, une transaction simple qui reste inactive : elle peut ouvrir une transaction, prendre des verrous sur certaines lignes, puis échouer quelque part dans le code, laissant une transaction en attente. Un autre client viendra, demandera les mêmes données, mais il se heurtera à un verrou, car cette transaction en attente détient déjà des verrous sur certaines lignes nécessaires. Ainsi, la seconde transaction restera en attente jusqu'à ce que la première transaction se termine ou que son administrateur la ferme de force. Par conséquent, les transactions en attente peuvent s'accumuler et dépasser la limite de connexions à la base de données. Lorsque cette limite est dépassée, l'application ne peut plus fonctionner avec la base. C'est une situation d'urgence pour le projet. C'est pourquoi il est important de surveiller ces mauvais clients et de réagir rapidement.
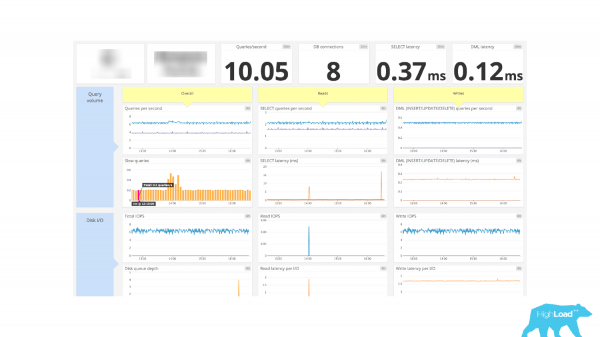
Un autre exemple de surveillance. Ici, nous avons un tableau de bord décent. Il contient des informations sur les connexions. DB connection - 8. Et c'est tout. Nous n'avons pas d'informations sur les clients actifs, ni sur ceux qui sont simplement inactifs et ne font rien. Il n'y a pas d'informations sur les transactions en attente ni sur les connexions en attente, c'est-à-dire que ce chiffre montre simplement le nombre de connexions et c'est tout. Ensuite, à vous de deviner.
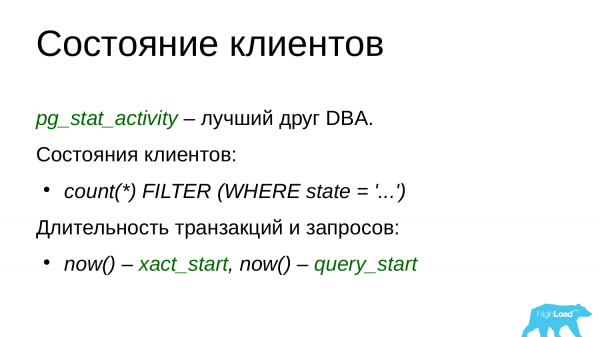
Pour ajouter cette information à la surveillance, il faut se référer à la vue système pg_stat_activity. Si vous passez beaucoup de temps dans PostgreSQL, cette vue est très utile et devrait devenir votre alliée, car elle montre l'activité actuelle dans PostgreSQL, c'est-à-dire ce qui s'y passe. Chaque processus dispose d'une ligne distincte qui montre des informations sur ce processus : depuis quel hôte la connexion a été effectuée, sous quel utilisateur, sous quel nom, quand la transaction a été lancée, quelle requête est actuellement exécutée et quelle était la dernière requête exécutée. En fonction de cela, nous pouvons évaluer l'état du client à partir du champ stat. En gros, nous pouvons grouper par ce champ et obtenir les stats actuellement présentes dans la base de données ainsi que le nombre de connexions associées à ce stat dans la base de données. Les chiffres ainsi obtenus peuvent être envoyés à notre système de surveillance pour visualiser des graphiques.
Il est également important d'évaluer la durée des transactions. J'ai déjà mentionné l'importance d'évaluer la durée des opérations de vidage, mais les transactions doivent également être évaluées de la même manière. Les champs xact_start et query_start montrent respectivement l'heure de début de la transaction et l'heure de début de la requête. Nous utilisons la fonction now(), qui affiche le timestamp actuel, et nous soustrayons le timestamp de la transaction et de la requête. Cela nous donne la durée de la transaction et la durée de la requête.
Si nous constatons des transactions longues, nous devons les annuler. Pour une charge OLTP, des transactions longues sont considérées comme celles dépassant 1 à 2 à 3 minutes.. Pour une charge OLAP, des transactions longues sont normales, mais si elles durent plus de deux heures, cela indique également qu'il y a un déséquilibre quelque part.
Lorsque les clients se connectent à la base de données, ils commencent à interagir avec nos données. Ils accèdent aux tables et aux index pour extraire des informations de la table. Il est important d'évaluer comment les clients interagissent avec ces données.
Cela est nécessaire pour évaluer notre charge de travail et comprendre quelles tables sont les plus « chaudes ». Par exemple, il est utile de savoir quelles tables « chaudes » placer sur un stockage SSD rapide. Des tables d'archive, que nous n'utilisons plus depuis longtemps, peuvent être déplacées vers un « froid » archive, sur des disques SATA, où elles peuvent rester, et leur accès se fera au besoin.
C'est également utile pour détecter les anomalies après divers déploiements et mises à jour. Imaginons qu'un projet déploie une nouvelle fonctionnalité. Par exemple, une nouvelle fonctionnalité pour travailler avec la base de données. Si nous construisons des graphiques d'utilisation des tables, nous pourrons facilement identifier ces anomalies sur ces graphiques. Par exemple, des pics d'update ou des pics de delete. Cela sera très visible.
Il est également possible de détecter les anomalies d'une statistique « floue ». Qu'est-ce que cela signifie ? PostgreSQL dispose d'un planificateur de requêtes très performant. Les développeurs consacrent beaucoup de temps à son développement. Comment cela fonctionne-t-il ? Pour construire de bons plans, PostgreSQL collecte périodiquement des statistiques sur la répartition des données dans les tables. Cela inclut les valeurs les plus fréquentes : le nombre de valeurs uniques, les informations sur les NULL dans la table, et de nombreuses autres informations.
Sur la base de ces statistiques, le planificateur construit plusieurs requêtes, sélectionne la plus optimale et utilise ce plan de requête pour exécuter la requête elle-même et renvoyer les données.
Il arrive que les statistiques « flottent ». La qualité et la quantité des données dans la table ont changé, mais les statistiques n'ont pas été mises à jour. Les plans générés peuvent donc ne pas être optimaux. Si nos plans s'avèrent non optimaux selon le monitoring collecté, sur les tables, nous pourrons observer ces anomalies. Par exemple, si les données ont changé qualitativement et qu'un accès séquentiel à la table est utilisé à la place de l'index, c'est-à-dire que si la requête doit renvoyer seulement 100 lignes (avec une limitation de 100), alors une recherche complète sera effectuée. Cela affecte toujours négativement les performances.
Et nous pourrons le voir dans la surveillance. Nous pourrons également examiner cette requête, effectuer un explain, recueillir des statistiques et construire un nouvel index supplémentaire. Et déjà réagir à ce problème. C'est pourquoi c'est important.
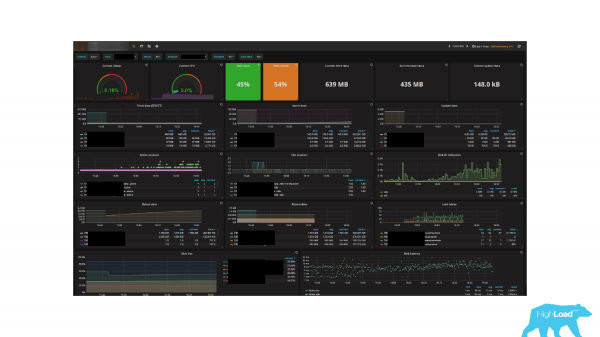
Un autre exemple de surveillance. Je pense que beaucoup l'ont reconnu, car il est très populaire. Qui l'utilise dans ses projets ? А кто использует этот продукт совместно с Prometheus? Дело в том, что в стандартном репозитории этого мониторинга есть дашборд для работы с PostgreSQL – Prometheus. Mais il y a un petit inconvénient ici.
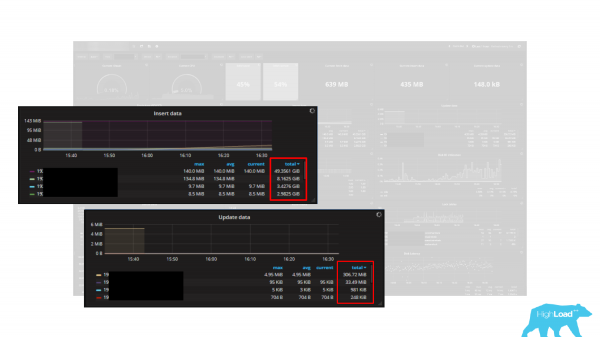
Il y a plusieurs graphiques. Et en tant qu'unité, on indique des octets, c'est-à-dire qu'il y a 5 graphiques. Cela inclut Insert data, Update data, Delete data, Fetch data et Return data. En tant qu'unité de mesure, on indique des octets. Mais le fait est que les statistiques dans PostgreSQL retournent les données sous forme de tuples (lignes). Par conséquent, ces graphiques sont un très bon moyen de sous-estimer votre charge de travail plusieurs fois, par dizaines, car un tuple ce n'est pas un octet, un tuple c'est une ligne, c'est beaucoup d'octets, et elle a toujours une longueur variable. Donc, calculer la charge de travail en octets en utilisant des tuples est une tâche irréaliste ou très compliquée. C'est pourquoi, lorsque vous utilisez un tableau de bord ou une surveillance intégrée, il est toujours important de comprendre qu'il fonctionne correctement et vous retourne des données évaluées correctement.
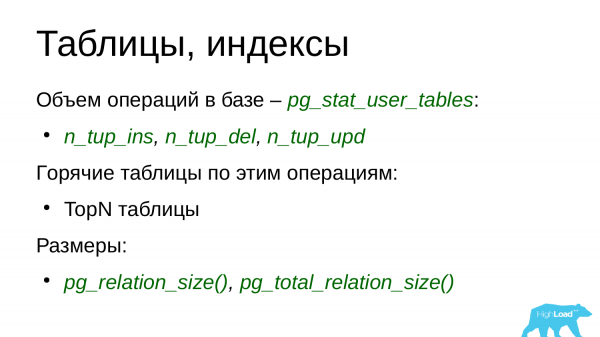
Comment obtenir des statistiques sur ces tables ? Pour cela, PostgreSQL dispose d'une certaine famille de vues. Et la vue principale est . User_tables signifie que les tables ont été créées au nom de l'utilisateur. En revanche, il y a les vues système qui sont utilisées par PostgreSQL lui-même. Et il y a une table récapitulative Alltables, qui inclut à la fois les systèmes et les utilisateurs. Vous pouvez vous baser sur l'une d'elles, celle que vous préférez.
À partir des champs mentionnés ci-dessus, on peut évaluer le nombre d'inserts, de mises à jour et de suppressions. L'exemple de tableau de bord que j'ai utilisé utilise précisément ces champs pour évaluer les caractéristiques de la charge de travail. Donc, nous pouvons également nous en baser. Mais il convient de se rappeler que ce sont des tuples, et non des octets, donc nous ne pouvons pas simplement le convertir en octets.
Sur la base de ces données, nous pouvons construire ce que l'on appelle des tables TopN. Par exemple, Top-5, Top-10. Et nous pouvons suivre les tables chaudes qui sont utilisées plus que les autres. Par exemple, les 5 « chaudes » en termes d'insertion. Et à partir de ces tables TopN, nous évaluons notre charge de travail et pouvons évaluer les pics de charge après chaque release, mise à jour et déploiement.
Il est également important d'évaluer les tailles des tables, car parfois les développeurs déploient une nouvelle fonctionnalité et nos tables commencent à gonfler en taille, car ils décident d'ajouter un volume de données supplémentaire sans prévoir comment cela affectera la taille de la base de données. De tels cas peuvent aussi être des surprises pour nous.
Et maintenant, une petite question pour vous. Quelle est la question qui vous vient à l'esprit quand vous remarquez une charge sur le serveur de base de données ? Quelle est la prochaine question qui vous vient ?
Mais en réalité, la question suivante se pose. Quelles requêtes provoquent la charge ? C'est-à-dire qu'il n'est pas intéressant de regarder les processus qui causent la charge. Il est évident que si le host a la base de données, alors une base de données y est en cours d'exécution et il est évident que seules les bases de données l'utiliseront. Si nous ouvrons Top, nous verrons une liste de processus dans PostgreSQL qui font quelque chose. Avec Top, on ne peut pas comprendre ce qu'ils font.
Par conséquent, il est nécessaire de détecter les requêtes qui provoquent la charge la plus importante, car le tuning des requêtes, en général, offre plus de profits que le tuning de la configuration de PostgreSQL ou du système d'exploitation, voire du matériel. À mon avis, cela représente environ 80-85-90 %. Et cela se fait beaucoup plus rapidement. Il est plus rapide de corriger une requête que d'ajuster la configuration, de planifier un redémarrage, surtout si la base ne peut pas être redémarrée, ou d'ajouter du matériel. Il est plus simple de réécrire une requête ou d'ajouter un index pour obtenir de meilleurs résultats.
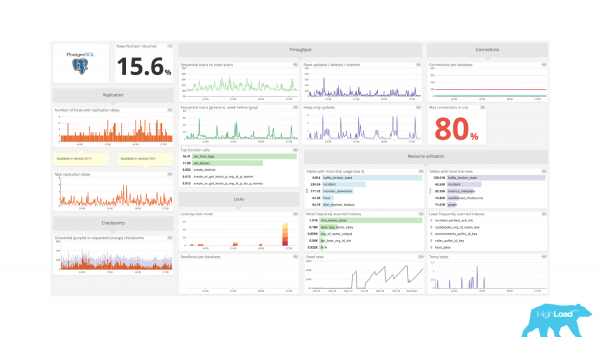
Par conséquent, il est nécessaire de surveiller les requêtes et leur adéquation. Prenons un autre exemple de surveillance. Ici aussi, c'est un bon monitoring. Il y a des informations sur la réplication, des informations sur la bande passante, les verrouillages, l'utilisation des ressources. Tout est parfait, mais il manque des informations sur les requêtes. Il n'est pas clair quelles requêtes s'exécutent dans notre base de données, combien de temps elles prennent, combien il y en a. Nous avons toujours besoin de ces informations dans le monitoring.
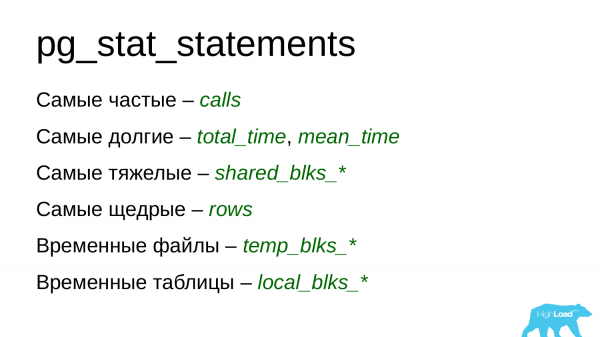
Et pour obtenir ces informations, nous pouvons utiliser le module pg_stat_statements. Sur cette base, il est possible de construire divers graphiques. Par exemple, nous pouvons obtenir des informations sur les requêtes les plus fréquentes, c'est-à-dire celles qui sont exécutées le plus souvent. Oui, après les déploiements, il est également très utile de le consulter pour comprendre s'il y a eu une augmentation soudaine des requêtes.
Nous pouvons surveiller les requêtes les plus longues, c'est-à-dire celles qui prennent le plus de temps à s'exécuter. Elles sollicitent le processeur et consomment des entrées-sorties. Nous pouvons également évaluer cela à partir des champs total_time, mean_time, blk_write_time et blk_read_time.
Nous pouvons évaluer et surveiller les requêtes les plus lourdes en termes d'utilisation des ressources, celles qui lisent depuis le disque, qui fonctionnent avec la mémoire ou, au contraire, qui créent une charge d'écriture.
Nous pouvons évaluer les requêtes les plus généreuses. Ce sont celles qui retournent un grand nombre de lignes. Par exemple, il peut s'agir d'une requête où il a été oublié de définir une limite. Elle renvoie alors tout le contenu de la table ou des tables demandées.
Il est également possible de surveiller les requêtes qui utilisent des fichiers temporaires ou des tables temporaires.
Et il nous reste des processus en arrière-plan. Les processus en arrière-plan sont d'abord les checkpoints, également appelés points de contrôle, ainsi que l'autovacuum et la réplication.
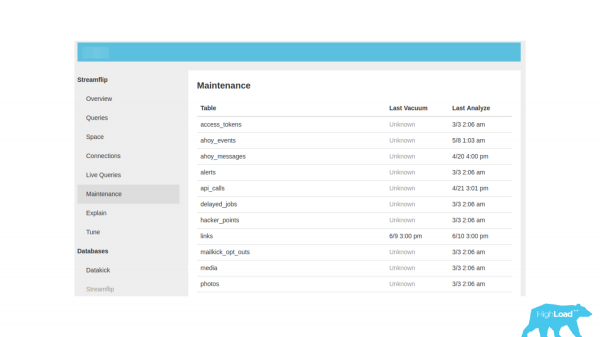
Un autre exemple de surveillance. Il y a un onglet Maintenance à gauche, nous y accédons en espérant voir quelque chose d'utile. Mais ici, il n'y a que le temps de fonctionnement du vacuum et de collecte des statistiques, rien de plus. C'est une information très pauvre, donc il est toujours nécessaire d'avoir des informations sur le fonctionnement de nos processus en arrière-plan et s'il n'y a pas de problèmes liés à leur activité.
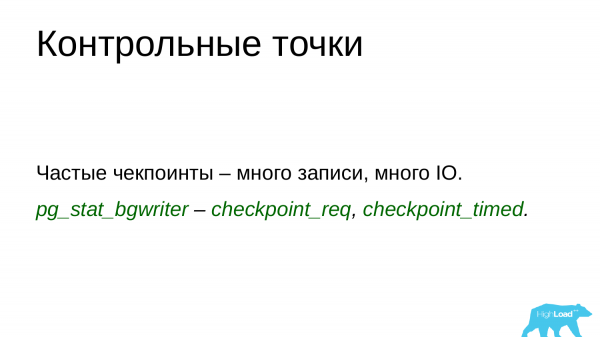
Lorsque nous examinons les points de contrôle, il est important de rappeler que les points de contrôle réinitialisent les pages « sales » de la mémoire shardée sur le disque, puis créent un point de contrôle. Ce point de contrôle peut ensuite être utilisé comme un moyen de restauration, si jamais PostgreSQL a été arrêté de manière inattendue.
Par conséquent, pour vider toutes les pages « sales » sur le disque, il faut effectuer un certain volume d'écriture. Et, en règle générale, sur les systèmes avec une grande capacité mémoire, cela représente beaucoup. Et si nos checkpoints sont effectués très fréquemment sur une courte période, alors la performance du disque va chuter considérablement. Les requêtes clients souffriront d'un manque de ressources. Elles se battront pour les ressources et leur performance sera insuffisante.
Ainsi, à travers pg_stat_bgwriter, nous pouvons surveiller le nombre de checkpoints qui se produisent en fonction des champs spécifiés. Et si, sur une période donnée (par exemple, 10-15-20 minutes, une demi-heure), nous avons beaucoup de checkpoints, par exemple 3-4-5, cela peut déjà poser problème. Il est alors nécessaire de vérifier la base de données, de regarder la configuration pour voir ce qui cause cette abondance de checkpoints. Peut-être qu'il y a une grande transaction en cours. À partir de la charge de travail, nous pouvons déjà évaluer, car nous avons les graphiques de charge de travail qui sont déjà ajoutés. Nous pouvons déjà ajuster les paramètres des points de contrôle de manière à ce qu'ils n'impactent pas trop la performance des requêtes.
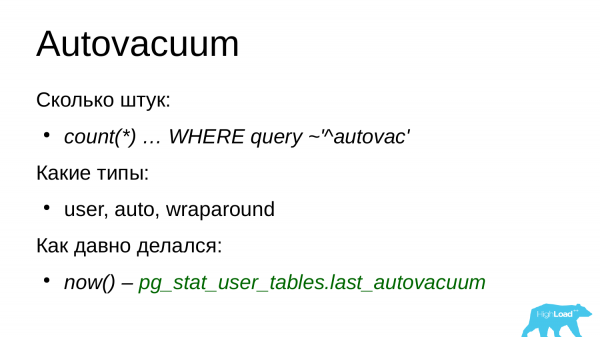
Je reviens encore à l'autovacuum, car c'est une fonctionnalité, comme je l'ai déjà mentionné, qui peut facilement affecter la performance tant des disques que des requêtes. Il est donc toujours important d'évaluer le nombre d'autovacuum.
Le nombre de travailleurs autovacuum dans la base de données est limité. Par défaut, il y en a trois ; donc si nous avons toujours trois travailleurs qui fonctionnent dans la base, cela signifie que notre autovacuum est mal configuré, il faut augmenter les limites, revoir les paramètres de l'autovacuum et aller vérifier la configuration.
Il est important d'évaluer quels travailleurs de vacuum sont actifs. Soit ils sont lancés par un utilisateur, le DBA est venu et a lancé manuellement un vacuum, ce qui a créé une charge. Nous avons alors un problème. Soit c'est le nombre de vacuums qui réinitialisent le compteur de transactions. Pour certaines versions de PostgreSQL, ce sont des vacuums très lourds. Et ils peuvent facilement impacter la performance, car ils parcourent toute la table dans son intégralité et scannent tous les blocs de cette table.
Et bien sûr, la durée des opérations de vide. Si nous avons des longues opérations de vide qui durent longtemps, cela signifie qu'il est à nouveau temps de se pencher sur la configuration du vide et peut-être de revoir ses paramètres. Parce qu'il peut y avoir une situation où le vide fonctionne sur une table pendant longtemps (3-4 heures), mais pendant que le vide fonctionne, un grand volume de lignes mortes peut s'accumuler de nouveau dans la table. Et dès que le vide se termine, il doit à nouveau effectuer une opération de vide sur cette table. Nous arrivons donc à une situation de vide infini. Dans ce cas, le vide ne remplit pas son rôle, et les tables commencent progressivement à gonfler en taille, même si le volume de données utiles reste le même. Par conséquent, lors de longues opérations de vide, nous examinons toujours la configuration et essayons de l'optimiser, tout en veillant à ce que les performances des requêtes des clients ne souffrent pas.
Actuellement, il n'y a pratiquement aucune installation de PostgreSQL sans réplication en continu. La réplication est le processus de transfert de données du maître vers la réplique.
La réplication dans PostgreSQL fonctionne à travers le journal des transactions. Le maître génère le journal des transactions. Ce journal de transaction est envoyé à la réplique via une connexion réseau, puis il est reproduit sur la réplique. C'est simple.
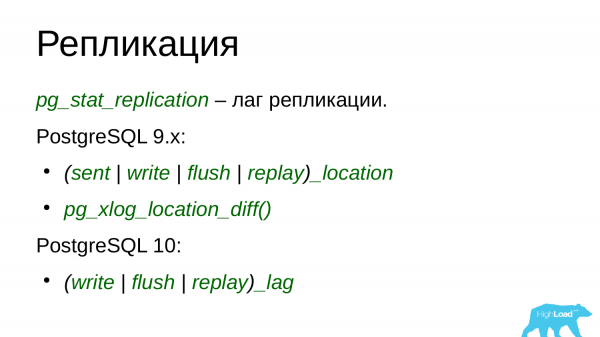
En conséquence, pour surveiller le retard de réplication, on utilise la vue pg_stat_replication. Mais ce n'est pas toujours simple. Dans la version 10, la vue a subi plusieurs modifications. Tout d'abord, certains champs ont été renommés. Et certains champs ont été ajoutés. Dans la version 10, des champs permettant d'évaluer le retard de réplication en secondes sont apparus. C'est très pratique. Avant la version 10, il était possible d'évaluer le retard de réplication en octets. Cette option est toujours disponible dans la version 10, c'est-à-dire que vous pouvez choisir ce qui vous convient le mieux - évaluer le retard en octets ou en secondes. Beaucoup font les deux.
Néanmoins, pour évaluer le retard de réplication, il est nécessaire de connaître la position du journal dans la transaction. Ces positions du journal de transaction se trouvent justement dans la vue pg_stat_replication. En d'autres termes, à l'aide de la fonction pg_xlog_location_diff(), nous pouvons prendre deux points dans le journal des transactions. Calculer la différence entre eux et obtenir le retard de réplication en octets. C'est très pratique et simple.
Dans la version 10, cette fonction a été renommée en pg_wal_lsn_diff(). En général, dans toutes les fonctions, vues et utilitaires où le mot « xlog » était présent, il a été remplacé par « wal ». Cela concerne tant les vues que les fonctions. C’est une nouveauté.
De plus, dans la version 10, des lignes ont été ajoutées pour indiquer spécifiquement le retard. Il s'agit de write lag, flush lag, replay lag. C'est-à-dire qu'il est important de surveiller ces éléments. Si nous constatons un retard de réplication, il est nécessaire d'explorer pourquoi il est apparu, d'où il vient et de résoudre le problème.
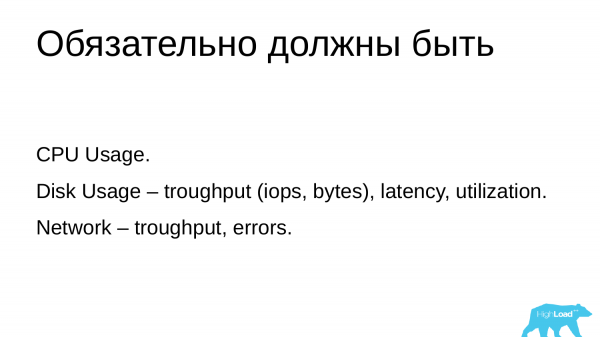
Les métriques système sont pratiquement toutes en ordre. Lorsqu'un système de surveillance se met en place, il commence par des métriques systèmes. Cela inclut l'utilisation du processeur, de la mémoire, des swaps, du réseau et du disque. Cependant, de nombreux paramètres ne figurent pas par défaut.
Si l'utilisation du processus est correcte, il y a des problèmes avec l'utilisation du disque. En général, les développeurs de systèmes de surveillance ajoutent des informations sur la bande passante. Cela peut être en IOPS ou en octets. Mais ils oublient la latence et l'utilisation des dispositifs de stockage. Ce sont des paramètres plus importants qui permettent d'évaluer à quel point nos disques sont chargés et combien ils ralentissent. Si nous avons une latence élevée, cela signifie qu'il y a des problèmes avec les disques. Si nous avons une utilisation élevée, cela signifie que les disques ne fonctionnent pas correctement. Ce sont des caractéristiques de qualité supérieure par rapport à la bande passante.
Bien que ces statistiques puissent également être obtenues à partir du système de fichiers /proc, comme c'est le cas pour l'utilisation du processeur. Je ne sais pas pourquoi cette information n'est pas ajoutée aux systèmes de surveillance. Cependant, il est important de l'avoir dans votre système de surveillance.
Il en va de même pour les interfaces réseau. Il existe des informations sur la bande passante réseau en paquets, en octets, mais il n'y a pas d'informations sur la latence et sur l'utilisation, bien que cela soit également utile.
Tous les systèmes de surveillance ont des inconvénients. Quel que soit le système de surveillance que vous choisissez, il ne correspondra toujours pas à certains critères. Cependant, ils évoluent, de nouvelles fonctionnalités et éléments sont ajoutés, donc choisissez quelque chose et peaufinez-le.
Et pour peaufiner, il est toujours nécessaire d'avoir une idée de ce que signifie la statistique fournie et comment l'utiliser pour résoudre des problèmes.
Et quelques points clés :
- Il est toujours nécessaire de surveiller la disponibilité, d'avoir des tableaux de bord pour que vous puissiez rapidement évaluer si tout va bien avec votre base de données.
- Il est toujours important d'avoir une idée des clients qui travaillent avec votre base de données, afin de pouvoir écarter les clients indésirables.
- Il est crucial d'évaluer comment ces clients interagissent avec les données. Vous devez avoir une idée de votre charge de travail.
- Il est important d'évaluer comment cette charge de travail se forme, quels types de requêtes sont utilisées. Vous pouvez évaluer les requêtes, les optimiser, les refactoriser et construire des index pour elles. C'est très important.
- Les processus en arrière-plan peuvent avoir un impact négatif sur les requêtes des clients, il est donc essentiel de surveiller qu'ils n'utilisent pas trop de ressources.
- Les métriques système vous permettent de planifier l'évolutivité et d'augmenter la capacité de vos serveurs, il est donc également important de les surveiller et de les évaluer.
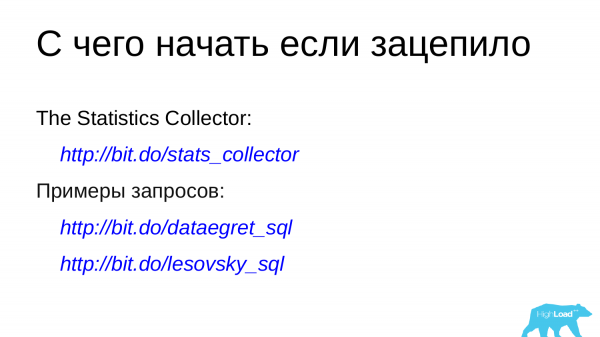
Si ce sujet vous intéresse, vous pouvez suivre ces liens.
— c'est la documentation officielle avec le collecteur de statistiques. Il y a une description de toutes les vues statistiques et de tous les champs. Vous pouvez les lire, les comprendre et les analyser. Ensuite, vous pourrez construire vos propres graphiques et les ajouter à vos systèmes de surveillance.
Exemples de requêtes :
C'est notre dépôt d'entreprise et le mien. Il contient des exemples de requêtes. Il n'y a pas de requêtes du type select * from quelque chose. Ce sont déjà des requêtes prêtes avec des jointures, utilisant des fonctions intéressantes qui transforment des chiffres bruts en valeurs lisibles et pratiques, c'est-à-dire des octets, du temps. Vous pouvez les explorer, les regarder, les analyser, les ajouter à vos systèmes de surveillance et construire vos propres systèmes de surveillance basés sur cela.
Questions
Question : Vous avez dit que vous ne ferez pas de publicité pour des marques, mais cela m'intéresse quand même – quels tableaux de bord utilisez-vous dans vos projets ?
Réponse : Ça dépend. Parfois, nous arrivons chez un client et il a déjà son propre système de surveillance. Et nous conseillons le client sur ce qu'il faut ajouter à son système. La situation est la plus difficile avec Zabbiх, car il n'a pas la capacité de construire des graphiques TopN. Nous utilisons nous-mêmes , car nous avons conseillé ces gars sur la surveillance. Ils ont conçu un système de surveillance PostgreSQL basé sur notre cahier des charges. Je développe mon propre projet personnel, qui collecte des données via Prometheus et les affiche dans J'ai pour mission de créer mon propre exportateur dans Prometheus et ensuite de tout afficher dans Grafana.
Question : Existe-t-il des analogues aux rapports AWR ou à des … agrégations ? Connaissez-vous quelque chose de similaire ?
Réponse : Oui, je sais ce qu'est AWR, c'est une très bonne chose. Actuellement, il existe divers outils qui réalisent un modèle similaire. À intervalles réguliers, certains baselines sont écrits dans PostgreSQL ou dans un stockage séparé. Vous pouvez les trouver sur Internet, ils existent. Un des développeurs de ce type d'outils est actif sur le forum sql.ru dans le fil PostgreSQL. Vous pouvez le contacter là-bas. Oui, de tels outils existent et peuvent être utilisés. En plus de cela, je développe aussi un outil qui permet de faire la même chose.
P.S.1 Si vous utilisez postgres_exporter, quel tableau de bord utilisez-vous ? Il y en a plusieurs. Ils sont déjà obsolètes. Peut-être que la communauté pourrait créer un modèle mis à jour ?
P.S.2 J'ai retiré pganalyze, car c'est une offre SaaS propriétaire qui se concentre sur la surveillance de performance et les suggestions d'automatisation.
Seuls les utilisateurs enregistrés peuvent participer au sondage. , s'il vous plaît.
Quel outil de surveillance self-hosted pour PostgreSQL (avec tableau de bord) considérez-vous comme le meilleur ?
30,0%Zabbix + modules d'Alexey Lesovsky ou zabbix 4.4 ou libzbxpgsql + zabbix libzbxpgsql + zabbix3
0,0%https://github.com/lesovsky/pgcenter0
0,0%https://github.com/pg-monz/pg_monz0
20,0%https://github.com/cybertec-postgresql/pgwatch22
20,0%https://github.com/postgrespro/mamonsu2
0,0%https://www.percona.com/doc/percona-monitoring-and-management/conf-postgres.html0
10,0%pganalyze est un SaaS propriétaire — je ne peux pas le supprimer.
10,0%https://github.com/powa-team/powa1
0,0%https://github.com/darold/pgbadger0
0,0%https://github.com/darold/pgcluu0
0,0%https://github.com/zalando/PGObserver0
10,0%https://github.com/spotify/postgresql-metrics1
10 utilisateurs ont voté. 26 utilisateurs se sont abstenus.
Source : habr.com
