

La prochaine conférence HighLoad++ se déroulera les 6 et 7 avril 2020 à Saint-Pétersbourg.
Détails et billets . HighLoad++ Sibérie 2019. Salle « Krasnoïarsk ». 25 juin, 12:00. Résumés et .
Il arrive que les exigences pratiques soient en conflit avec la théorie, où des aspects importants pour un produit commercial ne sont pas pris en compte. Dans cette présentation, nous présenterons le processus de sélection et de combinaison de différentes approches pour créer des composants de cohérence causale, basés sur des recherches académiques en fonction des exigences du produit commercial. Les auditeurs découvriront les approches théoriques existantes en matière d'horloges logiques, de suivi des dépendances, de sécurité des systèmes, de synchronisation des horloges, et pourquoi MongoDB a opté pour certaines solutions.
Mikhail Tyulenev (ci-après – MT) : – Je vais parler de la cohérence causale – c'est une fonctionnalité sur laquelle nous avons travaillé chez MongoDB. Je fais partie du groupe des systèmes distribués, nous l'avons développée il y a environ deux ans.
Au cours du processus, j'ai dû me familiariser avec un grand nombre de recherches académiques, car cette fonctionnalité a été bien étudiée. Il s'est avéré qu'aucun article ne correspond à ce qui est nécessaire en production, une base de données en raison de ses exigences très spécifiques, qui existent probablement dans n'importe quelle application de production.
Je vais expliquer comment nous, en tant que consommateurs de la recherche académique, préparons quelque chose que nous pouvons ensuite présenter à nos utilisateurs comme un plat prêt à l'emploi, facile et sûr à utiliser.
Cohérence causale. Définissons les termes
Pour commencer, je veux décrire brièvement ce qu'est la cohérence causale. Il y a deux personnages – Leonard et Penny (série « The Big Bang Theory ») :
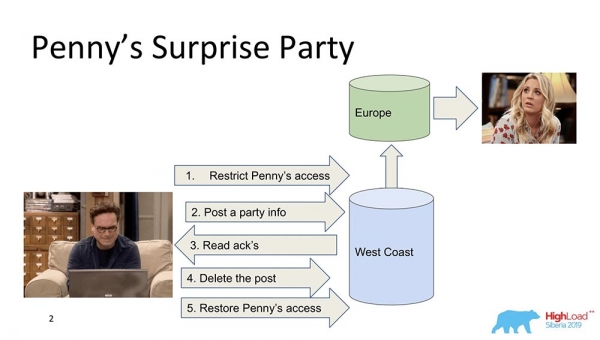
Supposons que Penny soit en Europe, et Leonard veuille lui faire une surprise, une fête. Et il ne trouve rien de mieux que de l’enlever de sa liste d’amis, d’envoyer une mise à jour à tous ses amis dans le flux : « Faisons plaisir à Penny ! » (elle est en Europe, elle dort pour l'instant, ne voit rien et ne peut pas le voir, car elle n'est pas là). À un moment donné, il supprime ce post, l’efface du « Fil » et rétablit l'accès pour qu'elle ne remarque rien et qu'il n'y ait pas de scandale.
C'est tout à fait magnifique, mais supposons que le système soit distribué et que les événements ne se déroulent pas tout à fait comme prévu. Par exemple, il pourrait arriver que la restriction d'accès de Penny se soit produite après la publication de ce post, si les événements ne sont pas liés par des relations de cause à effet. En fait, c'est un exemple de la nécessité d'une cohérence causale pour réaliser une fonction d'affaires (dans ce cas).
En réalité, ce sont des propriétés plutôt non triviales des bases de données – très peu d'entre elles les prennent en charge. Passons aux modèles.
Modèles de cohérence (Consistency Models)
Qu'est-ce qu'un modèle de cohérence dans les bases de données ? Ce sont certaines garanties que le système distribué fournit concernant les données et leur séquence dans laquelle le client peut les obtenir.
En principe, tous les modèles de cohérence se résument à la façon dont un système distribué ressemble à un système fonctionnant, par exemple, sur un seul nœud sur un ordinateur portable. Et à quel point un système fonctionnant sur des milliers de nœuds géographiquement dispersés ressemble à cet ordinateur portable, où toutes ces propriétés sont généralement réalisées automatiquement.
C'est pourquoi les modèles de cohérence ne s'appliquent qu'aux systèmes distribués. Tous les systèmes qui ont existé auparavant et qui fonctionnaient sur une mise à l'échelle verticale n'avaient pas ce genre de problèmes. Il y avait un seul Buffer Cache, et tout était constamment lu à partir de celui-ci.
Modèle Fort (Strong)
La toute première modélisation est le modèle Fort (ou rise ability, comme il est souvent appelé). C'est un modèle de cohérence qui garantit qu'à chaque fois qu'un changement est confirmé comme ayant été effectué, celui-ci devient visible pour tous les utilisateurs du système.
Cela crée un ordre global de tous les événements dans la base de données. C'est une propriété de cohérence très forte et elle est généralement très coûteuse. Néanmoins, elle est bien prise en charge. Elle est juste très coûteuse et lente – elle est donc rarement utilisée. Cela s'appelle la rise ability.
Il existe une autre propriété encore plus forte qui est prise en charge dans « Spanner » – appelée Cohérence Externe. Nous en parlerons un peu plus tard.
Causale
Ce qui suit est Causal, exactement ce dont je parlais. Entre Strong et Causal, il y a encore plusieurs sous-niveaux que je ne vais pas aborder, mais ils se résument tous à Causal. C'est un modèle important, car c'est le plus fort de tous les modèles, avec la plus forte consistance en cas de réseau ou de partitions.
Les Causals sont en fait la situation dans laquelle les événements sont liés par une relation de cause à effet. Ils sont souvent perçus comme Read your on rights du point de vue du client. Si un client a observé certaines valeurs, il ne peut pas voir les valeurs qui étaient dans le passé. Il commence déjà à voir des lectures préfixées. Tout cela se résume à la même chose.
Les Causals en tant que modèle de consistance représentent un ordonnancement partiel des événements sur le serveur, où les événements de tous les clients sont observés dans le même ordre. Dans ce cas, ce sont Leonard et Penny.
Eventual
Le troisième modèle est la Consistance Eventuelle. C'est ce que tous les systèmes distribués supportent, le modèle minimum qui a un sens. Cela signifie que lorsque nous avons des modifications dans les données, elles deviennent cohérentes à un certain moment.
À ce moment-là, cela n'indique rien, sinon cela deviendrait une Consistance Externe – ce serait une tout autre histoire. Pourtant, c'est un modèle très populaire, le plus répandu. Par défaut, tous les utilisateurs de systèmes distribués utilisent la Consistance Eventuelle.
Je veux donner quelques exemples comparatifs :
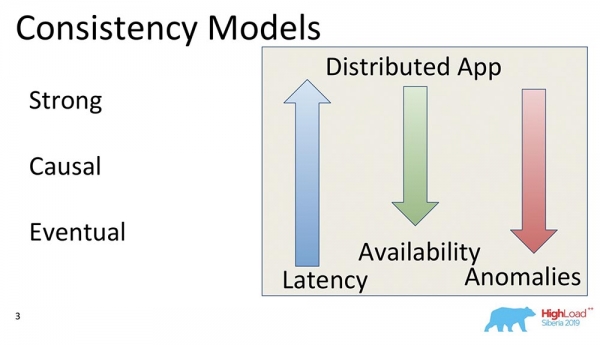
Que signifient ces flèches ?
- Latence. Avec l'augmentation de la force de consistance, elle devient plus grande pour des raisons évidentes : il faut effectuer plus d'écritures, recevoir la confirmation de tous les hôtes et nœuds impliqués dans le cluster que les données y sont déjà. Par conséquent, dans la Consistance Eventuelle, la réponse est la plus rapide, car généralement, il est même possible de faire un commit en mémoire et cela devrait être suffisamment.
- Disponibilité. Si l'on comprend cela comme la capacité du système à répondre en cas de coupures réseau, de partitions, ou de pannes – la tolérance aux pannes augmente avec la réduction du modèle de consistance, car il suffit qu'un hôte soit actif et qu'il fournisse certaines données. La Consistance Eventuelle ne garantit absolument rien concernant les données – cela peut être n'importe quoi.
- Anomalies. Cependant, cela entraîne bien sûr une augmentation du nombre d'anomalies. Avec la Consistance Forte, elles ne devraient pratiquement pas exister, alors qu'avec la Consistance Éventuelle, elles peuvent être de toutes sortes. La question se pose : pourquoi les gens choisissent-ils la Consistance Éventuelle, si elle contient des anomalies ? La réponse est que les modèles de Consistance Éventuelle sont applicables, et que les anomalies existent, par exemple, sur de courtes périodes ; il est possible d'utiliser un master pour lire et obtenir des données relativement cohérentes ; il y a souvent la possibilité d'utiliser des modèles de consistance forte. En pratique, cela fonctionne, et souvent le nombre d'anomalies est limité dans le temps.
Théorème CAP
Quand vous entendez les mots consistance, disponibilité – qu'est-ce qui vous vient à l'esprit ? Exactement – le théorème CAP ! Je veux maintenant dissiper un mythe... Ce n'est pas moi – c'est Martin Kleppmann, qui a écrit un excellent article, un excellent livre.
Le théorème CAP est un principe formulé dans les années 2000, qui traite de la Consistance, de la Disponibilité, des Partitions : prenez-en deux, vous ne pouvez pas choisir les trois. C'était un certain principe. Il a été prouvé comme théorème quelques années plus tard, cela a été fait par Gilbert et Lynch. Ensuite, cela a été utilisé comme un mantra – les systèmes ont été classés en CA, CP, AP, etc.
Ce théorème a été prouvé pour les cas suivants… Premièrement, la Disponibilité n'était pas considérée comme une valeur continue allant de zéro à cent (0 – système « mort », 100 – répond rapidement ; c'est ainsi que nous avons l'habitude de le considérer), mais comme une propriété de l'algorithme qui garantit que, lors de toutes ses exécutions, il retourne des données.
Il n'est absolument pas question de temps de réponse ici ! Il existe un algorithme qui retourne des données dans 100 ans – un algorithme disponible tout à fait remarquable, qui fait partie du théorème CAP.
Deuxièmement : le théorème a été prouvé pour des modifications des valeurs d'une même clé, alors que ces modifications sont de type resizeable. Cela signifie qu'ils ne sont pratiquement pas utilisés, car les modèles de Consistance Éventuelle, de Consistance Forte (peut-être) diffèrent.
À quoi cela sert-il ? Au fait que le théorème CAP, dans la forme dans laquelle il a été prouvé, est pratiquement inapplicable, rarement utilisé. Dans sa forme théorique, il limite d'une certaine manière tout. Cela donne un principe qui est intuitivement vrai, mais qui n'est pas vraiment prouvé.
La consistance causale est le modèle le plus fort
Ce qui se passe actuellement permet d'obtenir les trois éléments suivants : la cohérence, la disponibilité, que l'on peut réaliser avec les partitions. En particulier, la cohérence causale est le modèle de cohérence le plus puissant, qui fonctionne même en présence de partitions (coupures dans le réseau). C'est pourquoi elle suscite un si grand intérêt, et c'est pourquoi nous nous y engageons.
Elle simplifie, tout d'abord, le travail des développeurs d'applications. En particulier, la présence d'un large soutien côté serveur : lorsque toutes les opérations qui se produisent pour un même client arrivent de manière garantie dans la même séquence sur un autre client. Deuxièmement, elle résiste aux partitions.
La cuisine interne de MongoDB
En gardant à l'esprit que c'est l'heure du déjeuner, nous nous dirigeons vers la cuisine. Je vais vous parler du modèle système, en particulier de ce qu'est MongoDB pour ceux qui entendent parler de cette base de données pour la première fois.
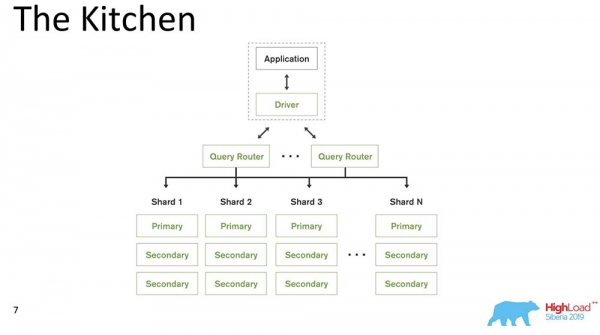
MongoDB (ci-après 'MongoDB') est un système distribué qui prend en charge le scalabilité horizontale, c'est-à-dire le sharding ; et à l'intérieur de chaque shard, il prend également en charge la redondance des données, c'est-à-dire la réplication.
Le sharding dans MongoDB (une base de données non relationnelle) effectue un équilibrage automatique, c'est-à-dire que chaque collection de documents (ou 'table' en termes de données relationnelles) est divisée en morceaux, et le serveur les déplace automatiquement entre les shards.
Le routeur de requêtes, qui répartit les demandes, est pour le client un certain client à travers lequel il travaille. Il sait déjà où se trouvent les données et quelles sont ces données, et dirige toutes les requêtes vers le bon shard.
Un autre point important : MongoDB est un unique master. Il y a un Primary - il peut prendre des enregistrements soutenant les clés qu'il contient. Il est impossible d'effectuer une écriture multi-master.
Nous avons sorti la version 4.2 - elle a introduit de nouvelles choses intéressantes. En particulier, nous avons intégré Lucene - la recherche - c'est-à-dire Java exécutable directement dans 'Mongo', et il est désormais possible d'effectuer des recherches avec Lucene, tout comme dans 'Elasticsearch'.
Et nous avons développé un nouveau produit - Charts, qui est également disponible sur 'Atlas' (le Cloud propre à Mongo). Ils ont une option Free Tier - vous pouvez jouer avec ça. J'ai beaucoup aimé Charts - la visualisation des données est très intuitive.
Les ingrédients de la cohérence causale
J'ai compté environ 230 articles publiés sur ce sujet - de Leslie Lamport. Maintenant, de ma mémoire, je vais vous transmettre certaines parties de ces documents.
Tout a commencé avec un article de Leslie Lampert, écrit dans les années 1970. Comme vous pouvez le voir, des recherches dans ce domaine se poursuivent encore aujourd'hui. Actuellement, la cohérence causale suscite de l'intérêt en raison de l'évolution des systèmes distribués.
Restrictions
Quelles sont les limitations ? C'est en réalité l'un des principaux points, car les contraintes imposées par les systèmes de production diffèrent fortement de celles qui existent dans les articles académiques. Souvent, elles sont assez artificielles.
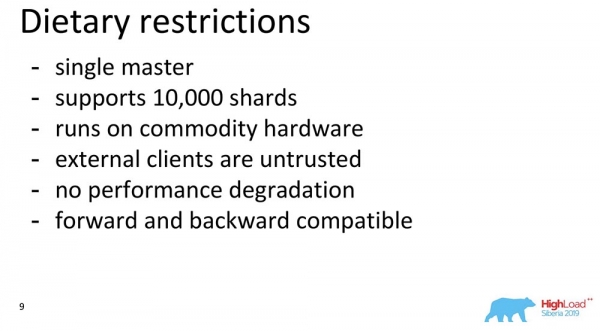
- Tout d'abord, « MongoDB » est un maître unique, comme je l'ai déjà mentionné (ce qui simplifie beaucoup les choses).
- Nous estimons que le système devrait supporter environ 10 000 shards. Nous ne pouvons pas prendre des décisions architecturales qui limiteraient clairement cette valeur.
- Nous avons un cloud, mais nous supposons que l'utilisateur doit avoir la possibilité, lorsqu'il télécharge un binaire, de l'exécuter sur son ordinateur portable, et que tout fonctionne parfaitement.
- Nous pensons que dans la recherche, il est rarement utilisé : les clients externes peuvent faire ce qu'ils veulent. « MongoDB » est open source. Par conséquent, les clients peuvent être intelligents, malveillants – ils peuvent vouloir tout casser. Nous supposons que des échecs byzantins peuvent se produire.
- Pour les clients externes, qui se trouvent en dehors du périmètre – une limitation importante : si cette fonctionnalité est désactivée, il ne devrait y avoir aucune dégradation des performances.
- Un autre point – totalement anti-académique : la compatibilité des versions précédentes et futures. Les anciens pilotes doivent prendre en charge les nouvelles mises à jour, et la base de données doit supporter les anciens pilotes.
En général, tout cela impose des contraintes.
Composants de la cohérence causale
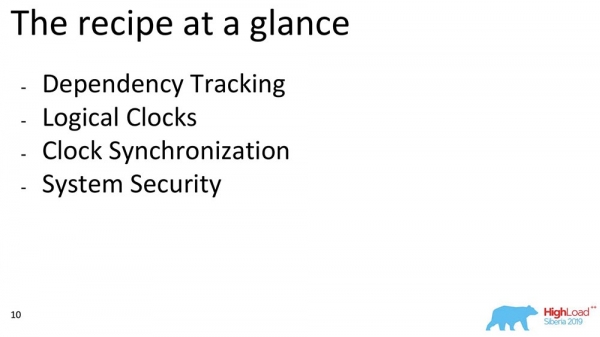
Je vais maintenant parler de certains composants. En considérant la cohérence causale, on peut distinguer des blocs. Nous avons sélectionné dans des travaux qui se rapportent à un certain bloc : le suivi des dépendances, le choix des horloges, comment ces horloges peuvent être synchronisées entre elles, et comment nous assurons la sécurité – voici un plan approximatif de ce que je vais aborder :
Suivi complet des dépendances (Full Dependency Tracking)
Pourquoi est-ce nécessaire ? Pour que, lorsque les données sont répliquées, chaque enregistrement, chaque modification des données contienne des informations sur les changements dont il dépend. La première et la plus naïve des modifications est celle où chaque message contenant un enregistrement inclut des informations sur les messages précédents :
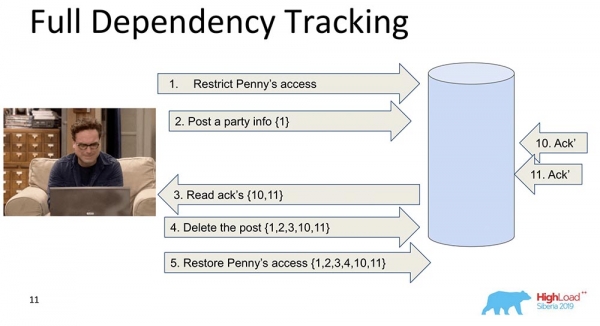
Dans cet exemple, le numéro entre accolades représente ces enregistrements. Parfois, ces enregistrements avec des valeurs sont même transmis intégralement, parfois certaines versions sont transmises. L'essentiel est que chaque changement contient des informations sur le précédent (il porte cela en lui).
Pourquoi avons-nous décidé de ne pas utiliser cette approche (le suivi complet) ? Évidemment, parce que cette méthode est peu pratique : chaque modification dans un réseau social dépend de toutes les modifications précédentes dans ce réseau, impliquant par exemple 'Facebook' ou 'VKontakte' à chaque mise à jour. Néanmoins, il existe de nombreuses recherches sur le Full Dependency Tracking – ce sont des pré-réseaux sociaux, et pour certaines situations, cela fonctionne réellement.
Suivi explicite des dépendances (Explicit Dependency Tracking)
Le suivant est plus limité. Ici, l'information transmise est considérée, mais seulement celle qui dépend explicitement. Ce dont dépend quoi est généralement défini par l'Application. Lorsque les données sont répliquées, seules les réponses sont fournies lorsque les dépendances précédentes ont été satisfaites, c'est-à-dire montrées. C'est là que réside le principe du fonctionnement de la cohérence causale.
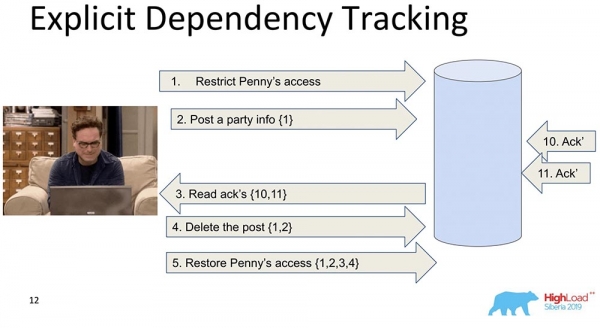
Elle voit que l'enregistrement 5 dépend des enregistrements 1, 2, 3, 4 - en conséquence, elle attend avant que le client ait accès aux modifications apportées par la décision d'accès de Penny, lorsque tous les changements précédents ont déjà été intégrés dans la base de données.
Cela ne nous convient pas non plus, car il y a encore trop d'informations, et cela va ralentir. Il existe une autre approche…
Horloge de Lamport (Lamport Clock)
Elles sont très anciennes. L'Horloge de Lamport suppose que ces dépendances se plient en une fonction scalaire, qui s'appelle Lamport Clock.
Une fonction scalaire est un nombre abstrait. On parle souvent de temps logique. À chaque événement, ce compteur augmente. Le compteur, qui est actuellement connu du processus, envoie chaque message. Il est clair que les processus peuvent être désynchronisés, et qu'ils peuvent avoir des temps complètement différents. Néanmoins, ce type d'échange de messages permet au système d'équilibrer d'une manière ou d'une autre les horloges. Que se passe-t-il dans ce cas ?
J'ai divisé ce grand shard en deux pour clarifier : les Friends peuvent vivre dans un nœud qui contient une partie de la collection, tandis que le Feed peut se trouver dans un autre nœud, qui contient un autre morceau de cette collection. Comment peuvent-ils ne pas être en file d'attente ? D'abord, le Feed dira : « Répliqué », puis ce sera au tour de Friends. Si le système ne garantit pas que le Feed ne sera pas affiché tant que les dépendances de Friends dans la collection Friends ne seront pas également livrées, alors nous nous retrouvons précisément dans la situation que j'ai mentionnée.
Vous voyez comment le temps logique du compteur sur le Feed augmente :
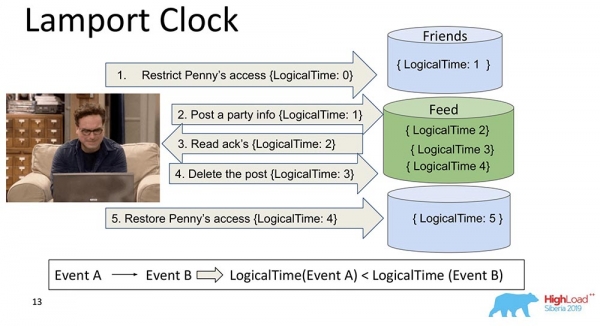
Ainsi, la propriété principale de cette horloge de Lamport et de la cohérence causale (expliquée à travers l'horloge de Lamport) est la suivante : si nous avons des événements A et B, et que l'événement B dépend de l'événement A *, alors il en découle que le LogicalTime de l'événement A est inférieur au LogicalTime de l'événement B.
* Parfois on dit aussi que A est arrivé avant B, c'est-à-dire A a eu lieu avant B – c'est une sorte de relation qui ordonne partiellement l'ensemble des événements qui se sont réellement produits.
Dans l'autre sens, ce n'est pas vrai. C'est en fait l'un des principaux inconvénients de l'horloge de Lamport – l'ordre partiel. Il existe un concept d'événements simultanés, c'est-à-dire d'événements où ni (A est arrivé avant B), ni (B est arrivé avant A). Un exemple pourrait être l'ajout parallèle de Leonard en tant qu'ami de quelqu'un d'autre (même pas Leonard, mais Sheldon, par exemple).
C'est la propriété qu'on utilise souvent lors du travail avec les horloges de Lamport : on regarde précisément la fonction et on en déduit – peut-être que ces événements sont dépendants. Car dans un sens c'est vrai : si le LogicalTime A est inférieur au LogicalTime B, alors B ne peut pas être arrivé avant A ; et si c'est plus, alors cela peut être le cas.
Horloges vectorielles (Vector Clock)
Le développement logique des horloges de Lamport est l'horloge vectorielle. Elles se distinguent par le fait que chaque nœud, présent ici, contient ses propres horloges distinctes, et celles-ci sont transmises sous forme de vecteur.
Dans ce cas, vous voyez que l'index zéro du vecteur correspond à Feed, et le premier index du vecteur correspond à Friends (chacun de ces nœuds). Et maintenant, ils vont commencer à augmenter : l'index zéro de « Feed » augmente lorsque l'on écrit - 1, 2, 3 :
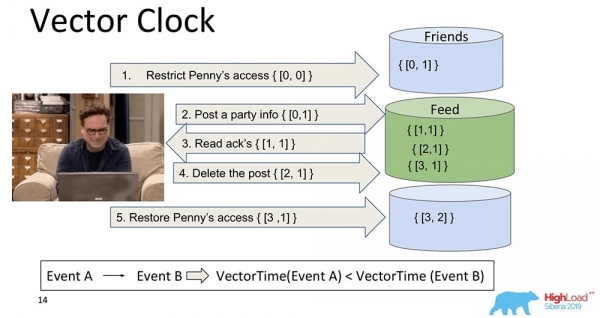
Pourquoi les horloges vectorielles sont-elles meilleures ? Parce qu'elles permettent de comprendre quels événements sont simultanés et quand ils se produisent sur différents nœuds. C'est très important pour un système de shard comme « MongoDB ». Cependant, nous ne l'avons pas choisi, bien que ce soit une très bonne chose, et cela fonctionne exceptionnellement bien, et cela nous aurait probablement convenu…
Si nous avons 10 000 shards, nous ne pouvons pas transmettre 10 000 composants, même si nous les compressons ou trouvons d'autres solutions - le payload sera toujours de plusieurs ordres de grandeur inférieur au volume total de ce vecteur. Par conséquent, à contrecœur, nous avons abandonné cette approche et sommes passés à une autre.
Spanner TrueTime. Horloges atomiques
J'ai dit qu'il y aurait un exposé sur « Spanner ». C'est une chose géniale, vraiment du XXIe siècle : horloges atomiques, synchronisation GPS.
Quelle est l'idée ? « Spanner » est le système de Google qui est récemment devenu accessible au public (ils lui ont ajouté SQL). Chaque transaction a un certain timestamp. Comme le temps est synchronisé*, chaque événement peut se voir attribuer un certain temps - les horloges atomiques ont un temps d'attente, après lequel un autre temps se produit déjà.
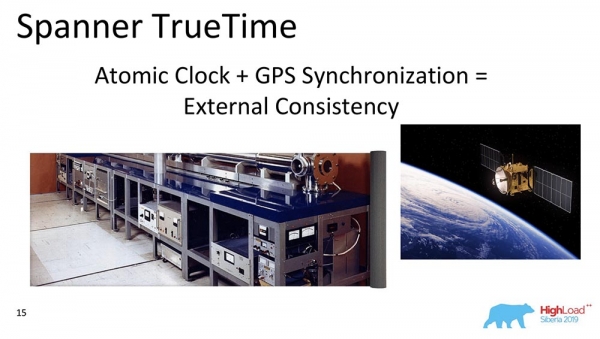
Ainsi, en enregistrant simplement dans la base de données et en attendant une certaine période, la sérialisation des événements est automatiquement garantie. Ils ont le modèle de consistance le plus robuste que l'on puisse imaginer - il s'agit de Consistance Externe.
* C'est le principal problème des horloges de Lamport - elles ne sont jamais synchronisées dans des systèmes distribués. Elles peuvent diverger, même avec NTP, elles ne fonctionnent toujours pas très bien. « Spanner » possède des horloges atomiques et une synchronisation, semble-t-il, jusqu'à la microseconde.
Pourquoi ne l'avons-nous pas choisi ? Nous ne supposons pas que nos utilisateurs aient d'horloges atomiques intégrées. Quand elles seront intégrées à chaque ordinateur portable, avec une super synchronisation GPS - alors oui… Mais pour l'instant, le meilleur que nous pouvons faire - ce sont les « Amazon », Stations de base - pour les passionnés… C'est pourquoi nous avons utilisé d'autres horloges.
Horloges hybrides (Hybrid Clock)
C'est en fait ce qui fonctionne dans «MongoDB» pour assurer la cohérence causale. En quoi sont-ils hybrides ? Un hybride est une valeur scalaire, mais elle se compose de deux composants :
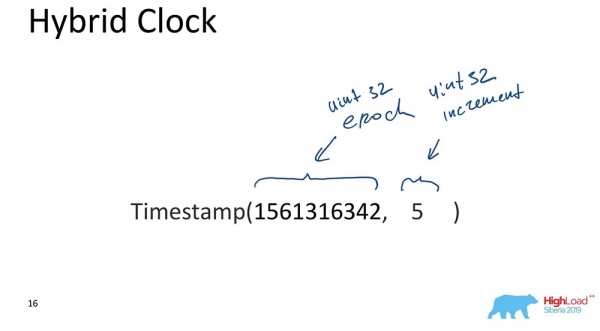
- Le premier est l'époque Unix (le nombre de secondes écoulées depuis le «début du monde informatique»).
- Le second est un certain incrément, également un entier non signé de 32 bits.
Voilà, c'est tout. Il existe une approche : la partie qui gère le temps se synchronise en permanence avec l'horloge ; chaque fois qu'une mise à jour se produit, cette partie est synchronisée avec l'horloge, et il en résulte que le temps est toujours relativement correct, alors que l'incrément permet de distinguer les événements survenus au même moment.
Pourquoi est-ce important pour «MongoDB» ? Parce que cela permet de faire des backups-restaurations à un moment donné, c'est-à-dire que l'événement est indexé par le temps. C'est crucial lorsque certains événements sont nécessaires ; pour les bases de données, les événements sont des modifications dans la base de données qui se sont produites à des moments précis.
Je ne vais vous dire que la principale raison (s'il vous plaît, ne le dites à personne) ! Nous l'avons fait parce que c'est ainsi que les données ordonnées et indexées apparaissent dans le MongoDB OpLog. L'OpLog est une structure de données qui contient toutes les modifications dans la base : elles d'abord entrent dans l'OpLog, puis sont appliquées au stockage lorsque les données sont répliquées ou shardées.
C'était la raison principale. Néanmoins, il existe également des exigences pratiques pour le développement de la base, ce qui signifie que cela doit être simple - peu de code, le moins de choses cassées à réécrire et à tester. Le fait que nos oplogs ont été indexés avec des horloges hybrides a beaucoup aidé et a permis de faire le bon choix. Cela a vraiment porté ses fruits et a fonctionné de manière presque magique, dès le premier prototype. C'était vraiment génial !
Synchronisation des horloges
Il existe plusieurs méthodes de synchronisation décrites dans la littérature scientifique. Je parle de synchronisation lorsque nous avons deux shards différents. Si nous avons un replica set, alors aucune synchronisation n'est nécessaire : c'est un « single-master » ; nous avons un OpLog dans lequel toutes les modifications sont enregistrées - dans ce cas, tout est déjà ordonné séquentiellement dans l' « OpLog ». Mais s'il y a deux shards différents, ici la synchronisation du temps devient importante. C'est là que les horloges vectorielles aident davantage ! Mais nous ne les avons pas.
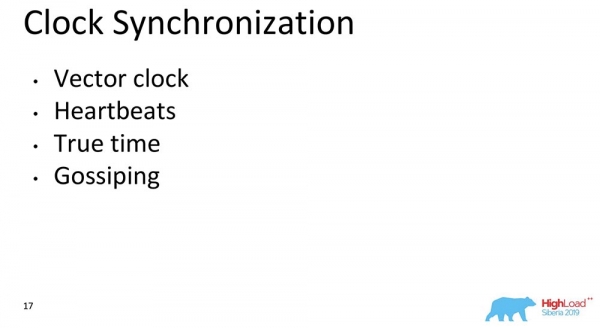
Le deuxième moyen est les « Heartbeats ». Nous pouvons échanger certains signaux qui se produisent à chaque unité de temps. Mais les « Heartbeats » sont trop lents, nous ne pouvons pas garantir la latence à notre client.
Le temps véritable – c'est évidemment une belle chose. Mais, encore une fois, c'est probablement l'avenir… Bien que dans « Atlas » il est déjà possible de le faire, il existe déjà des synchroniseurs de temps rapides « à la mode d'Amazon ». Mais cela ne sera pas accessible à tout le monde.
Le Gossiping – c'est lorsque tous les messages incluent le temps. C'est à peu près ce que nous utilisons. Chaque message entre les nœuds, le pilote, le routeur de nœuds de données, absolument tout pour « MongoDB » – ce sont des éléments, des composants de la base de données qui contiennent des horloges qui coulent. Ils ont tous une valeur de temps hybride, elle est transmise. 64 bits ? Cela permet, c'est possible.
Comment tout cela fonctionne-t-il ensemble ?
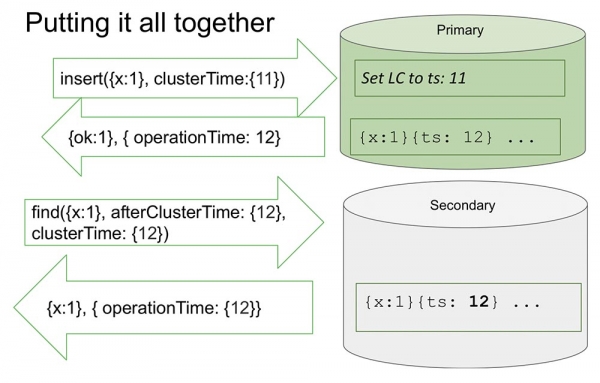
Ici, j'examine un replica set pour que ce soit un peu plus simple. Il y a un Primary et un Secondary. Le Secondary effectue la réplication et n'est pas toujours complètement synchronisé avec le Primary.
Une insertion (insert) est effectuée dans le « Primary » avec une certaine valeur de temps. Cette insertion augmente le compteur interne de 11, si c'est le maximum. Sinon, il vérifiera les valeurs de l'horloge et se synchronisera si les valeurs de l'horloge sont plus élevées. Cela permet d'ordonner par temps.
Après qu'il ait effectué l'écriture, un moment important se produit. Les horloges dans « MongoDB » s'incrémentent uniquement lors d'une écriture dans l'« OpLog ». C'est cela qui constitue un événement qui change l'état du système. Absolument dans tous les articles classiques, un événement est considéré comme l'arrivée d'un message dans un nœud : un message est arrivé – cela signifie que le système a changé son état.
Cela est dû à la difficulté d'interpréter comment ce message sera compris lors de l'exploration. Nous savons exactement que s'il n'est pas reflété dans le « Oplog », alors il ne sera pas interprété du tout, et le seul changement d'état du système est l'enregistrement dans l'« Oplog ». Cela nous simplifie tout : le modèle est simplifié et permet d'organiser les choses au sein d'un même replica set, avec beaucoup d'autres avantages.
La valeur qui a déjà été enregistrée dans l'« Oplog » est retournée – nous savons que cette valeur se trouve déjà dans l'« Oplog », et son temps est 12. Maintenant, disons qu'une lecture commence à partir d'un autre nœud (Secondary), et il transmet déjà afterClusterTime dans le message lui-même. Il dit : « J'ai besoin de tout ce qui s'est passé au moins après 12 ou à 12 heures » (voir illustration ci-dessus).
C'est ce qu'on appelle Causal a consistent (CAT). Il existe un concept en théorie qui désigne une tranche de temps qui est cohérente en soi. Dans ce cas, on peut dire que c'est l'état du système observé au moment 12.
Actuellement, il n'y a rien ici, car cela simule une situation où le Secondary doit répliquer des données du Primary. Il attend… Et maintenant les données sont arrivées – elles retournent ces valeurs.
Voilà comment tout cela fonctionne. À peu près.
Que signifie « à peu près » ? Supposons qu'il y a une personne qui a lu et compris comment tout cela fonctionne. Elle a compris qu'à chaque fois, un ClusterTime se produit, il met à jour ses horloges logiques internes, et ensuite, le prochain enregistrement augmente de un. Cette fonction occupe 20 lignes. Supposons que cette personne transmet un nombre 64 bits maximum, moins un.
Pourquoi « moins un » ? Parce que les horloges internes seront insérées dans cette valeur (évidemment, c'est le plus grand possible et plus grand que le temps actuel), ensuite une écriture se produira dans l'« Oplog », et les horloges seront incrémentées d'un autre – et ce sera déjà la valeur maximale (il n'y a que des unités là-dedans, il n'y a pas d'autre place, unsaint int's).
Il est évident qu'après cela, le système devient complètement inaccessible pour quoi que ce soit. On ne peut que le décharger, le nettoyer – c'est beaucoup de travail manuel. Disponibilité totale :
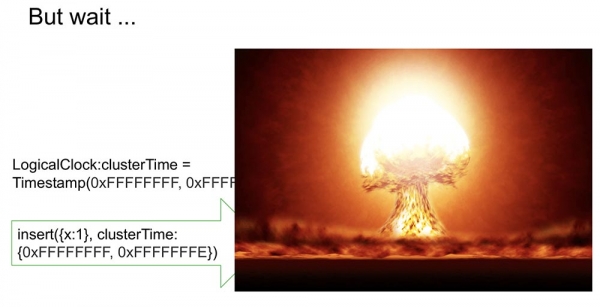
En effet, si cela est répliqué ailleurs, cela fait s'effondrer tout le cluster. C'est une situation absolument inacceptable, que n'importe qui peut organiser très rapidement et facilement ! C'est pourquoi nous considérons ce point comme l'un des plus importants. Comment le prévenir ?
Notre méthode consiste à signer clusterTime
Ainsi, cela est transmis dans le message (avant le texte en bleu). Mais nous avons également commencé à générer une signature (texte en bleu) :
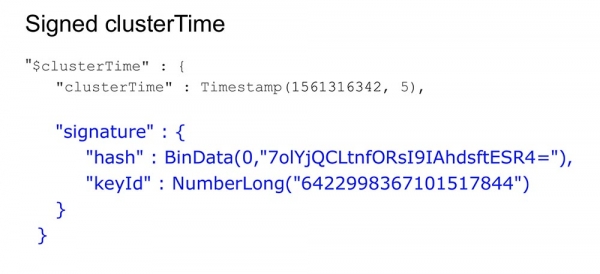
La signature est générée par une clé, qui est stockée dans la base de données, à l'intérieur d'un périmètre sécurisé ; elle est générée, mise à jour (les utilisateurs ne voient rien de cela). Un hash est généré, et chaque message est signé à sa création et validé à sa réception.
Les gens se posent probablement la question : « Est-ce que cela ralentit tout ça ? » J'ai dit que cela devait fonctionner rapidement, surtout en l'absence de cette fonctionnalité.
Que signifie utiliser la cohérence causale dans ce cas ? Cela consiste à afficher le paramètre afterClusterTime. Sinon, il transmettra simplement les valeurs quoi qu'il arrive. Le Gossiping, à partir de la version 3.6, fonctionne toujours.
Si nous maintenons une génération constante de signatures, cela ralentira le système même en l'absence de cette fonctionnalité, ce qui ne correspond pas à nos approches et exigences. Et que avons-nous fait ?
Fais-le rapidement !
C'est une chose assez simple, mais le truc est intéressant - je vais partager, peut-être que cela intéressera quelqu'un.
Nous avons un hash dans lequel sont stockées les données signées. Toutes les données passent par un cache. Le cache ne signe pas un temps spécifique, mais un Range. Lorsqu'une certaine valeur arrive, nous générons un Range, masquons les 16 derniers bits, et cette valeur est signée :
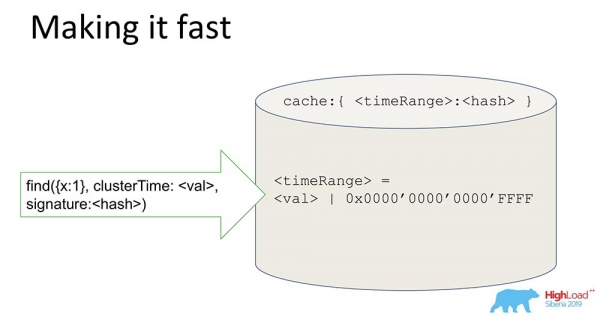
En obtenant une telle signature, nous accélérons le système (en condition) de 65 000 fois. Cela fonctionne très bien : lorsque nous avons réalisé des expériences - le temps s'est réellement réduit de 10 000 fois lors de nos mises à jour successives. Évidemment, cela ne fonctionne pas lorsque les mises à jour sont désynchronisées. Mais dans la plupart des cas pratiques, cela fonctionne. La combinaison de la signature du Range avec la signature a permis de résoudre le problème de sécurité.
Qu'avons-nous appris ?
Les leçons que nous en avons tirées :
- Il est nécessaire de lire des documents, des histoires, des articles, car nous avons beaucoup de choses intéressantes à partager. Lorsque nous travaillons sur une fonctionnalité (surtout maintenant, quand nous avons fait des transactions, etc.), il est important de lire et de comprendre. Cela prend du temps, mais c'est en réalité très utile, car cela nous permet de comprendre où nous en sommes. Nous n'avons pas vraiment inventé quelque chose de nouveau – nous avons simplement pris des ingrédients.
Il existe en effet une certaine différence de pensée lorsqu'une conférence académique a lieu (comme celle de « Sigmon », par exemple) – là-bas, tout le monde se concentre sur de nouvelles idées. Quelle est l'innovation de notre algorithme ? Il n'y a pas vraiment de nouveauté ici. L'innovation réside plutôt dans la façon dont nous avons mélangé ensemble des approches existantes. Donc, la première chose à faire est de lire les classiques, en commençant par Lamport.
- En production, les exigences sont complètement différentes. Je suis sûr que beaucoup d'entre vous ne rencontrent pas des bases de données « sphériques » dans un vide abstrait, mais des choses normales et réelles, qui ont des problèmes de disponibilité, de latence et de tolérance aux pannes.
- Enfin, nous avons dû examiner différentes idées et combiner plusieurs articles très différents en une seule approche. L'idée de la signature, par exemple, vient d'un article qui examinait le protocole Paxos, qui s'applique aux failles non byzantines à l'intérieur du protocole d'autorisation, et pour les byzantines – en dehors du protocole d'autorisation… En gros, c'est exactement ce que nous avons fini par faire.
Il n'y a absolument rien de nouveau ici ! Mais une fois que nous avons tout mélangé… C'est comme dire que la recette de la salade Olivier est une absurdité, parce que les œufs, la mayonnaise et les cornichons existent déjà… C'est à peu près la même histoire.
Je vais conclure ici. Merci !
Questions
Question du public (Q) : – Merci, Mikhaïl, pour votre présentation ! Le sujet du temps est intéressant. Vous utilisez le Gossiping. Vous avez dit que tout le monde a son propre temps, chacun connaît son temps local. J'ai compris qu'il existe un driver – il peut y avoir beaucoup de clients avec des drivers, il y a aussi beaucoup de query-planners et de shards… Que se passe-t-il dans le système si une divergence apparaît : quelqu'un décide qu'il est une minute en avance, quelqu'un d'autre – une minute en retard ? Où nous retrouverons-nous ?
MT : – C'est en fait une excellente question ! Je voulais justement parler des shards. Si je comprends bien la question, nous avons la situation suivante : il y a le shard 1 et le shard 2, la lecture se fait à partir de ces deux shards – ils ont des divergences, ils n'interagissent pas entre eux car le temps qu'ils connaissent est différent, surtout le temps qu'ils ont dans les oplogs.
Disons que le shard 1 a fait un million d'enregistrements, le shard 2 – absolument rien, et une requête est arrivée aux deux shards. Et le premier a un afterClusterTime de plus d'un million. Dans cette situation, comme je l'ai expliqué, le shard 2 ne répondra jamais.
Q : – Je voulais savoir comment ils se synchronisent et choisissent un temps logique unique ?
MT : – Ils se synchronisent très simplement. Quand un shard reçoit un afterClusterTime et qu'il ne trouve pas le temps dans l'Oplog – il initie un no approved. C'est-à-dire qu'il élève manuellement son temps à cette valeur. Cela signifie qu'il n'a pas d'événements répondant à cette requête. Il crée cet événement artificiellement et devient ainsi Causal Consistent.
Q : – Et si après cela, d'autres événements arrivent, qui se seraient perdus dans le réseau ?
MT : – Le shard est conçu de telle sorte qu'ils n'arriveront plus, car il s'agit d'un single master. S'il a déjà enregistré, ils n'arriveront plus, mais cela sera après. Il ne peut pas arriver que quelque chose soit bloqué quelque part, puis il fasse un no write, puis ces événements arrivent – et que la Causal consistency soit violée. Quand il fait un no write, ils doivent tous arriver après (il les attend).
Q : – J'ai plusieurs questions concernant les files d'attente. La Causal consistency suppose qu'il y a une certaine file d'actions à effectuer. Que se passe-t-il si un paquet disparaît ? Par exemple, le 10ème, 11ème… Le 12ème a disparu, et tous les autres attendent qu'il soit exécuté. Et soudain, notre machine est tombée en panne, nous ne pouvons rien faire. Y a-t-il une longueur maximale de la file qui peut s'accumuler avant d'être exécutée ? Quelle défaillance fatale se produit lors de la perte d'un seul état ? D'autant plus que si nous enregistrons qu'il y a un état précédent, nous devons nous y référer d'une certaine manière ? Mais nous n'avons pas pu nous y référer !
MT : – C'est aussi une excellente question ! Que faisons-nous ? Dans MongoDB, il y a le concept d'écritures de quorum, de lectures de quorum. Dans quels cas un message peut-il disparaître ? Quand l'écriture n'est pas de quorum ou quand la lecture n'est pas de quorum (cela peut aussi introduire des déchets).
Concernant la cohérence causale, nous avons réalisé une vaste évaluation expérimentale dont le résultat montre que lorsque les écritures et les lectures sont non quorum, des violations de la cohérence causale surviennent. Exactement ce que vous dites !
Notre conseil : utiliser au moins une lecture de quorum lors de l'utilisation de la cohérence causale. Dans ce cas, rien ne sera perdu, même si l'écriture de quorum est perdue… C'est une situation orthogonale : si l'utilisateur ne veut pas que des données soient perdues, il doit utiliser une écriture de quorum. La cohérence causale ne garantit pas la durabilité. La durabilité est garantie par la réplication et le mécanisme associé à la réplication.
Q : – Quand nous créons une instance qui exécute le sharding (pas le maître, mais l'esclave, respectivement), elle s'appuie sur l'heure UNIX de sa propre machine ou sur l'heure du 'maître' ; est-elle synchronisée une première fois ou périodiquement ?
MT : – Laissez-moi clarifier. Un shard (c'est-à-dire une partition horizontale) a toujours un primaire. Et dans un shard, il peut y avoir un 'maître' et des répliques. Mais le shard reçoit toujours des écritures, car il doit maintenir un certain domaine (un primaire est présent dans le shard).
Q : – Donc tout dépend strictement du 'maître' ? L'heure du 'maître' est toujours utilisée ?
MT : – Oui. On peut dire de manière figurée : les horloges tournent lorsque l'écriture se produit dans le 'maître', dans l'OpLog.
Q : – Nous avons un client qui se connecte, et il n'a pas besoin de rien savoir sur l'heure ?
MT : – Il n'a absolument besoin de rien savoir ! Si l'on parle de la façon dont cela fonctionne pour le client : quand le client souhaite utiliser la cohérence causale, il doit ouvrir une session. Actuellement, tout est là : les transactions dans la session et les droits à récupérer… Une session est un ordre des événements logiques se produisant avec le client.
S'il ouvre cette session et indique qu'il souhaite la cohérence causale (si par défaut la session supporte la cohérence causale), tout fonctionne automatiquement. Le pilote se rappelle de cette heure et l'augmente lorsqu'il reçoit un nouveau message. Il mémorise quelle réponse a été retournée par le précédent serveur qui a renvoyé des données. La prochaine demande contiendra afterCluster ('temps supérieur à cela').
Le client n'a absolument rien à savoir ! C'est totalement opaque pour lui. Si des personnes utilisent ces fonctionnalités, que permet-on de faire ? Tout d'abord, on peut lire en toute sécurité depuis des secundaires : on peut écrire sur le Primary et lire à partir de secundaires géographiquement répliqués en s'assurant que cela fonctionne. De plus, les sessions enregistrées sur le Primary peuvent même être transférées sur le Secondary, c'est-à-dire qu'il est possible d'utiliser non pas une session, mais plusieurs.
Q : – Le thème de la cohérence éventuelle est étroitement lié à une nouvelle branche de l'informatique – les types de données CRDT (Conflict-free Replicated Data Types). Avez-vous envisagé l'intégration de ces types de données dans votre base et que pouvez-vous en dire ?
MT : – Bonne question ! Les CRDT ont du sens pour les conflits d'écriture : dans MongoDB, il y a un maître unique.
Q : – J'ai une question de la part des devops. Dans le monde actuel, on rencontre des situations de type jésuite, où des échecs byzantins se produisent, et où de mauvaises personnes à l'intérieur du périmètre protégé commencent à trifouiller le protocole, en envoyant des paquets spécialement conçus ?
MT : – De mauvaises personnes à l'intérieur du périmètre, c'est comme un cheval de Troie ! Ces personnes peuvent faire beaucoup de mauvaises choses.
Q : – Il est évident que laisser sur le serveur, pour le dire simplement, une petite ouverture par laquelle on peut faire passer un zoo d'éléphants et faire s'effondrer tout le cluster pour toujours… Cela prendra du temps pour une restauration manuelle… C'est, pour le dire légèrement, incorrect. D'un autre côté, il est intéressant de se demander : dans la vie réelle, rencontre-t-on des situations où de telles attaques internes se produisent ?
MT : – Étant donné que je fais rarement face à des violations de la sécurité dans la vie réelle, je ne peux pas dire – peut-être qu'elles se produisent. Mais si l'on parle de philosophie de développement, nous pensons ceci : nous avons un périmètre qui sécurise les personnes en charge de la sécurité – c'est la serrure, le mur ; et à l'intérieur du périmètre, on peut faire tout ce qu'on veut. Évidemment, il y a des utilisateurs qui ont seulement la possibilité de consulter, et d'autres qui peuvent supprimer des répertoires.
Selon les droits, les dommages que les utilisateurs peuvent causer peuvent être ceux d'une souris ou d'un éléphant. Il est clair qu'un utilisateur ayant des droits complets peut faire absolument ce qu'il veut. Un utilisateur avec des droits restreints peut causer beaucoup moins de dégâts. En particulier, il ne peut pas briser le système.
Q : – Dans un périmètre sécurisé, quelqu'un a réussi à établir des protocoles inattendus pour le serveur, afin de l'attaquer, et si tout va bien, peut-être même tout le cluster... Est-ce que cela peut aller jusqu'à être si "bien" ?
MT : – Je n'ai jamais entendu parler de telles choses. Que l'on puisse mettre un serveur à genoux de cette manière n'est un secret pour personne. À l'intérieur, en utilisant le protocole, en étant un utilisateur authentifié qui peut écrire quelque chose dans le message... En réalité, ce n'est pas possible, car cela sera quand même vérifié. Il est possible de désactiver cette authentification pour les utilisateurs qui ne le souhaitent pas – c'est alors leur problème ; en gros, ils ont eux-mêmes détruit les murs et on peut y introduire un éléphant qui écrasera tout... En fait, on peut se déguiser en réparateur, entrer et le retirer !
Q : – Merci pour la présentation. Sergey ("Yandex"). Dans "Mongo", il y a une constante qui limite le nombre de membres votants dans le Replica Set, et cette constante est égale à 7 (sept). Pourquoi est-ce une constante ? Pourquoi ce n'est pas un paramètre quelconque ?
MT : – Un Replica Set peut avoir jusqu'à 40 nœuds. Il y a toujours une majorité. Je ne sais pas quelle version...
Q : – Dans un Replica Set, il est possible de faire fonctionner des membres non votants, mais pour les votants, le maximum est de 7. Comment gérer un arrêt dans ce cas si notre Replica Set est réparti sur 3 centres de données ? Un centre de données peut facilement être mis hors service, et une autre machine peut également tomber.
MT : – Cela dépasse un peu le cadre de la présentation. C'est une question générale. Je pourrais en parler plus tard.
Un peu de publicité 🙂
Merci de rester avec nous. Aimez-vous nos articles ? Voulez-vous voir plus de contenu intéressant ? Soutenez-nous en passants une commande ou en nous recommandant à des amis, , un équivalent unique des serveurs d'entrée de gamme, conçu pour vous : (options disponibles avec RAID1 et RAID10, jusqu'à 24 cœurs et jusqu'à 40 Go DDR4).
Dell R730xd deux fois moins cher dans le data center Equinix Tier IV à Amsterdam ? Uniquement chez nous aux Pays-Bas ! Dell R420 — 2x E5-2430 2.2GHz 6C 128Go DDR3 2x960Go SSD 1Gbps 100To — à partir de 99 $ ! Lisez sur
Source : habr.com
