

Note de traduction.: Dans cet article, l'entreprise Banzai Cloud partage un exemple d'utilisation de ses outils spéciaux pour faciliter l'exploitation de Kafka au sein de Kubernetes. Les instructions fournies illustrent comment déterminer la taille optimale de l'infrastructure et configurer Kafka pour atteindre la bande passante requise.
Apache Kafka est une plateforme de streaming distribuée pour créer des systèmes de flux en temps réel fiables, évolutifs et hautes performances. Ses capacités impressionnantes peuvent être étendues grâce à Kubernetes. Pour cela, nous avons développé et un outil nommé . Ils permettent de faire fonctionner Kafka dans Kubernetes et d'utiliser ses diverses fonctionnalités, telles que l'affinage de la configuration des brokers, le redimensionnement basé sur des métriques avec rééquilibrage, la sensibilisation aux racks (rack awareness), le déploiement en douceur (graceful) des mises à jour, etc.
Essayez Supertubes dans votre cluster :
curl https://getsupertubes.sh | sh et supertubes install -a --no-democluster --kubeconfigOu reportez-vous à . Vous pouvez également lire sur certaines fonctionnalités de Kafka, dont l'automatisation est réalisée grâce à Supertubes et à l'opérateur Kafka. Nous en avons déjà parlé sur le blog :
- ;
- ;
- ;
- ;
- ;
- ;
- .
En décidant de déployer un cluster Kafka dans Kubernetes, vous serez sûrement confronté au problème de la détermination de la taille optimale de l'infrastructure de base et à la nécessité d'affiner la configuration de Kafka pour répondre aux exigences en matière de capacité de traitement. La performance maximale de chaque broker est déterminée par la performance des composants de l'infrastructure sous-jacente, tels que la mémoire, le processeur, la vitesse du disque, la bande passante réseau, etc.
Idéalement, la configuration du broker devrait permettre à tous les éléments de l'infrastructure d'être utilisés à leur pleine capacité. Cependant, dans la réalité, un tel réglage est assez complexe. Il est plus probable que les utilisateurs configureront les brokers de manière à maximiser l'utilisation d'un ou deux composants (disque, mémoire ou processeur). En général, un broker montre une performance maximale lorsque sa configuration permet d'exploiter pleinement le composant le plus lent. Ainsi, nous pouvons avoir une idée approximative de la charge qu'un seul broker peut gérer.
Théoriquement, nous pouvons également estimer le nombre de brokers nécessaires pour traiter une charge donnée. Cependant, dans la pratique, les options de configuration à différents niveaux sont si nombreuses qu'il est très difficile (voire impossible) d'évaluer la performance potentielle d'une configuration donnée. En d'autres termes, il est très compliqué de planifier une configuration en se basant sur une performance donnée.
Pour les utilisateurs de Supertubes, nous appliquons généralement l'approche suivante : nous commençons par une certaine configuration (infrastructure + réglages), puis nous mesurons sa performance, ajustons les réglages du broker et répétons le processus. Cela se déroule jusqu'à ce que le potentiel du composant le plus lent de l'infrastructure soit complètement exploité.
De cette manière, nous obtenons une vision plus claire du nombre de brokers nécessaires au cluster pour gérer une charge donnée (le nombre de brokers dépend également d'autres facteurs, tels que le nombre minimum de répliques de messages pour assurer la résilience, le nombre de leaders de partition, etc.). De plus, nous avons une idée de quel composant infrastructurel devrait idéalement être mis à l'échelle verticalement.
Dans cet article, nous aborderons les étapes que nous entreprenons pour 'tirer le meilleur parti' des composants les plus lents dans les configurations initiales et mesurer la capacité de traitement du cluster Kafka. Une configuration hautement disponible nécessite au moins trois brokers opérationnels (min.insync.replicas=3), répartis sur trois zones de disponibilité différentes. Pour configurer, évoluer et surveiller l'infrastructure Kubernetes, nous utilisons notre propre plateforme de gestion des conteneurs pour les cloud hybrides — . Elle prend en charge on-premise (bare metal, VMware) et cinq types de cloud (Alibaba, AWS, Azure, Google, Oracle), ainsi que toutes leurs combinaisons.
Réflexions sur l'infrastructure et la configuration du cluster Kafka
Pour les exemples ci-dessous, nous avons choisi AWS comme fournisseur de cloud et EKS comme distribution Kubernetes. Une configuration similaire peut être réalisée avec — la distribution Kubernetes de Banzai Cloud, certifiée par la CNCF.
Disque
Amazon propose différents . À la base, gp2 et io1 reposent sur des disques SSD, mais pour garantir un débit élevé, gp2 pointe consommée des crédits I/O (I/O credits), c'est pourquoi nous avons préféré le type io1, qui offre un débit élevé stable.
Types d'instances
La performance de Kafka dépend fortement du cache de page du système d'exploitation, nous avons donc besoin d'instances avec suffisamment de mémoire pour les courtiers (JVM) et le cache de page. L'instance c5.2xlarge est un bon début, car elle dispose de 16 Go de mémoire et . Son inconvénient est qu'elle peut atteindre des performances maximales pendant pas plus de 30 minutes toutes les 24 heures. Si la charge de travail nécessite des performances maximales pendant une période prolongée, il convient d'explorer d'autres types d'instances. C'est exactement ce que nous avons fait en nous arrêtant sur c5.4xlarge. Il fournit un débit maximal de 593,75 Mo/s. Le débit maximal d'un volume EBS io1 est supérieur à celui de l'instance c5.4xlarge, donc le maillon le plus lent de l'infrastructure est probablement le débit I/O de ce type d'instance (ce que les résultats de nos tests de charge devraient également confirmer).
Réseau
Le débit réseau doit être suffisamment élevé par rapport à la performance de l'instance VM et du disque, sinon le réseau devient un goulot d'étranglement. Dans notre cas, l'interface réseau c5.4xlarge prend en charge une vitesse allant jusqu'à 10 Gb/s, ce qui est significativement supérieur au débit I/O de l'instance VM.
Déploiement des courtiers
Les courtiers doivent être déployés (planifiés dans Kubernetes) sur des nœuds dédiés afin d'éviter la concurrence avec d'autres processus pour les ressources CPU, mémoire, réseau et disque.
Version Java
Le choix logique est Java 11, car il est compatible avec Docker dans le sens où la JVM détecte correctement les processeurs et la mémoire disponibles pour le conteneur dans lequel le courtier fonctionne. Sachant que les limites de processeurs sont importantes, la JVM définit en interne et de manière transparente le nombre de threads GC et de threads JIT compilateurs. Nous avons utilisé l'image Kafka banzaicloud/kafka:2.13-2.4.0, comprenant la version Kafka 2.4.0 (Scala 2.13) sur Java 11.
Si vous souhaitez en savoir plus sur Java/JVM sur Kubernetes, consultez nos publications suivantes :
- ;
- .
Paramètres de mémoire du courtier
Il y a deux aspects clés dans la configuration de la mémoire du courtier : les paramètres pour la JVM et pour le pod Kubernetes. La limite de mémoire définie pour le pod doit être supérieure à la taille maximale du tas afin que la JVM ait de la place pour l'espace de métadonnées Java, qui réside en mémoire propre, et pour le cache de page du système d'exploitation, que Kafka utilise activement. Dans nos tests, nous avons exécuté des courtiers Kafka avec les paramètres -Xmx4G -Xms2G, tandis que la limite de mémoire pour le pod était de 10 Gi. Notez que les paramètres de mémoire pour la JVM peuvent être obtenus automatiquement grâce à -XX:MaxRAMPercentage et -X:MinRAMPercentage, en fonction de la limite de mémoire pour le pod.
Paramètres de processeur du courtier
En général, on peut améliorer les performances en augmentant le parallélisme grâce à une augmentation du nombre de threads utilisés par Kafka. Plus il y a de processeurs disponibles pour Kafka, mieux c'est. Dans notre test, nous avons commencé avec une limite de 6 processeurs et avons progressivement (par itérations) augmenté ce nombre à 15. De plus, nous avons défini num.network.threads=12 dans les paramètres du courtier pour augmenter le nombre de threads acceptant les données du réseau et les envoyant. Dès que nous avons découvert que les courtiers suiveurs ne pouvaient pas recevoir les répliques assez rapidement, nous avons augmenté num.replica.fetchers à 4 pour accroître la vitesse à laquelle les courtiers suiveurs répliquaient les messages des leaders.
Outil de génération de charge
Il est essentiel de s'assurer que le potentiel du générateur de charge choisi ne sera pas épuisé avant que le cluster Kafka (le benchmark en cours) n'atteigne sa charge maximale. En d'autres termes, une évaluation préalable des capacités de l'outil de génération de charge doit être effectuée, ainsi que le choix de types d'instances avec une quantité suffisante de processeurs et de mémoire. Dans ce cas, notre outil produira plus de charge que ce que le cluster Kafka peut gérer. Après de nombreuses expériences, nous avons opté pour trois instances c5.4xlarge, dont chacune a exécuté le générateur.
Benchmarking
La mesure de performance est un processus itératif comprenant les étapes suivantes :
- configuration de l'infrastructure (cluster EKS, cluster Kafka, outil de génération de charge, ainsi que Prometheus et Grafana);
- génération de charge pendant une période déterminée pour filtrer les écarts aléatoires dans les métriques de performance collectées;
- ajustement de l'infrastructure et de la configuration du broker en fonction des performances observées;
- répétition du processus jusqu'à ce que le niveau de bande passante requis pour le cluster Kafka soit atteint. Celui-ci doit être constamment reproductible et montrer des variations minimales de bande passante.
Dans la section suivante, les étapes suivies lors du benchmark du cluster de test sont décrites.
Outils
Pour un déploiement rapide de la configuration de base, la génération de charge et la mesure des performances, les outils suivants ont été utilisés :
- pour organiser le cluster EKS d'Amazon avec (pour la collecte des métriques de Kafka et de l'infrastructure) et (pour la visualisation de ces métriques). Nous avons utilisé des services intégrés dans qui assurent une surveillance fédérée, une collecte centralisée des logs, un scan des vulnérabilités, la récupération après sinistre, une sécurité de niveau entreprise et bien plus encore.
- est un outil de test de charge pour le cluster Kafka.
- Panneaux Grafana pour la visualisation des métriques de Kafka et de l'infrastructure : , .
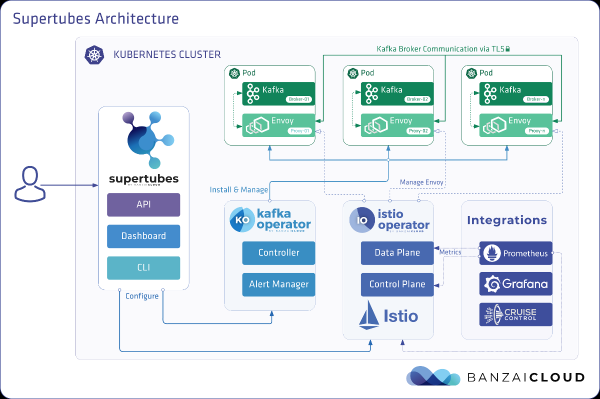
- Supertubes CLI pour une configuration simplifiée de votre cluster Kafka sur Kubernetes. Zookeeper, Kafka operator, Envoy et de nombreux autres composants sont installés et correctement configurés pour exécuter un cluster Kafka prêt pour la production sur Kubernetes.
- Pour l'installation supertubes CLI suivez les instructions fournies .
Cluster EKS
Préparer un cluster EKS avec des nœuds de travail dédiés c5.4xlarge dans différentes zones de disponibilité pour les pods avec des courtiers Kafka, ainsi que des nœuds dédiés pour le générateur de charge et l'infrastructure de surveillance.
banzai cluster create -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/cluster_eks_202001.jsonUne fois le cluster EKS opérationnel, activez son intégration — cela déploiera Prometheus et Grafana dans le cluster.
Composants système Kafka
Installez les composants système Kafka (Zookeeper, kafka-operator) dans l'EKS en utilisant supertubes CLI :
supertubes install -a --no-democluster --kubeconfigCluster Kafka
Par défaut, dans EKS, des volumes EBS de type gp2, il est donc nécessaire de créer une classe de stockage distincte basée sur les volumes io1 pour le cluster Kafka :
kubectl create -f - <<EOF
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fast-ssd
provisioner: kubernetes.io/aws-ebs
parameters:
  type: io1
  iopsPerGB: "50"
  fsType: ext4
volumeBindingMode: WaitForFirstConsumer
EOF
Configurez le paramètre pour les courtiers min.insync.replicas=3 et déployez les pods courtiers sur des nœuds dans trois zones de disponibilité différentes :
supertubes cluster create -n kafka --kubeconfig -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/kafka_202001_3brokers.yaml --wait --timeout 600Sujets
Nous avons lancé simultanément trois instances du générateur de charge. Chacune écrit dans son propre sujet, ce qui signifie que nous avons besoin de trois sujets au total :
supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest1
spec:
  name: perftest1
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
    name: perftest2
spec:
  name: perftest2
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest3
spec:
  name: perftest3
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF
Pour chaque sujet, le facteur de réplication est de 3 — la valeur minimale recommandée pour les systèmes de production hautement disponibles.
Outil de génération de charge
Nous avons lancé trois instances du générateur de charge (chacune écrivant dans un sujet séparé). Pour les pods du générateur de charge, il est nécessaire de définir l'affinité des nœuds, afin qu'ils soient planifiés uniquement sur les nœuds qui leur sont dédiés :
apiVersion: extensions/v1beta1
kind: Deployment
metadata:
  labels:
    app: loadtest
  name: perf-load1
  namespace: kafka
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      app: loadtest
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        app: loadtest
    spec:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: nodepool.banzaicloud.io/name
                operator: In
                values:
                - loadgen
      containers:
      - args:
        - -brokers=kafka-0:29092,kafka-1:29092,kafka-2:29092,kafka-3:29092
        - -topic=perftest1
        - -required-acks=all
        - -message-size=512
        - -workers=20
        image: banzaicloud/perfload:0.1.0-blog
        imagePullPolicy: Always
        name: sangrenel
        resources:
          limits:
            cpu: 2
            memory: 1Gi
          requests:
            cpu: 2
            memory: 1Gi
        terminationMessagePath: /dev/termination-log
        terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      terminationGracePeriodSeconds: 30
Quelques points à noter :
- Le générateur de charge génère des messages de 512 octets et les publie dans Kafka par lots de 500 messages.
- Avec l'argument
-required-acks=allla publication est considérée comme réussie lorsque tous les réplicas synchronisés du message ont été reçus et confirmés par les brokers Kafka. Cela signifie que lors du benchmark, nous avons mesuré non seulement la vitesse des leaders recevant les messages, mais aussi de leurs suiveurs répliquant ces messages. L'objectif de ce test n'est pas d'évaluer la vitesse de lecture des consommateurs (consumers) des messages récemment reçus, qui restent encore dans le cache de page du système d'exploitation, et sa comparaison avec la vitesse de lecture des messages stockés sur disque. - Le générateur de charge lance en parallèle 20 workers (
-workers=20). Chaque worker contient 5 producteurs, qui partagent ensemble la connexion du worker au cluster Kafka. Au final, chaque générateur compte 100 producteurs, et tous envoient des messages au cluster Kafka.
Surveillance de l'état du cluster
Lors des tests de charge du cluster Kafka, nous avons également surveillé sa santé pour nous assurer qu'il n'y avait pas de redémarrages de pod, de répliques désynchronisées et que la capacité maximale était atteinte avec des fluctuations minimales.
- Le générateur de charge écrit des statistiques standard sur le nombre de messages publiés et le niveau d'erreurs. Le pourcentage d'erreurs doit rester à
0,00%. - , déployé par kafka-operator, fournit un tableau de bord où nous pouvons également observer l'état du cluster. Pour afficher ce tableau de bord, exécutez :
supertubes cluster cruisecontrol show -n kafka --kubeconfig - Le niveau ISR (nombre de répliques « in-sync ») le shrink et l'expansion sont égaux à 0.
Résultats des mesures
3 brokers, taille des messages — 512 octets
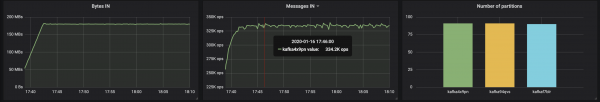
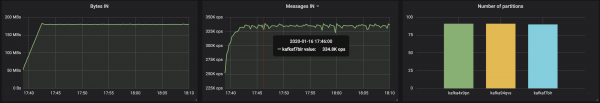
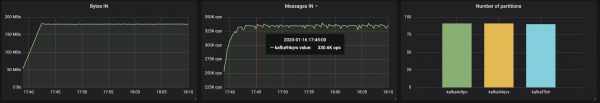
Avec des partitions uniformément réparties entre trois brokers, nous avons pu atteindre une performance ~500 Mo/s (environ 990 000 messages par seconde):
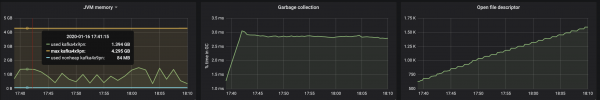
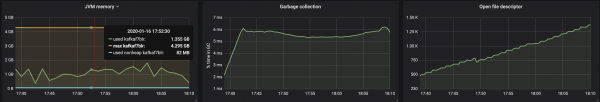
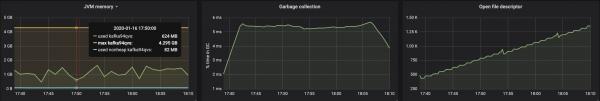
La consommation de mémoire de la machine virtuelle JVM n'a pas dépassé 2 Go :
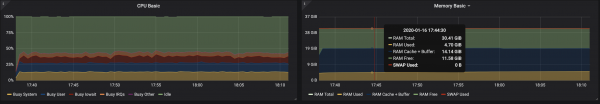
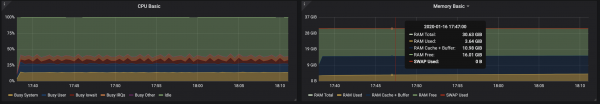
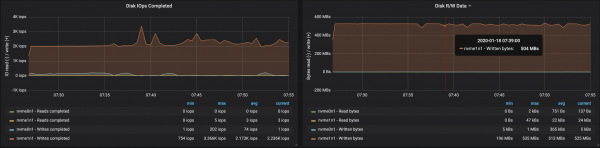
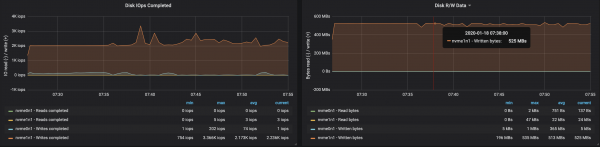
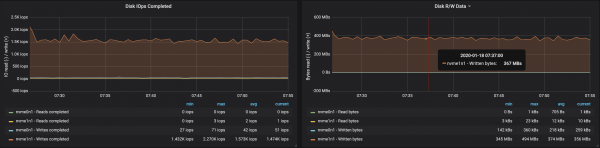
La capacité de disque a atteint le maximum de capacité I/O du nœud sur les trois instances où les brokers opéraient :
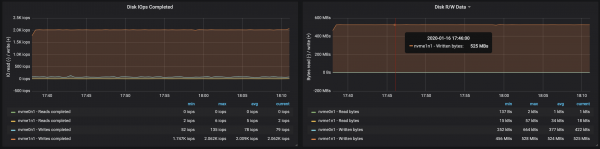
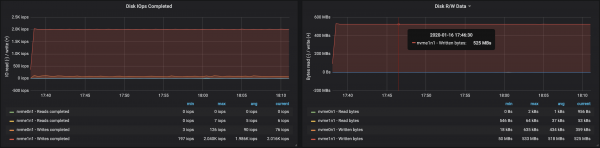
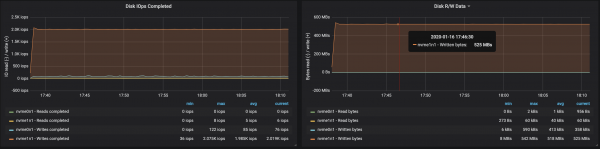
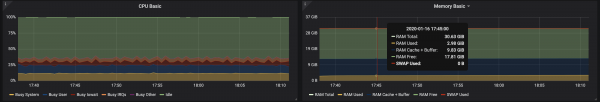
D'après les données sur l'utilisation de la mémoire par les nœuds, le buffering système et la mise en cache ont occupé environ 10-15 Go :
3 brokers, taille des messages — 100 octets
Avec la diminution de la taille des messages, la capacité de traitement chute d'environ 15-20 % : cela est dû au temps nécessaire à chaque message. De plus, la charge processeur a presque doublé.
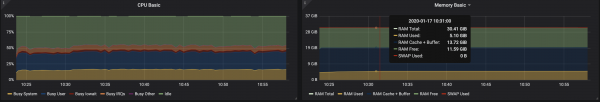
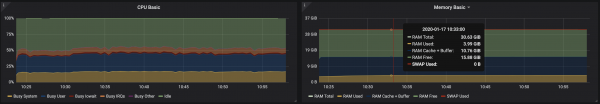
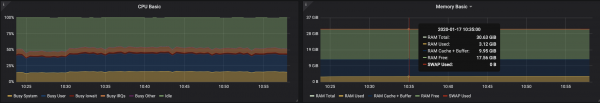
Étant donné qu'il reste des cœurs non utilisés sur les nœuds des brokers, la performance peut être améliorée en modifiant la configuration de Kafka. Cela représente un défi, donc pour augmenter la capacité, il est préférable de travailler avec des messages de plus grande taille.
4 brokers, taille des messages — 512 octets
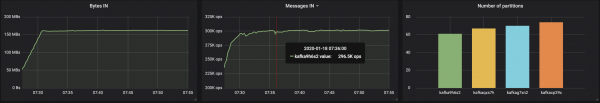
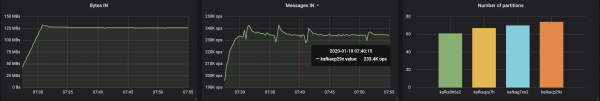
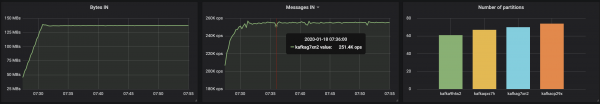
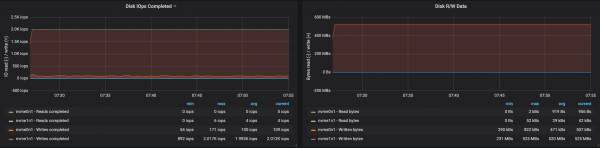
Il est facile d'augmenter la performance du cluster Kafka juste en ajoutant de nouveaux brokers et en maintenant l'équilibre des partitions (ce qui assure une répartition uniforme de la charge entre les brokers). Dans notre cas, après l'ajout d'un broker, la capacité du cluster a augmenté jusqu'à ~580 Mo/s (~1,1 million de messages par seconde). L'augmentation a été inférieure aux attentes : cela s'explique principalement par le déséquilibre des partitions (tous les brokers ne fonctionnent pas à leur pleine capacité).
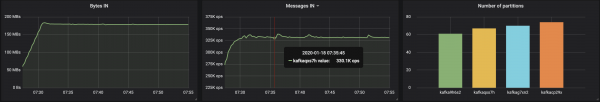
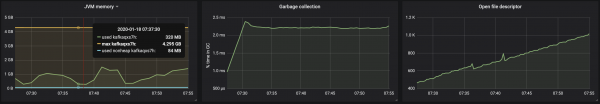
La consommation de mémoire par la machine JVM est restée en dessous de 2 Go :
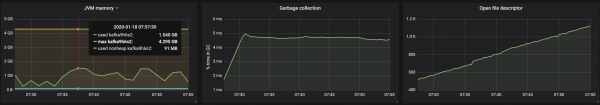
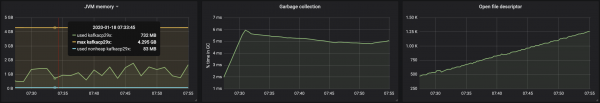
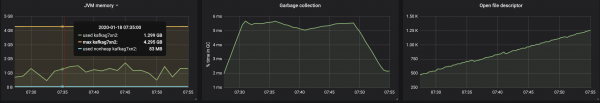
Le travail des courtiers avec des accumulateurs a été affecté par un déséquilibre des partitions :
Conclusions
L'approche itérative présentée ci-dessus peut être étendue pour couvrir des scénarios plus complexes incluant des centaines de consommateurs, le repartitionnement, des mises à jour en rolling, des redémarrages de pods, etc. Tout cela nous permet d'évaluer les limites des capacités du cluster Kafka dans diverses conditions, d'identifier les goulets d'étranglement dans son fonctionnement et de trouver des moyens de les surmonter.
Nous avons développé Supertubes pour un déploiement rapide et facile du cluster, sa configuration, l'ajout/retirement de courtiers et de sujets, la réponse aux alertes et l'assurance du bon fonctionnement de Kafka dans Kubernetes en général. Notre objectif est d'aider à se concentrer sur la tâche principale (« générer » et « consommer » des messages Kafka), tandis que tout le travail lourd est confié à Supertubes et à l'opérateur Kafka.
Si vous êtes intéressé par les technologies et les projets Open Source de Banzai Cloud, abonnez-vous à l'entreprise sur , ou .
P.S. de l'auteur
Lisez aussi dans notre blog :
- «»;
- «»;
- «».
Source : habr.com
