

Lorsque votre travail consiste à créer quelque chose de beau, il n'est pas nécessaire d'en parler beaucoup, car le résultat est visible pour tous. Par contre, si vous effacez des inscriptions sur des clôtures, personne ne remarquera votre travail tant que les clôtures restent présentables ou jusqu'à ce que vous effaciez quelque chose que vous ne devriez pas.
Tout service permettant de laisser un commentaire, un avis, d'envoyer un message ou de télécharger des images est tôt ou tard confronté au problème du spam, de la fraude et des contenus inappropriés. Il n'est pas possible d'y échapper, mais il faut y faire face.
Je m'appelle Mikhaïl, je fais partie de l'équipe Antispam qui protège les utilisateurs des services Yandex contre de tels problèmes. Notre travail est rarement visible (et c'est tant mieux !), c'est pourquoi aujourd'hui je vais vous en parler plus en détail. Vous découvrirez dans quelles circonstances la modération est inutile et pourquoi la précision n'est pas le seul indicateur de son efficacité. Nous parlerons également de l'utilisation d'injures en prenant les chats et les chiens comme exemples, et pourquoi il est parfois utile de « penser comme un juron ».
Yandex propose de plus en plus de services où les utilisateurs publient leur propre contenu. On peut poser une question ou donner une réponse sur Yandex.Q, discuter des nouvelles de son quartier sur Yandex.Rayon, ou partager des conditions de circulation dans des discussions sur Yandex.Maps. Mais lorsque l'audience du service grandit, il devient attractif pour les escrocs et les spammeurs. Ils viennent et remplissent les commentaires : proposant un gain facile, faisant la promotion de produits miracle et promettant des allocations sociales. À cause des spammeurs, certains utilisateurs perdent de l'argent, tandis que d'autres perdent l'envie d'utiliser un service négligé, envahi par le spam.
Et ce n'est pas le seul problème. Nous nous efforçons non seulement de protéger les utilisateurs contre les escrocs, mais aussi de créer une atmosphère confortable pour les échanges. Si les gens dans les commentaires font face à des jurons et des insultes, il y a de fortes chances qu'ils se retirent et ne reviennent jamais. Il faut donc aussi savoir lutter contre cela.
Web Propre
Comme cela arrive souvent chez nous, les premières avancées ont été réalisées dans la recherche, dans la partie qui lutte contre le spam dans les résultats. Il y a dix ans, une tâche de filtrage de contenus pour adultes a été mise en place pour les recherches familiales et pour des requêtes qui ne doivent pas contenir de réponses de la catégorie 18+. C'est ainsi que les premiers dictionnaires de pornographie et d'insultes, élaborés manuellement, ont vu le jour grâce à l'ajout d'analyses. L'objectif principal était de classer les requêtes en celles où il était acceptable d'afficher du contenu pour adultes et celles où cela ne l'était pas. Pour cette tâche, des annotations ont été collectées, des heuristiques ont été construites et des modèles ont été formés. Cela a conduit aux premières avancées pour le filtrage de contenu indésirable.
Avec le temps, un contenu généré par les utilisateurs (UGC) a commencé à apparaître dans Yandex — des messages rédigés par les utilisateurs eux-mêmes, que Yandex ne faisait que publier. Pour les raisons mentionnées ci-dessus, de nombreux messages ne pouvaient pas être publiés tels quels — une modération était nécessaire. On a alors décidé de créer un service qui fournirait une protection contre le spam et les malfaiteurs pour tous les produits UGC de Yandex, utilisant les avancées du filtrage de contenu indésirable dans la recherche. Le service a été nommé "Web Propre".
Nouvelles tâches et assistance des tolokers
Au début, nous n'avions qu'une simple automatisation : les services nous envoyaient des textes et nous appliquions sur eux des dictionnaires d'insultes, des dictionnaires de pornographie et des expressions régulières — les analystes compilaient tout manuellement. Mais avec le temps, le service a été utilisé pour un nombre croissant de produits Yandex, et nous avons dû apprendre à gérer de nouveaux problèmes.
Souvent, au lieu d'un avis, les utilisateurs publient une suite de lettres sans signification, essayant d'obtenir des récompenses, parfois ils font la publicité de leur entreprise dans des avis sur des entreprises concurrentes, et parfois ils confondent simplement les organisations, écrivant dans un avis sur une animalerie : « Poisson parfaitement préparé ! ». Peut-être qu'un jour l'intelligence artificielle saura saisir parfaitement le sens de n'importe quel texte, mais pour l'instant, l'automatique fonctionne parfois moins bien qu'un humain.
Il est devenu évident qu'il nous fallait un balisage manuel, et nous avons ajouté une deuxième étape à notre processus : l'envoi pour vérification par un humain. Les textes publiés qui ne présentaient pas de problèmes selon le classificateur étaient envoyés là. Vous pouvez facilement imaginer l'ampleur d'une telle tâche, c'est pourquoi nous ne nous sommes pas seulement fiés aux évaluateurs, mais avons également utilisé la « sagesse des foules », c'est-à-dire que nous avons fait appel à des travailleurs de la foule. Ce sont eux qui nous aident à identifier ce que la machine a manqué, et ainsi l'éduquent.
Mise en cache intelligente et hachage LSH
Un autre problème auquel nous avons été confrontés en travaillant avec les commentaires est le spam, ou plutôt, son volume et sa vitesse de propagation. Lorsque l'audience de Yandex.Region a commencé à croître rapidement, des spammeurs sont venus. Ils ont appris à contourner les expressions régulières en modifiant légèrement le texte. Bien sûr, nous parvenions toujours à détecter et supprimer le spam, mais à l'échelle de Yandex, un message inacceptable, même diffusé pendant 5 minutes, pouvait être vu par des centaines de personnes.
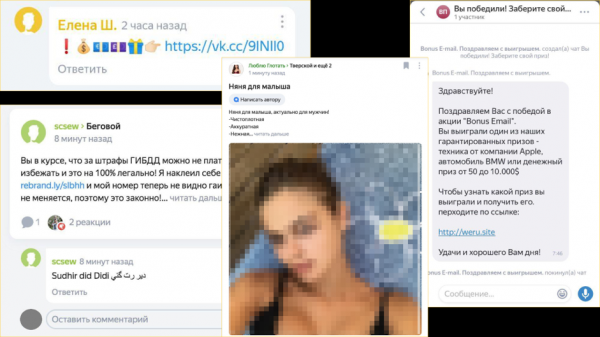
Cela ne nous convenait évidemment pas, et nous avons mis en œuvre une mise en cache intelligente des textes basée sur LSH (). Le fonctionnement est le suivant : nous normalisions le texte, supprimions les liens et le découpions en n-grammes (séquences de n lettres). Ensuite, nous calculions les hachages des n-grammes, et à partir de ceux-ci, nous construisions un vecteur LSH pour le document. L'idée est que des textes similaires, même légèrement modifiés, se transformaient en vecteurs similaires.
Cette solution a permis de réutiliser les verdicts des classificateurs et des travailleurs de la foule pour des textes similaires. Lors d'une attaque de spam, dès qu'un premier message passait la vérification et était enregistré en cache avec le verdict 'spam', tous les nouveaux messages similaires, même modifiés, recevaient le même verdict et étaient automatiquement supprimés. Plus tard, nous avons appris à entraîner et réentraîner automatiquement les classificateurs de spam, mais ce 'cache intelligent' est resté avec nous et nous aide encore souvent.
Classificateur de bons textes
À peine rétablis de la lutte contre le spam, nous avons réalisé que 95 % de notre contenu est modéré manuellement : les classificateurs réagissent uniquement aux violations, tandis que la plupart des textes sont de bonne qualité. Nous faisons appel à des annotateurs, qui dans 95 cas sur 100 donnent la note « Tout est OK ». Nous avons dû entreprendre un travail inhabituel — créer des classificateurs pour le bon contenu, heureusement, nous avons accumulé suffisamment de données pour cela en cours de route.
Le premier classificateur ressemblait à ceci : nous lemmatisons le texte (nous ramenons les mots à leur forme initiale), nous éliminons toutes les parties de discours fonctionnelles et appliquons un « dictionnaire de bonnes lemmes » préalablement préparé. Si tous les mots du texte sont « bons », alors le texte entier ne contient pas de violations. Cette approche a immédiatement permis d'automatiser de 25 à 35 % de l'annotation manuelle sur différents services. Bien sûr, cette méthode n'est pas parfaite : il est facile de combiner quelques mots innocents et d'obtenir une expression très offensante, mais elle nous a permis d'atteindre rapidement un bon niveau d'automatisation et nous a donné le temps de former des modèles plus complexes.
Les versions suivantes des classificateurs de bons textes comprenaient déjà des modèles linéaires, des arbres décisionnels et leurs combinaisons. Pour annoter les vulgarités et les insultes, par exemple, nous avons essayé le réseau de neurones BERT. Il est important de saisir le sens d'un mot dans son contexte et la relation entre les mots dans différentes phrases, et BERT s'en sort plutôt bien à ce niveau. (Au fait, récemment, nos collègues des Nouvelles , ont utilisé cette technologie pour une tâche atypique — rechercher des erreurs dans les titres.) Au final, nous avons réussi à automatiser jusqu'à 90 % du flux, selon le service.
Précision, exhaustivité et rapidité
Pour se développer, il faut comprendre quel bénéfice apportent les différents classificateurs automatiques, les modifications apportées et s'il n'y a pas de dégradation de la qualité des vérifications manuelles. Pour cela, nous utilisons des indicateurs de précision et d'exhaustivité.
La précision est la part de verdicts corrects parmi tous les verdicts concernant le mauvais contenu. Plus la précision est élevée, moins il y a de faux positifs. Si l'on ne surveille pas la précision, il est théoriquement possible de supprimer tout le spam et le langage inapproprié, emportant avec eux une partie des bons messages. D'un autre côté, si l'on se fie uniquement à la précision, la meilleure technologie serait celle qui n'attrape personne. C'est pourquoi il existe également un indicateur de complétude : la part de mauvais contenu identifié parmi l'ensemble du volume de mauvais contenu. Ces deux métriques se complètent mutuellement.
Pour mesurer cela, nous échantillonnons tout le flux entrant de chaque service et fournissons des échantillons de contenu à des évaluateurs pour une évaluation experte et une comparaison avec les décisions de la machine.
Mais il existe un autre indicateur important.
J'ai mentionné plus haut qu'un message inacceptable peut être vu par des centaines de personnes en seulement 5 minutes. C'est pourquoi nous comptons combien de fois nous avons pu montrer aux gens un mauvais contenu avant de l'avoir caché. Cela est important, car il ne suffit pas de travailler de manière qualitative — il faut aussi travailler rapidement. Et lorsque nous avons construit une protection contre le langage inapproprié, nous l’avons pleinement ressenti.
L'anti-langage inapproprié illustré par des chatons et des chiots
Une petite digression. Certains pourraient dire que le langage inapproprié et les insultes ne sont pas aussi dangereux que les liens malveillants et ne sont pas aussi ennuyeux que le spam. Mais nous nous efforçons de maintenir des conditions agréables pour la communication de millions d'utilisateurs, et les gens n'aiment pas retourner là où ils sont insultés. Il n'est pas surprenant que l'interdiction du langage inapproprié et des insultes soit inscrite dans les règles de nombreuses communautés, y compris sur Habr. Mais revenons-en au sujet.
Les dictionnaires de langage inapproprié ne couvrent pas toute la richesse de la langue russe. Bien qu'il n'y ait que quatre racines principales de langage inapproprié, il est possible de former un nombre incalculable de mots qui ne peuvent être attrapés par des expressions régulières. De plus, on peut écrire une partie du mot en translittération, remplacer des lettres par des combinaisons similaires, réarranger des lettres, ajouter des astérisques, etc. Parfois, sans contexte, il est simplement impossible de déterminer ce que l'utilisateur entendait par un mot inapproprié. Nous respectons les règles de Habr, nous allons donc le démontrer non pas avec des exemples réels, mais avec des chatons et des chiots.
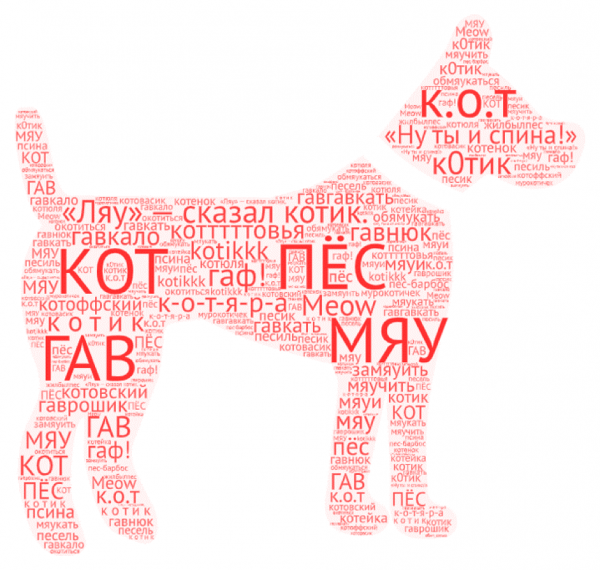
« Miaou », dit le chaton. Mais nous comprenons que le chaton a dit un mot différent…
Nous avons commencé à réfléchir aux algorithmes de "matching flou" de notre vocabulaire et à un prétraitement plus intelligent : nous avons translittéré, fusionné des espaces et de la ponctuation, recherché des motifs et écrit des expressions régulières spécifiques. Cette approche a porté ses fruits, mais réduisait souvent la précision, ne fournissant pas la complétude souhaitée.
Nous avons alors décidé de "penser comme des jurons". Nous avons commencé à introduire nous-mêmes du bruit dans les données : nous avons mélangé les lettres, généré des fautes de frappe, remplacé des lettres par des similaires, et ainsi de suite. Nous avons pris le premier marquage en appliquant des dictionnaires de jurons à de grands corpus textuels. Si nous prenons une phrase et la déformons de plusieurs façons, nous obtiendrons déjà de nombreuses phrases. Cela peut augmenter l'échantillon d'apprentissage de plusieurs dizaines de fois. Il ne reste plus qu'à former un modèle relativement intelligent sur ce pool obtenu, prenant en compte le contexte.
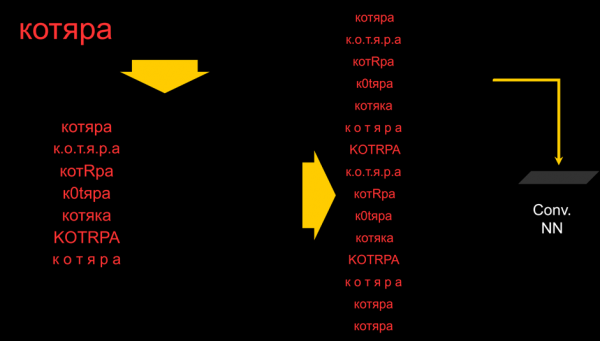
Il est encore prématuré de parler de la solution finale. Nous expérimentons toujours avec des approches à ce problème, mais nous voyons déjà qu'un simple réseau de neurones convolutifs symboliques de plusieurs couches surpasse de manière significative les dictionnaires et les expressions régulières : cela permet d'augmenter à la fois la précision et la complétude.
Bien sûr, nous comprenons qu'il y aura toujours des moyens de contourner même l'automatisation la plus avancée, surtout lorsque le jeu est aussi engageant : écrire de manière à ce qu'une machine stupide ne comprenne pas. Ici, comme dans la lutte contre le spam, notre objectif n'est pas d'éradiquer la possibilité d'écrire des choses obscènes, notre tâche est de faire en sorte que le jeu ne vaille pas la peine.
Ouvrir la possibilité de partager son opinion, de communiquer et de commenter n'est pas difficile. Ce qui est beaucoup plus complexe, c'est d'atteindre des conditions sécurisées, confortables et un respect mutuel entre les gens. Sans cela, il n'y aura pas de développement pour aucune communauté.
Source : habr.com
