

Bonjour, et tout d'abord un peu de lyrisme. Parfois, j'envie mes collègues qui travaillent à distance — c'est formidable de pouvoir travailler de n'importe quel coin du monde connecté à Internet, de prendre des vacances à tout moment, d'avoir des projets et des délais à respecter, plutôt que d'être présent au bureau de 8h à 17h. Ma position et mes tâches de travail excluent pratiquement la possibilité d'un long absence au centre de données. Cependant, il arrive parfois des cas intéressants, comme celui décrit ci-dessous — et je comprends qu'il existe peu de postes offrant un tel espace pour l'expression créative d'un troubleshooter interne.
Un petit avertissement — au moment de la rédaction de cet article, le cas n'est pas complètement résolu, mais compte tenu de la rapidité de réponse des fournisseurs, une solution complète pourrait prendre encore des mois, et j'aimerais déjà partager mes découvertes. J'espère, chers lecteurs, que vous me pardonnerez cette hâte. Mais assez de blabla — que se passe-t-il avec le cas ?
Tout d'abord, un peu de contexte : il y a une entreprise (où je travaille comme ingénieur réseau) qui héberge des solutions clients dans un cloud privé VMWare. La plupart des nouvelles solutions sont connectées à des segments VXLAN, gérés par NSX-V — je ne vais pas évaluer combien de temps cette solution m'a fait gagner, pour faire court — beaucoup. J'ai même réussi à former des collègues à la configuration de NSX ESG, et de petites solutions clients sont déployées sans ma participation. Remarque importante — notre plan de contrôle utilise la réplication unicast. Les hyperviseurs sont connectés de manière redondante via deux interfaces à différents commutateurs physiques Juniper QFX5100 (assemblés en Châssis Virtuel) et avec une politique de synchronisation basée sur le port virtuel d'origine — c'est pour compléter le tableau.
Les solutions clients sont très variées : allant de Windows IIS, où tous les composants du serveur web sont installés sur une seule machine, à des configurations plus importantes — par exemple, des fronts web Apache équilibrés par charge + LB MariaDB en Galera + serveurs de fichiers synchronisés à l'aide de GlusterFS. Pratiquement chaque serveur doit être surveillé séparément, et tous les composants n'ont pas d'adresses publiques — si vous avez déjà été confronté à cette tâche et disposez d'une solution plus élégante, je serais ravi de recevoir vos conseils.
Ma solution de surveillance consiste à "connecter" un pare-feu (Fortigate) à chaque réseau client interne (+SNAT et, bien sûr, des restrictions strictes sur le type de trafic autorisé) et à surveiller les adresses internes. Cela permet d'atteindre une certaine uniformité et de simplifier la surveillance. La surveillance elle-même se fait à partir d'un cluster de serveurs PRTG. Le schéma de surveillance est à peu près le suivant :
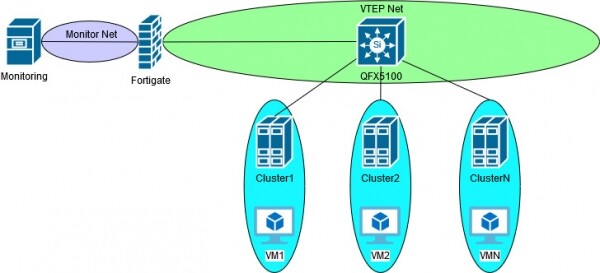
Tant que nous ne travaillions qu'avec des VLAN, tout fonctionnait de manière assez ordinaire et prévisible, comme une horloge. Après la mise en œuvre de NSX-V et VXLAN, nous avons été confrontés à la question : peut-on continuer à surveiller de l'ancienne manière ? À ce moment-là, la solution la plus "rapide" était de déployer NSX ESG et de connecter l'interface trunk VXLAN au réseau VTEP. Rapide entre guillemets, car utiliser l'interface graphique pour configurer les réseaux clients, SNAT et les règles du pare-feu peut unifier la gestion dans une seule interface vSphere, mais à mon avis, cela reste assez lourd et, en plus, cela limite les outils disponibles pour le dépannage. Ceux qui ont utilisé NSX ESG comme remplacement d'un véritable pare-feu seront d'accord, je suppose. Bien que, probablement, une telle solution serait plus stable, car tout se déroule au sein d'un même fournisseur.
Une autre solution consiste à utiliser NSX DLR en mode bridge entre VLAN et VXLAN. Ici, je pense que tout est clair : l'avantage d'utiliser VXLAN est perdu, car dans ce cas, il faut toujours tirer le VLAN vers l'installation de surveillance. D'ailleurs, en travaillant sur cette solution, j'ai rencontré un problème où le bridge DLR n'envoyait pas de paquets à la VM avec laquelle il se trouvait sur le même hôte. Je sais, je sais — dans les livres et les guides sur NSX-V, il est clairement dit qu'un cluster distinct doit être dédié à NSX Edge, mais cela reste dans les livres… Quoi qu'il en soit, après quelques mois avec le support, nous n'avons pas résolu le problème. En gros, j'ai compris la logique : le module du noyau de l'hyperviseur responsable de l'encapsulation VXLAN n'était pas utilisé, car le DLR et le serveur observé se trouvaient sur le même hôte, le trafic ne quittant pas l'hôte et logiquement devant être relié au segment VXLAN — l'encapsulation n'était pas nécessaire. Avec le support, nous nous sommes arrêtés sur l'interface virtuelle vdrPort, qui unit logiquement les uplinks et assure le bridging/l'encapsulation — c'est là que nous avons constaté une incohérence dans le trafic entrant, que j'ai pris en charge pour le cas actuel. Mais comme il a été dit, je n'ai pas poussé ce cas jusqu'au bout, car j'ai été transféré sur un autre projet et de plus, la branche était initialement sans issue et je n'avais pas vraiment l'envie de la développer. Si je ne me trompe pas, le problème était observé dans les versions NSX 6.1.4 et 6.2.
Et là — bingo ! Fortinet annonce le support natif . Et pas seulement du point à point ou du VXLAN-over-IPSec, pas de bridging logiciel VLAN-VXLAN — tout cela a commencé à être mis en œuvre depuis la version 5.4 (et présenté par d'autres ), et un véritable support pour le plan de contrôle unicast. Lors de la mise en œuvre de la solution, j'ai rencontré un autre problème - les serveurs surveillés disparaissaient parfois, puis reapparaissaient dans la surveillance, alors que la machine virtuelle était toujours active. La raison était que j'avais oublié d'autoriser le Ping sur l'interface VXLAN. Dans le processus de rééquilibrage des clusters, les machines virtuelles étaient déplacées, et avec le Ping, le vMotion était terminé pour désigner le nouvel hôte ESXI sur lequel la machine avait été déplacée. C'était une erreur de ma part, mais ce problème a encore une fois sapé ma confiance dans le support du fabricant - dans ce cas Fortinet. Je ne mentionne même pas que chaque cas lié à VXLAN commence par la question « où se trouvent vos paramètres de softswitch VLAN-VXLAN ? » Cette fois, on m'a conseillé de modifier le MTU - c'est pour le Ping, qui fait 32 octets. Ensuite, « joue » avec tcp-send-mss et tcp-receive-mss dans les politiques - pour VXLAN, qui est encapsulé dans UDP. Ouf, pardon - j'en avais marre. Bref, j'ai résolu ce problème par mes propres moyens.
Après avoir testé le trafic avec succès, il a été décidé de mettre en œuvre cette solution. Et en production, il s'est avéré qu'après un jour ou deux, tout ce qui était surveillé via VXLAN commençait progressivement à tomber en panne. La désactivation/réactivation de l'interface aidait, mais seulement pour un temps. Souvenant de la lenteur du support du fabricant, je me suis attelé au dépannage de mon côté - après tout, ma société, mon réseau - ma responsabilité.
Sous spoiler le déroulement du dépannage. Ceux qui sont fatigués des lettres et des vantardises - passez et allez à l'analyse postérieure.
Déroulement du dépannageMerci d'avoir continué la lecture - continuons !
Donc, la surveillance fonctionne un certain temps, puis se déconnecte d'elle-même. Cela signifie qu'il n'y a probablement pas de problèmes dans les politiques du pare-feu. Cependant, comme j'ai rencontré des problèmes de processus système suspendus dans Fortigate versions 5.6+, commençons par regarder « diagnose debug flow » - comme prévu, le trafic est autorisé et s'en va de l'interface avec aucune réponse attendue. Cela signifie que nous approfondissons la pile. Je vais malheureusement devoir masquer les adresses même si elles sont RFC1918, mais j'espère fournir un descriptif suffisant pour la compréhension. Le serveur à l'intérieur du VXLAN a l'adresse x.x.x.15, l'interface de Fortigate x.x.x.254, toutes les autres adresses appartiennent au réseau VTEP.
Pour le transfert réussi des paquets VXLAN encapsulés, il est nécessaire d'avoir des informations correctes dans plusieurs tables. Pour l'overlay, ce sont ARP et OVSDB, pour l'underlay, ce sont ARP et CAM. Dans le cas de Fortigate, VXLAN FDB est OVSDB. Commençons là.
 fortigate (root) #diag sys vxlan fdb list vxlan-LS
mac=00:50:56:8f:3f:5a state=0x0002 flags=0x00 remote_ip=x.x.x.47 port=4789 vni=5008 ifindex=7
Ici, c'est assez simple — l'adresse MAC de la machine virtuelle doit être présente sur le VTEP avec l'adresse x.x.x.47. En examinant le contenu et les paramètres du cluster ESXI, je constate que l'adresse MAC de la machine virtuelle est correcte, tout comme l'adresse VTEP. Je vérifie la table CAM/ARP sur le Fortigate — tout correspond à la configuration de l'hôte ESXI :
fortigate (root) #get sys arp | grep x.x.x.47
x.x.x.47 0 00:50:56:65:f6:2c dmz
Les tables sont correctes et le trafic sort — peut-être que le problème ne se trouve pas sur le Fortigate ? J'ai intentionnellement omis l'analyse de la commutation du trafic sur Juniper — logiquement, c'est là qu'il faut effectuer la prochaine étape de dépannage, mais mon réseau est simple — un seul VLAN pour VTEP et tous les composants sont connectés directement. De plus, je me souviens d'un cas avec un pont DLR, VDR et un trafic manquant — je dois sniffer sur l'hôte ESXI, tout en créant un cas déjà chez VMWare. Ci-dessous, la MAC «97:6e» appartient au Fortigate, vmnic1 — c'est l'interface qui a le VTEP avec l'adresse x.x.x.47, je sniff dans les deux directions "—dir 2":
pktcap-uw --uplink vmnic1 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
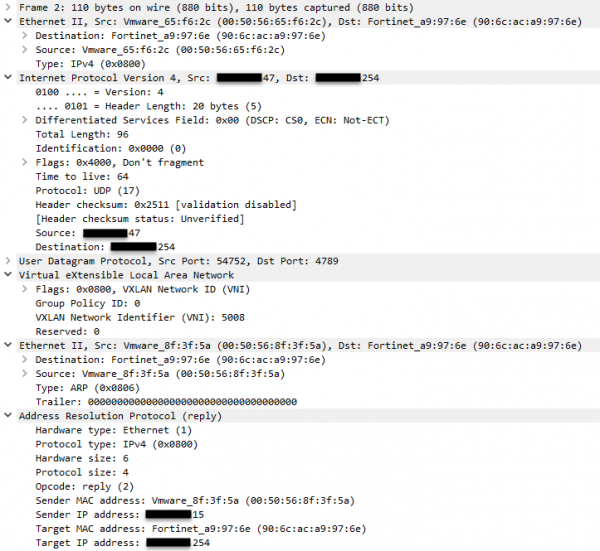
Progrès — dans le sniffer, je vois une requête ARP et la réponse qui arrive. Je ne mentionne que la réponse ARP et tout est correct. Je n'ai pas mentionné, mais pendant tout ce temps, le serveur de surveillance ping x.x.x.15 — où est le trafic ICMP ? Je me souviens que j'ai deux uplinks. On pourrait débattre et dire que le port virtuel source est le même (ma politique de teaming), c'est-à-dire qu'un même uplink doit être sélectionné pour la même vNIC, mais comme je suis sur l'hôte, vérifier un autre uplink ne pose pas de problème :
pktcap-uw --uplink vmnic4 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
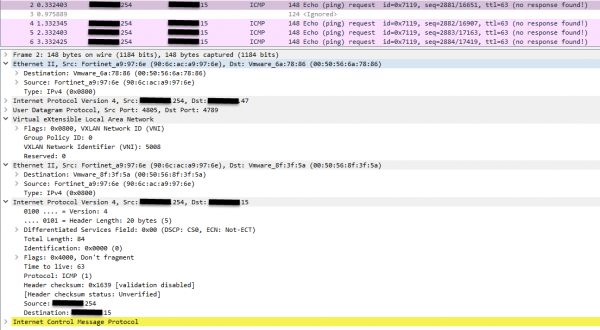
Des requêtes provenant de Fortigate arrivent, mais il n'y a pas de réponse. Donc, le problème ne vient pas de Fortigate. Eh bien, je pense à nouveau à ce même problème de trafic qui disparaît sur le VDR, encore quelques mois à diriger le cas dans la bonne direction. Après quelques jours de réflexion et ne souhaitant pas rester coincé, j'ai décidé de récupérer d'autres sniffers pour le support afin d'accélérer le processus. Et là, mon regard « tombe par hasard » sur l'encapsulation Ethernet sous-jacente. Le roi n'est pas vrai et l'adresse MAC VTEP ne correspond pas à son IP. Je remets à zéro, je sniffe, je creuse - c'est vrai que ce n'est pas vrai. Je vais fournir la table ARP à côté pour facilité la comparaison. Faites attention à la première encapsulation Ethernet sur l'image ci-dessus :
fortigate (root) #get sys arp | grep x.x.x.47
x.x.x.47 0 00:50:56:65:f6:2c dmz
fortigate (root) #get sys arp | grep x.x.x.42
x.x.x.42 0 00:50:56:6a:78:86 dmz
Alors, que nous avons au final - après la migration de la machine virtuelle, Fortigate essaie d'envoyer du trafic sur VTEP à partir de (correctement) VXLAN FDB, mais utilise une mauvaise MAC DST et le trafic est donc rejeté par l'interface de l'hyperviseur qui le reçoit. En un cas sur quatre, cette MAC appartenait à l'hyperviseur d'origine, à partir duquel nous avons commencé la migration de la machine.
Hier, j'ai reçu un e-mail du support technique de Fortinet - un bug 615586 a été ouvert sur mon cas. Je ne sais pas vraiment si je dois me réjouir ou me lamenter : d'un côté, le problème ne vient pas des paramètres, de l'autre, le correctif viendra seulement avec la mise à jour du firmware, au mieux lors de la prochaine. Mon égo est également alimenté par un autre bug que j'ai découvert le mois dernier, bien que cette fois-ci dans l'interface HTML5 de vSphere. C'est comme un département local QA des fournisseurs...
Je vais tenter de faire l'hypothèse suivante :
1 — le plan de contrôle multicast ne sera probablement pas sujet au problème décrit — en effet, les adresses MAC VTEP sont obtenues à partir de l'adresse IP du groupe, auquel l'interface est abonnée.
2 — il est probable que le problème de Fortigate vienne du déchargement des sessions sur le processeur réseau (en gros, similaire à CEF) — si chaque paquet passe par le CPU, des tables contenant les bonnes informations — du moins visuellement — seront utilisées. Cela est soutenu par le fait que fermer / ouvrir l'interface ou attendre un certain temps — plus de 5 minutes — aide.
3 — changer la politique de teaming, par exemple en explicit failover, ou mettre en œuvre LAG ne résoudra pas le problème, car il a été observé que l'adresse MAC de l'hyperviseur d'origine se « fige » dans les paquets encapsulés.
À la lumière de cela, je peux partager que j'ai récemment découvert , où l'un des articles prétendait que les pare-feux stateful et les méthodes de transmission de données mises en cache ne sont que des solutions de contournement. Eh bien, je ne suis pas assez expérimenté en IT pour affirmer cela, et de plus, je ne suis pas d'accord avec toutes les affirmations des articles de blog. Cependant, quelque chose me dit qu'il y a une part de vérité dans les propos d'Ivan.
Merci pour votre attention ! Je serai ravi de répondre à vos questions et d'entendre des critiques constructives.
Source : habr.com
