

Condition standard lors de la mise en œuvre de CI/CD dans Kubernetes : l'application doit être capable de refuser de nouvelles requêtes clients avant d'être complètement arrêtée, mais surtout, elle doit être en mesure de terminer avec succès les demandes existantes.
Respecter cette condition permet d'atteindre un temps d'arrêt nul lors du déploiement. Cependant, même en utilisant des combinaisons très populaires (comme NGINX et PHP-FPM), il est possible de rencontrer des difficultés qui entraîneront une augmentation des erreurs à chaque déploiement…
Théorie. Comment vit un pod
Nous avons déjà publié des détails sur le cycle de vie d'un pod. Dans le contexte du sujet traité, nous nous intéressons au moment où le pod passe à l'état Terminating, il ne reçoit plus de nouvelles requêtes (le pod est retiré de la liste des endpoints pour le service). Ainsi, pour éviter un temps d'arrêt lors du déploiement, il nous suffit de résoudre le problème d'arrêt correct de l'application.
Il convient également de se rappeler que la période de grâce est par défaut de : après cela, le pod sera terminé et l'application doit être en mesure de traiter toutes les requêtes avant cette période. Remarque: bien que toute requête prenant plus de 5 à 10 secondes soit déjà problématique, et qu'un arrêt gracieux ne pourra plus l'aider…
Pour mieux comprendre ce qui se passe lorsque le pod termine son travail, il suffit d'étudier le schéma suivant :
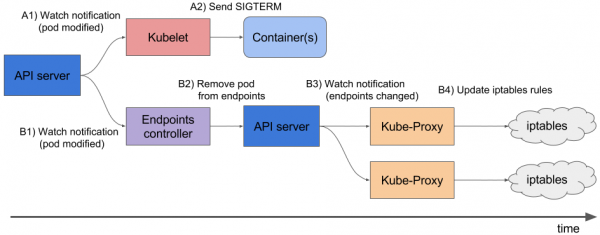
A1, B1 — Réception des changements d'état du pod
A2 — Envoi de SIGTERM
B2 — Suppression du pod des endpoints
B3 — Réception des changements (la liste des endpoints a changé)
B4 — Mise à jour des règles iptables
Remarque : la suppression de l'endpoint du pod et l'envoi de SIGTERM ne se font pas de manière séquentielle, mais en parallèle. Et en raison du fait que l'Ingress ne reçoit pas immédiatement la liste mise à jour des endpoints, de nouvelles requêtes des clients seront envoyées au pod, ce qui entraînera des erreurs 500 pendant la terminaison du pod. (nous avons traduit un matériel plus détaillé à ce sujet, ). Pour résoudre ce problème, il faut procéder de la manière suivante :
- Envoyer dans les en-têtes de réponse Connection: close (si cela concerne une application HTTP).
- S'il n'est pas possible d'apporter des modifications au code, cet article décrit une solution qui permettra de traiter les requêtes jusqu'à la fin de la période de grâce.
Théorie. Comment NGINX et PHP-FPM terminent leurs processus.
NGINX
Commençons par NGINX, car tout est assez évident avec lui. En nous plongeant dans la théorie, nous découvrons qu'NGINX possède un processus maître et plusieurs « workers » — ce sont des processus enfants qui gèrent les requêtes des clients. Il existe une fonctionnalité pratique : à l'aide de la commande nginx -s nous pouvons terminer les processus soit en mode fast shutdown, soit en graceful shutdown. Évidemment, c'est le dernier choix qui nous intéresse.
Ensuite, tout est simple : nous devons ajouter dans le la commande qui enverra le signal pour un graceful shutdown. Cela peut être fait dans le Deployment, dans le bloc de conteneur :
       lifecycle:
          preStop:
            exec:
              command:
              - /usr/sbin/nginx
              - -s
              - quit
Maintenant, au moment de l'arrêt du pod, nous verrons dans les logs du conteneur NGINX ce qui suit :
2018/01/25 13:58:31 [notice] 1#1: signal 3 (SIGQUIT) received, shutting down
2018/01/25 13:58:31 [notice] 11#11: gracefully shutting down
Et cela signifiera exactement ce dont nous avons besoin : NGINX attend la fin de l'exécution des requêtes, après quoi il termine le processus. Cependant, ci-dessous, nous examinerons un problème courant qui peut entraîner une interruption même en présence de la commande nginx -s quit le processus se termine de manière incorrecte.
À cette étape, nous avons terminé avec NGINX : au moins, d'après les logs, nous pouvons comprendre que tout fonctionne comme il se doit.
Qu'en est-il de PHP-FPM ? Comment gère-t-il le graceful shutdown ? Analysons cela.
PHP-FPM
Dans le cas de PHP-FPM, les informations sont un peu moins nombreuses. Si nous nous basons sur le de PHP-FPM, il indique que les signaux POSIX suivants sont pris en compte :
-
SIGINT,SIGTERM— fast shutdown ; -
SIGQUIT— graceful shutdown (ce dont nous avons besoin).
Les autres signaux ne sont pas nécessaires pour cette tâche, ainsi nous allons omettre leur analyse. Pour un arrêt correct du processus, le hook preStop suivant devra être écrit :
        lifecycle:
          preStop:
            exec:
              command:
              - /bin/kill
              - -SIGQUIT
              - "1"
À première vue, c'est tout ce qui est nécessaire pour effectuer un graceful shutdown dans les deux conteneurs. Cependant, la tâche est plus complexe qu'elle n'y paraît. Deux cas où le graceful shutdown n'a pas fonctionné, provoquant une indisponibilité temporaire du projet lors du déploiement, sont examinés ci-dessous.
Pratique. Problèmes possibles avec le graceful shutdown
NGINX
Première chose à retenir : en plus de l'exécution de la commande nginx -s quit Il existe une autre étape à ne pas négliger. Nous avons rencontré un problème où NGINX envoyait SIGTERM au lieu du signal SIGQUIT, ce qui empêchait les requêtes de se terminer correctement. On retrouve des cas similaires, par exemple, . Malheureusement, nous n'avons pas pu établir la cause précise de ce comportement : nous avons suspecté certaines versions de NGINX, mais cela n'a pas été confirmé. Les symptômes étaient que dans les journaux du conteneur NGINX, nous observions des messages « open socket #10 left in connection 5 », après quoi le pod s'arrêtait.
Nous pouvons observer ce problème, par exemple, dans les réponses de notre Ingress :
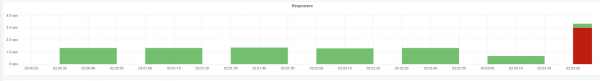
Les indicateurs de statut au moment du déploiement
Dans ce cas, nous recevons le code d'erreur 503 de l'Ingress lui-même : il ne peut pas accéder au conteneur NGINX, car celui-ci n'est déjà plus disponible. Si nous consultons les journaux du conteneur NGINX, nous y trouvons :
[alert] 13939#0: *154 open socket #3 left in connection 16
[alert] 13939#0: *168 open socket #6 left in connection 13
Après avoir modifié le signal d'arrêt, le conteneur commence à s'arrêter correctement : cela est confirmé par le fait qu'aucune erreur 503 n'est plus observée.
Si vous êtes confronté à un problème similaire, il est logique de vérifier quel signal d'arrêt est utilisé dans le conteneur et comment le hook preStop est configuré. Il est tout à fait possible que la raison en soit.
PHP-FPM… et pas seulement
Le problème avec PHP-FPM est décrit de manière triviale : il ne attend pas la fin des processus fils, les termine, ce qui entraîne des erreurs 502 lors des déploiements et d'autres opérations. Des rapports d'erreurs existent depuis 2005 sur bugs.php.net (par exemple, et ), décrivant ce problème. Vous ne verrez probablement rien dans les journaux : PHP-FPM annonçera la fin de son processus sans aucune erreur ni notification externe.
Il convient de préciser que le problème lui-même peut varier en fonction de l'application et peut ne pas se manifester, par exemple, dans la surveillance. Si vous tombez sur ce problème, le premier réflexe pourrait être d'appliquer un simple contournement : ajouter un hook preStop avec sleep(30). Cela permettra de terminer toutes les requêtes qui ont eu lieu auparavant (et nous n'acceptons pas de nouvelles, puisque le pod est déjà dans l'état Terminating), et après 30 secondes, le pod se terminera avec le signal SIGTERM.
Il en résulte qu'un seul image provenant d'un registre lent peut bloquer le déploiement le lifecycle pour le conteneur se présentera comme suit :
    lifecycle:
      preStop:
        exec:
          command:
          - /bin/sleep
          - "30"
Cependant, à cause de l'indication des 30 secondes, cela sleep nous fortement nous allons augmenter le temps de déploiement, car chaque pod sera terminé minimum 30 secondes, ce qui n'est pas bon. Que pouvons-nous y faire ?
Nous allons nous adresser à la partie responsable de l'exécution directe de l'application. Dans notre cas, c'est PHP-FPM, qui par défaut ne surveille pas l'exécution de ses processus enfants: le processus maître est terminé immédiatement. Ce comportement peut être modifié à l'aide de la directive process_control_timeout, qui spécifie des limites temporelles pour l'attente des signaux des processus enfants du maître. Si une valeur de 20 secondes est définie, cela couvrira la plupart des requêtes exécutées dans le conteneur, et après leur achèvement, le processus maître sera arrêté.
Avec cette connaissance, revenons à notre dernier problème. Comme mentionné précédemment, Kubernetes n'est pas une plateforme monolithique : l'interaction entre ses différents composants prend un certain temps. Cela est particulièrement pertinent lorsque nous examinons le fonctionnement des Ingress et d'autres composants connexes, car en raison de ce retard au moment du déploiement, il est facile de rencontrer des pics d'erreurs 500. Par exemple, une erreur peut se produire lors de l'envoi d'une requête à l'upstream, mais le « lag temporel » d'interaction entre les composants est en fait assez court — moins d'une seconde.
Par conséquent, dans l'ensemble avec la directive mentionnée ci-dessus process_control_timeout vous pouvez utiliser la structure suivante pour le lifecycle:
lifecycle:
  preStop:
    exec:
      command: ["/bin/bash","-c","/bin/sleep 1; kill -QUIT 1"]
Dans ce cas, nous compensons le retard avec la commande sleep et nous n'augmentons pas beaucoup le temps de déploiement : après tout, il y a une différence entre 30 secondes et une ?.. En substance, c'est « le travail principal » qui est pris en charge par process_control_timeout, et le lifecycle est utilisé uniquement comme « sécurité » en cas de lag.
il est impossible d'obtenir une le comportement décrit et la solution correspondante ne concernent pas uniquement PHP-FPM. Une situation similaire peut survenir d'une manière ou d'une autre lors de l'utilisation d'autres langages/frameworks. Si d'autres moyens pour corriger l'arrêt en douceur ne fonctionnent pas — par exemple, réécrire le code pour que l'application gère correctement les signaux de terminaison — vous pouvez appliquer la méthode décrite. Ce n'est peut-être pas la plus élégante, mais cela fonctionne.
Pratique. Test de charge pour vérifier le fonctionnement du pod.
Le test de charge est l'un des moyens de vérifier le fonctionnement d'un conteneur, car cette procédure se rapproche des conditions réelles, lorsque des utilisateurs accèdent au site. Pour tester les recommandations ci-dessus, vous pouvez utiliser : il couvre parfaitement tous nos besoins. Ci-dessous se trouvent des conseils et recommandations pour effectuer les tests avec un exemple concret – grâce aux graphiques de Grafana et de Yandex.Tank – tiré de notre expérience.
L'essentiel ici est de vérifier les modifications par étapes. Après l'ajout d'un nouveau correctif, lancez les tests et observez si les résultats ont changé par rapport au lancement précédent. Sinon, il sera difficile d'identifier les solutions inefficaces, et à long terme, cela pourrait même causer des problèmes (par exemple, augmenter le temps de déploiement).
Un autre point à prendre en compte est d'examiner les journaux du conteneur lors de sa terminaison. Y a-t-il des informations sur un arrêt en douceur ? Y a-t-il des erreurs dans les journaux lors de l'accès à d'autres ressources (par exemple, au conteneur PHP-FPM voisin) ? Y a-t-il des erreurs provenant de l'application elle-même (comme dans le cas mentionné ci-dessus avec NGINX) ? J'espère que les informations préliminaires de cet article aideront à mieux comprendre ce qui se passe avec le conteneur lors de sa terminaison.
Ainsi, le premier lancement du test s'est effectué sans le lifecycle et sans directives supplémentaires pour le serveur d'applications (process_control_timeout dans PHP-FPM). L'objectif de ce test était d'identifier le nombre approximatif d'erreurs (et s'il y en a). Il convient également de noter que le temps moyen de déploiement de chaque pod était d'environ 5 à 10 secondes avant d'atteindre un état de pleine disponibilité. Les résultats sont les suivants :
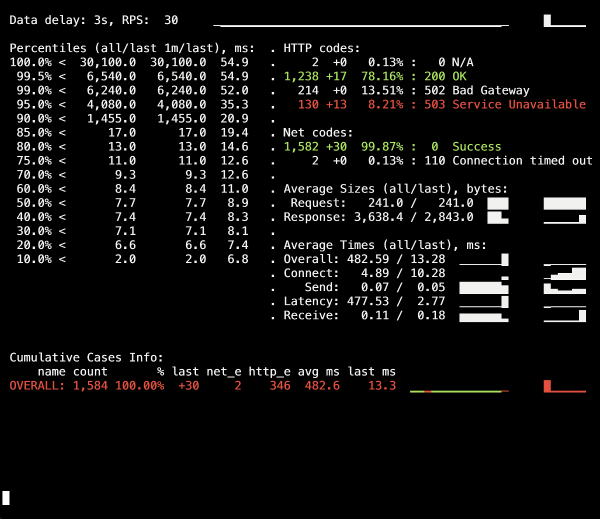
Sur le tableau de bord de Yandex.Tank, on observe un pic de 502 erreurs qui s'est produit au moment du déploiement et a duré en moyenne jusqu'à 5 secondes. On suppose que cela était dû à l'interruption des requêtes existantes vers l'ancien pod au moment de sa terminaison. Par la suite, des erreurs 503 sont apparues, ce qui était le résultat d'un conteneur NGINX arrêté, qui a également rompu les connexions à cause du backend (ce qui a empêché Ingress de se connecter).
Voyons comment process_control_timeout dans PHP-FPM nous aidera à attendre la fin des processus enfants, c'est-à-dire à corriger ces erreurs. Un redéploiement déjà avec cette directive :
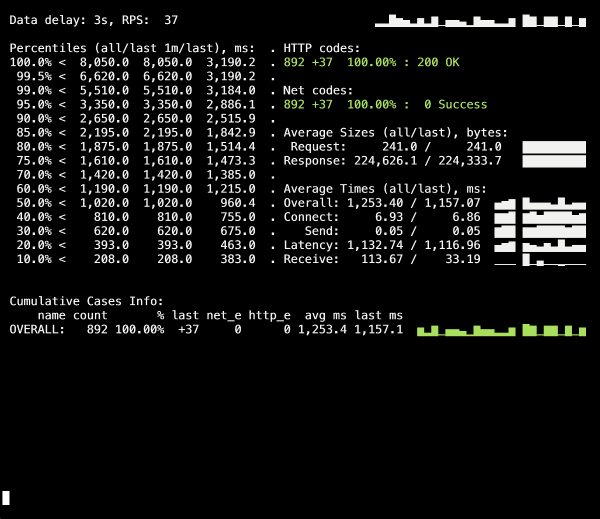
Plus de 500 erreurs pendant le déploiement ! Le déploiement se déroule avec succès, l'arrêt en douceur fonctionne.
Cependant, il est important de se rappeler le moment avec les conteneurs Ingress, un petit pourcentage d'erreurs que nous pouvons rencontrer en raison d'un lag temporaire. Pour les éviter, il suffit d'ajouter une construction avec sleep et de répéter le déploiement. Néanmoins, dans notre cas particulier, aucun changement n'était visible (pas d'erreurs à nouveau).
Conclusion
Pour achever correctement le processus, nous attendons du programme le comportement suivant :
- Attendre quelques secondes, puis cesser d'accepter de nouvelles connexions.
- Attendre la fin de toutes les requêtes et fermer toutes les connexions keepalive qui n'effectuent pas de requêtes.
- Terminer son processus.
Cependant, toutes les applications ne fonctionnent pas de cette manière. L'une des solutions au problème dans le contexte de Kubernetes est :
- l'ajout d'un hook pre-stop qui attendra quelques secondes ;
- l'examen du fichier de configuration de notre backend pour vérifier les paramètres appropriés.
L'exemple avec NGINX permet de comprendre qu'une application, même celle censée gérer correctement les signaux de terminaison, peut ne pas le faire, donc il est crucial de vérifier la présence d'erreurs 500 lors du déploiement de l'application. Cela permet également d'adopter une perspective plus large et d'éviter de se concentrer uniquement sur un pod ou un conteneur particulier, mais de considérer l'ensemble de l'infrastructure.
Pour tester, vous pouvez utiliser Yandex.Tank en conjonction avec n'importe quel système de surveillance (dans notre cas, les données de test provenaient de Grafana avec un backend Prometheus). Les problèmes d'arrêt en douceur sont bien visibles sous de fortes charges, que peut générer un benchmark, et la surveillance aide à analyser plus en détail la situation pendant ou après le test.
En réponse aux retours sur l'article : il convient de préciser que les problèmes et leurs solutions décrits ici s'appliquent à NGINX Ingress. Pour d'autres cas, il existe d'autres solutions que nous examinerons peut-être dans les futurs articles de cette série.
P.S.
Autre extrait de la série K8s tips & tricks :
- «»;
- «»;
- «»;
- «».
Source : habr.com
