

Le canari est un petit oiseau qui chante constamment. Ces oiseaux sont sensibles au méthane et au monoxyde de carbone. Même une faible concentration de gaz supplémentaires dans l'air peut les amener à perdre connaissance ou à mourir. Les chercheurs d'or et les mineurs prenaient des canaris avec eux : tant que les canaris chantent, on peut travailler, et s'ils se taisent, cela signifie qu'il y a du gaz dans la mine et qu'il est temps de partir. Les mineurs faisaient ce sacrifice pour sortir des mines vivants.
Une telle pratique s'est également retrouvée dans l'IT. Par exemple, dans la tâche standard de déploiement d'une nouvelle version d'un service ou d'une application en production, avec test préalable. Un environnement de test peut être trop coûteux, les tests automatisés ne couvrent pas tout ce qu'on souhaiterait, et ne pas tester et sacrifier la qualité est risqué. C'est précisément dans ces cas que l'approche du Canary Deployment est utile, où un peu de trafic réel est dirigé vers la nouvelle version. Cette méthode aide en toute sécurité à vérifier la nouvelle version en production, sacrifiant le peu pour un grand objectif. En savoir plus sur le fonctionnement de cette approche, ses avantages et comment la mettre en œuvre sera expliqué par Andrey Markelov (), à travers l'exemple de sa mise en œuvre dans l'entreprise Infobip.
Andrey Markelov — ingénieur logiciel principal chez Infobip, il développe des applications Java dans le domaine financier et des télécommunications depuis 11 ans. Il développe des produits Open Source, participe activement à la communauté Atlassian et écrit des plugins pour les produits Atlassian. Évangéliste de Prometheus, Docker et Redis.
À propos d'Infobip
C'est une plateforme de télécommunication mondiale qui permet aux banques, au commerce de détail, aux magasins en ligne et aux entreprises de transport d'envoyer des messages à leurs clients par SMS, notifications push, courriels et messages vocaux. Dans ce secteur, la stabilité et la fiabilité sont cruciales pour que les clients reçoivent leurs messages à temps.
L'infrastructure IT d'Infobip en chiffres :
- 15 centres de données dans le monde entier ;
- 500 services uniques en exploitation ;
- 2500 services, ce qui dépasse largement le nombre d'équipes ;
- 4,5 To de trafic mensuel ;
- 4,5 milliards de numéros de téléphone ;
L'entreprise est en pleine croissance, tout comme le nombre de déploiements. Nous effectuons environ 60 déploiements par jour, car les clients demandent plus de fonctionnalités et de capacités. Mais cela est difficile : il y a beaucoup de services et peu d'équipes. Il est donc nécessaire d'écrire rapidement du code qui fonctionne en production sans erreurs.
Releases
Un lancement typique chez nous se déroule ainsi. Par exemple, nous avons des services A, B, C, D et E, chacun développé par une équipe distincte.
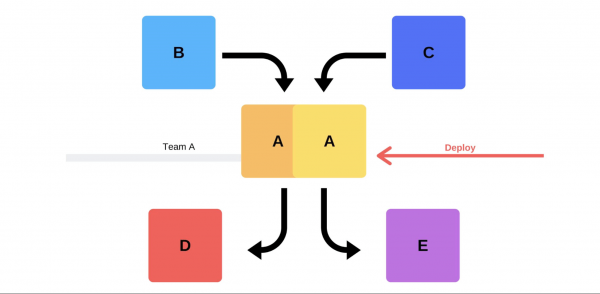
À un moment donné, l'équipe du service A décide de déployer une nouvelle version, mais les équipes des services B, C, D et E n'en sont pas informées. Il y a deux façons dont l'équipe du service A peut agir.
Elle effectuera un déploiement incrémental : elle remplacera d'abord une version, puis l'autre.
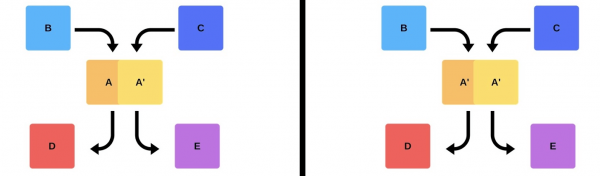
Mais il existe une autre option : l'équipe trouvera des ressources et des machines supplémentaires, déploiera la nouvelle version, puis basculera le routeur, et la version commencera à fonctionner en production.
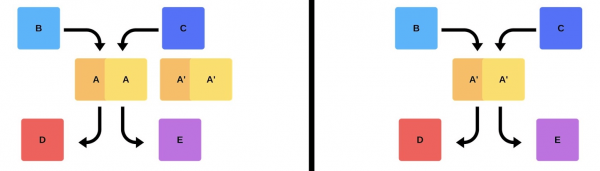
Dans tous les cas, après le déploiement, des problèmes surviennent presque toujours, même si la version a été testée. On peut tester manuellement, de manière automatisée, ou ne pas tester du tout — des problèmes apparaîtront de toute façon. La façon la plus simple et correcte de les résoudre est de revenir à la version fonctionnelle. Ensuite, nous pourrons nous pencher sur les dommages, les causes et les corriger.
Alors, que voulons-nous ?
Nous ne voulons pas de problèmes. Si les clients les découvrent plus vite que nous, cela nuira à notre réputation. C'est pourquoi nous devons détecter les problèmes plus rapidement que les clients.En agissant de manière proactive, nous minimisons les pertes.
En même temps, nous voulons accélérer le déploiement, afin qu'il se déroule rapidement, facilement, naturellement et sans stress pour l'équipe. Les ingénieurs, les ingénieurs DevOps et les programmeurs doivent être protégés — le lancement d'une nouvelle version est un stress. L'équipe n'est pas une ressource jetable, nous nous efforçons de utiliser les ressources humaines de manière rationnelle..
Problèmes de déploiement
Le trafic client est imprévisible.Il est impossible de prédire quand le trafic client sera minimal. Nous ne savons pas où et quand les clients commenceront leurs campagnes — cela peut être cette nuit en Inde et demain à Hong Kong. Compte tenu du grand décalage horaire, un déploiement à 2 heures du matin ne garantit pas que les clients ne seront pas affectés.
Problèmes des fournisseurs.Les messageries et les fournisseurs sont nos partenaires. Parfois, ils rencontrent des pannes qui provoquent des erreurs lors du déploiement de nouvelles versions.
Équipes distribuées.Les équipes qui développent la partie client et le backend sont situées dans des fuseaux horaires différents. Cela les empêche souvent de se mettre d'accord entre elles.
Les centres de données ne peuvent pas être reproduits en environnement de test.Dans un centre de données, il y a 200 racks — il est pratiquement impossible de reproduire cela dans un bac à sable.
Les temps d'arrêtsont inacceptables ! Nous avons un niveau d'accessibilité acceptable (Error Budget), lorsque nous работons 99,99 % du temps, par exemple, et les pourcentages restants représentent « le droit à l'erreur ». Atteindre 100 % de fiabilité est impossible, mais il est important de surveiller constamment les pannes et les indisponibilités.
Solutions classiques
Écrire du code sans bugs. Quand j'étais jeune développeur, les managers venaient me voir en me demandant de faire une release sans bugs, mais ce n'est pas toujours possible.
Écrire des tests. Les tests fonctionnent, mais parfois pas du tout comme le souhaite l'entreprise. Gagner de l'argent n'est pas une tâche pour les tests.
Tester en stage. Au cours de mes 3,5 années de travail chez Infobip, je n'ai jamais vu l'état du stade coïncider ne serait-ce qu'en partie avec la production.
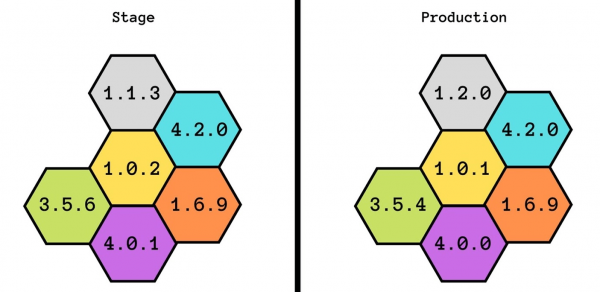
Nous avons même essayé de développer cette idée : d'abord, nous avions un stade, puis un préprod, ensuite un préprod du préprod. Mais même cela n'a pas aidé — ils ne coïncidaient pas même en termes de puissance. Avec le stade, nous pouvons garantir la fonctionnalité de base, mais nous ne savons pas comment cela fonctionnera sous charge.
La release est faite par celui qui développe. C'est une bonne pratique : même si quelqu'un change le nom d'un commentaire, il l'ajoute immédiatement à la production. Cela aide à développer la responsabilité et à ne pas oublier les modifications apportées.
Il y a aussi des complexités supplémentaires. Pour un développeur, c'est du stress — passer beaucoup de temps à tout vérifier manuellement.
Releases coordonnées. Cette option est généralement proposée par la direction : « Convenons que vous testerez et ajouterez de nouvelles versions chaque jour ». Cela ne fonctionne pas : il y a toujours une équipe qui attend les autres ou vice-versa.
Tests de fumée
Une autre façon de résoudre nos problèmes de déploiement. Examinons comment fonctionnent les tests de fumée dans l'exemple précédent, où l'équipe A souhaite déployer une nouvelle version.
D'abord, l'équipe déploie une instance en production. Par des messages dans l'instance provenant des mocks le trafic réel est imité, afin qu'il corresponde au trafic quotidien normal. Si tout va bien, l'équipe bascule la nouvelle version sur le trafic utilisateur.
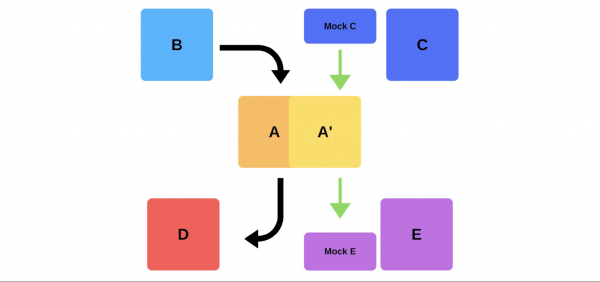
La deuxième option est de déployer avec du matériel supplémentaire. L'équipe le teste en production, puis effectue la bascule, et tout fonctionne.
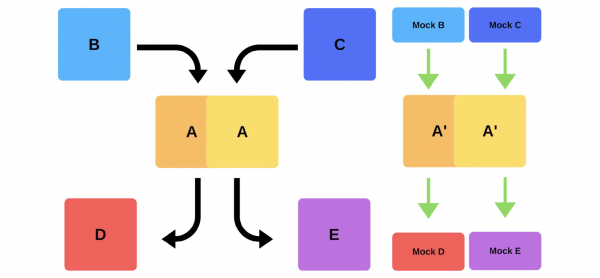
Inconvénients des tests de fumée :
- On ne peut pas se fier aux tests. Où trouver le même trafic que sur la production ? On peut utiliser des données d'hier ou de la semaine dernière, mais elles ne correspondent pas toujours à l'actualité.
- Difficile à maintenir. Il faudra gérer des comptes de test, les réinitialiser avant chaque déploiement, quand des enregistrements actifs sont envoyés au stockage. C'est plus complexe que d'écrire un test dans son propre bac à sable.
Le seul avantage ici — c'est qu'on peut vérifier la performance.
Les déploiements Canary
En raison des inconvénients des tests de validation, nous avons commencé à utiliser des déploiements canary.
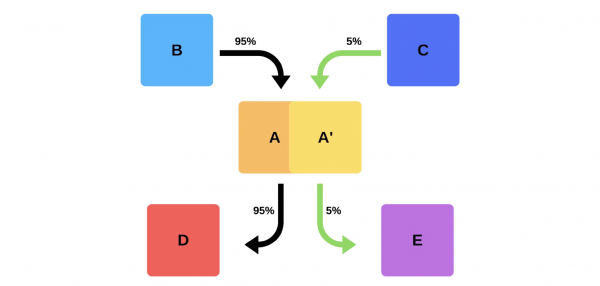
Une pratique semblable à celle où les mineurs utilisaient des canaris pour indiquer les niveaux de gaz a trouvé sa place dans l'informatique. Nous déployons un peu de trafic de production réel sur la nouvelle version, tout en veillant à respecter l'Accord de Niveau de Service (ANS). L'ANS est notre « droit à l'erreur », que nous pouvons utiliser une fois par an (ou durant un autre intervalle de temps). Si tout se passe bien, nous ajouterons plus de trafic. Sinon, nous reviendrons aux versions précédentes.
Mise en œuvre et spécificités
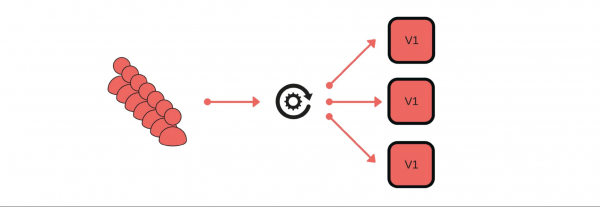
Comment avons-nous mis en œuvre les déploiements canary ? Par exemple, un groupe de clients envoie des messages via notre service.
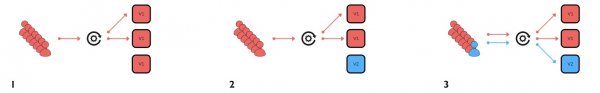
Le déploiement se déroule comme suit : nous retirons un nœud du répartiteur de charge (1), changeons la version (2) et envoyons séparément un peu de trafic (3).
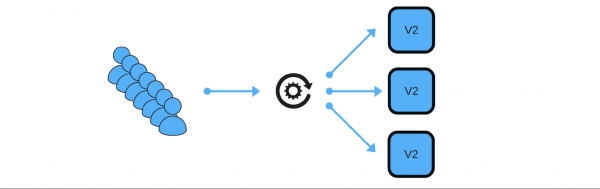
Dans l'ensemble, dans le groupe, tout le monde sera heureux, même si un utilisateur est insatisfait. Si tout va bien, nous changeons toutes les versions.
Je vais montrer schématiquement à quoi cela ressemble pour les microservices dans la plupart des cas.
Il y a la découverte de services et deux autres services : S1N1 et S2. Le premier service (S1N1) informe la découverte de services lorsqu'il démarre, et la découverte de services le mémorise. Le deuxième service avec deux nœuds (S2N1 et S2N2) informe également la découverte de services lors du démarrage.
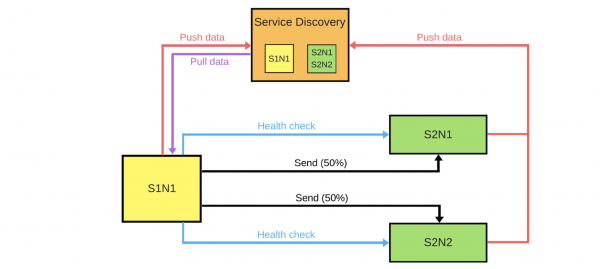
Le deuxième service pour le premier fonctionne comme un serveur. Le premier demande à la découverte de services des informations sur ses serveurs, et lorsqu'il les reçoit, il les recherche et les vérifie (« vérification de l’état »). Une fois vérifié, il leur enverra des messages.
Lorsque quelqu'un souhaite déployer une nouvelle version du deuxième service, il informe la découverte de services que le deuxième nœud sera un nœud canary : il recevra moins de trafic, car un déploiement est en cours. Nous retirons le nœud canary du répartiteur de charge, et le premier service ne lui envoie pas de trafic.
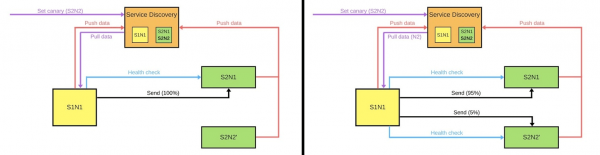
Nous changeons de version et le Service Discovery sait que la deuxième nœud est désormais canary - nous pouvons lui donner moins de charge (5%). Si tout va bien, nous changeons de version, rétablissons la charge et continuons à travailler.
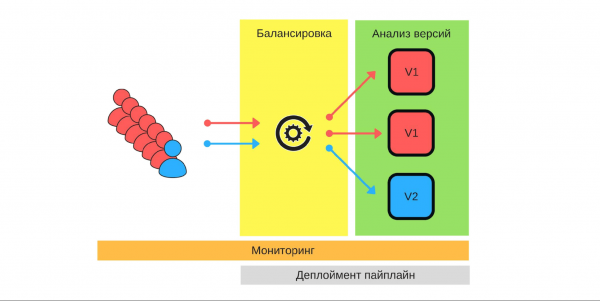
Pour réaliser tout cela, nous avons besoin de :
- balancement;
- surveillance, car il est important de savoir ce que chaque utilisateur attend et comment fonctionnent nos services en détail ;
- analyse des versions, pour comprendre à quel point la nouvelle version fonctionnera bien en production ;
- qui permet de tester, déployer et livrer de nouvelles fonctionnalités aux utilisateurs beaucoup plus rapidement. Par exemple, dans tous nos projets, un pipeline CI est automatiquement créé à chaque commit. Celui-ci construit l'image, la teste, la déploie dans divers environnements Kubernetes pour le débogage et les vérifications restantes, et si tout va bien, les modifications atteignent l'utilisateur final. Ce n'est plus une science-fusée, mais une banalité pour beaucoup — probablement pour vous également, puisque vous lisez cet article. — nous écrivons la séquence de déploiement (deployment pipeline).
Balancement
C'est le premier aspect auquel nous devons réfléchir. Il existe deux stratégies de balancement.
La solution la plus simple est que un nœud soit toujours canary. Ce nœud reçoit toujours moins de trafic et nous commençons le déploiement avec lui. En cas de problème, nous comparerons sa performance avant et pendant le déploiement. Par exemple, si le nombre d'erreurs a doublé, cela signifie que le dommage a également doublé.
Le nœud canary est défini lors du déploiement. Une fois le déploiement terminé et que nous enlevons son statut de nœud canary, le trafic sera rétabli. Avec moins de machines, nous obtenons une distribution juste.
Surveillance
La pierre angulaire des canary releases. Nous devons bien comprendre pourquoi nous faisons cela et quelles métriques nous voulons collecter.
Exemples de métriques que nous collectons de nos services.
- Nombre d'erreurs, qui sont enregistrées dans les journaux. C'est un indicateur évident que tout fonctionne comme prévu. En général, c'est une bonne métrique.
- Temps d'exécution des requêtes (latence). Toutes les personnes surveillent cette métrique, car tout le monde veut travailler rapidement.
- Taille de la file d'attente (débit).
- Nombre de réponses réussies par seconde.
- Temps d'exécution de 95 % de toutes les requêtes.
- Métriques commerciales : combien d'argent l'entreprise gagne sur une période donnée ou le taux de désabonnement des utilisateurs. Ces métriques peuvent être plus importantes pour notre nouvelle version que celles ajoutées par les ingénieurs.
Exemples de métriques dans la plupart des systèmes de surveillance populaires.
Compteur. C'est une certaine quantité croissante, par exemple, le nombre d'erreurs. Cette métrique est simplement interpolable et permet d'étudier le graphique : hier il y avait 2 erreurs, et aujourd'hui 500, ce qui signifie que quelque chose ne va pas.
Le nombre d'erreurs par minute ou par seconde est un indicateur et essentiel, que l'on peut calculer en utilisant un Compteur. Ces données donnent une vision claire de la performance du système dans le temps. Observons, par exemple, le graphique du nombre d'erreurs par seconde pour deux versions du système de production.
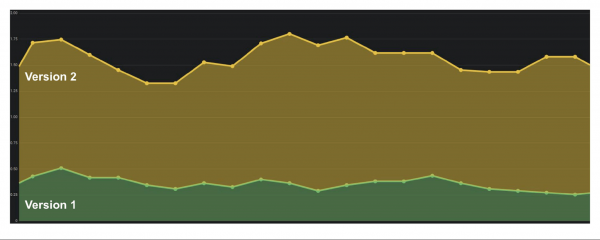
Dans la première version, il y avait peu d'erreurs, peut-être que l'audit ne fonctionnait pas. Dans la deuxième version, tout est beaucoup pire. On peut dire avec certitude qu'il y a des problèmes, donc nous devons revenir à cette version.
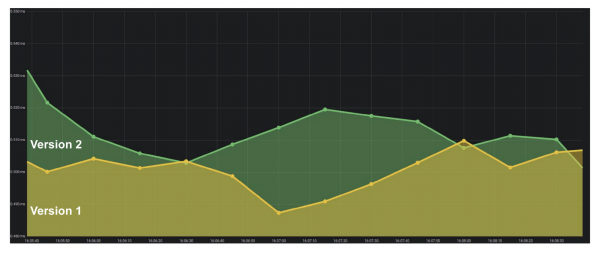
Mesure. Les métriques ressemblent à Counter, mais nous enregistrons des valeurs qui peuvent à la fois augmenter et diminuer. Par exemple, le temps d'exécution des requêtes ou la taille de la file d'attente.
Sur le graphique, un exemple de temps de réponse (latence). On peut voir que les versions sont similaires, et qu'on peut travailler avec elles. Mais si on regarde de plus près, on remarque que la grandeur change. Si le temps d'exécution des requêtes augmente avec l'ajout d'utilisateurs, il est évident qu'il y a des problèmes — ce n'était pas le cas auparavant.
Résumé. L'un des indicateurs les plus importants pour les entreprises est les percentiles. La métrique montre qu'à 95% des cas notre système fonctionne comme nous le souhaitons. Nous pouvons nous contenter de quelques problèmes, car nous comprenons la tendance générale, à quel point tout va bien ou mal.
Outils
ELK Stack. La mise en œuvre du canary peut se faire en utilisant Elasticsearch — nous y enregistrons les erreurs lorsqu'elles se produisent. Avec un simple appel API, nous pouvons obtenir le nombre d'erreurs à tout moment et le comparer avec les périodes passées : GET /applg/_count?q=level:error.
Prometheus. Il a bien performé dans Infobip. Il permet de réaliser des métriques multidimensionnelles, car il utilise des labels.
Nous pouvons utiliser niveau, instance, service, les combiner dans un seul système. Grâce à offset on peut voir, par exemple, la valeur d'une grandeur il y a une semaine avec une seule commande GET /api/v1/query?query={query}, où {query}:
rate(logback_appender_total{
    level="error",
    instance=~"$instance"
}[5m] offset $offset_value)
Analyse des versions
Il existe plusieurs stratégies d'analyse des versions.
Observer les métriques uniquement des nœuds canary. L'une des solutions les plus simples : déployer une nouvelle version et étudier uniquement son fonctionnement. Mais si un ingénieur commence à étudier les journaux à ce moment-là, en rechargeant constamment les pages de manière nerveuse, alors cette solution ne diffère pas des autres.
Le nœud canary est comparé à tout autre nœud. Cette comparaison se fait avec d'autres instances qui fonctionnent avec le trafic complet. Par exemple, si avec un petit trafic les résultats sont pires, ou pas meilleurs, qu'avec les instances réelles, alors quelque chose ne va pas.
Le nœud canary est comparé à lui-même dans le passé. Les nœuds dédiés au canary peuvent être comparés aux données historiques. Par exemple, si tout allait bien il y a une semaine, nous pouvons nous référer à ces données pour comprendre la situation actuelle.
Automatisation
Nous souhaitons libérer les ingénieurs de la comparaison manuelle, c'est pourquoi il est important de mettre en œuvre l'automatisation. Le processus de déploiement (deployment pipeline) ressemble généralement à ceci :
- nous démarrons ;
- nous retirons le nœud du répartiteur de charge ;
- nous mettons en place le nœud canary ;
- nous activons le répartiteur de charge avec une quantité limitée de trafic ;
- nous comparons.
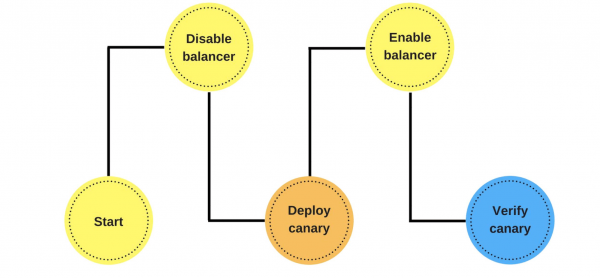
À ce stade, nous mettons en œuvre la comparaison automatique. Comment cela peut-il se présenter et pourquoi est-ce mieux que de vérifier après le déploiement, examinons cela avec un exemple de Jenkins.
C'est un pipeline en Groovy.
while (System.currentTimeMillis() < endCanaryTs) {
    def isOk = compare(srv, canary, time, base, offset, metrics)
    if (isOk) {
        sleep DEFAULT SLEEP
    }   else {
        echo "Canary échoué, besoin de revenir en arrière"
        return false
    }
}
Ici, dans la boucle, nous définissons que nous allons comparer le nouveau nœud pendant une heure. Si le processus canary n'est pas encore terminé, nous appelons la fonction. Elle indique si tout va bien ou non : def isOk = compare(srv, canary, time, base, offset, metrics).
Si tout va bien — sleep DEFAULT SLEEP, par exemple une seconde, et nous continuons. Sinon, nous sortons — le déploiement a échoué.
Description de la métrique. Voyons à quoi pourrait ressembler la fonction compare avec un exemple de DSL.
metric(
    'errorCounts',
    'rate(errorCounts{node=~"$canaryInst"}[5m] offset $offset)',
    {   baseValue, canaryValue ->
        if (canaryValue > baseValue * 1.3) return false
        return true
    }
)
Supposons que nous comparions le nombre d'erreurs et voulions savoir combien d'erreurs par seconde au cours des 5 dernières minutes.
Nous avons deux valeurs : la valeur de base et celle du nœud canary. La valeur du nœud canary est actuelle. La valeur de base est baseValue — c'est la valeur de tout autre nœud qui n'est pas canary. Nous comparons les valeurs entre elles selon la formule que nous établissons en fonction de notre expérience et de nos observations. Si la valeur canaryValue est mauvaise, alors le déploiement a échoué, et nous revenons en arrière.
Pourquoi tout cela ?
Une personne ne peut pas vérifier des centaines et des milliers de métriques, surtout le faire rapidement. La comparaison automatique aide à vérifier toutes les métriques et avertit rapidement des problèmes. Le temps d'avertissement est critique : si quelque chose s'est produit au cours des 2 dernières secondes, les dégâts ne seront pas aussi importants que si cela s'était produit 15 minutes plus tôt. Pendant que quelqu'un remarque le problème, écrit au support, et que le support nous aide à revenir en arrière, nous pouvons perdre des clients.
Si le processus s'est bien déroulé, nous déployons automatiquement tous les autres nœuds. Pendant ce temps, les ingénieurs ne font rien. Ce n'est qu'au moment où ils lancent le canary qu'ils décident quelles métriques prendre, combien de temps faire la comparaison et quelle stratégie utiliser.
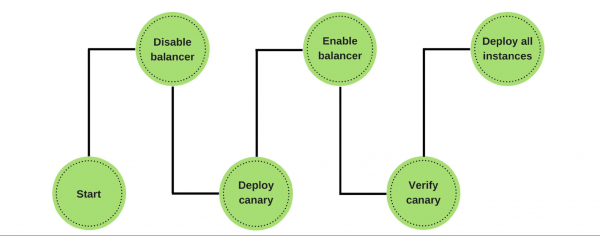
S'il y a des problèmes, nous revenons automatiquement à la nœud canary, travaillons sur les anciennes versions et corrigeons les erreurs identifiées. Les métriques permettent de les trouver facilement et de voir les dommages causés par la nouvelle version.
Obstacles
Bien sûr, mettre cela en œuvre n'est pas simple. Avant tout, il faut un système de surveillance général. Les ingénieurs ont leurs propres métriques, le support et les analystes en ont d'autres, et le business en a des tiers. Un système commun, c'est la langue commune entre l'entreprise et le développement.
Il est nécessaire de vérifier en pratique la stabilité des métriques. Cette vérification aide à comprendre quel ensemble minimal de métriques est nécessaire pour garantir la qualité..
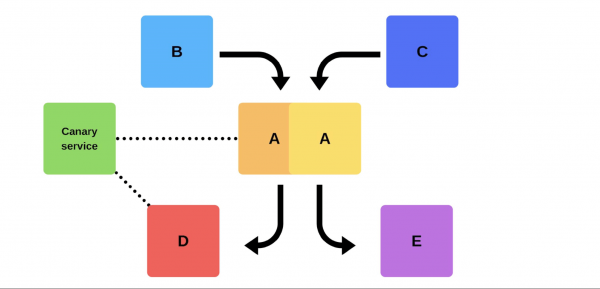
Comment y parvenir ? Utiliser le service canary non pas au moment du déploiement. Nous ajoutons sur l'ancienne version un certain service qui peut à tout moment prendre n'importe quel nœud dédié, réduire le trafic sans déploiement. Ensuite, nous comparons : nous étudions les erreurs et cherchons la limite à laquelle nous atteignons la qualité.
Quels avantages avons-nous retirés des déploiements canary ?
Nous avons minimisé le pourcentage de dommages causés par des bugs. La plupart des erreurs de déploiement proviennent de l'incohérence des données ou des priorités. De telles erreurs sont beaucoup moins fréquentes, car nous pouvons résoudre le problème dans les premières secondes.
Nous avons optimisé le travail des équipes. Les débutants ont un "droit à l'erreur" : ils peuvent déployer en production sans craindre de se tromper, ce qui leur donne une initiative supplémentaire et un stimulus à travailler. Si jamais ils cassent quelque chose, ce ne sera pas critique, et l'utilisateur fautif ne sera pas licencié.
Nous avons automatisé le déploiement. Ce n'est plus un processus manuel comme auparavant, mais un véritable processus automatisé. Cependant, il prend plus de temps.
Nous avons identifié des métriques importantes. L'ensemble de l'entreprise, des équipes commerciales aux ingénieurs, comprend ce qui est vraiment important dans notre produit, quelles métriques, par exemple, le taux de churn et l'afflux d'utilisateurs. Nous contrôlons le processus : testons les métriques, introduisons de nouvelles, surveillons le fonctionnement des anciennes pour construire un système qui sera plus rentable.
Nous avons de nombreuses pratiques et systèmes intéressants qui nous aident. Cela dit, nous nous efforçons d'être des professionnels et de réaliser notre travail avec qualité, que nous ayons ou non un système pour nous assister.
Approches et pratiques d'ingénierie — . Si vous avez fait des progrès vers l'excellence technique et que vous êtes prêt à partager ce qui vous a aidé — .
Nous prévoyons d'organiser le 8 juin. Nous comprenons qu'il est difficile de prendre des décisions concernant votre participation à la conférence en ce moment. Cependant, nous croyons que le confinement n'est pas une raison pour arrêter la communication professionnelle et le développement. Par conséquent, nous trouverons de toute façon un moyen de discuter des problèmes des Tech Leads et des approches pour les résoudre — si nécessaire, nous passerons en ligne et mettrons en place du networking là-bas !
Source : habr.com
