

Aujourd'hui, nous allons parler d'une technologie intéressante mise en œuvre dans les systèmes de stockage Unity / Unity XT : FAST VP. Si vous entendez parler de Unity pour la première fois, vous pouvez consulter les caractéristiques du système via le lien à la fin de l'article. Dans l'équipe projet de Dell EMC, j'ai travaillé sur FAST VP pendant plus d'un an. Aujourd'hui, je souhaite expliquer cette technologie plus en détail et révéler certains aspects de sa mise en œuvre. Évidemment, je ne partagerai que celles qui peuvent être divulguées. Si vous vous intéressez aux questions de stockage efficace des données ou si vous n'avez pas complètement compris la documentation, cet article sera sans aucun doute utile et intéressant.
Je commencerai par préciser ce que ce matériel ne couvrira pas. Il n'y aura pas de recherche sur les concurrents ni de comparaisons avec eux. Je ne prévois pas non plus de parler de technologies similaires open source, car le lecteur curieux en connaît déjà assez. Et bien sûr, je n'ai aucune intention de faire de la publicité.
Classement de stockage. Objectifs et missions de FAST VP
FAST VP signifie Fully Automated Storage Tiering for Virtual Pool. C'est un peu compliqué ? Pas de souci, nous allons clarifier cela. Le tiering est une méthode d'organisation du stockage des données, où plusieurs niveaux (tiers) sont utilisés pour stocker ces données. Chacun d'eux possède ses propres caractéristiques. Les plus importantes sont : la performance, le volume et le coût de stockage par unité d'information. Évidemment, il existe des interrelations entre ces éléments.
Une caractéristique importante du tiering est que l'accès aux données est fourni de manière uniforme, peu importe le niveau de stockage auquel elles se trouvent actuellement, et la taille du pool est égale à la somme des tailles des ressources qui le composent. C'est là que résident les différences avec le cache : la taille du cache n'est pas ajoutée au volume total de la ressource (le pool dans ce cas), et les données du cache dupliquent un fragment de données du support principal (ou le feront si les données du cache ne sont pas encore écrites). De plus, la répartition des données entre les niveaux est cachée de l'utilisateur. Cela signifie qu'il ne voit pas quelles données se trouvent à chaque niveau, bien qu'il puisse influencer cela indirectement en définissant des politiques (que nous aborderons plus tard).
Nous allons maintenant examiner les caractéristiques du tiering de stockage dans Unity. Dans Unity, trois niveaux ou tiers sont distingués :
- Performance extrême (SSDs)
- Performance (SAS HDD 10k / 15k RPM)
- Capacité (NL-SAS HDD 7200 RPM)
Ils sont présentés par ordre décroissant de performance et de prix. Dans Extreme performance, seuls des disques SSD sont inclus. Dans les deux autres niveaux, ce sont des disques durs magnétiques, qui se distinguent par la vitesse de rotation et, par conséquent, la performance.
Les supports d'information d'un même niveau et de même taille sont regroupés dans un tableau RAID, formant un groupe RAID (groupe RAID, abrégé en RG) ; vous pouvez lire sur les niveaux RAID disponibles et recommandés dans la documentation officielle. Des groupes RAID de un ou plusieurs niveaux forment des pools de stockage (pool de stockage), à partir desquels l'espace libre est ensuite distribué. C'est à partir du pool que l'espace est alloué aux systèmes de fichiers et aux LUN.
Pourquoi ai-je besoin de Tiering ?
En résumé et de manière abstraite : pour obtenir un meilleur résultat en utilisant un minimum de ressources. Plus concrètement, le résultat est généralement compris comme l'ensemble des caractéristiques des systèmes de stockage – la vitesse et le temps d'accès, le coût de stockage, etc. Le minimum de ressources fait référence aux dépenses les plus faibles : d'argent, d'énergie, etc. FAST VP met justement en œuvre des mécanismes de redistribution des données entre différents niveaux dans les systèmes de stockage Unity/Unity XT. Si vous me croyez, vous pouvez passer au paragraphe suivant. Pour les autres, je vais expliquer un peu plus en détail.
Une bonne répartition des données entre les niveaux de stockage permet d'économiser sur le coût total des systèmes de stockage, en sacrifiant la vitesse d'accès à certaines informations peu utilisées, et d'améliorer la performance en déplaçant les données fréquemment utilisées vers des supports plus rapides. Certains pourraient rétorquer qu'un bon administrateur sait déjà où placer quelles données, quelles caractéristiques des systèmes de stockage sont souhaitables pour sa tâche, etc. Bien sûr, c'est vrai, mais la répartition manuelle des données a ses inconvénients :
- elle nécessite du temps et de l'attention de l'administrateur ;
- il n'est pas toujours possible de « réajuster » les ressources du système de stockage selon les conditions changeantes ;
- un avantage important disparaît : l'accès unifié aux ressources situées à différents niveaux de stockage.
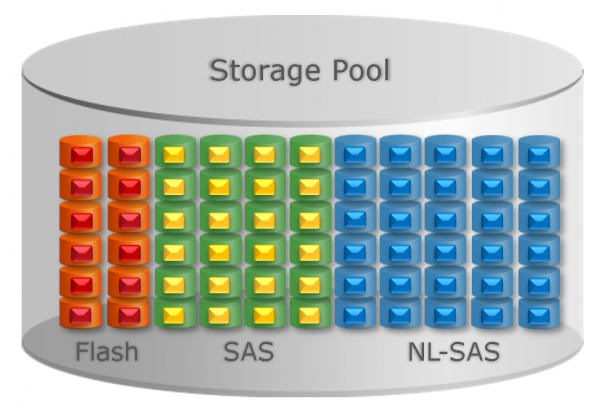
Pour que les administrateurs de stockage s'inquiètent moins de la sécurité de l'emploi, je dois ajouter qu'une bonne planification des ressources est également nécessaire ici. Maintenant que les tâches de tiering sont brièvement décrites, examinons ce que l'on peut attendre de FAST VP. Il est temps de revenir à la définition. Les deux premiers mots - Fully Automated - se traduisent littéralement par « entièrement automatisé » et signifient que la répartition par niveaux se fait automatiquement. Quant à Virtual Pool, il s'agit d'un pool de données comprenant des ressources provenant de différents niveaux de stockage. Voici à quoi cela ressemble :
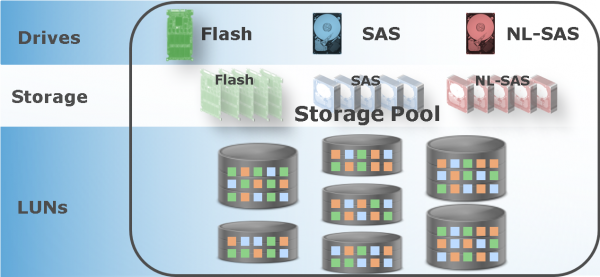
Pour anticiper, je dirai que FAST VP déplace les données uniquement à l'intérieur d'un seul pool, et non entre plusieurs pools.
Les tâches résolues par FAST VP
Commençons par parler de manière abstraite. Nous avons un pool et un mécanisme qui peut redistribuer les données au sein de ce pool. Sachant que notre objectif est d'atteindre une performance maximale, posons-nous la question : comment peut-on y parvenir ? Cela peut se faire de plusieurs manières, et FAST VP a beaucoup à offrir à l'utilisateur, car la technologie est plus qu'un simple tiering de stockage. Voici comment FAST VP peut augmenter la performance du pool :
- Répartition des données entre différents types de disques, niveaux
- Répartition des données parmi des disques d'un même type
- Répartition des données lors de l'extension du pool
Avant de discuter de la manière dont ces tâches sont accomplies, nous devons connaître certains faits nécessaires concernant le fonctionnement de FAST VP. FAST VP opère par blocs de taille définie – 256 mégaoctets. C'est le plus petit « morceau » continu de données qui peut être déplacé. Dans la documentation, cela est appelé slice. Du point de vue de FAST VP, tous les groupes RAID se composent d'un ensemble de ces « morceaux ». Par conséquent, toutes les statistiques d'entrée-sortie sont accumulées pour ces blocs de données. Pourquoi ce taille de bloc a-t-il été choisie et sera-t-elle réduite ? Le bloc est assez grand, mais c'est un compromis entre la granularité des données (plus la taille du bloc est petite - plus la répartition est précise) et les ressources de calcul disponibles : compte tenu des limites strictes de mémoire vive et du grand nombre de blocs, les statistiques de données peuvent prendre trop de place, et le nombre de calculs augmentera de manière proportionnelle.
Comment FAST VP place les données dans le pool. Politiques
Pour gérer le placement des données dans un pool avec FAST VP activé, plusieurs politiques existent :
- Niveau le plus élevé disponible
- Auto-Tier
- Commencer par le haut puis Auto-Tier (par défaut)
- Niveau le plus bas disponible
Elles influencent à la fois le placement initial du bloc (lorsque les données sont écrites pour la première fois) et la redistribution ultérieure. Une fois que les données sont placées sur les disques, la redistribution sera initiée selon un calendrier ou manuellement.
Le Niveau le plus élevé disponible tente de placer un nouveau bloc au niveau le plus performant. S'il n'y a pas assez d'espace, il le mettra au niveau suivant en performance, mais les données peuvent ensuite être déplacées vers un niveau plus performant (si de l'espace est disponible ou en remplaçant d'autres données). L'Auto-Tier place de nouvelles données à différents niveaux en fonction de la taille de l'espace disponible, et elles sont redistribuées en fonction de leur demande et de l'espace libre. La politique Commencer par le haut puis Auto-Tier est la politique par défaut et aussi recommandée. Lors du placement initial, elle fonctionne comme le Niveau le plus élevé disponible, puis les données sont déplacées en fonction de leurs statistiques d'utilisation. La politique Niveau le plus bas disponible vise à placer les données au niveau de performance le plus faible.
Le transfert de données se fait avec une priorité faible pour ne pas perturber le bon fonctionnement du stockage, néanmoins il existe un paramètre « Taux de relocalisation des données » qui modifie cette priorité. Il y a une particularité : tous les blocs de données n'ont pas la même priorité de redistribution. Par exemple, les blocs marqués comme métadonnées seront déplacés en premier vers un niveau plus rapide. Les métadonnées sont, si l'on peut dire, des « données sur des données », une information additionnelle qui n'est pas des données utilisateur, mais qui contient leur description. Par exemple, des informations dans le système de fichiers indiquant dans quel bloc se trouve un fichier spécifique. Ainsi, la vitesse d'accès aux données dépend de la vitesse d'accès aux métadonnées. Étant donné que les métadonnées sont généralement beaucoup plus petites, le gain lié à leur déplacement vers des disques plus performants est attendu d'être plus important.
Les critères que Fast VP utilise dans son fonctionnement
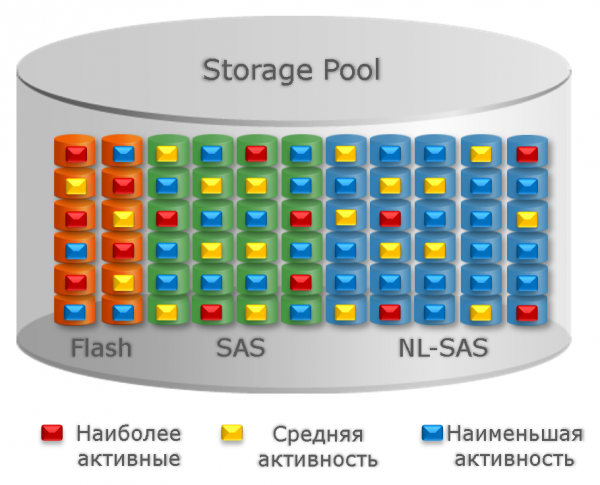
Le critère principal pour chaque bloc, très grossièrement, est la caractéristique de « demande » des données, qui dépend du nombre d'opérations de lecture et d'écriture d'un fragment de données. Cette caractéristique est appelée « Température ». Il y a des données populaires (hot) qui sont « plus chaudes » que celles qui ne le sont pas. Elle est calculée périodiquement, par défaut à intervalles d'une heure.
La fonction de calcul de la température possède les propriétés suivantes :
- En l'absence d'entrées-sorties, les données « refroidissent » avec le temps.
- Avec une charge plutôt homogène dans le temps, la température initialement augmente puis se stabilise dans une certaine plage.
Ensuite, les politiques décrites ci-dessus et l'espace libre sur chaque niveau sont pris en compte. Pour illustrer, voici une image provenant de la documentation. Les blocs avec une température élevée, moyenne et faible sont respectivement marqués en rouge, jaune et bleu.
Mais revenons aux tâches. Donc, nous pouvons commencer à examiner ce qui est fait pour résoudre les problèmes de FAST VP.
A. Répartition des données sur différents types de disques, niveaux
C'est essentiellement la tâche principale de FAST VP. Les autres, dans un certain sens, en sont des dérivés. Selon la politique choisie, les données seront réparties sur différents niveaux de stockage. Tout d'abord, la politique de placement est prise en compte, puis la température des blocs et la taille/vitesse des groupes RAID.
Pour les politiques de Highest/Lowest Available Tier, c'est assez simple. Pour les deux autres, la situation est la suivante. Les données sont réparties sur différents niveaux en tenant compte de la taille et de la performance des groupes RAID : de manière à ce que le rapport de la « température » totale des blocs à la « performance maximale théorique » de chaque groupe RAID soit à peu près le même. Ainsi, la charge est répartie de manière relativement uniforme. Les données les plus demandées sont déplacées vers des supports rapides, celles peu utilisées vers des plus lents. Idéalement, la répartition devrait ressembler à peu près à ceci :
B. Répartition des données entre des disques d'un même type
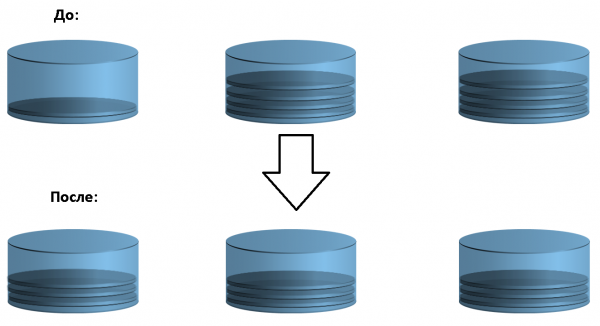
Souvenez-vous, au début, j'ai écrit que les supports d'information viennent de un ou plusieurs Les niveaux sont-ils combinés en un seul pool ? Dans le cas d'un niveau unique pour FAST VP, il y a également du travail. Pour que les performances de tout niveau soient maximales, il est préférable de répartir les données uniformément entre les disques. Cela permettra (en théorie) d'obtenir le maximum d'IOPS. Les données au sein d'un groupe RAID peuvent être considérées comme réparties uniformément entre les disques, mais ce n'est pas toujours le cas entre les groupes RAID. En cas de déséquilibre, FAST VP déplacera les données entre les groupes RAID en proportion de leur volume et de leur « performance conditionnelle » (en valeur numérique). Pour illustrer, je vais montrer un schéma de rééquilibrage parmi trois groupes RAID :
B. Répartition des données lors de l'extension d'un pool
Cette tâche est un cas particulier de la précédente et est effectuée lorsque l'on ajoute un groupe RAID au pool. Pour éviter que le groupe RAID nouvellement ajouté ne reste inactif, une partie des données sera transférée vers lui, redistribuant ainsi la charge sur tous les groupes RAID.
Équilibrage de l'usure des SSD
Grâce à l'équilibrage de l'usure, FAST VP peut prolonger la durée de vie des SSD, même si cette fonction n'est pas directement liée au stockage hiérarchique. Étant donné que les données sur la température sont déjà disponibles, le nombre d'opérations d'écriture est également pris en compte, et nous sommes capables de déplacer des blocs de données, il serait logique que FAST VP s'attaque aussi à ce problème.
Dans le cas où le nombre d'écritures dans un groupe RAID dépasse considérablement le nombre d'écritures dans un autre, FAST VP redistribuera les données en fonction du nombre d'opérations d'écriture. D'une part, cela réduit la charge et préserve les ressources de certains disques, d'autre part, cela ajoute du « travail » pour ceux moins sollicités, augmentant ainsi la performance globale.
Ainsi, FAST VP prend en charge les tâches traditionnelles du stockage hiérarchique et en fait un peu plus. Tout cela permet de stocker les données de manière assez efficace dans les systèmes de stockage de la famille Unity.
Quelques conseils
- Ne négligez pas la documentation. Il existe des meilleures pratiques, et elles fonctionnent assez bien. Si on les suit, il n'y a généralement pas de problèmes sérieux. Les autres conseils répètent principalement ou complètent ceux-ci.
- Si vous avez configuré et activé FAST VP, il est préférable de le laisser allumé. Laissez-le répartir les données à l'heure prévue, progressivement plutôt qu'une fois par an, en impactant sérieusement la performance des autres tâches. Dans de tels cas, la redistribution des données peut prendre beaucoup de temps.
- Soyez attentif au choix de la fenêtre de relocalisation. Bien que cela semble évident, essayez de choisir un moment où Unity est le moins sollicité et prévoyez suffisamment de temps.
- Planifiez l'expansion du stockage, faites-le à temps. C'est une recommandation générale qui est également importante pour FAST VP. Si l'espace libre est très réduit, le déplacement des données ralentira ou deviendra impossible. Surtout si vous avez négligé le point 2.
- Lors de l'extension du pool avec FAST VP activé, évitez de commencer avec les disques les plus lents. Soit nous ajoutons tous les groupes RAID prévus en même temps, soit nous commençons par les disques les plus rapides. Dans ce cas, la redistribution des données sur les nouveaux 'rapides' augmentera la vitesse globale du pool. Sinon, si vous commencez par des disques 'lents', vous risquez de vous retrouver dans une situation très désagréable. Les données seront d'abord transférées vers de nouveaux disques, relativement lents, puis lors de l'ajout de disques plus rapides, cela se fera dans l'autre sens. Il y a des nuances liées aux différentes politiques de FAST VP, mais en général, cette situation est possible.
Si vous envisagez ce produit, vous pouvez essayer Unity en action gratuitement en téléchargeant l'appliance virtuelle Unity VSA.
Pour conclure, je partage quelques liens utiles :
- Page
- – une brève description de la fonction
- , format pdf
Conclusion
Je souhaite parler de beaucoup de choses, mais je comprends que tous les détails n'intéresseront pas le lecteur. Par exemple, on peut expliquer plus en détail les critères selon lesquels FAST VP décide de déplacer des données, ainsi que les processus d'analyse des statistiques d'E/S. Le sujet de l'interaction avec , est complètement écarté, ce qui pourrait faire l'objet d'un article séparé. On peut même imaginer le développement de cette technologie. J'espère que cela n'a pas été ennuyeux et que je ne vous ai pas fatigué. À bientôt !
Source : habr.com
