

Préface du traducteur
Le matériau m'a intéressé, en premier lieu en raison du tableau ci-dessous :
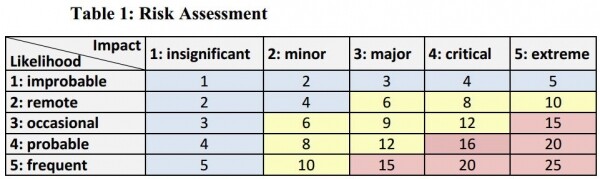
Compte tenu du fait que les statisticiens (et les Russes, par nature) ont une aversion pour tout ce qui s'écarte de la dépendance linéaire, ces gars-là ont réussi à intégrer une fonction d'activation sous forme parabolique pour déterminer le degré de risque lié à l'utilisation de Big Data dans les statistiques officielles. Bravo à eux. Bien sûr, les statisticiens ont ajouté leur remarque à ce travail : « 1 Toute erreur ou omission est de la responsabilité exclusive des auteurs. Les opinions exprimées dans ce document sont personnelles et ne reflètent pas nécessairement la position officielle de la Commission européenne ». Mais le travail a été publié. Je pense qu'il y en a suffisamment pour aujourd'hui, et ils (les auteurs) n'ont interdit à personne de trouver leurs échelles dans ces aspects.
Dans ce travail, il est possible de structurer clairement comment et de quelle manière les méthodes statistiques diffèrent des méthodes de recherche pour Big Data. À mon avis, le plus grand bénéfice de ce travail sera lors des discussions avec le client et pour contrer ses affirmations telles que :
— Nous collectons nous-mêmes des statistiques, que voulez-vous encore rechercher ?
— Et présentez-nous vos résultats d'une manière à ce que nous puissions les concilier avec nos statistiques. À cet égard, les auteurs suggèrent qu'il serait bon de lire ce travail (3 )
Dans ce travail, les auteurs ont indiqué leur vision du niveau de risque. Ce paramètre est entre parenthèses, à ne pas confondre avec une référence aux sources.
Deuxième observation. Les auteurs utilisent le terme BDS – c'est l'équivalent du concept de Big Data. (probablement un clin d'œil à la statistique officielle).
Préface des auteurs
De plus en plus d'agences statistiques explorent la possibilité d'utiliser de grandes sources de données pour la production de statistiques officielles. À l'heure actuelle, il n'existe que quelques exemples où ces sources ont été complètement intégrées dans le processus statistique réel. Par conséquent, le plein impact de leur intégration n'est pas encore clairement défini. Pendant ce temps, les premières tentatives ont été faites pour analyser les conditions et l'impact des big data sur divers aspects de la production statistique, tels que la qualité ou la méthodologie. Récemment, un groupe de travail a élaboré un cadre qualitatif pour la préparation de données statistiques basées sur les big data dans le cadre du projet sur les big data de la Commission économique pour l'Europe des Nations Unies (CEE ONU). Selon le Code de pratique statistique européen, fournir des informations statistiques de haute qualité est une tâche essentielle pour les agences statistiques. Étant donné que le risque est défini comme l'impact de l'incertitude sur les objectifs (par exemple, par l'Organisation internationale de normalisation ISO 31000), nous avons jugé approprié de catégoriser les risques en fonction des dimensions de qualité sur lesquelles ils affectent.
La structure proposée pour la qualité des données statistiques issues de grandes sources de données offre une représentation structurée de la qualité tout au long des étapes du processus métier statistique, et peut ainsi servir de base pour une évaluation globale et une gestion des risques associés à ces nouvelles sources de données. Elle introduit de nouvelles dimensions qualitatives spécifiques à l'utilisation des big data pour les statistiques officielles, telles que l'environnement institutionnel / commercial ou la complexité. En utilisant ces nouvelles dimensions qualitatives, il est possible d'identifier de manière plus systématique les risques liés à l'utilisation de grandes sources de données dans la statistique officielle.
Dans ce travail, nous visons à identifier les risques liés à l'utilisation des grandes données dans le contexte de la statistique officielle. Nous adoptons une approche systémique pour définir les risques dans le cadre de la structure de qualité proposée. En nous concentrant sur les nouvelles mesures de qualité proposées, nous pouvons décrire les risques qui sont actuellement absents ou n'ont pas d'impact sur la production de statistiques officielles. En même temps, nous pouvons identifier les risques actuels qui seront évalués de manière tout à fait différente lors de l'utilisation des grandes données pour générer des statistiques. Nous avançons ensuite dans le cycle de gestion des risques et fournissons une évaluation de la probabilité et de l'impact de ces risques. Comme l'évaluation des risques implique une subjectivité dans leur attribution, nous mesurons l'accord entre des dizaines de parties prenantes différentes, fournies indépendamment. Ensuite, nous proposons des options pour réduire ces risques selon quatre catégories principales : éviter, réduire, partager et conserver. Selon l'ISO, l'un des principes de gestion des risques doit être la création de valeur, c'est-à-dire que les ressources pour atténuer les risques doivent être inférieures à celles de l'inaction. Selon ce principe, nous allons enfin évaluer l'impact potentiel de certaines mesures d'atténuation des risques sur la qualité des résultats finaux, afin d'arriver à une évaluation plus complète de l'utilisation des grandes données pour la statistique officielle.
1. Introduction
1.1. Contexte
Le développement des « grandes données » a été caractérisé par Kenneth Neil Cukier et Viktor Mayer-Schönberger dans leur article « La montée des grandes données » (2. ) par le terme « datafication ». La datafication est décrite comme le processus consistant à « prendre tous les aspects de la vie et à les transformer en données ». Par exemple, Facebook propose des réseaux personnels, des capteurs pour toutes sortes de conditions environnementales, des smartphones pour la communication et les déplacements personnels, des données portables pour des conditions personnelles. Cela conduit à une collecte et une disponibilité quasi omniprésentes des données.
Comme dans de nombreux autres secteurs, les statistiques officielles n'ont commencé à discuter la question des grandes données à un niveau stratégique que récemment. Il n'existe pas encore de compréhension commune et largement répandue des moyens d'avancer, que ce soit un défi ou une opportunité, qu'il s'agisse d'une petite ou d'une grande question, etc. Dans le cadre du Groupe de haut niveau sur la modernisation de la production et des services statistiques (3 How big is Big Data? Exploring the role of Big Data in Official Statistics: ), un premier SWOT a été réalisé, accompagné d'une analyse rudimentaire des risques/bénéfices. Il a été noté que « l'analyse complète des risques inclura également des aspects tels que la probabilité et l'impact, et pourrait également être étendue pour définir des stratégies d'atténuation des risques et de gestion ».
Bien que ce document soit encore loin d'une analyse complète des risques, il vise à améliorer la situation en créant le premier aperçu structuré. Nous tenons à souligner que cet aperçu doit être considéré comme un point de départ pour stimuler une discussion générale au sein de la communauté statistique officielle (OSC).
1.2. Domaine
Cet article est exclusivement dédié aux risques, excluant non seulement les avantages, mais aussi les forces et faiblesses, les opportunités et menaces. Cela signifie que les « risques d'inaction » (par exemple, le risque que l'OSC perde en compétitivité par rapport à d'autres acteurs si elle n'est pas modernisée) ne relèvent pas de son champ d'application ; ce sont plutôt des menaces. Au lieu de cela, nous essayons de mettre en évidence les risques qui peuvent survenir (a) si l'OSC exploite les opportunités offertes par les grandes données et commence à développer ou améliorer un « produit officiel de statistique basé sur les grandes données » (BOSP) ; (b) les risques liés au nouveau « modèle d'affaires » normal, c'est-à-dire les risques liés à la production de statistiques officielles basées sur les « grandes données ». (Étant donné que toute production de statistiques officielles est liée à des risques, nous nous limitons (b) aux « risques spécifiques aux grandes données », c'est-à-dire les risques qui n'existent pas ou sont négligeables dans le processus de collecte des statistiques officielles « traditionnelles ».)
1.3. Structure
Dans la section 2, nous présentons les principes fondamentaux associés à cette tâche, en commençant par la base nécessaire pour la gestion des risques et la gestion des risques (section 2.1). Nous présentons également une structure préliminaire de qualité des données statistiques, obtenues à partir de grandes données (section 2.2), car l'association de la structure de qualité avec les risques remplit deux objectifs :
- Elle établit le contexte pour la définition des risques. Certains indicateurs de qualité, associés aux caractéristiques examinées, expriment les valeurs de l'objet, qui sont considérées comme importantes et déterminantes pour la fourniture de services aux clients et aux utilisateurs.
- Cela permet d'attribuer des risques spécifiques aux mesures de qualité, qui sont intégrées dans des hyperespaces généraux et liées à des étapes particulières du processus de production des produits statistiques.
Dans les sections 3, 4, 5 et 6, nous présentons les risques identifiés jusqu'à présent dans divers contextes (4 Les documents de cas d'affaire du projet ESS (https://www.europeansocialsurvey.org/about/structure_and_governance.html) Big Data ainsi que sur les ESSnets Big Data contiennent une liste de risques partiellement liés au projet et partiellement à l'utilisation des grandes sources de données à des fins statistiques. Le document « Un cadre suggéré pour la qualité des grandes données » mentionne certains risques liés aux dimensions de la qualité. / Les documents de cas d'affaire du projet ESS Big Data, ainsi que dans les réseaux ESS Big Data contiennent une liste de risques partiellement liés au projet et partiellement à l'utilisation des sources de grandes données à des fins statistiques. Dans le document « Une structure suggérée pour la qualité des grandes données », certains risques liés aux indicateurs de qualité sont mentionnés.). Ici, nous utilisons la classification de l'accès aux données, le cadre juridique, la confidentialité et la sécurité des données, ainsi que les compétences ; la réorganisation selon la structure de qualité des statistiques obtenues à partir de grandes données (section 2.2) doit être examinée dès que cette structure atteindra un statut plus complet. Pour chaque risque identifié, nous (i) fournissons une évaluation de la probabilité ainsi que de l'impact (conformément à la section 2.1.3) et (ii) proposons des stratégies de réduction des risques et de gestion de ceux-ci (voir section 2.1.4).
À la fin, nous discuterons de nos conclusions et esquisserons quelques étapes suivantes dans la section 7.
2. Fondements
2.1. Risques et gestion des risques
Selon l'ISO 31000: 20095, le risque est défini comme « l'impact de l'incertitude sur les objectifs fixés ». Cela signifie que les objectifs doivent être définis ou connus avant de pouvoir identifier les risques. Ces objectifs sont généralement établis en tenant compte du contexte institutionnel de l'organisation concernée. Une autre considération importante est que les risques portent une caractéristique d'incertitude, c'est-à-dire qu'il n'est pas clair si l'événement décrit se produira. Ainsi, les risques sont mesurés en termes de probabilité de survenance de l'événement et de ses conséquences, c'est-à-dire l'impact que cet événement a sur l'atteinte des objectifs fixés. L'évaluation des risques devrait fournir des informations plus objectives qui, au final, permettront de trouver un équilibre approprié entre la réalisation des opportunités de profit et la minimisation des conséquences négatives. La gestion des risques est une partie intégrante de la pratique de management et un élément important des bonnes pratiques d'entreprise (6 Statistique Canada : rapport 2014-2015 sur les plans et priorités, ). C'est un processus itératif qui, idéalement, permet d'améliorer continuellement le processus de prise de décision et favorise l'amélioration continue de la performance.
Les risques sont également liés à la qualité. L'application d'un système de qualité doit permettre d'exploiter les opportunités offertes par diverses sources et méthodologies pour obtenir un résultat d'un certain niveau de qualité, dans le sens où ce résultat satisfait les besoins des utilisateurs. Tout comme les risques, les niveaux de qualité peuvent être issus de l'environnement institutionnel et des objectifs d'institutions spécifiques. Dans ce contexte, l'environnement institutionnel détermine le niveau global de risque que l'organisation est prête à supporter pour atteindre ses objectifs.
Le processus d'évaluation et de gestion des risques peut être divisé en différentes étapes, qui comprennent l'établissement du contexte, l'identification des risques, l'analyse des risques en termes de probabilité et d'impact, l'évaluation des risques et, enfin, le traitement des risques.
2.1.1. Contexte institutionnel
La première étape consiste à établir le contexte stratégique, organisationnel et de gestion des risques dans lequel le reste du processus se déroulera. Cela comprend la définition des critères selon lesquels les risques seront évalués et la détermination de la structure d'analyse.
2.1.2. Identification des risques
Au deuxième stade, il est nécessaire de déterminer les événements susceptibles d'affecter l'atteinte des objectifs. L'identification doit inclure des questions liées au type de risques, à la durée des événements, à leur lieu ou à la manière dont les événements peuvent empêcher, aggraver, retarder ou améliorer l'atteinte des objectifs.
2.1.3. Évaluation des risques
L'étape suivante consiste à identifier les mesures de contrôle existantes et à analyser les risques en termes de probabilité et de conséquences potentielles. Dans le contexte de cet article, la probabilité ou le risque d'occurrence est évalué sur une échelle de 1 (peu probable) à 5 (fréquent). L'impact des événements est mesuré sur une échelle de 1 (insignifiant) à 5 (extrême). Comme indiqué dans le tableau 1, le produit de la probabilité et de l'impact donne le « niveau de risque » dans une fourchette de 1 à 25.
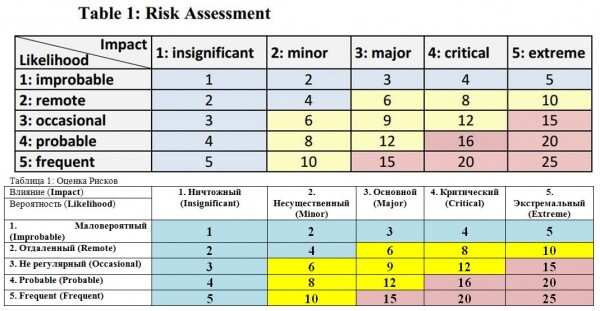
Les niveaux de risque évalués peuvent être comparés aux critères préalablement définis pour établir un équilibre entre les avantages potentiels et les résultats défavorables. Cela permet de porter des jugements sur les priorités de gestion.
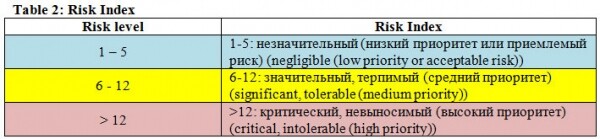
Les priorités d'action doivent porter sur les risques critiques (voir tableau 2), c'est-à-dire ceux qui peuvent se produire et qui ont des conséquences graves ou extrêmes pour les objectifs de l'organisation.
2.1.4. Réaction aux risques
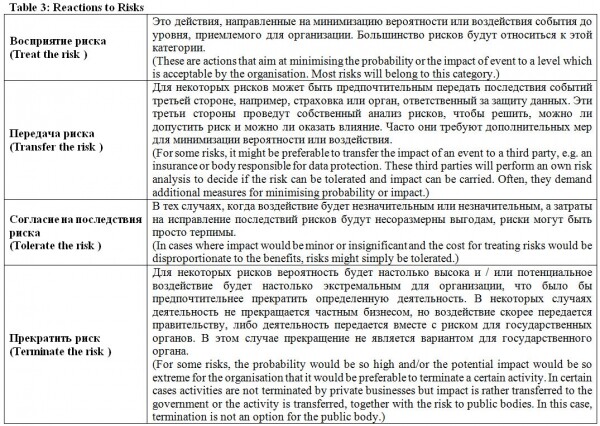
La dernière étape concerne les décisions sur la manière de réagir aux risques. Certains risques, jugés en dessous d'un niveau de risque prédéfini, peuvent être ignorés ou tolérés. Pour d'autres, les coûts de neutralisation des risques peuvent être si élevés qu'ils l'emportent sur les bénéfices potentiels. Dans ce cas, l'organisation peut décider d'abandonner l'activité concernée. Les risques peuvent également être transférés à des tiers, comme par exemple l'assurance, qui compense les coûts encourus. La dernière option consiste à prendre en compte les risques lors de la définition des stratégies et des actions qui équilibrent les coûts avec les bénéfices potentiels. Ainsi, l'organisation décidera de mettre en œuvre des stratégies visant à maximiser les bénéfices et à minimiser les coûts potentiels.
2.2. Systèmes de qualité
Un groupe cible, composé de représentants d'organisations statistiques nationales et internationales, a élaboré en 2014 un cadre préliminaire de qualité pour les statistiques dérivées des grandes données. Ce groupe cible a travaillé sous l'égide du projet UNECE/HLG « Le rôle des grandes données dans la modernisation de la production statistique ». Il a élargi les systèmes de qualité existants, développés pour évaluer les statistiques issues de sources administratives, avec des indicateurs de qualité jugés pertinents pour de grandes sources de données.
Dans le cadre de ce système, une distinction est faite entre trois phases du processus commercial : l'entrée, la productivité et la sortie. La phase d'entrée correspond aux phases de « conception » et de « collecte » de GSBP, la productivité aux phases de « processus » et d'« analyse », tandis que les données de sortie équivalent à la phase de « diffusion ».
La structure utilise une hiérarchie qui s'inspire de la structure des données administratives développée par le Bureau des statistiques des Pays-Bas (7 Daas, P., S. Ossen, R. Vis-Visschers et J. Arends-Toth, (2009), Checklist for the Quality evaluation of Administrative Data Sources. Statistics Netherlands, La Haye/Heerlen). Les mesures de qualité sont intégrées dans une structure hiérarchique appelée hyperspaces. Trois hypersurfaces définies sont « source », « métadonnées » et « données ». Les mesures de qualité sont imbriquées dans ces hypersurfaces et attribuées à chaque étape de la production. Pour la phase d'entrée, des aspects supplémentaires tels que « confidentialité et secret », « complexité » (en fonction de la structure des données), « exhaustivité » des métadonnées et « connectivité » (capacité à relier les données à d'autres données) ont été proposés pour enrichir le modèle de qualité standard. Pour chacun des indicateurs de qualité, des facteurs pertinents sont proposés pour leur description ainsi que des indicateurs possibles.
Dans le contexte de cet article, les risques peuvent être exclus de ces facteurs. Par exemple, les facteurs à considérer pour mesurer la qualité de « l'environnement institutionnel / commercial » incluent la robustesse du fournisseur de données. Le risque associé peut être que les données ne soient plus disponibles chez le fournisseur de données à l'avenir. Un autre exemple est lié à un aspect récemment proposé de la qualité, la confidentialité et la sécurité. Un des facteurs importants est « la perception », ce qui signifie la possible perception négative d'un usage prévu de sources de données spécifiques par différentes parties prenantes.
3. Risques liés à l'accès aux données
3.1. Absence d'accès aux données
3.1.1. Description
Ce risque résulte d'un projet associé au développement de BOSP qui ne parvient pas à accéder à la source de Big Data (BDS) nécessaire.
À ce jour, l'OSC a appris à la dure que même sortir des blocs de départ et obtenir cet accès peuvent parfois être un obstacle insurmontable. Parfois, il est facile d'accéder à une source spécifique — telle que les enregistrements de données d'appels (CDR), pour des fins de test/recherche, mais il est beaucoup plus difficile (pour des raisons juridiques ou commerciales) d'y accéder pour des besoins de production.
3.1.2. Probabilité
La probabilité dépend en grande partie des caractéristiques du BDS. S'il s'agit de grandes données administratives, elles peuvent n'en représenter qu'une partie, notamment si (comme dans le cas des données de boucle de trafic examinées par Daas et al. 8 Daas, P., M. Puts, B. Buelens et P. van den Hurk. 2015. «Big Data as a Source for Official Statistics». Journal of Official Statistics 31 (2). (À paraître ; publication prévue pour juin 2015.)) il n'y a pas de problèmes de protection des données personnelles. Si le cas du BDS appartient à un particulier, notamment s'il est sensible (par exemple, en termes de protection des données) ou précieux (d'un point de vue commercial), la probabilité peut être très élevée (5).
3.1.3. Impact
L'impact dépend du BOSP et de l'utilisation du BDS. Si le BDS est au cœur du sujet, l'impact peut être très élevé (4 = il est impossible de produire le BOSP), alors qu'il peut être inférieur s'il est encore possible de produire le BOSP (bien que de moindre qualité), en s'appuyant sur d'autres URB, ce qui entraîne un impact dans la fourchette de 2 à 3.
3.1.4. Prévention
Pour réduire le risque d'absence d'accès, il est conseillé d'établir des contacts préalables avec le fournisseur de données et de conclure un accord à long terme sur l'accès aux données. De plus, une analyse juridique complète doit être effectuée concernant la combinaison spécifique de BDS et de BOSP. Il convient également d'évaluer les possibilités d'accès aux données dans le cadre de la législation actuelle ou future.
3.1.5. Atténuation
S'il existe des BDS alternatifs qui peuvent être utilisés pour le BOSP, ceux-ci devraient être envisagés à la place. S'il n'y a aucun moyen de produire le BOSP sans BDS, et s'il est impossible de surmonter l'absence d'accès, les efforts doivent être interrompus et un nouveau BOSP ne verra pas le jour.
3.2. Perte d'accès aux données
3.2.1. Description
Ce risque consiste en la perte par la gestion statistique du BDS, qui sous-tend le BOSP.
3.2.2. Probabilité
Si le BOSP est déjà en production, il y a généralement une certaine stabilité, et dans certains cas, le risque peut être très faible (1). Cependant, notamment dans le cas de sujets privés pour lesquels des accords insuffisamment solides ont été conclus, rien ne peut empêcher, par exemple, une nouvelle direction de modifier la politique de fourniture des données, ce qui entraîne un risque modéré de rupture (3). De plus, si le BDS est lié à une activité instable, il existe toujours un risque que le fournisseur fasse faillite, et ce risque peut même être plus élevé (4).
3.2.3. Impact
Étant donné qu'un BOSP existant peut être impossible à produire, il y a souvent un impact très fort (5). Dans d'autres cas, lorsque le BDS est auxiliaire, l'impact peut plutôt être une perte de qualité avec un impact dans la plage de 2-3.
3.2.4. Prévention
La stratégie de prévention est semblable à la stratégie d'absence d'accès aux données, mais avec un accent accru sur la vigilance constante même en conditions de production.
Ne pas mettre tous ses œufs dans le même panier (c'est-à-dire avoir plusieurs BDS sous-jacents à chaque BSOP) peut également être une stratégie, mais cela peut être soit impraticable, soit trop coûteux.
3.2.5. Atténuation
Si le BDS résulte d'une activité instable, il est possible qu'un nouveau BDS, reflétant le même phénomène social, devienne progressivement disponible. Cependant, il serait trop tard pour commencer le « scan du marché » une fois que le BSOP est hors service ; une vigilance constante est nécessaire — ce qui peut être difficile à atteindre.
4. Risque lié à l'environnement juridique
4.1. Non-respect de la législation applicable
4.1.1. Description
Ce risque est lié à un projet de développement de BOSP, dans lequel la législation applicable n'est pas prise en compte, rendant le BOSP non conforme à la législation désignée. Cela peut concerner la législation sur la protection des données, les réglementations concernant le fardeau de la réponse, etc.
4.1.2. Probabilité
Compte tenu de l'ignorance de l'OSC concernant les grandes données, il n'est pas exclu qu'un non-respect accidentel (3) puisse survenir. La probabilité est généralement liée au BDS, car plus la source est « insensible », moins il y a de chances qu'une non-conformité se produise.
4.1.3. Impact
L'impact est généralement critique (4) dans le sens où une production non conforme nécessitera l'arrêt du BOSP (ou, si celui-ci n'a pas encore atteint la phase de mise en œuvre, son développement devra être interrompu). Cela peut même être extrême (5), car les risques réputationnels découlant de statistiques officielles non conformes («illégales») peuvent avoir des conséquences.
4.1.4. Prévention
Pour tout BOSP, une analyse juridique approfondie est nécessaire — et cela se fait à plusieurs étapes (ce qui est acceptable au stade du développement / de l'exploration peut ne pas l'être au stade de l'implémentation / de la production). Cela peut à son tour entraîner une réingénierie du BOSP pour le rendre compatible.
4.1.5. Atténuation
En fonction de la gravité de la non-conformité, la première étape peut consister à mettre le BOSP en mode hors ligne.
La réingénierie du BOSP pour le rendre compatible peut être une option, mais la possibilité que le BOSP soit «sauvé» de cette manière dépend fortement de la nature de la non-conformité.
4.2. Changements défavorables dans l'environnement juridique
4.2.1. Description
Une nouvelle législation concernant le BOSP en cours de développement peut être introduite, rendant en fait le BOSP incompatible.
4.2.2. Probabilité
Il n'est pas exclu que les partisans d'une protection des données renforcée réussissent à imposer de nouvelles exigences qui affecteront directement ou indirectement la possibilité de créer des BOSP spécifiques. Une probabilité dans la fourchette de 2-3 semble être une estimation réaliste.
4.2.3. Impact
L'impact est généralement critique (4), dans le sens où une production non conforme nécessitera l'arrêt du BOSP.
4.2.4. Prévention
Certaines informations commerciales doivent être régulièrement surveillées pour suivre l'évolution de la législation — peut-être aussi pour influencer celle-ci en plaidant en faveur de statistiques officielles lors de forums appropriés (par exemple, consultatifs).
4.2.5. Atténuation
À condition qu'une surveillance proactive ait été effectuée, il peut y avoir du temps pour réingénierie du BOSP afin de le mettre en conformité avec la nouvelle législation dès le premier jour de son entrée en vigueur.
En revanche, si la surveillance n'a pas été effectuée, de sorte que la nouvelle législation est devenue une « surprise » — ou si la législation est tellement radicale qu'il n'existe aucun moyen de rendre le BOSP incompatible — la seule option pourrait être de désactiver le BOSP.
5. Risques liés à la confidentialité et à la sécurité des données
5.1. Violations de la sécurité des données
5.1.1. Description
Ce risque concerne l'accès non autorisé aux données stockées dans les gestions statistiques. Des tiers peuvent obtenir des données qui sont sous embargo, par exemple, à cause de la publication d'un calendrier. Pour tout BOSP qui repose entièrement sur une seule BDS, il est inévitable que les données soient implicitement connues du propriétaire initial des données, et si la méthodologie est transparente, les statistiques dérivées seront également connues. Cette situation n'est pas abordée ici, mais plutôt dans le risque lié aux abus de pouvoir par les propriétaires. De plus, ces données peuvent comporter un risque de violation de la confidentialité. Ce risque sera examiné séparément. Cela peut inclure, par exemple, des données que les investisseurs attendent sur le marché boursier.
5.1.2. Probabilité
En ce qui concerne les aspects techniques de la protection de l'environnement informatique dans la division statistique, le risque est de même probabilité pour les BDS que pour les sources traditionnelles. Cependant, deux aspects supplémentaires doivent être pris en compte.
Premièrement, avec certains BDS, le risque global augmente légèrement en raison du fait que la sécurité des données du propriétaire initial peut être compromise. Cela peut être dû, par exemple, à de l'espionnage industriel ou à des piratages.
Deuxièmement, une fois que des données potentiellement précieuses commencent à être stockées dans les bureaux, le risque d'attirer des intentions malveillantes augmente. Si les données stockées ont une très grande valeur pour l'entreprise, il convient de se préparer à une probabilité très élevée d'attaques ciblées sur l'infrastructure informatique, ce qui signifie que la probabilité de piratage peut être potentiellement plus élevée.
Si les données stockées ne sont pas perçues comme ayant de la valeur, la probabilité globale semble peu élevée — entre 1 et 3 selon la source des données.
5.1.3. Impact
Le potentiel de dommage à la réputation peut être considérable (5). Dans le cas des BDS, ce qui est important, c'est que si une violation de sécurité se produit chez le propriétaire initial, l'impact sur la réputation de la gestion statistique devrait, en principe, être moindre que si la violation concernait des données sous sa garde.
D'un autre côté, il est possible qu'une violation dans la gestion statistique ait des conséquences négatives pour le propriétaire initial. Dans ce cas, il est à nouveau possible qu'il y ait une forte influence négative en raison des dégâts en termes de confiance entre le fournisseur et la gestion statistique (5).
5.1.4. Prévention
Ce qui caractérise le cas des BDS, c'est que les procédures de sécurité du propriétaire initial peuvent être pertinentes. Il est peu probable que les gestions statistiques obtiennent des pouvoirs d'audit pour contrôler cela. Les propriétaires, dont les données sont utilisées pour établir des enregistrements avec des échéances de publication sensibles, doivent être informés des conséquences pour les statistiques officielles d'une potentielle violation de sécurité dans leurs locaux et doivent recevoir une garantie officielle que des procédures de sécurité appropriées sont en place.
Une façon directe de prévenir un impact sérieux d'une violation de sécurité dans les locaux du propriétaire sur la gestion statistique est d'assurer l'utilisation de plusieurs sources pour un même produit, de sorte qu'une seule source compromise ne soit pas suffisante pour obtenir un chiffre final. L'avantage de cette approche est qu'un plus grand contrôle est exercé par la gestion statistique.
La méthode pour prévenir les conséquences négatives d'une violation de la sécurité dans un bureau de statistiques pour le propriétaire initial des données consiste à trouver un moyen de travailler qui n'implique pas le transfert de données potentiellement sensibles du point de vue du propriétaire vers la gestion statistique. En l'état brut. Une approche préventive possible est l'utilisation de données agrégées. Il convient de noter cependant que certaines formes d'agrégation, par exemple celles destinées à prévenir l'identification des membres individuels de la population, peuvent ne pas être appropriées dans ce cas. L'une des raisons peut être que le risque pour le propriétaire est lié à la valeur commerciale des données, qui peut être substantielle même après l'atteinte de l'anonymat.
5.1.5. Atténuation
En cas de violation des données sous la responsabilité de la gestion statistique, les mesures d'atténuation des conséquences seront les mêmes que pour les sources traditionnelles, sauf si un impact négatif a été subi par le propriétaire initial.
En cas de conséquences négatives pour le propriétaire initial, la gestion statistique doit réexaminer et renforcer ses procédures de sécurité et clairement communiquer et démontrer son engagement envers cela.
Si la violation s'est produite dans les locaux du propriétaire initial, le service statistique concerné doit clairement faire état de la situation et insister sur l'amélioration des procédures de sécurité du propriétaire. Si nécessaire, il peut être envisagé de chercher un fournisseur alternatif.
5.2. Violations de la confidentialité des données
5.2.1. Description
C'est le risque que la confidentialité d'une ou plusieurs personnes de la population statistique soit violée. Cela peut être dû à une attaque sur l'infrastructure IT sous la pression d'autres agences gouvernementales ou en raison de mesures de contrôle inadéquates sur la divulgation de données statistiques.
5.2.2. Probabilité
Tout comme dans le cas du risque de violation de la sécurité des données, les conditions techniques de stockage des micro-données ne changent guère avec l'ajout de l'EDS. Cependant, il existe également des mises en garde ici.
Les micro-données provenant de certaines sources de données peuvent avoir une grande valeur commerciale, de sorte que leur stockage augmentera la probabilité d'attaques.
De plus, certaines microdonnées peuvent être potentiellement très utiles pour d'autres agences gouvernementales, comme les forces de l'ordre, la fiscalité ou la santé. Dans certaines circonstances, l'adhésion au principe de la confidentialité statistique peut être soumise à une forte pression.
En ce qui concerne les défaillances dans le contrôle de la divulgation des informations statistiques, il existe déjà une pratique établie. Le BDS peut permettre de produire des statistiques pour de petits sous-groupes de la population ou de fournir la possibilité de relier des données agrégées de divers BDS, ce qui peut augmenter les risques. De plus, de nouvelles sources nécessiteront toutefois de nouveaux développements méthodologiques, c'est pourquoi le véritable danger réside dans le fait que la méthodologie de contrôle de la divulgation des informations ne soit pas mise à jour correctement.
En général, avec des mesures préventives raisonnables, la probabilité peut être maintenue à des niveaux raisonnables, mais comme il existe de nombreux facteurs différents et variés, l'évaluation appropriée ici semble être que la probabilité est élevée (4).
5.2.3. Impact
Le potentiel de dommages à la réputation peut être important (5). Comme pour le risque de violation de la sécurité des données, une rupture dans la gestion statistique peut avoir des conséquences négatives pour le propriétaire d'origine. Ici, l'impact d'un tel événement pourrait être potentiellement encore plus grand, surtout si les tendances actuelles de l'opinion publique se poursuivent. Les dommages dans les relations entre le fournisseur de données et la gestion statistique devraient également être très importants.
5.2.4. Prévention
Le moyen infaillible de prévenir ce risque est de ne pas avoir de microdonnées issues de BDS (bien que la conservation d'autres microdonnées demeure associée à un risque pertinent, mais avec une probabilité et un impact différents). Cette approche, tout comme pour le risque de violation de la sécurité des données, impliquera le besoin de développer d'autres méthodes d'utilisation des données à des fins statistiques. De plus, la nature variée des sources ici signifie qu'il sera nécessaire de développer de nouvelles méthodologies avec des objectifs concurrents d'extraction du maximum d'informations utiles tout en protégeant la confidentialité des données.
En cas de stockage de microdonnées, les mécanismes de sécurité IT et de contrôle d'accès doivent être à un niveau requis et surveillés en permanence. Une attention particulière doit être portée à la sécurité des nouvelles méthodes d'obtention de données. Ironiquement, cette nouvelle méthode pourrait être le transport physique des dispositifs de stockage (par exemple, des disques durs). Si cette méthode est utilisée, la livraison doit être physiquement sécurisée et le chiffrement doit être employé.
5.2.5. Atténuation
Les mesures d'atténuation ici sont en principe les mêmes que dans le cas d'une violation de sécurité des données. Si la cause de la violation est la pression d'un autre organe gouvernemental, il convient de saisir l'opportunité de renforcer l'indépendance de la gestion afin que de telles violations soient encore plus difficiles à l'avenir.
5.3. Manipulations de la source de données
5.3.1. Description
Les fournisseurs de données tiers, comme les données des réseaux sociaux ou les données fournies volontairement, sont exposés au risque de manipulation. Cela peut être effectué soit par le fournisseur de données lui-même, soit par des tiers. Par exemple, de nombreux faux messages sur les réseaux sociaux peuvent être générés pour influencer l'indice statistique obtenu sur la base de ces données d'une manière ou d'une autre, si l'on sait que l'indice est calculé sur la base de telles données.
Pour les données fournies volontairement, il peut s'agir d'un cas où des bénévoles représentent un certain groupe d'intérêts avec un certain agenda.
5.3.2. Probabilité
Pour les données dont la manipulation peut apporter un grand bénéfice, la probabilité est plus élevée. Il peut s'agir de données pour lesquelles les statistiques sont intéressantes, comme le marché boursier. À la lumière des récents scandales liés au LIBOR et au Forex, on peut supposer que tant qu'il existe une incitation, les tentatives de manipulation des données seront probables.
Pour les statistiques basées sur des données fournies volontairement, il suffit de jeter un œil aux pratiques récentes en matière de relations publiques qui consistent à recruter des personnes prétendant avoir un certain avis et payées pour exprimer publiquement cet avis (par exemple, sur les forums Internet) pour conclure que cette probabilité n'est pas négligeable. En général, un chiffre de 3 à 4 semble adéquat.
5.3.3. Impact
Le principal problème avec les manipulations est qu'elles peuvent durer longtemps sans être détectées. Si les manipulations se poursuivent pendant une longue période, l'impact sur la qualité peut devenir significatif. De plus, les dommages à la confiance publique dans les statistiques officielles peuvent également être importants, surtout si le rôle des bureaux statistiques en tant que fournisseurs de données de qualité est souligné publiquement. D'autre part, si les manipulations sont détectées à temps et ensuite publiées, cela peut en fait améliorer la perception publique. Sauf dans des cas extrêmement graves, on peut envisager un impact maximal (3).
5.3.4. Prévention
La réalisation régulière d'exercices de contrôle avec des sources alternatives est l'une des approches préventives possibles. Ces sources alternatives peuvent être traditionnelles ou autres. L'utilisation de statistiques basées sur une combinaison de sources peut éviter des impacts significatifs de manipulations. Dans les cas où des manipulations initiées par le fournisseur sont craintes, des accords juridiques peuvent également constituer un moyen de prévenir de telles pratiques.
5.3.5. Atténuation
En ce qui concerne les dommages aux relations publiques, les mesures d'atténuation qui doivent être prises ici ne diffèrent guère des mesures prises pour lutter contre toute crise.
En ce qui concerne la qualité des données, il serait utile que les données passées puissent être corrigées de sorte qu'une série correcte puisse être présentée même avec un grand retard.
Cela peut être utile d'effectuer un benchmarking régulier. Notez que l'objectif de l'analyse comparative, dans ce cas, diffère légèrement de celui de la prévention. Pour la prévention, il est important de détecter et d'examiner rapidement toute incohérence suspecte entre les données du test de référence et celles du BDS. Pour atténuer les conséquences, les anciennes données utiles sont toujours bénéfiques.
De plus, il convient de veiller à éviter de telles manipulations à l'avenir — dans des cas particulièrement sensibles, cela peut signifier obtenir des données potentiellement redondantes de plusieurs fournisseurs pour l'analyse comparative.
5.4. Perception défavorable du public concernant l'utilisation des grandes données par les statistiques officielles
5.4.1. Description
Les médias et le grand public sont très sensibles aux questions de confidentialité et à l'utilisation des données personnelles provenant de grandes sources de données, en particulier dans le contexte de la réutilisation des données par les autorités administratives qui prennent des mesures administratives ou judiciaires à l'encontre des citoyens. L'utilisation perçue de manière négative peut se traduire par un contrôle de la vitesse basé sur l'analyse des données de navigation (11 Voir ).
Le cas spécifique de TomTom Netherlands a entraîné une baisse significative de la demande pour les appareils TomTom et a conduit l'entreprise à limiter l'accès aux données. Dans ce cas particulier, les données concernaient des individus, mais à des niveaux de vitesse sur des sections de route.
Cependant, il peut exister des applications de grandes données qui sont perçues positivement par le public. Un exemple pourrait être des applications qui préviennent des crimes tels que le vol par effraction, basées sur des méthodes de grandes données.
L'opinion publique positive, ainsi que négative, peut avoir un impact fort sur l'utilisation des BDS dans le contexte de la production de statistiques officielles.
Une conséquence de la perception négative du public peut être que :
- Les BDS ne seront plus accessibles aux offices statistiques, soit en raison de décisions des fournisseurs de données, soit de décisions gouvernementales de ne pas utiliser les données, ou
- l'utilisation des données sera limitée, ce qui pourrait interférer avec la production, si certains BOSP.
5.4.2. Probabilité
Facteurs pouvant influencer la probabilité d'un tel événement ou son impact sur la production de statistiques :
- confidentialité des données, c'est-à-dire la facilité d'identification des personnes ;
- volume d'informations que les données révèlent sur des individus, par exemple, augmentant par la liaison de données provenant de différentes sources ;
- type de données, par exemple, les transactions financières étant perçues comme plus confidentielles que d'autres données ;
- type d'action potentielle pouvant être entreprise à l'égard des citoyens, par exemple, sanctionner les personnes pour excès de vitesse ;
- environnement juridique flou dans lequel opèrent les fournisseurs et utilisateurs de données ou lorsque les conditions juridiques entrent en contradiction avec les opinions publiques / normes éthiques ;
- degré de dépendance à une source de données particulière pour obtenir des statistiques ; à l'étape d'exploration, ce facteur peut avoir une importance limitée. Cependant, cela peut avoir un impact majeur sur l'obtention de statistiques à un stade ultérieur et doit donc également être pris en compte à l'étape d'exploration. L'un des problèmes peut résider dans le fait que le volume final d'utilisation des données est inconnu au début, car les sources de données peuvent potentiellement servir à plusieurs domaines statistiques.
L'évaluation du temps des événements indésirables est impossible, car la mobilisation du public est souvent déclenchée par la couverture d'événements ayant un impact négatif sur les citoyens. Néanmoins, avec l'augmentation de l'utilisation des grandes données par les gouvernements et entreprises privées, et en particulier avec le marketing actif des données à des fins autres que celles ayant conduit à leur collecte initiale, il est plus probable que de tels événements se produisent.
Les événements ayant un impact significatif sur la perception publique sont peu fréquents, mais plutôt aléatoires (3) et éloignés (2). Avec l'augmentation de l'utilisation des grandes sources de données, la probabilité augmentera également.
5.4.3. Influence
L'impact d'un événement dépend fortement des facteurs discutés ci-dessus. Dans l'ensemble, l'influence est plus sérieuse pour la production de données statistiques déjà établie, car il se peut que l'action doive être interrompue. L'impact dépend également de la disponibilité de sources de données alternatives, bien qu'il puisse arriver que la perception publique ne distingue pas les différentes sources de données dans le cas où l'événement se matérialise. Dans l'état actuel d'utilisation des grandes données, il semble que ces sources ne peuvent pas complètement remplacer les sources de données traditionnelles, mais plutôt compléter les statistiques existantes. Cela réduira l'impact des événements. Par conséquent, l'impact d'un événement est considéré dans une fourchette de 2 (insignifiant) à 3 (principal). Au stade de la production, l'impact peut augmenter à 4 (valeur critique).
5.4.4. Prévention
Les mesures préventives peuvent consister à définir des principes éthiques pour les grandes données dans la statistique officielle. Les principes éthiques devraient être basés sur des principes tels que le code de conduite pour la statistique européenne ou les principes fondamentaux de la statistique officielle (12 ). La mesure suivante sera de définir une stratégie de communication qui publiera les résultats des principes éthiques pour le public et pourra être utilisée pour informer les parties prenantes sur l'utilisation éthique des BDS pour le BOSP.
Une évaluation des risques particulière pour une BDS spécifique peut être réalisée pour identifier les risques et proposer des actions préventives ou d'atténuation sur la base de principes éthiques. Une évaluation distincte des risques peut également inclure des parties prenantes, telles que des agences de protection des données, afin d'assurer l'identification de tous les risques et la justification des actions.
5.4.5. Atténuation
La stratégie de communication doit également inclure des mesures en cas d'augmentation de l'attitude négative du public. Une évaluation distincte des risques devrait rassembler des exemples positifs d'utilisation des données et des mesures pour prévenir les abus de données, qui pourraient être nécessairement adoptées au niveau politique, et la communauté statistique pourrait ne pas être en mesure d'y influencer efficacement.
5.5. Perte de confiance - obtenue sans observation
5.5.1. Description
Les utilisateurs de statistiques officielles ont généralement une grande confiance dans l'exactitude et la fiabilité des données statistiques. Cela repose sur le fait que la production de données statistiques est intégrée dans une base méthodologique solide et accessible, ainsi que dans la documentation sur la qualité du produit statistique. De plus, la plupart des données statistiques sont basées sur des observations, c'est-à-dire obtenues par le biais d'enquêtes ou de recensements, établissant un lien facilement compréhensible entre l'observation et les données statistiques. L'utilisation de BDS, qui ne sont pas collectées à la fin principale de la statistique, est risquée car ces liens peuvent être perdus, et les utilisateurs perdront confiance dans les données de la statistique officielle. Un exemple lié au dernier recensement (2010) est que dans certains pays, les données statistiques ont été obtenues à l'aide de plusieurs sources et modèles statistiques. Dans plusieurs cas, les parties prenantes ont contesté les données statistiques.
5.5.2. Probabilité
La probabilité d'un risque dépend de facteurs tels que la complexité du modèle statistique/méthodologique, la fiabilité des relations entre BDS et BOSP ou la conformité à d'autres données statistiques. La probabilité doit être comprise entre 3 (rare) et 4 (probable), ce qui signifie que cela peut se produire plusieurs fois ou souvent.
5.5.3. Impact
L'impact de l'apparition du risque dépendra en grande partie de la capacité des OSN à prouver avec succès l'exactitude et la fiabilité des données statistiques. Si cela ne peut pas être atteint, l'impact en termes de perte de confiance pourrait également affecter d'autres domaines statistiques, c'est-à-dire mettre en doute non seulement certaines données statistiques, mais également remettre en cause l'organisation elle-même. Les OSN perdraient ainsi leur avantage concurrentiel par rapport à d'autres organisations privées opérant dans ce domaine.
5.5.4. Prévention
Les actions préventives consisteront à développer et à publier une méthodologie fondée sur des preuves, reconnue par la communauté scientifique, enrichissant les données avec des métadonnées de qualité, et assurant la cohérence BOSP avec les non-BOSP, tout en exerçant un contrôle strict de la qualité.
Avant de commencer la production statistique, le BOSP pourrait être publié à titre expérimental, et il serait recommandé aux parties prenantes de contester le BOSP pour le confirmer ou l'améliorer.
5.5.5. Atténuation
Il existe deux cas à distinguer. Lorsque les données statistiques sont contestées, mais qu'elles ont une qualité élevée / suffisante (correcte / précise), il suffirait d'expliquer et de communiquer les données statistiques au public, en fournissant des exemples faciles à comprendre.
6. Risques liés aux compétences
6.1. Pénurie de spécialistes
6.1.1. Description
L'analyse des traces numériques laissées par les individus lors de leurs activités nécessite des outils d'analyse de données qui ne sont actuellement pas les plus courants dans les statistiques officielles. Tout d'abord, l'utilisation de données indirectes sur les activités des personnes au lieu d'enquêtes directes dans les sondages requiert l'utilisation de modèles statistiques et, par conséquent, des compétences en raisonnement et en apprentissage automatique. Deuxièmement, ces enregistrements numériques sont constitués de données qui n'ont souvent pas le format tabulaire habituel, typique des résultats d'enquête, avec des lignes correspondant à l'unité statistique et des colonnes avec des caractéristiques spécifiques de ces unités statistiques. Les traces numériques se présentent également sous forme de texte, de son, d'image et de vidéo. L'extraction d'informations statistiques pertinentes de ces types de données nécessite des compétences en traitement du langage naturel, en traitement des signaux audio et en traitement d'image. Troisièmement, ces sources de données ont tendance à fournir des ensembles massifs de données, dont le traitement nécessite une bonne compréhension des méthodologies de calcul distribué.
Le risque de pénurie d'experts réside dans l'obtention de données à partir de l'une de ces nouvelles grandes sources de données, car la gestion statistique n'a pas la capacité de les traiter et de les analyser correctement en raison du manque de compétences nécessaires parmi son personnel.
6.1.2. Probabilité
La probabilité de ce risque dépendra de trois facteurs : 1) les types spécifiques de compétences nécessaires pour chaque type de source de grandes données et la probabilité que la gestion statistique trouve une occasion d'étudier une telle source ; 2) la disponibilité actuelle des compétences nécessaires dans la gestion statistique ; et 3) la culture organisationnelle de la gestion statistique.
En ce qui concerne les types de compétences qui peuvent être nécessaires, il convient de noter que toutes les sources ne nécessitent pas toutes les compétences énumérées ci-dessus. Certaines (comme les données de type Google Trends) ne nécessitent pas de calculs distribués, car elles ont déjà été prétraitées par le détenteur des données ou possèdent des compétences en traitement de signaux, et elles auront principalement besoin de compétences en modélisation statistique. Cependant, il existe une grande variété de sources de grandes données, pour la plupart desquelles des compétences en calculs distribués, en traitement de signaux et en apprentissage automatique sont requises. En même temps, une recherche adéquate sur ces traces numériques nécessitera le traitement de plusieurs sources. Ainsi, il y a une forte probabilité que les grandes sources de données devenant accessibles pour la gestion statistique nécessitent ces compétences atypiques, et la probabilité de ce risque est très élevée (5).
En ce qui concerne la disponibilité actuelle des compétences nécessaires, cela dépendra de la gestion statistique spécifique. Même si la méthodologie d'enquête est moins répandue que la méthodologie d'enquête, elle est également utilisée dans la statistique officielle dans certains domaines. Par conséquent, même si cela peut nécessiter une certaine redistribution des ressources humaines, les administrations statistiques peuvent trouver des solutions par leurs propres moyens. En ce qui concerne les compétences en calculs distribués, principalement liées à l'informatique, elles dépendront de la manière dont l'infrastructure informatique est gérée au sein de l'organisation. Selon le degré de soutien du service informatique, des solutions peuvent être trouvées dans le cadre des accords existants. Toutefois, les compétences en traitement de signaux et en apprentissage automatique n'existent généralement pas dans la plupart des administrations statistiques officielles, et l'application de ces compétences ne peut pas être externalisée, car elles doivent être appliquées par des experts en statistiques. Par conséquent, sous cet angle, la probabilité de ce risque semble également très élevée (5).
La culture organisationnelle influencera également la probabilité de ce risque. La présence de personnel prêt à acquérir les compétences nécessaires par auto-apprentissage peut permettre à l'organisation de réagir à une situation avec une nouvelle source de données nécessitant des compétences différentes de celles habituellement requises. Cela dépendra de la culture organisationnelle de la gestion statistique, notamment de savoir si elle incite les employés à acquérir de nouvelles compétences et si elle leur accorde du temps pour l'auto-formation.
Ainsi, la probabilité que la gestion statistique ne puisse traiter et analyser de nouvelles sources de données en raison d'un manque de compétences de la part de ses employés sera comprise entre probable (4) et fréquente (5), selon la culture de l'auto-apprentissage de l'organisation.
6.1.3. Impact
Une gestion statistique incapable de traiter et d'analyser de grandes sources de données en raison du manque de compétences de ses employés peut avoir deux conséquences négatives possibles : 1) la source de données ne sera pas pleinement explorée ; 2) la source sera mal utilisée.
L'absence de possibilité d'explorer pleinement le potentiel d'une précieuse source de données massives aura un impact négligeable (2) à court terme, car les gestions statistiques disposent réellement d'outils statistiques pour répondre aux besoins actuels. Cependant, à long terme (et peut-être même à moyen terme), les conséquences de la perte de cette opportunité seront significatives (4), car les gestions statistiques sont de plus en plus confrontées à la concurrence de fournisseurs privés qui n'ont pas la même structure institutionnelle leur permettant de garantir au public l'indépendance des données statistiques.
Cependant, une utilisation incorrecte de la source aura des conséquences extrêmement négatives pour les bureaux de statistiques, car les statistiques officielles dépendent en grande partie de leur réputation dans l'exécution de leur mission. Cela étant dit, nous pouvons affirmer que la compétence la plus importante, dont l'absence peut conduire à des résultats erronés, est l'inférence statistique, en particulier l'inférence basée sur des modèles, qui, elle aussi, sera moins probablement absente. Par conséquent, l'impact attendu sera plutôt critique (4) que extrême.
6.1.4. Prévention
Les bureaux de statistiques peuvent activement éviter ce risque de deux manières : 1) formation ; et 2) recrutement.
Les bureaux statistiques peuvent fournir au personnel les compétences nécessaires en définissant précisément les compétences requises pour utiliser de grandes sources de données dans la production statistique, en établissant une liste des compétences existantes du personnel, en identifiant les besoins en formation, puis en organisant des cours de formation.
Les bureaux de statistiques peuvent également recruter de nouveaux employés possédant les compétences nécessaires. Cela semble avoir des limitations sérieuses, car les bureaux de statistiques ne pourront pas atteindre une masse critique de personnel dans des situations où l'utilisation de grandes sources de données sera répandue dans le département, et les nouveaux employés devront encore plusieurs années pour atteindre le niveau d'expertise des employés existants. Cependant, au moins certains des nouveaux employés recrutés dans le cadre d'une mise à jour normale du personnel peuvent avoir des compétences liées aux grandes données.
6.1.5. Atténuation
Face à une situation où de nouvelles sources de grandes données sont disponibles sans employés possédant les compétences nécessaires, les bureaux de statistiques peuvent atténuer les conséquences négatives de deux manières : 1) sous-traitance ; et 2) collaboration.
Les agences statistiques peuvent conclure des contrats pour le traitement de données et l'analyse de nouvelles sources de Big Data avec d'autres organisations qui fournissent ces types de services. Cela semble être une solution viable, car un nouveau secteur d'entreprises se spécialise dans le traitement de ce type de données. Cependant, cette solution comporte des risques, car l'agence statistique aura moins de contrôle sur la production de produits statistiques potentiellement sensibles. Cette approche présente également l'inconvénient de ne pas permettre aux employés de l'agence statistique d'apprendre et d'acquérir les compétences nécessaires.
La collaboration avec d'autres organisations, où se trouvent des employés possédant les compétences nécessaires et qui sont également intéressés par l'étude des sources de Big Data, semble être une solution plus prometteuse. Cette collaboration peut prendre la forme de projets communs entre les employés des agences statistiques et ceux d'autres organisations sur un pied d'égalité, qui partagent leurs connaissances. Cela permettrait non seulement de réduire le risque de pénurie de compétences, mais aussi de permettre aux employés des agences statistiques d'acquérir ces compétences.
6.2. Fuite d'experts vers d'autres organisations
6.2.1. Description
Ce risque consiste à ce que les agences statistiques perdent leur personnel au profit d'autres organisations après que celui-ci ait acquis des compétences liées aux Big Data.
6.2.2. Probabilité
La probabilité de ce risque dépendra de deux facteurs : 1) les opportunités attrayantes existantes au sein d'organisations en dehors de la statistique officielle ; 2) les conditions de travail au sein des agences statistiques.
En ce qui concerne les opportunités dans les organisations en dehors des statistiques officielles, la probabilité de ce risque semble plausible (4). La demande de personnes ayant des compétences en big data est élevée dans le secteur privé, ainsi que dans d'autres organismes du secteur public. Une fois les compétences en big data acquises, les statistiques officielles bénéficieront d'un avantage comparatif en étant des experts dans le domaine des statistiques. En plus des compétences spécifiques en big data, d'autres organisations nécessitent des spécialistes des données possédant des compétences plus traditionnelles, telles que l'évaluation des besoins des utilisateurs et le développement d'indicateurs clés de performance (KPI), qui sont courants pour les statisticiens officiels. De plus, il est prévu que les employés ayant plus de propension à acquérir de nouvelles compétences soient également ceux qui seront plus ouverts aux changements de carrière et quitteront les bureaux de statistique.
En ce qui concerne les conditions de travail dans les bureaux de statistique, cela dépendra principalement du bureau spécifique. Cependant, les bureaux de statistique offrent globalement encore des opportunités professionnelles attrayantes pour les personnes ayant une perspective quantitative. Les bureaux de statistique proposent la plus large gamme de domaines possibles pour travailler et le plus grand choix de données. Cela réduira d'une certaine manière la probabilité que les bureaux de statistique perdent leur personnel en raison de circonstances imprévues (3).
6.2.3. Impact
L'impact de ce risque sera le même que celui du risque d'absence de personnel possédant les compétences appropriées en premier lieu. Par conséquent, l'impact sera critique (4), comme indiqué ci-dessus.
6.2.4. Prévention
Il semble que la seule possibilité pour les offices statistiques d'éviter ce risque soit d'assurer des conditions de travail attrayantes pour leurs employés. Cela est généralement vrai pour l'ensemble du personnel. Cependant, dans le cas spécifique où les employés sont ouverts à l'acquisition de nouvelles compétences, notamment celles liées aux grandes données, les conditions de travail peuvent être améliorées en leur offrant des possibilités de formation où ils peuvent développer leurs intérêts professionnels. Les offices statistiques peuvent également accorder une attention particulière à être ouverts à de nouveaux projets innovants et idées liés aux nouvelles sources de grandes données provenant de statisticiens travaillant dans plusieurs domaines de la statistique. Enfin, prévenir la perte de personnel vers d'autres organisations, en fonction de leurs compétences en matière de grandes données, dépendra d'une bonne identification du personnel capable et désireux de travailler avec de telles données, ainsi que de la fourniture de bonnes opportunités pour leur développement professionnel.
6.2.5. Atténuation
La réduction de ce risque sera effectuée en ce qui concerne le risque d'absence de personnel ayant les compétences nécessaires : 1) sous-traitance ; et 2) collaboration.
7. Discussion
De cette première revue, il est clair qu'il est impossible d'établir une probabilité ou un impact unique pour le « risque de grandes données » — en général, les deux indicateurs dépendent largement de la source des grandes données, ainsi que de la « statistique officielle basée sur les grandes données ».
produit «.
Ainsi, nous concluons que la prochaine étape logique dans ce domaine est l'adoption d'une série de projets pilotes possibles (chacun d'eux comprenant une combinaison d'un ou plusieurs BDS et d'un ou plusieurs BDOS) comme point de départ et – pour chaque pilote – un effort pour évaluer la probabilité et l'impact de chaque risque.
À cette fin, nous sommes sur le point de lancer une enquête auprès des parties prenantes, cherchant à évaluer l'évaluation de l'OSC de la probabilité, de l'impact (et des actions possibles pour prévenir/atténuer les conséquences) concernant une série de projets pilotes possibles – et de demander des suggestions à l'OSC concernant les risques que nous n'avons pas inclus dans ce document.
8. RÉFÉRENCESUNECE (2014), «Un cadre suggéré pour la qualité des Big Data», Produits de l'équipe de travail sur la qualité des Big Data de l'UNECE,
a%20Quality%20Framework%20-%20final-%20Jan08-2015.pdf?version=1&modificationDate=1420725063663&api=v2
UNECE (2014), «Quelle est l'ampleur des Big Data ? Exploration du rôle des Big Data dans les statistiques officielles»,
Daas, P., S. Ossen, R. Vis-Visschers, et J. Arends-Toth, (2009), Liste de contrôle pour l'évaluation de la qualité des sources de données administratives, Statistics Netherlands, La Haye/Heerlen
Dorfman, Mark S. (2007), Introduction à la gestion des risques (éd. e), Cambridge, Royaume-Uni, Woodhead-Faulkner, p. 18, ISBN 0-85941-332-22)
Eurostat (2014), «Procédure d'accréditation pour les données statistiques provenant de sources non officielles» dans Analyse des méthodologies d'utilisation d'Internet pour la collecte d'informations sociétales et d'autres statistiques,
Reimsbach-Kounatze, C. (2015), «La prolifération des 'Big Data' et ses implications pour les statistiques officielles et les agences statistiques : Analyse préliminaire», OECD Digital Economy Papers, No. 245, OECD Publishing.
Reis, F., Ferreira, P., Perduca, V. (2014) «L'utilisation des preuves d'activité web pour accroître la rapidité des indicateurs des statistiques officielles», communication présentée à la conférence IAOS 2014,
Bien que ne mentionnant pas explicitement les risques, cet article aborde en fait les nombreux risques associés à l'utilisation des données d'activité web pour les statistiques officielles. Eurostat (2007), Manuel sur les méthodes et outils d'évaluation de la qualité des données,
Source : habr.com
