

Une question classique que les développeurs posent presque toujours à leur DBA ou au consultant PostgreSQL est : « Pourquoi les requêtes prennent-elles autant de temps à s'exécuter ? »
Un ensemble traditionnel de raisons :
- un algorithme inefficace
lorsque vous essayez de faire un JOIN entre plusieurs CTE avec des dizaines de milliers d'enregistrements - Ce point est particulièrement important pour PostgreSQL, lorsque vous avez « déversé » un grand ensemble de données sur le serveur, vous faites une requête — et celui-ci effectue une « scan séquentielle » sur la table. Parce qu'hier, il y avait 10 enregistrements, et aujourd'hui 10 millions, mais PostgreSQL n'est pas encore au courant, et il faut le lui signaler. [
si la distribution réelle des données dans la table diffère fortement de celle analysée par ANALYZE la dernière fois - Vous avez installé une grande base de données lourde sur un serveur faible, manquant d'espace disque, de mémoire et de puissance processeur. Et voilà… Il y a un seuil de performance au-delà duquel vous ne pouvez plus sauter.
et si les capacités de calcul CPU dédiées ne suffisent plus, que des gigaoctets de mémoire sont constamment sollicités ou que le disque ne peut pas suivre toutes les « demandes » de la base de données - de blocage en raison de processus concurrents
Et si les blocages sont assez difficiles à capturer et à analyser, pour tout le reste, il nous suffit du plan de requête, que l'on peut obtenir en utilisant (idéalement, utilisez EXPLAIN (ANALYZE, BUFFERS) …) ou .
Cependant, comme le dit la documentation,
« Comprendre le plan est un art, et pour le maîtriser, une certaine expérience est nécessaire, … »
Mais on peut s'en passer si l'on utilise un outil approprié !
À quoi ressemble généralement un plan de requête ? En quelque sorte comme cela :
Index Scan using pg_class_relname_nsp_index on pg_class (actual time=0.049..0.050 rows=1 loops=1)
  Index Cond: (relname = $1)
  Filter: (oid = $0)
  Buffers: shared hit=4
  InitPlan 1 (returns $0,$1)
    ->  Limit (actual time=0.019..0.020 rows=1 loops=1)
          Buffers: shared hit=1
          ->  Seq Scan on pg_class pg_class_1 (actual time=0.015..0.015 rows=1 loops=1)
                Filter: (relkind = 'r'::"char")
                Rows Removed by Filter: 5
                Buffers: shared hit=1
ou comme ça :
"Append  (cost=868.60..878.95 rows=2 width=233) (actual time=0.024..0.144 rows=2 loops=1)"
"  Buffers: shared hit=3"
"  CTE cl"
"    ->  Seq Scan on pg_class  (cost=0.00..868.60 rows=9972 width=537) (actual time=0.016..0.042 rows=101 loops=1)"
"          Buffers: shared hit=3"
"  ->  Limit  (cost=0.00..0.10 rows=1 width=233) (actual time=0.023..0.024 rows=1 loops=1)"
"        Buffers: shared hit=1"
"        ->  CTE Scan on cl  (cost=0.00..997.20 rows=9972 width=233) (actual time=0.021..0.021 rows=1 loops=1)"
"              Buffers: shared hit=1"
"  ->  Limit  (cost=10.00..10.10 rows=1 width=233) (actual time=0.117..0.118 rows=1 loops=1)"
"        Buffers: shared hit=2"
"        ->  CTE Scan on cl cl_1  (cost=0.00..997.20 rows=9972 width=233) (actual time=0.001..0.104 rows=101 loops=1)"
"              Buffers: shared hit=2"
"Planning Time: 0.634 ms"
"Execution Time: 0.248 ms"
Mais lire le plan textuellement « à la volée » est très difficile et peu clair :
- dans le nœud, est affiché la somme des ressources de l'arbre sous-jacent
c'est-à-dire que pour comprendre combien de temps a été utilisé pour exécuter un nœud spécifique, ou combien de données ont été effectivement récupérées de la table — il faut soustraire une valeur d'une autre - le temps du nœud doit être multiplié par les loops
Oui, la soustraction n'est pas l'opération la plus difficile à faire « mentalement » — en effet, le temps d'exécution est indiqué en moyenne pour un seul nœud, alors qu'il peut y en avoir des centaines. - Eh bien, tout cela complique la réponse à la question principale — alors, qui est-ce ? « Le maillon le plus faible »?
Lorsque nous avons essayé d'expliquer tout cela à plusieurs centaines de nos développeurs, nous avons réalisé que de l'extérieur, cela ressemblait à peu près à cela :
Alors, nous avons besoin de…
Outil
Dans celui-ci, nous avons essayé de rassembler toutes les mécaniques clés qui aident à comprendre, en fonction du plan et de la demande, « qui est responsable et que faire ». Et aussi, de partager une partie de notre expérience avec la communauté.
Faites connaissance et utilisez —
Clarté des plans
Est-il facile de comprendre un plan lorsqu'il ressemble à cela ?
Seq Scan on pg_class (temps réel=0.009..1.304 lignes=6609 boucles=1)
  Buffers : partagés hit=263
Temps de planification : 0.108 ms
Temps d'exécution : 1.800 ms
Pas vraiment.
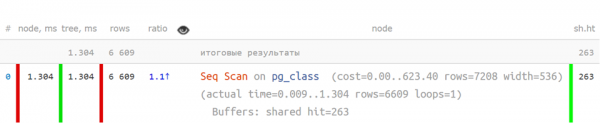
Mais ainsi, dans une version abrégée, lorsque les indicateurs clés sont séparés — c'est déjà beaucoup plus clair :
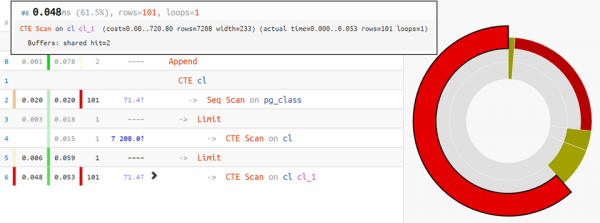
Mais si le plan est plus complexe — un diagramme à secteurs de distribution du temps par nœuds :
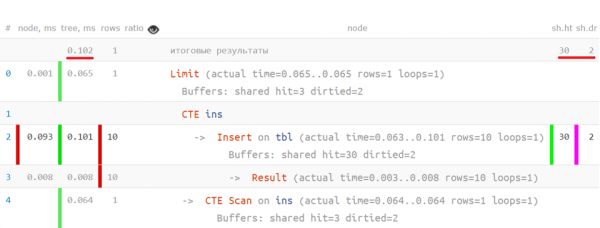
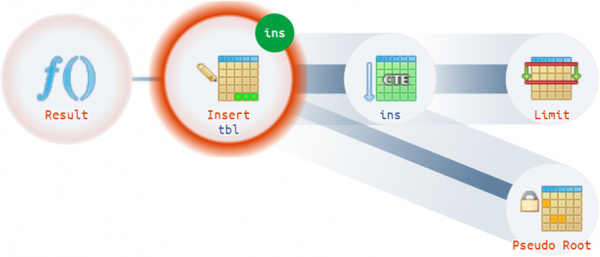
Eh bien, pour les cas les plus complexes, le diagramme d'exécution:
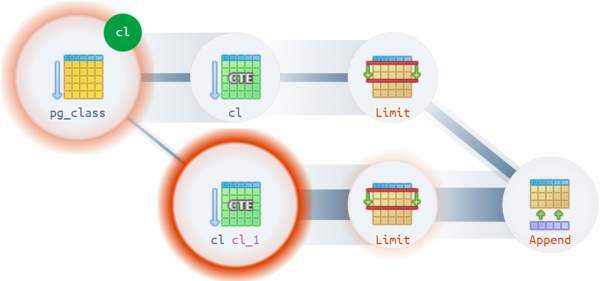
Par exemple, il existe des situations suffisamment non triviales où un plan peut avoir plus d'une racine réelle :
Conseils structurels
Eh bien, si toute la structure du plan et ses points faibles sont déjà établis et visibles — pourquoi ne pas les mettre en évidence pour le développeur, et expliquer « en termes simples » ?
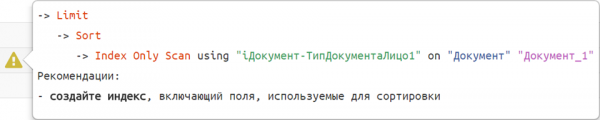 Nous avons déjà rassemblé une bonne dizaine de ces modèles de recommandations.
Profilage ligne par ligne de la requête
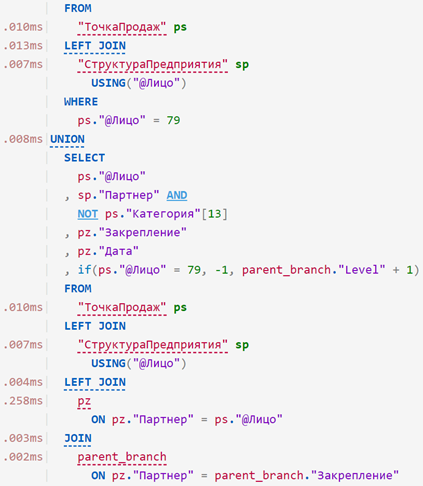
Maintenant, si vous appliquez la requête d'origine au plan analysé, vous pouvez voir combien de temps chaque opérateur individuel a pris — à peu près comme cela :
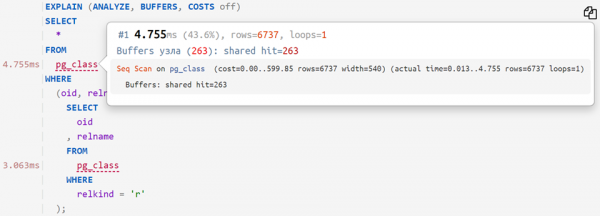
… ou même comme ça :
Substitution de paramètres dans la requête
Si vous avez « attaché » au plan non seulement la requête, mais aussi ses paramètres depuis la ligne DETAIL du journal, vous pouvez la copier de manière supplémentaire dans l'une des variantes :
- avec substitution des valeurs dans la requête
pour une exécution immédiate sur votre propre base et un profilage ultérieurSELECT 'const', 'param'::text; - avec substitution des valeurs via PREPARE/EXECUTE
pour simuler le fonctionnement du planificateur, lorsque la partie paramétrique peut être ignorée — par exemple, lors de l'utilisation de tables partitionnéesDEALLOCATE ALL; PREPARE q(text) AS SELECT 'const', $1::text; EXECUTE q('param'::text);
Archives des plans
Insérez, analysez, partagez avec vos collègues ! Les plans resteront archivés, et vous pourrez y revenir plus tard :
Mais si vous ne voulez pas que votre plan soit vu par d'autres, n'oubliez pas de cocher la case « ne pas publier dans l'archive ».
Dans les prochains articles, je parlerai des difficultés et des solutions qui surgissent lors de l'analyse des plans.
Source : habr.com
