

De nombreuses personnes se retrouvent face à Elasticsearch. Mais que se passe-t-il lorsqu'on souhaite l'utiliser pour stocker des journaux 'en très grande quantité'? Et comment supporter sans douleur la défaillance de l'un des plusieurs centres de données? Quelle architecture doit-on adopter, et quels écueils risque-t-on de rencontrer?
Nous, à Odnoklassniki, avons décidé d'utiliser Elasticsearch pour résoudre le problème de gestion des journaux, et maintenant nous partageons notre expérience avec Habr : à propos de l'architecture et des pièges rencontrés.
Je suis Piotr Zaïtsev, administrateur système chez Odnoklassniki. Auparavant, j'étais également administrateur, travaillant avec Manticore Search, Sphinx Search, Elasticsearch. Si un autre ...search apparaît, je travaillerai probablement également avec. Je participe également à plusieurs projets open source sur une base volontaire.
Lorsque je suis arrivé chez Odnoklassniki, j'ai imprudemment déclaré en entretien que je savais travailler avec Elasticsearch. Après m'être familiarisé et avoir réalisé quelques petites tâches, on m'a confié une grande mission de réforme du système de gestion des journaux existant à l'époque.
Exigences
Les exigences pour le système ont été formulées comme suit :
- Graylog devait être utilisé comme frontend. Parce que l'entreprise avait déjà de l'expérience avec ce produit, les développeurs et les testeurs le connaissaient, il leur était familier et confortable.
- Volume de données : en moyenne 50 à 80 000 messages par seconde, mais si quelque chose se casse, le trafic n'est pas limité, cela peut atteindre 2 à 3 millions de lignes par seconde.
- Après avoir discuté avec les clients des exigences concernant la vitesse de traitement des requêtes, nous avons compris que le schéma typique d'utilisation d'un tel système est le suivant : les gens recherchent les journaux de leur application des deux derniers jours et ne veulent pas attendre plus d'une seconde pour le résultat de leur requête.
- Les admins ont insisté pour que le système puisse être facilement évolutif si nécessaire, sans nécessiter d'eux une profonde compréhension de son fonctionnement.
- Pour que la seule tâche de maintenance requise par ces systèmes soit périodiquement de changer un matériel.
- De plus, chez Odnoklassniki, il y a une excellente tradition technique : tout service que nous lançons doit survivre à la panne d'un centre de données (brutale, imprévue et à tout moment).
La dernière exigence dans la réalisation de ce projet a été particulièrement difficile, dont je parlerai en détail par la suite.
Environnement
Nous travaillons dans quatre centres de données, tout en sachant que les nœuds Elasticsearch ne peuvent être situés que dans trois (pour diverses raisons non techniques).
Dans ces quatre centres de données, il y a environ 18 000 sources de logs différentes — matériel, conteneurs, machines virtuelles.
Caractéristique importante : le cluster se lance dans des conteneurs pas sur des machines physiques, mais sur . Les conteneurs disposent de 2 cœurs, similaires à 2.0Ghz v4, avec la possibilité d'utiliser les autres cœurs en cas d'inactivité.
En d'autres termes :
Topologie
L'apparence générale de la solution m'est d'abord apparue comme suit :
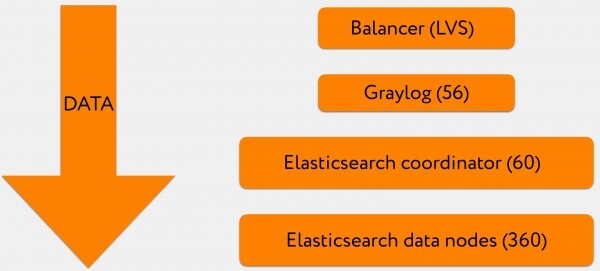
- 3-4 VIP sont derrière l'enregistrement A du domaine Graylog, c'est l'adresse à laquelle les logs sont envoyés.
- Chaque VIP est un équilibreur de charge LVS.
- Après cela, les logs arrivent dans un cluster Graylog, une partie des données est en format GELF, l'autre en format syslog.
- Ensuite, le tout est écrit par gros lots dans un groupe de coordinateurs Elasticsearch.
- Et eux, à leur tour, envoient des requêtes d'écriture et de lecture aux nœuds de données pertinents.
Terminologie
Il est possible que tout le monde ne maîtrise pas la terminologie, c'est pourquoi je voudrais m'arrêter un peu là-dessus.
Dans Elasticsearch, il existe plusieurs types de nœuds — master, coordinator, data node. Il y a aussi deux autres types pour différents types de transformations de logs et la communication entre divers clusters, mais nous n'avons utilisé que les types énumérés.
Maître
Il fait le ping de tous les nœuds présents dans le cluster, maintient une carte à jour du cluster et la distribue entre les nœuds, traite la logique événementielle, et s'occupe de diverses tâches de maintenance à l'échelle du cluster.
Coordinateur
Effectue une tâche unique : reçoit les requêtes des clients pour la lecture ou l'écriture et redirige ce trafic. En cas de requête d'écriture, il demandera probablement au master dans quel shard du bon index il faut l'ajouter et redirigera la requête.
Nœud de données
Stocke des données, exécute les requêtes de recherche et les opérations sur les shards qui y sont stockés.
Graylog
C'est une sorte de combinaison de Kibana et Logstash dans la pile ELK. Graylog allie UI et pipeline de traitement des journaux. Sous le capot, Graylog utilise Kafka et Zookeeper, qui assurent la connectivité de Graylog en tant que cluster. Graylog peut mettre en cache les journaux (Kafka) en cas d'indisponibilité d'Elasticsearch et répéter les requêtes de lecture et d'écriture échouées, en regroupant et en etiquetant les journaux selon des règles définies. Tout comme Logstash, Graylog dispose de fonctionnalités pour modifier les chaînes avant de les enregistrer dans Elasticsearch.
De plus, Graylog possède une découverte de services intégrée, permettant à partir d'un nœud Elasticsearch accessible d'obtenir toute la carte du cluster et de la filtrer par un tag spécifique, ce qui permet d'orienter les requêtes vers des conteneurs précis.
Visuellement, cela ressemble à ceci :

Ceci est une capture d'écran d'une instance spécifique. Ici, nous construisons un histogramme à partir d'une requête de recherche, affichant des lignes pertinentes.
Indices
Revenant à l'architecture du système, j'aimerais m'attarder sur la manière dont nous avons construit le modèle d'index afin que tout fonctionne correctement.
Dans le schéma présenté précédemment, c'est le niveau le plus inférieur : les nœuds de données Elasticsearch.
Un index est une grande entité virtuelle, composée de shards Elasticsearch. Chacun de ces shards n'est rien d'autre qu'un index Lucene. Et chaque index Lucene est composé d'un ou plusieurs segments.
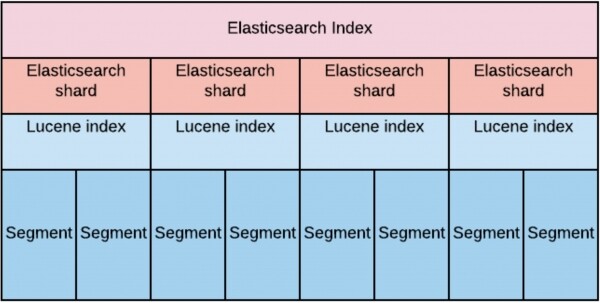
Lors de la conception, nous avons estimé que pour garantir la vitesse de lecture sur un grand volume de données, nous devions uniformément "étaler" ces données sur les nœuds de données.
Cela a conduit à ce que le nombre de shards par index (avec répliques) doive être strictement égal au nombre de nœuds de données. Tout d'abord, pour garantir un facteur de réplication de deux (c'est-à-dire que nous pouvons perdre la moitié du cluster). Ensuite, pour que les requêtes de lecture et d'écriture soient traitées sur au moins la moitié du cluster.
Nous avons d'abord défini le temps de conservation à 30 jours.
La distribution des shards peut être représentée graphiquement comme suit :
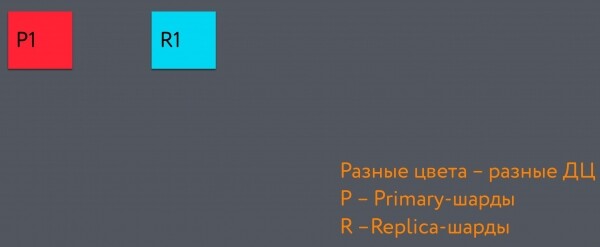
Tout le rectangle gris foncé représente l'index. Le carré rouge à gauche en fait partie — c'est le shard primaire, le premier de l'index. Et le carré bleu — c'est le shard réplique. Ils se trouvent dans différents centres de données.
Lorsque nous ajoutons un nouveau shard, il va dans le troisième data center. Et, finalement, nous obtenons une structure qui permet de perdre un DC sans perdre la cohérence des données :
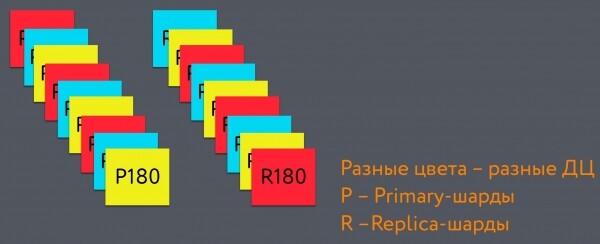
Nous avons défini la rotation des index, c'est-à-dire la création d'un nouvel index et la suppression de l'index le plus ancien, à 48 heures (selon le modèle d'utilisation de l'index : il est le plus souvent recherché dans les dernières 48 heures).
Ce type d'intervalle de rotation des index est lié aux raisons suivantes :
Lorsque la node de données reçoit une requête de recherche, il est plus performant de consulter un seul shard, à condition que sa taille soit comparable à celle de la mémoire vive de la node. Cela permet de garder la partie "chaude" de l'index en mémoire et d'y accéder rapidement. Lorsque le nombre de parties "chaudes" augmente, la vitesse de recherche dans l'index se dégrade.
Lorsque la node commence à exécuter une requête de recherche sur un shard, elle alloue un nombre de threads égal au nombre de cœurs hyper-threading de la machine physique. Si la requête de recherche touche un grand nombre de shards, le nombre de threads augmente proportionnellement. Cela a un impact négatif sur la vitesse de recherche et affecte la nouvelle indexation des données.
Pour garantir la latence de recherche nécessaire, nous avons décidé d'utiliser des SSD. Pour un traitement rapide des requêtes, les machines sur lesquelles ces conteneurs sont hébergés devaient avoir au moins 56 cœurs. Le chiffre de 56 a été choisi comme une valeur conditionnellement suffisante, définissant le nombre de threads qu'Elasticsearch génère pendant son fonctionnement. Dans Elasticsearch, de nombreux paramètres du pool de threads dépendent directement du nombre de cœurs disponibles, ce qui influence à son tour le nombre nécessaire de nodes dans le cluster selon le principe "moins de cœurs - plus de nodes".
En fin de compte, nous avons obtenu qu'en moyenne, un shard pèse environ 20 gigaoctets, et qu'il y a 360 shards par index. Par conséquent, si nous les faisons pivoter toutes les 48 heures, nous en avons 15. Chaque index contient des données sur 2 jours.
Schémas d'écriture et de lecture des données
Examinons comment les données sont écrites dans ce système.
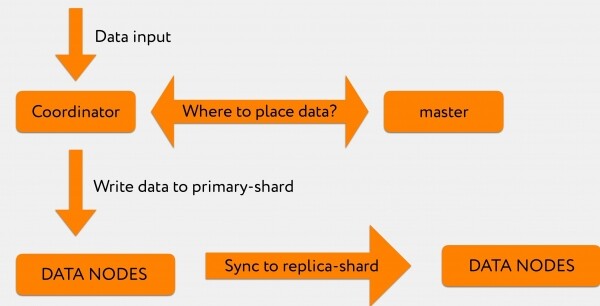
Supposons qu'une requête nous parvienne de Graylog dans le coordinateur. Par exemple, nous souhaitons indexer 2 à 3 mille lignes.
Le coordinateur, ayant reçu une demande de Graylog, interroge le master : « Dans la demande d'indexation, nous avions spécifiquement indiqué l'index, mais il n'est pas précisé dans quel shard cela doit être écrit ».
Le master répond : « Note cette information dans le shard numéro 71 », après quoi elle est directement envoyée au nœud de données pertinent, où se trouve le primary-shard numéro 71.
Ensuite, le journal des transactions est répliqué sur le replica-shard, qui se trouve dans un autre data center.
De Graylog, une requête de recherche arrive au coordinateur. Le coordinateur la redirige par index, tandis qu'Elasticsearch distribue les requêtes entre le primary-shard et le replica-shard selon un principe de round-robin.
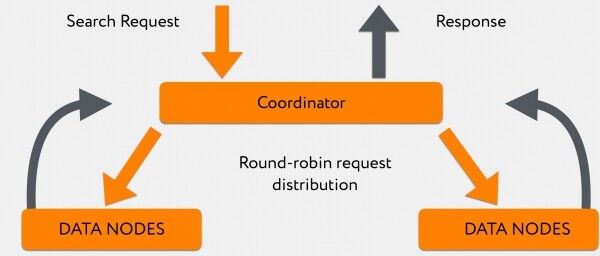
Les nœuds, au nombre de 180, répondent de manière inégale et, pendant qu'ils répondent, le coordinateur accumule les informations qui ont déjà été « crachées » par les nœuds de données plus rapides. Ensuite, soit lorsque toutes les informations sont arrivées, soit lorsque le délai d'attente de la requête est atteint, il les renvoie directement au client.
Dans l'ensemble, ce système traite en moyenne les requêtes de recherche sur les dernières 48 heures en 300-400 ms, à l'exception des requêtes avec un leading wildcard.
Les « fleurs » d'Elasticsearch : configuration de Java
Pour que tout cela fonctionne comme nous le souhaitions initialement, nous avons longuement ajusté divers éléments dans le cluster.
La première partie des problèmes découverts était liée à la façon dont Java est pré-configurée par défaut dans Elasticsearch.
Premier problème
Nous avons observé un grand nombre de messages indiquant qu'au niveau de Lucene, lorsque des tâches en arrière-plan sont exécutées, les fusions de segments Lucene se terminent par une erreur. Les journaux révélaient que c'était une erreur OutOfMemoryError. Par la télémétrie, nous avons constaté que le heap était libre, et il n'était pas clair pourquoi cette opération échouait.
Il s'est avéré que les fusions des index Lucene se produisent hors du heap. Les conteneurs sont assez strictement limités en ressources consommées. Ces ressources étaient accessibles uniquement au heap (la valeur heap.size était à peu près égale à la RAM), et certaines opérations hors heap échouaient avec une erreur d'allocation de mémoire si, pour une raison quelconque, elles ne rentraient pas dans les ~500 Mo qui restaient avant le seuil.
Le correctif était relativement trivial : nous avons augmenté la quantité de RAM disponible pour le conteneur, après quoi nous avons oublié que de tels problèmes existent.
Deuxième problème
Environ 4-5 jours après le lancement du cluster, nous avons remarqué que les nœuds de données commençaient à se déconnecter périodiquement du cluster et à y revenir 10-20 secondes plus tard.
Lorsque nous avons commencé à enquêter, il est devenu clair que cette mémoire off-heap dans Elasticsearch n'est pratiquement pas contrôlée. Lorsque nous avons alloué plus de mémoire au conteneur, nous avons pu remplir les pools de buffer direct avec diverses informations, et elles étaient nettoyées seulement après qu'un GC explicite ait été déclenché par Elasticsearch.
Dans certains cas, cette opération prenait assez longtemps, et pendant ce temps, le cluster avait le temps de marquer ce nœud comme hors service. Ce problème est bien documenté. .
La solution a été la suivante : nous avons restreint la capacité de Java à utiliser la majeure partie de la mémoire hors heap pour ces opérations. Nous l'avons limitée à 16 gigaoctets (-XX:MaxDirectMemorySize=16g), ce qui a conduit à un appel du GC explicite beaucoup plus fréquent et plus rapide, stabilisant ainsi le cluster.
Troisième problème
Si vous pensez que les problèmes de « nœuds quittant le cluster au moment le plus inattendu » se sont arrêtés ici, vous vous trompez.
Lorsque nous avons configuré le travail avec les indices, nous avons opté pour mmapfs afin de pour les nouveaux shards avec une grande segmentation. C'était une erreur assez grossière, car lors de l'utilisation de mmapfs, le fichier est mappé dans la mémoire vive, et ensuite nous travaillons déjà avec le fichier mappé. Cela signifie que lorsque le GC essaie d'arrêter les threads dans l'application, nous atteignons très lentement le safepoint, et en chemin, l'application ne répond plus aux requêtes du maître sur son état. Par conséquent, le maître pense que le nœud n'est plus présent dans le cluster. Ensuite, après environ 5 à 10 secondes, le garbage collector effectue son travail, le nœud renaît, rejoint à nouveau le cluster et commence l'initialisation des shards. Tout cela ressemblait beaucoup à un “produit que nous méritions” et n'était pas adapté à quoi que ce soit de sérieux.
Pour remédier à ce comportement, nous avons d'abord migré vers le standard niofs, puis, lorsque nous sommes passés des versions 5 d'Elastic aux versions 6, nous avons essayé hybridfs, où ce problème ne se reproduisait pas. Pour en savoir plus sur les types de stockage, vous pouvez lire. .
Quatrième problème
Ensuite, il y a eu un problème très intéressant que nous avons traité pendant un temps record. Nous l'avons suivi pendant 2 à 3 mois, car son schéma était absolument incompréhensible.
Parfois, nos coordinateurs entraient en Full GC, généralement après le déjeuner, et ne revenaient jamais. Lors de la journalisation des retards de GC, cela apparaissait comme suit : tout se passait bien, bien, bien, puis soudain, tout devenait soudainement mauvais.
Au début, nous pensions qu'il y avait un utilisateur malveillant qui lançait une requête dérangeant le fonctionnement du coordinateur. Nous avons passé beaucoup de temps à enregistrer les requêtes pour essayer de comprendre ce qui se passait.
Finalement, il s'est avéré que lorsque certains utilisateurs lançaient de très grosses requêtes et qu'elles atterrissaient sur un coordinateur Elasticsearch spécifique, certains nœuds répondaient plus lentement que d'autres.
Et pendant le temps que le coordinateur attendait les réponses de tous les nœuds, il accumulait les résultats envoyés par les nœuds déjà répondus. Pour le GC, cela signifie que notre modèle d'utilisation de la mémoire vive changeait rapidement. Et le GC que nous utilisions ne parvenait pas à gérer cette tâche.
Le seul correctif que nous avons trouvé pour changer le comportement du cluster dans une telle situation est la migration vers JDK13 et l'utilisation du ramasse-miettes Shenandoah. Cela a résolu le problème, les coordinateurs ne s'effondraient plus.
À ce stade, les problèmes liés à Java étaient résolus et nous avons commencé à rencontrer des problèmes de bande passante.
« Les cerises » avec Elasticsearch : bande passante
Les problèmes de bande passante signifient que notre cluster fonctionne de manière stable, mais lors des pics de documents indexés et pendant les manœuvres, les performances sont insuffisantes.
Le premier symptôme rencontré : lors de certains « pics » en production, où un très grand nombre de journaux est soudainement généré, l'erreur d'indexation es_rejected_execution apparaît fréquemment dans Graylog.
Cela se produisait parce que thread_pool.write.queue sur un nœud de données, avant qu'Elasticsearch puisse traiter la requête d'indexation et envoyer les informations dans le shard sur disque, ne peut par défaut mettre en cache que 200 requêtes. Et dans il est très peu question de ce paramètre. Seule la limite du nombre de threads et la taille par défaut sont mentionnées.
Naturellement, nous avons commencé à ajuster cette valeur et avons découvert que, spécifiquement dans notre configuration, il est possible de mettre en cache jusqu'à 300 requêtes, mais que des valeurs plus élevées sont risquées car nous retombons à nouveau dans le Full GC.
De plus, comme il s'agit de lots de messages arrivant dans une seule demande, nous devions également ajuster Graylog pour qu'il n'écrive pas souvent et par petits groupes, mais par de grands groupes ou une fois toutes les 3 secondes, si le groupe n'est toujours pas plein. Dans ce cas, les informations que nous écrivons dans Elasticsearch deviennent accessibles non pas après deux secondes, mais après cinq (ce qui nous convient parfaitement), mais le nombre de retries nécessaires pour pousser un grand lot d'informations est réduit.
C'est particulièrement important à ces moments où nous rencontrons un problème quelconque et que cela le signale de manière frénétique, afin de ne pas obtenir un Elastic complètement spammé, et après un certain temps — des nœuds Graylog non fonctionnels en raison de tampons saturés.
De plus, lorsque ces explosions se produisaient en production, nous recevions des plaintes de la part des programmeurs et des testeurs : au moment où ils avaient vraiment besoin de ces logs, ceux-ci leur étaient fournis très lentement.
Nous avons commencé à examiner la situation. D'une part, il était clair que les requêtes de recherche et les requêtes d'indexation étaient traitées essentiellement sur les mêmes machines physiques, et d'une manière ou d'une autre, des baisses de performance se produiraient.
Mais cela pouvait être partiellement contourné grâce à l'algorithme introduit dans les versions six d'Elasticsearch, qui permet de répartir les requêtes entre les nœuds de données pertinents, non pas selon un principe aléatoire de round-robin (le conteneur qui s'occupe de l'indexation et maintient le primary-shard peut être très occupé, n'ayant pas la possibilité de répondre rapidement), mais de diriger cette requête vers un conteneur moins chargé avec un replica-shard, qui répondra beaucoup plus rapidement. En d'autres termes, nous sommes passés à use_adaptive_replica_selection: true.
L'image de lecture commence à ressembler à ceci :
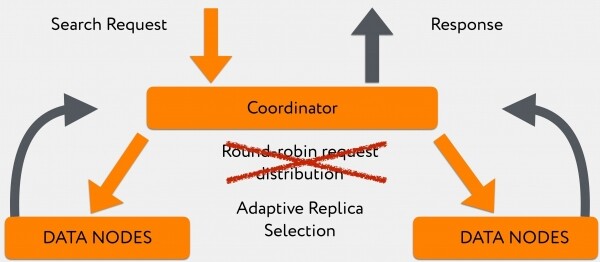
Le passage à cet algorithme a permis d'améliorer considérablement le temps de requête lorsque nous avions un grand flux de logs à écrire.
Enfin, le principal problème était de sortir le data center sans douleur.
Ce que nous voulions du cluster immédiatement après la perte de connexion avec un DC :
- Si le master actuel se trouve dans le data center déconnecté, il sera réélu et déplacé comme rôle vers un autre nœud dans un autre DC.
- Le master éliminera rapidement tous les nœuds inaccessibles du cluster.
- Sur la base des shards restants, il comprendra que dans le centre de données perdu, nous avions tels primary shards, et rapidement il promouvra des replica shards complémentaires dans les centres de données restants, et nous continuerons l'indexation des données.
- En conséquence, la bande passante du cluster pour les écritures et les lectures va progressivement diminuer, mais dans l'ensemble, tout fonctionnera, même si lentement, de manière stable.
Comme il s'est avéré, nous voulions quelque chose comme ça :
Et nous avons reçu ce qui suit :
Comment cela a-t-il pu se produire ?
Au moment de la chute du centre de données, le maître est devenu le goulot d'étranglement.
Pourquoi ?
En fait, dans le maître, il existe un TaskBatcher, responsable de la diffusion de certaines tâches et événements dans le cluster. Toute sortie d'un nœud, toute promotion d'un shard de replica à primary, toute tâche de création d'un shard quelque part — tout cela passe d'abord par le TaskBatcher, où il est traité de manière séquentielle et en un seul flux.
Au moment de la sortie d'un centre de données, il semblait que tous les nœuds de données dans les centres de données survivants avaient pour devoir de signaler au maître « nous avons perdu tels shards et tels nœuds de données ».
Dans le même temps, les nœuds de données survivants envoyaient toutes ces informations au maître actuel et essayaient d'attendre une confirmation qu'il l'avait reçue. Ils ne l'attendaient pas, car le maître recevait les tâches plus vite qu'il ne pouvait répondre. Les nœuds répétaient leurs requêtes après un délai, et pendant ce temps, le maître ne tentait même pas de répondre, étant complètement absorbé par la tâche de tri des requêtes par priorité.
De manière terminale, il apparaissait que les nœuds de données spammaient le maître jusqu'à ce qu'il soit en full GC. Après cela, notre rôle de maître se déplaçait vers un autre nœud, avec lequel se passait exactement la même chose, et finalement le cluster s'effondrait complètement.
Nous avons effectué des mesures, et jusqu'à la version 6.4.0, où cela a été corrigé, il suffisait de sortir simultanément seulement 10 nœuds de données sur 360 pour provoquer un effondrement complet du cluster.
Cela ressemblait à peu près à ceci :
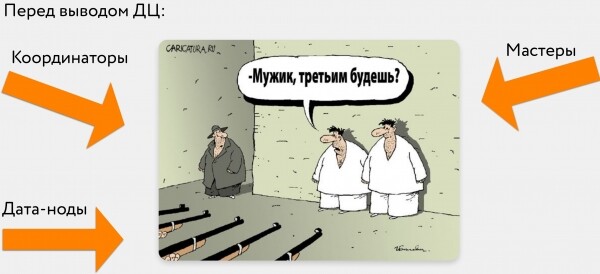
Après la version 6.4.0, où ce bug problématique a été corrigé, les nœuds de données ont cessé d'écraser le maître. Mais il n'est pas devenu « plus intelligent » pour autant. En effet : lorsque nous sortons 2, 3 ou 10 (quelque nombre autre que un) nœuds de données, le maître reçoit un certain premier message informant que le nœud A est sorti, et essaie d'en informer le nœud B, le nœud C, le nœud D.
À l'heure actuelle, il n'est possible de lutter contre cela qu'en installant un délai d'attente pour les tentatives de raconter quelque chose à quelqu'un, d'environ 20 à 30 secondes, et ainsi gérer la vitesse de sortie du centre de données du cluster.
En principe, cela correspond aux exigences initialement posées pour le produit final dans le cadre du projet, mais du point de vue de la « science pure », c'est un bug. Qui, d'ailleurs, a été corrigé avec succès par les développeurs dans la version 7.2.
En fait, lorsque certaines data-nodes sortaient, il s'est avéré qu'il était plus important de diffuser l'information sur leur sortie que de prévenir tout le cluster que sur celles-ci se trouvaient certaines primary-shard (pour promouvoir replica-shard dans un autre centre de données en primary, pour pouvoir y écrire des informations).
Ainsi, une fois que tout était « fini », les data-nodes sortants ne sont pas immédiatement marquées comme obsolètes. Par conséquent, nous devons attendre que tous les pings vers les data-nodes sortants expirent et seulement après cela notre cluster commence à informer que là-bas, ici et là, il faut continuer à enregistrer des informations. Vous pouvez lire plus en détail à ce sujet. .
Au final, l'opération de sortie du centre de données prend aujourd'hui environ 5 minutes aux heures de pointe. Pour une machine aussi grande et peu maniable, c'est un résultat assez bon.
Nous en sommes arrivés à la conclusion suivante :
- Nous avons 360 data-nodes avec des disques de 700 gigaoctets.
- 60 coordinateurs pour router le trafic entre ces data-nodes.
- 40 maîtres, qui nous sont restés comme un héritage des versions précédentes à partir de 6.4.0 — pour survivre à la sortie du centre de données, nous étions moralement prêts à perdre quelques machines, afin d'assurer même dans le pire scénario avoir un quorum de maîtres.
- Toute tentative de combiner des rôles sur un même conteneur se heurtait au fait qu'à un moment donné, la node tombait sous la charge.
- Dans tout le cluster, la taille de la heap est de 31 gigaoctets : toutes les tentatives de réduire cette taille ont conduit à ce que des requêtes de recherche lourdes avec des wildcards en tête tuaient certaines nodes ou déclenchaient un circuit breaker dans Elasticsearch.
- De plus, pour garantir la performance de recherche, nous essayions de maintenir le nombre d'objets dans le cluster aussi bas que possible, afin de traiter le moins d'événements possible au point le plus étroit que nous avons obtenu dans le maître.
Enfin, concernant la surveillance
Pour que tout cela fonctionne comme prévu, nous surveillons ce qui suit :
- Chaque nœud de données informe notre cloud de son existence et des shards qu'il gère. Lorsque nous arrêtons quelque chose quelque part, le cluster rend compte dans les 2-3 secondes qu'au centre A, nous avons éteint les nœuds 2, 3 et 4 — cela signifie qu'aucun des autres centres de données ne peut éteindre les nœuds qui contiennent des shards en unique exemplaire.
- En connaissant le comportement du maître, nous surveillons de très près le nombre de tâches en attente. Parce qu'une seule tâche suspendue, si elle n'expire pas à temps, pourrait théoriquement, dans une situation d'urgence, être la raison pour laquelle, par exemple, la promotion d'un shard replica vers un primary ne fonctionne pas, ce qui stopperait l'indexation.
- Nous surveillons également de près les délais du garbage collector, car nous avons déjà rencontré de grandes difficultés avec cela lors de l'optimisation.
- Les rejets par threads, pour comprendre à l'avance où se trouve le "goulot d'étranglement".
- Et les métriques standard, comme le heap, la RAM et l'I/O.
Lors de la mise en place de la surveillance, il est essentiel de prendre en compte les spécificités du Thread Pool dans Elasticsearch. décrit les possibilités de configuration et les valeurs par défaut pour la recherche, l'indexation, mais ne mentionne pas du tout thread_pool.management. Ces threads gèrent, entre autres, des requêtes comme _cat/shards et d'autres similaires, qui sont pratiques pour écrire des outils de surveillance. Plus le cluster est grand, plus ces requêtes sont exécutées en une seule fois, et le thread_pool.management mentionné ci-dessus, en plus de ne pas figurer dans la documentation officielle, est de plus limité par défaut à 5 threads, ce qui est très rapidement consommé, après quoi la surveillance cesse de fonctionner correctement.
En conclusion, je tiens à dire : nous avons réussi ! Nous avons pu fournir à nos programmeurs et développeurs un outil capable de fournir rapidement et fidèlement des informations sur ce qui se passe en production, dans presque toutes les situations.
Oui, cela a été assez complexe, mais néanmoins, nous avons pu intégrer nos exigences dans des produits existants, sans avoir à les patcher ou à les réécrire selon nos besoins.
Source : habr.com
