

Cet article décrit l'implémentation des pipelines dans le noyau Unix. J'ai été quelque peu déçu qu'un article récent intitulé «» se soit avéré ne être sur l'architecture interne. Cela m'a intrigué et j'ai fouillé dans d'anciennes sources pour trouver la réponse.
De quoi s'agit-il ?
Les pipelines — « probablement la plus importante invention dans Unix » — sont une caractéristique déterminante de la philosophie Unix qui consiste à combiner de petits programmes, ainsi que l'inscription familière dans la ligne de commande :
$ echo hello | wc -c
6
Cette fonctionnalité dépend de l'appel système fourni par le noyau pipe, qui est décrit dans la documentation et :
Les pipelines fournissent un canal unidirectionnel pour la communication inter-processus. Un pipeline a une entrée (write end) et une sortie (read end). Les données écrites dans l'entrée du pipeline peuvent être lues à la sortie.
Le pipeline est créé par l'appel
pipe(2), qui retourne deux descripteurs de fichiers : l'un se réfère à l'entrée du pipeline, l'autre à la sortie.
Les résultats du traçage de la commande ci-dessus montrent la création d'un pipeline et le flux de données à travers celui-ci d'un processus à un autre :
$ strace -qf -e execve,pipe,dup2,read,write
    sh -c 'echo hello | wc -c'

execve("/bin/sh", ["sh", "-c", "echo hello | wc -c"], …)
pipe([3, 4])                            = 0
[pid 2604795] dup2(4, 1)                = 1
[pid 2604795] write(1, "hellon", 6)    = 6
[pid 2604796] dup2(3, 0)                = 0
[pid 2604796] execve("/usr/bin/wc", ["wc", "-c"], …)
[pid 2604796] read(0, "hellon", 16384) = 6
[pid 2604796] write(1, "6n", 2)        = 2
Le processus parent appelle pipe(), afin d'obtenir des descripteurs de fichiers connectés. Un processus enfant écrit dans un des descripteurs, tandis qu'un autre processus lit les mêmes données à partir de l'autre descripteur. Le shell utilise dup2 pour « renommer » les descripteurs 3 et 4 afin qu'ils correspondent à stdin et stdout.
Sans les pipelines, le shell devrait écrire le résultat d'un processus dans un fichier et le transmettre à un autre processus pour qu'il lise les données à partir du fichier. Par conséquent, nous gaspillerions plus de ressources et d'espace disque. Cependant, les pipelines ne sont pas seulement avantageux parce qu'ils évitent l'utilisation de fichiers temporaires :
Si un processus essaie de lire depuis un pipeline vide, alors
read(2)se bloque jusqu'à ce que des données soient disponibles. Si un processus essaie d'écrire dans un pipeline plein, alorswrite(2)bloquera jusqu'à ce qu'il y ait suffisamment de données lues du pipeline pour effectuer l'écriture.
Conformément à l'exigence POSIX, c'est une propriété importante : l'écriture dans le pipeline jusqu'à PIPE_BUF octets (au moins 512) doit être atomique, afin que les processus puissent interagir les uns avec les autres via le pipeline, comme les fichiers ordinaires (qui ne fournissent pas de telles garanties) ne peuvent pas.
Lors de l'utilisation d'un fichier normal, un processus peut y écrire toutes ses sorties et les transmettre à un autre processus. Ou les processus peuvent fonctionner en mode de parallélisme rigide, utilisant un mécanisme de signalisation externe (comme un sémaphore) pour s'informer mutuellement de la fin de l'écriture ou de la lecture. Les pipelines nous libèrent de tous ces tracas.
Que recherchons-nous ?
Je vais expliquer simplement, pour vous aider à imaginer comment un pipeline peut fonctionner. Vous aurez besoin de réserver un tampon en mémoire et d'un certain état. Vous aurez besoin de fonctions pour ajouter et retirer des données du tampon. Vous aurez besoin d'un moyen pour appeler ces fonctions lors des opérations de lecture et d'écriture sur les descripteurs de fichiers. Et vous aurez besoin de verrous pour mettre en œuvre le comportement spécial décrit ci-dessus.
Nous sommes maintenant prêts à examiner sous la lumière vive des lampes le code source du noyau pour confirmer ou infirmer notre floue représentation mentale. Mais soyez toujours prêt pour des surprises.
Où recherchons-nous ?
Je ne sais pas où se trouve mon exemplaire du célèbre livre «» avec le code source d'Unix 6, mais grâce à on peut le rechercher en ligne dans des versions encore plus anciennes d'Unix.
Errer dans les archives de TUHS est similaire à visiter un musée. Nous pouvons jeter un œil à notre histoire commune, et je ressens du respect pour des années d'efforts consacrés à la restauration de tout ce matériel, bit par bit, à partir de vieilles cassettes et impressions. Et je prends conscience des fragments qui manquent encore.
Après avoir satisfait ma curiosité concernant l'antiquité des pipelines, nous pouvons comparer avec les noyaux modernes.
Au fait, pipe est l'appel système numéro 42 dans la table sysent[]. Coincidence ?
Les noyaux Unix traditionnels (1970–1974)
Je n'ai trouvé aucune trace pipe(2) ni dans (janvier 1970), ni dans (novembre 1971), ni dans le code source incomplet (juin 1972).
TUHS affirme que (février 1973) a été la première version avec des pipelines :
La troisième édition d'Unix a été la dernière version avec un noyau écrit en assembleur, mais également la première version avec des pipelines. Au cours de l'année 1973, des travaux ont été menés pour améliorer la troisième édition, le noyau a été réécrit en C, donnant naissance à la quatrième édition d'Unix.
Un des lecteurs a trouvé un scan d'un document dans lequel Doug McIlroy a proposé l'idée de "connecter des programmes sur le principe d'un tuyau de jardin".
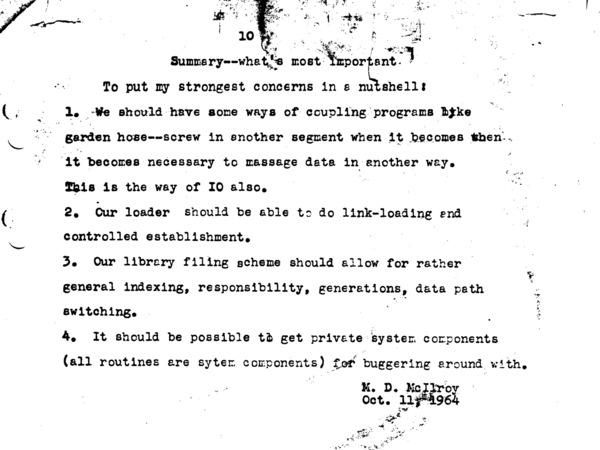
Dans le livre de Brian Kernighan", l'histoire de l'apparition des pipelines mentionne également ce document : "... il était accroché au mur de mon bureau chez Bell Labs pendant 30 ans". Voici , et une autre histoire de :
Lorsque Unix a été lancé, mon intérêt pour les coroutines m'a poussé à demander à l'auteur de l'OS, Ken Thompson, de permettre aux données enregistrées dans un processus d'aller non seulement vers un dispositif, mais aussi vers la sortie d'un autre processus. Ken a décidé que c'était possible. Cependant, en tant que minimaliste, il voulait que chaque fonction système joue un rôle significatif. La connexion directe entre processus offre-t-elle vraiment un grand avantage par rapport à l'écriture dans un fichier temporaire ? Ce n'est que lorsque j'ai présenté une proposition concrète avec un nom accrocheur de "pipeline" et une description de la syntaxe d'interaction des processus que Ken s'est finalement exclamé : "Je vais le faire !".
Et il l'a fait. Un soir décisif, Ken a modifié le noyau et le shell, a corrigé plusieurs programmes standards, en standardisant leur procédure de réception des entrées (qui peuvent provenir d'un pipeline), et a également changé les noms des fichiers. Le lendemain, les pipelines ont commencé à être largement utilisés dans les applications. À la fin de la semaine, les secrétaires utilisaient ce moyen pour envoyer à l'imprimante des documents provenant de leurs éditeurs de texte. Peu après, Ken a remplacé l'API originale et la syntaxe pour l'utilisation des pipelines par des conventions plus claires qui sont toujours appliquées.
Malheureusement, le code source du noyau de la troisième édition d'Unix est perdu. Et bien que nous ayons le code source du noyau écrit en C , publiée en novembre 1973, elle est sortie quelques mois avant le lancement officiel et ne contient pas l'implémentation des pipelines. C'est dommage que le code source de la fonction légendaire d'Unix soit perdu, peut-être pour toujours.
Nous avons le texte de la documentation sur pipe(2) les deux versions, donc nous pouvons commencer par chercher dans la documentation (par des mots spécifiques, soulignés « manuellement », ligne de littéraux ^H, après quoi suit un soulignement !). Ce proto-pipe(2) est écrit en assembleur et ne retourne qu'un seul descripteur de fichier, mais fournit déjà la fonctionnalité de base attendue :
Appel système pipe crée un mécanisme d'entrée/sortie appelé pipeline. Le descripteur de fichier retourné peut être utilisé pour des opérations de lecture et d'écriture. Lorsqu'on écrit quelque chose dans le pipeline, il est mis en mémoire tampon jusqu'à 504 octets de données, après quoi le processus d'écriture est suspendu. Lors de la lecture du pipeline, les données mises en mémoire tampon sont récupérées.
L'année suivante, le noyau a été réécrit en C, et a pris son apparence moderne avec le prototype «pipe(fildes)»:
Appel système pipe crée un mécanisme d'entrée/sortie appelé pipeline. Les descripteurs de fichiers retournés peuvent être utilisés pour des opérations de lecture et d'écriture. Lorsqu'on écrit quelque chose dans le pipeline, on utilise le descripteur retourné dans r1 (c'est-à-dire fildes[1]), qui est mis en mémoire tampon jusqu'à 4096 octets de données, après quoi le processus d'écriture est suspendu. Lors de la lecture du pipeline, le descripteur retourné dans r0 (c'est-à-dire fildes[0]) récupère les données.
Il est supposé qu'après la définition du pipeline, deux (ou plusieurs) processus interagissant (créés par des appels successifs à fork) vont transférer des données à partir du pipeline via des appels read et write.
Dans le shell, il existe une syntaxe pour définir un tableau linéaire de processus reliés par un pipeline.
Les appels de lecture depuis un pipeline vide (ne contenant pas de données en mémoire tampon), n'ayant qu'une seule extrémité (tous les descripteurs de fichiers d'écriture sont fermés), retournent « fin de fichier ». Les appels d'écriture dans une situation similaire sont ignorés.
La plus ancienne appartient (juin 1974), mais elle est presque identique à celle apparue dans la version suivante. Seules des commentaires ont été ajoutés, donc la cinquième édition peut être sautée.
La sixième édition de Unix (1975)
Commençons à lire le code source de Unix (mai 1975). En grande partie grâce à Lions le trouver est beaucoup plus facile que les sources des versions antérieures :
Pendant de nombreuses années, le livre Lions était le seul document sur le noyau Unix disponible en dehors des murs de Bell Labs. Bien que la licence de la sixième édition permettait aux enseignants d'utiliser son code source, la licence de la septième édition a exclu cette possibilité, donc le livre était distribué sous forme de copies dactylographiées illégales.
Aujourd'hui, il est possible d'acheter un exemplaire en réimpression du livre, dont la couverture montre des étudiants à une photocopieuse. Et grâce à Warren Toomey (qui a lancé le projet TUHS), vous pouvez télécharger Je veux vous donner une idée des efforts nécessaires pour créer ce fichier :
Il y a plus de 15 ans, j'ai retapé une copie du code source fournie dans Lions, car je n'étais pas satisfait de la qualité de ma copie provenant d'un nombre inconnu d'autres copies. TUHS n'existait pas encore, et je n'avais pas accès aux anciennes sources. Mais en 1988, j'ai trouvé une vieille bande à 9 pistes, qui contenait une sauvegarde de l'ordinateur PDP11. C'était difficile de comprendre si elle fonctionnait, mais il y avait un arbre intact /usr/src/, où la plupart des fichiers étaient datés de 1979, ce qui semblait déjà vieux à l'époque. C'était la septième édition ou son dérivé PWB, comme je l'ai estimé.
J'ai pris cette découverte comme base et ai manuellement corrigé les sources jusqu'à l'état de la sixième édition. Une partie du code est restée la même, d'autres ont nécessité une légère modification, changeant le jeton moderne += en l'ancien =+. J'ai simplement supprimé certaines parties, et d'autres ont dû être réécrites complètement, mais pas trop.
Et aujourd'hui, nous pouvons lire en ligne sur TUHS le code source de la sixième édition depuis .
À propos, à première vue, la principale caractéristique du code C avant l'ère de Kernighan et Ritchie est sa brièveté.Il n'est pas si fréquent que je peux insérer des extraits de code sans un vaste éditing pour qu'ils correspondent à une zone d'affichage relativement étroite sur mon site.
Au début, il y a un commentaire explicatif (et oui, il y a aussi ):
/*
 * Max allowable buffering per pipe.
 * This is also the max size of the
 * file created to implement the pipe.
 * If this size is bigger than 4096,
 * pipes will be implemented in LARG
 * files, which is probably not good.
 */
#define    PIPSIZ    4096
La taille du tampon n'a pas changé depuis la quatrième édition. Mais ici, nous voyons sans aucune documentation publique que, par le passé, les pipelines utilisaient des fichiers comme stockage de secours !
Quant aux fichiers LARG, ils correspondent au , qui est utilisé par « l'algorithme de grande adressage » pour le traitement. pour prendre en charge des systèmes de fichiers plus volumineux. Puisque Ken a dit qu'il valait mieux ne pas les utiliser, je le croirai sur parole.
Voici un véritable appel système pipe:
/*
 * The sys-pipe entry.
 * Allocate an inode on the root device.
 * Allocate 2 file structures.
 * Put it all together with flags.
 */
pipe()
{
    register *ip, *rf, *wf;
    int r;

    ip = ialloc(rootdev);
    if(ip == NULL)
        return;
    rf = falloc();
    if(rf == NULL) {
        iput(ip);
        return;
    }
    r = u.u_ar0[R0];
    wf = falloc();
    if(wf == NULL) {
        rf->f_count = 0;
        u.u_ofile[r] = NULL;
        iput(ip);
        return;
    }
    u.u_ar0[R1] = u.u_ar0[R0]; /* wf's fd */
    u.u_ar0[R0] = r;           /* rf's fd */
    wf->f_flag = FWRITE|FPIPE;
    wf->f_inode = ip;
    rf->f_flag = FREAD|FPIPE;
    rf->f_inode = ip;
    ip->i_count = 2;
    ip->i_flag = IACC|IUPD;
    ip->i_mode = IALLOC;
}
Le commentaire décrit clairement ce qui se passe ici. Mais comprendre le code n'est pas si simple, en partie à cause de la façon dont «» et les registres R0 et R1 passent les paramètres des appels systèmes et les valeurs de retour.
Essayons d'utiliser pour allouer sur le disque , et d'utiliser pour allouer en mémoire deux . Si tout se passe bien, nous allons définir des indicateurs pour considérer ces fichiers comme les deux extrémités d'un pipeline, les indiquer dans le même inode (dont le compteur de références sera égal à 2), et marquer l'inode comme modifié et utilisé. Notez les appels à dans les chemins d'erreur pour réduire le compteur de références dans le nouvel inode.
pipe() doit passer par R0 et R1 retourner les numéros de descripteurs de fichiers pour la lecture et l'écriture. falloc() retourne un pointeur vers une structure de fichier, mais « retourne » également via u.u_ar0[R0] et le descripteur de fichier. Autrement dit, le code sauvegarde dans r le descripteur de fichier pour la lecture et attribue le descripteur pour l'écriture directement à partir de u.u_ar0[R0] après le second appel falloc().
Drapeau FPIPE, que nous avons défini lors de la création du pipeline, gère le comportement de la fonction , qui appelle des sous-programmes spécifiques d'entrée-sortie I/O :
/*
 * common code for read and write calls:
 * check permissions, set base, count, and offset,
 * and switch out to readi, writei, or pipe code.
 */
rdwr(mode)
{
    register *fp, m;

    m = mode;
    fp = getf(u.u_ar0[R0]);
        /* … */

    if(fp->f_flag&FPIPE) {
        if(m==FREAD)
            readp(fp); else
            writep(fp);
    }
        /* … */
}
Ensuite, la fonction readp() dans pipe.c lit les données du pipeline. Mais il vaut mieux suivre l'implémentation à partir de writep(). Je le répète, le code s'est complexifié à cause des spécificités de la convention de passage d'arguments, mais certains détails peuvent être omis.
writep(fp)
{
    register *rp, *ip, c;

    rp = fp;
    ip = rp->f_inode;
    c = u.u_count;

loop:
    /* Si tout est fait, retourner. */

    plock(ip);
    if(c == 0) {
        prele(ip);
        u.u_count = 0;
        return;
    }

    /*
     * S'il n'y a pas à la fois les côtés de lecture et d'écriture du
     * pipeline actifs, retourner une erreur et signaler également.
     */

    if(ip->i_count i_size1 == PIPSIZ) {
        ip->i_mode |= IWRITE;
        prele(ip);
        sleep(ip + 1, PPIPE);
        goto loop;
    }

    /* Écrire ce qui est possible et revenir en boucle. */

    u.u_offset[0] = 0;
    u.u_offset[1] = ip->i_size1;
    u.u_count = min(c, PIPSIZ - u.u_offset[1]);
    c -= u.u_count;
    writei(ip);
    prele(ip);
    if(ip->i_mode & IREAD) {
        ip->i_mode &= ~IREAD;
        wakeup(ip + 2);
    }
    goto loop;
}
Nous voulons écrire des octets dans l'entrée du pipeline u.u_count. D'abord, exigeons de bloquer le descripteur d'index (voir ci-dessous plock/préambule).
Ensuite, nous vérifions le compteur de liens inode. Tant que les deux extrémités du pipeline restent ouvertes, le compteur doit être égal à 2. Nous maintenons un lien (de rp->f_inode), donc si le compteur est inférieur à 2, cela signifie que le processus de lecture a fermé son extrémité du pipeline. En d'autres termes, nous essayons d'écrire dans un pipeline fermé, ce qui constitue une erreur. Pour la première fois, le code d'erreur EPIPE et le signal SIGPIPE sont apparus dans la sixième édition de Unix.
Mais même si le pipeline est ouvert, il peut être plein. Dans ce cas, nous levons le verrou et nous endormons en espérant qu'un autre processus lira depuis le pipeline et libérera suffisamment d'espace. En nous réveillant, nous revenons au début, nous levons de nouveau le verrou et lançons un nouveau cycle d'écriture.
Si le pipeline a suffisamment d'espace libre, nous écrivons dans celui-ci à l'aide de . Le paramètre i_size1 de l'inode (dans le cas d'un pipeline vide, il peut être égal à 0) indique la fin des données qui y sont déjà contenues. Si l'espace d'écriture est suffisant, nous pouvons remplir le pipeline à partir de i_size1 à PIPESIZ. Ensuite, nous levons le verrou et essayons de réveiller tout processus qui attend de pouvoir lire depuis le pipeline. Nous revenons au début pour voir si nous avons réussi à écrire autant de bytes que nécessaire. Si ce n'est pas le cas, nous commençons un nouveau cycle d'écriture.
En général, le paramètre i_mode de l'inode est utilisé pour stocker les permissions r, w et x. Mais dans le cas des pipelines, nous signalons l'attente d'un processus de lecture ou d'écriture à l'aide des bits IREAD et IWRITE respectivement. Le processus définit un drapeau et appelle sleep(), et on s'attend à ce qu'un autre processus appelle wakeup().
La vraie magie se produit dans sleep() et wakeup(). Ils sont implémentés dans , source du célèbre commentaire « Vous n'êtes pas censé comprendre cela » (You are not expected to understand this). Heureusement, nous ne sommes pas obligés de comprendre le code, juste de regarder quelques commentaires :
/*
 * Give up the processor till a wakeup occurs
 * on chan, at which time the process
 * enters the scheduling queue at priority pri.
 * The most important effect of pri is that when
 * pri<0 a signal cannot disturb the sleep;
 * if pri>=0 signals will be processed.
 * Callers of this routine must be prepared for
 * premature return, and check that the reason for
 * sleeping has gone away.
 */
sleep(chan, pri) /* … */

/*
 * Wake up all processes sleeping on chan.
 */
wakeup(chan) /* … */
Un processus qui appelle sleep() pour un canal donné peut être réveillé plus tard par un autre processus qui appelle wakeup() pour le même canal. writep() et readp() Ils coordonnent leurs actions grâce à de tels appels en paire. Notez que pipe.c donne toujours la priorité à PPIPE lors de l'appel sleep(), donc tous sleep() peuvent être interrompus par un signal.
Maintenant, nous avons tout pour comprendre la fonction readp():
readp(fp)
int *fp;
{
    register *rp, *ip;

    rp = fp;
    ip = rp->f_inode;

loop:
    /* Verrouillage très conservateur. */

    plock(ip);

    /*
     * Si la tête (lecture) a rattrapé
     * la queue (écriture), réinitialiser les deux à 0.
     * /

    if(rp->f_offset[1] == ip->i_size1) {
        if(rp->f_offset[1] != 0) {
            rp->f_offset[1] = 0;
            ip->i_size1 = 0;
            if(ip->i_mode&IWRITE) {
                ip->i_mode =& ~IWRITE;
                wakeup(ip+1);
            }
        }

        /*
         * S'il n'y a pas à la fois un lecteur et
         * un écrivain actifs, retourner sans
         * satisfaire la lecture.
         * /

        prele(ip);
        if(ip->i_count i_mode =| IREAD;
        sleep(ip+2, PPIPE);
        goto loop;
    }

    /* Lire et retourner */

    u.u_offset[0] = 0;
    u.u_offset[1] = rp->f_offset[1];
    readi(ip);
    rp->f_offset[1] = u.u_offset[1];
    prele(ip);
}
Il vous sera peut-être plus facile de lire cette fonction de bas en haut. La branche « lire et retourner » est généralement utilisée lorsqu'il y a des données dans le tube. Dans ce cas, nous utilisons pour lire autant de données que disponibles à partir de l'actuel f_offset de lecture, puis nous mettons à jour la valeur du décalage correspondant.
Lors de la prochaine lecture, le tube sera vide si le décalage de lecture a atteint la valeur i_size1 pour l'inode. Nous réinitialisons la position à 0 et essayons de réveiller tout processus qui souhaite écrire dans le tube. Nous savons que lorsque le tube sera plein, writep() il s'endormira sur ip+1. Et maintenant, lorsque le tube est vide, nous pouvons le réveiller pour qu'il reprenne son cycle d'écriture.
S'il n'y a rien à lire, alors readp() il peut définir un drapeau IREAD et s'endormir sur ip+2. Nous savons qu'il sera réveillé writep()lorsqu'il écrira des données dans le tube.
Les commentaires sur aideront à comprendre que plutôt que de passer des paramètres via «u», nous pouvons les traiter comme de simples fonctions d'entrée-sortie, qui prennent un fichier, une position, un tampon en mémoire et comptent le nombre d'octets à lire ou à écrire.
/*
 * Read the file corresponding to
 * the inode pointed at by the argument.
 * The actual read arguments are found
 * in the variables:
 *    u_base        core address for destination
 *    u_offset    byte offset in file
 *    u_count        number of bytes to read
 *    u_segflg    read to kernel/user
 */
readi(aip)
struct inode *aip;
/* … */

/*
 * Write the file corresponding to
 * the inode pointed at by the argument.
 * The actual write arguments are found
 * in the variables:
 *    u_base        core address for source
 *    u_offset    byte offset in file
 *    u_count        number of bytes to write
 *    u_segflg    write to kernel/user
 */
writei(aip)
struct inode *aip;
/* … */
En ce qui concerne le verrouillage « conservateur », il readp() et writep() verrouille l'inode jusqu'à ce qu'il ait terminé son travail ou qu'il ait obtenu un résultat (c'est-à-dire qu'il appelle wakeup). plock() et prele() fonctionnent simplement : avec un autre ensemble d'appels sleep et wakeup ils nous permettent de réveiller tout processus qui a besoin du verrou que nous venons de libérer :
/*
 * Lock a pipe.
 * If its already locked, set the WANT bit and sleep.
 */
plock(ip)
int *ip;
{
    register *rp;

    rp = ip;
    while(rp->i_flag&ILOCK) {
        rp->i_flag =| IWANT;
        sleep(rp, PPIPE);
    }
    rp->i_flag =| ILOCK;
}

/*
 * Unlock a pipe.
 * If WANT bit is on, wakeup.
 * This routine is also used to unlock inodes in general.
 */
prele(ip)
int *ip;
{
    register *rp;

    rp = ip;
    rp->i_flag =& ~ILOCK;
    if(rp->i_flag&IWANT) {
        rp->i_flag =& ~IWANT;
        wakeup(rp);
    }
}
Au début, je n'arrivais pas à comprendre pourquoi readp() il n'appelle pas prele(ip) avant d'appeler wakeup(ip+1). La première chose queil appelle dans sa boucle, c'est writep() plock(ip), qui provoque un blocage siil n'a pas encore libéré son verrou, donc le code doit fonctionner correctement d'une manière ou d'une autre. Si l'on regarde readp() le wakeup(), il devient évident qu'il ne fait que marquer le processus en sommeil comme prêt à être exécuté, afin que plus tard sched() le lance réellement. Donc readp() cause wakeup(), il libère le verrou, définit IREAD et appelle sleep(ip+2)— tout cela avant que writep() il redémarre la boucle.
Ainsi se termine la description des pipelines dans la sixième édition. Un code simple, des conséquences majeures.
(janvier 1979) était une nouvelle version majeure (après quatre ans), qui a introduit de nombreuses nouvelles applications et fonctionnalités du noyau. Il y a eu aussi des changements significatifs liés à l'utilisation de la conversion de types, des unions et des pointeurs typés vers des structures. Cependant n'a pratiquement pas changé. Nous pouvons sauter cette version.
Xv6, un noyau semblable à Unix
La création du noyau a été influencée par la sixième édition de Unix, mais elle est écrite en C moderne pour fonctionner sur des processeurs x86. Le code est facile à lire, il est compréhensible. De plus, contrairement aux sources de Unix avec TUHS, vous pouvez le compiler, le modifier et l'exécuter sur autre chose que le PDP 11/70. C'est pourquoi ce noyau est largement utilisé dans les universités comme matériel pédagogique en systèmes d'exploitation. Les sources .
Le code contient une mise en œuvre claire et réfléchie , soutenue par un tampon en mémoire au lieu d'un inode sur le disque. Ici, je ne donne que la définition du « pipeline structurel » et de la fonction pipealloc():
#define PIPESIZE 512

struct pipe {
  struct spinlock lock;
  char data[PIPESIZE];
  uint nread;     // number of bytes read
  uint nwrite;    // number of bytes written
  int readopen;   // read fd is still open
  int writeopen;  // write fd is still open
};

int
pipealloc(struct file **f0, struct file **f1)
{
  struct pipe *p;

  p = 0;
  *f0 = *f1 = 0;
  if((*f0 = filealloc()) == 0 || (*f1 = filealloc()) == 0)
    goto bad;
  if((p = (struct pipe*)kalloc()) == 0)
    goto bad;
  p->readopen = 1;
  p->writeopen = 1;
  p->nwrite = 0;
  p->nread = 0;
  initlock(&p->lock, "pipe");
  (*f0)->type = FD_PIPE;
  (*f0)->readable = 1;
  (*f0)->writable = 0;
  (*f0)->pipe = p;
  (*f1)->type = FD_PIPE;
  (*f1)->readable = 0;
  (*f1)->writable = 1;
  (*f1)->pipe = p;
  return 0;

 bad:
  if(p)
    kfree((char*)p);
  if(*f0)
    fileclose(*f0);
  if(*f1)
    fileclose(*f1);
  return -1;
}
pipealloc() définit l'état de toute l'autre mise en œuvre, qui comprend les fonctions piperead(), pipewrite() et pipeclose(). L'appel système réel sys_pipe est une enveloppe, réalisée dans . Je recommande de lire tout son code. La complexité est au niveau de la sixième édition, mais c'est beaucoup plus facile et agréable à lire.
Linux 0.01
Le code source de Linux 0.01 peut être trouvé. Cela serait instructif d'étudier la mise en œuvre des pipelines dans son code. fs/pipe.c. Ici, pour représenter le pipeline, on utilise un inode, mais le pipeline lui-même est écrit en C moderne. Si vous avez réussi à déchiffrer le code de la sixième édition, vous ne rencontrerez pas de difficultés ici. Voici à quoi ressemble la fonction write_pipe():
int write_pipe(struct m_inode * inode, char * buf, int count)
{
    char * b=buf;

    wake_up(&inode->i_wait);
    if (inode->i_count != 2) { /* no readers */
        current->signal |= (1< 0) {
        while (PIPE_FULL(*inode)) {
            wake_up(&inode->i_wait);
            if (inode->i_count != 2) {
                current->signal |= (1<i_wait);
        }
        ((char *)inode->i_size)[PIPE_HEAD(*inode)] =
            get_fs_byte(b++);
        INC_PIPE(PIPE_HEAD(*inode));
        wake_up(&inode->i_wait);
    }
    wake_up(&inode->i_wait);
    return b-buf;
}
Même sans jeter un coup d'œil aux définitions de structures, on peut comprendre comment le compteur de références inode est utilisé pour vérifier si l'opération d'écriture conduit à SIGPIPE. En plus d'un travail au niveau des octets, cette fonction est facilement associable aux idées décrites ci-dessus. Même la logique sleep_on/wake_up ne paraît pas si étrangère.
Les noyaux modernes Linux, FreeBSD, NetBSD, OpenBSD
J'ai rapidement parcouru certains noyaux modernes. Aucun d'eux n'utilise déjà une implémentation basée sur un disque (pas étonnant). Linux a sa propre implémentation. Et bien que trois noyaux BSD modernes contiennent des implémentations basées sur du code écrit par John Dyson, au fil des ans, ils se sont trop éloignés les uns des autres.
Pour lire fs/pipe.c (sur Linux) ou sys/kern/sys_pipe.c (sur *BSD), il faut un véritable engagement. Aujourd'hui, la performance et le support de fonctions comme les opérations d'entrée/sortie vectorielles et asynchrones sont cruciales. Les détails concernant l'allocation de mémoire, les verrouillages et la configuration du noyau varient énormément. Ce n'est pas ce qu'il faut pour un cours d'introduction sur les systèmes d'exploitation.
Quoi qu'il en soit, j'étais intéressé de déterrer quelques anciens modèles (comme la génération SIGPIPE et le retour EPIPE lors d'une écriture dans un pipeline fermé) dans tous ces noyaux modernes si différents. Je ne verrai probablement jamais un ordinateur PDP-11 en vrai, mais il reste des leçons à tirer du code écrit plusieurs années avant ma naissance.
L'article écrit par Divi Kapoor en 2011 intitulé «» constitue un aperçu de la façon dont les pipelines fonctionnent (encore aujourd'hui) dans Linux. De plus, illustre le modèle de pipeline d'interaction, dont les capacités dépassent celles des fichiers temporaires ; il montre également à quel point les pipelines se sont éloignés de la « verrouillage très conservateur » dans le noyau Unix de la sixième édition.
Source : habr.com
