

Quelle que soit l'évolution des technologies, il existe toujours une litanie d'approches obsolètes qui les accompagne. Cela peut être dû à une transition en douceur, à des facteurs humains, à des nécessités technologiques ou à d'autres raisons. Dans le domaine du traitement des données, les sources de données sont particulièrement révélatrices à cet égard. Peu importe combien nous rêvons de nous en débarrasser, tant que certaines données sont transmises par des messageries et des courriels, sans parler des formats plus archaïques. Je vous invite à découvrir ci-dessous l'un des moyens d'extraire des données depuis des courriers électroniques dans Apache Airflow.
Contexte
De nombreuses données sont encore transmises par e-mail, allant des communications interpersonnelles aux normes d'interaction entre entreprises. Il est idéal de pouvoir créer une interface pour obtenir des données ou de placer des personnes au bureau pour saisir ces informations dans des sources plus pratiques, mais souvent, cette possibilité peut simplement ne pas exister. La tâche spécifique à laquelle j'ai été confronté était de connecter un système CRM bien connu à un entrepôt de données, puis à un système OLAP. Il se trouve qu'historiquement, pour notre entreprise, l'utilisation de ce système était pratique dans un domaine particulier de l'activité. Par conséquent, tout le monde souhaitait pouvoir manipuler des données également à partir de ce système tiers. Dans un premier temps, nous avons bien sûr étudié la possibilité d'obtenir des données via une API ouverte. Malheureusement, l'API ne couvrait pas l'obtention de toutes les données nécessaires, et pour le dire simplement, elle était en grande partie inefficace, et le support technique n'a pas voulu ou n'a pas pu répondre à la demande d'un fonctionnement plus complet. En revanche, ce système offrait la possibilité d'obtenir périodiquement les données manquantes par e-mail sous forme de lien pour télécharger une archive.
Il convient de noter que ce n'était pas le seul cas où l'entreprise souhaitait collecter des données à partir de courriels ou de messageries. Cependant, dans ce cas, nous ne pouvions pas influencer l'entreprise tierce qui ne fournissait certaines données que de cette manière.
Apache Airflow
Pour construire des processus ETL, nous utilisons le plus souvent Apache Airflow. Afin d'aider le lecteur qui n'est pas familier avec cette technologie à mieux comprendre à quoi cela ressemble dans un contexte général, je vais décrire quelques éléments d'introduction.
Apache Airflow est une plateforme open-source utilisée pour créer, exécuter et surveiller des processus ETL (Extract-Transform-Loading) en Python. Le concept principal dans Airflow est le graphe acyclique orienté, où les sommets du graphe représentent des processus spécifiques et les arêtes du graphe représentent le flux de contrôle ou d'informations. Un processus peut simplement appeler n'importe quelle fonction Python, ou il peut avoir une logique plus complexe avec un appel séquentiel de plusieurs fonctions dans le contexte d'une classe. Pour les opérations les plus courantes, il existe déjà de nombreuses solutions prêtes à l'emploi qui peuvent être utilisées comme des processus. Parmi ces solutions, on trouve :
- des opérateurs — pour transférer des données d'un endroit à un autre, par exemple d'une table de base de données vers un entrepôt de données ;
- des capteurs — pour attendre qu'un événement spécifique se produise et diriger le flux de contrôle vers les sommets suivants du graphe ;
- des hooks — pour des opérations de niveau inférieur, par exemple, pour obtenir des données d'une table de base de données (utilisées dans les opérateurs) ;
- etc.
Il ne serait pas judicieux de décrire Apache Airflow en détail dans cet article. Vous pouvez consulter des introductions succinctes. ou .
Hook pour obtenir des données
Tout d'abord, pour résoudre le problème, il faut écrire un hook qui nous permettrait de :
- se connecter à un email ;
- trouver l'email nécessaire ;
- obtenir des données de l'email.
from airflow.hooks.base_hook import BaseHook
import imaplib
import logging

class IMAPHook(BaseHook):
    def __init__(self, imap_conn_id):
        """
           IMAP hook pour obtenir des données d'emails

           :param imap_conn_id:       Identifiant de connexion à l'email
           :type imap_conn_id:        string
        """
        self.connection = self.get_connection(imap_conn_id)
        self.mail = None

    def authenticate(self):
        """
            Connexion à l'email
        """
        mail = imaplib.IMAP4_SSL(self.connection.host)
        response, detail = mail.login(user=self.connection.login, password=self.connection.password)
        if response != "OK":
            raise AirflowException("Échec de la connexion")
        else:
            self.mail = mail

    def get_last_mail(self, check_seen=True, box="INBOX", condition="(UNSEEN)"):
        """
            Méthode pour obtenir l'identifiant du dernier email,
            répondant aux conditions de recherche

            :param check_seen:      Marquer le dernier email comme lu
            :type check_seen:       bool
            :param box:             Nom de la boîte
            :type box:              string
            :param condition:       Conditions de recherche des emails
            :type condition:        string
        """
        self.authenticate()
        self.mail.select(mailbox=box)
        response, data = self.mail.search(None, condition)
        mail_ids = data[0].split()
        logging.info("Les emails suivants ont été trouvés dans la boîte : " + str(mail_ids))

        if not mail_ids:
            logging.info("Aucun nouvel email trouvé")
            return None

        mail_id = mail_ids[0]

        # si plusieurs emails sont trouvés
        if len(mail_ids) > 1:
            # marquer les autres comme lus
            for id in mail_ids:
                self.mail.store(id, "+FLAGS", "\Seen")

            # retourner le dernier
            mail_id = mail_ids[-1]

        # doit-on marquer le dernier comme lu
        if not check_seen:
            self.mail.store(mail_id, "-FLAGS", "\Seen")

        return mail_id
La logique est la suivante : on se connecte, on trouve le dernier email le plus pertinent, et si d'autres sont présents — on les ignore. Cette fonction est utilisée précisément pour cela, car les emails ultérieurs contiennent toutes les données des précédents. Si ce n'est pas le cas, on peut renvoyer un tableau de tous les emails ou traiter le premier, les autres lors du prochain passage. En résumé, tout dépend toujours de la tâche.
Nous ajoutons deux fonctions auxiliaires au hook : une pour télécharger un fichier et une autre pour télécharger un fichier à partir d'un lien dans un e-mail. D'ailleurs, on peut les extraire dans un opérateur, cela dépend de la fréquence d'utilisation de cette fonctionnalité. Que faut-il encore ajouter au hook ? Cela dépend encore de la tâche : si des fichiers arrivent directement dans l'e-mail, on peut télécharger les pièces jointes, si des données arrivent dans l'e-mail, il faut parser l'e-mail, etc. Dans mon cas, l'e-mail arrive avec un seul lien vers une archive que je dois placer à un endroit spécifique et déclencher le processus de traitement suivant.
    def download_from_url(self, url, path, chunk_size=128):
        """
            Méthode pour télécharger un fichier

            :param url:              Adresse de téléchargement
            :type url:               string
            :param path:             Où placer le fichier
            :type path:              string
            :param chunk_size:       Taille des chunks à écrire
            :type chunk_size:        int
        """
        r = requests.get(url, stream=True)
        with open(path, "wb") as fd:
            for chunk in r.iter_content(chunk_size=chunk_size):
                fd.write(chunk)

    def download_mail_href_attachment(self, mail_id, path):
        """
            Méthode pour télécharger un fichier à partir d'un lien dans un e-mail

            :param mail_id:         Identifiant de l'e-mail
            :type mail_id:          string
            :param path:            Où placer le fichier
            :type path:             string
        """
        response, data = self.mail.fetch(mail_id, "(RFC822)")
        raw_email = data[0][1]
        raw_soup = raw_email.decode().replace("r", "").replace("n", "")
        parse_soup = BeautifulSoup(raw_soup, "html.parser")
        link_text = ""

        for a in parse_soup.find_all("a", href=True, text=True):
            link_text = a["href"]

        self.download_from_url(link_text, path)
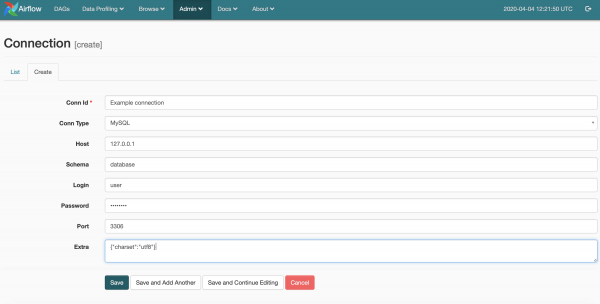
Le code est simple, donc il ne nécessite probablement pas d'explications supplémentaires. Je vais juste parler de la ligne magique imap_conn_id. Apache Airflow stocke les paramètres de connexion (nom d'utilisateur, mot de passe, adresse et autres paramètres) auxquels on peut accéder par identifiant sous forme de chaîne. Visuellement, la gestion des connexions ressemble à ceci
Capteur pour attendre les données
Puisque nous savons déjà comment nous connecter et obtenir des données par e-mail, nous pouvons maintenant écrire un capteur pour les attendre. Écrire immédiatement un opérateur qui traitera les données si elles existent n'a pas été possible dans mon cas, car d'autres processus, y compris ceux qui prennent des données liées provenant d'autres sources (API, téléphonie, web analytics, etc.), fonctionnent également sur la base des données recueillies par e-mail. Prenons un exemple. Un nouvel utilisateur apparaît dans le système CRM, et nous ne connaissons pas encore son UUID. Ainsi, lorsque nous essayons d'obtenir des données de téléphonie SIP, nous recevrons des appels liés à son UUID, mais nous ne pourrons pas les enregistrer et les utiliser correctement. Dans de telles situations, il est important de garder à l'esprit la dépendance des données, surtout si elles proviennent de différentes sources. Ce sont, bien sûr, des mesures insuffisantes pour garantir l'intégrité des données, mais parfois nécessaires. Et occuper des ressources inutilement n'est pas non plus rationnel.
Ainsi, notre capteur lancera les sommets suivants du graphique s'il y a de nouvelles informations par e-mail, tout en marquant les informations précédentes comme non pertinentes.
from airflow.sensors.base_sensor_operator import BaseSensorOperator
from airflow.utils.decorators import apply_defaults
from my_plugin.hooks.imap_hook import IMAPHook

class MailSensor(BaseSensorOperator):
    @apply_defaults
    def __init__(self, conn_id, check_seen=True, box="Inbox", condition="(UNSEEN)", *args, **kwargs):
        super().__init__(*args, **kwargs)
        self.conn_id = conn_id
        self.check_seen = check_seen
        self.box = box
        self.condition = condition

    def poke(self, context):
        conn = IMAPHook(self.conn_id)
        mail_id = conn.get_last_mail(check_seen=self.check_seen, box=self.box, condition=self.condition)

        if mail_id is None:
            return False
        else:
            return True
Obtenir et utiliser des données
Pour obtenir et traiter des données, on peut écrire un opérateur séparé ou utiliser des opérateurs existants. Puisque la logique est pour l'instant triviale – récupérer des données d'un e-mail, je propose ici l'utilisation du PythonOperator standard comme exemple.
from airflow.models import DAG

from airflow.operators.python_operator import PythonOperator
from airflow.sensors.my_plugin import MailSensor
from my_plugin.hooks.imap_hook import IMAPHook

start_date = datetime(2020, 4, 4)

# Configuration standard du graphe
args = {
    "owner": "example",
    "start_date": start_date,
    "email": ["home@home.ru"],
    "email_on_failure": False,
    "email_on_retry": False,
    "retry_delay": timedelta(minutes=15),
    "provide_context": False,
}

dag = DAG(
    dag_id="test_etl",
    default_args=args,
    schedule_interval="@hourly",
)

# Définir le capteur
mail_check_sensor = MailSensor(
    task_id="check_new_emails",
    poke_interval=10,
    conn_id="mail_conn_id",
    timeout=10,
    soft_fail=True,
    box="my_box",
    dag=dag,
    mode="poke",
)

# Fonction pour obtenir des données à partir d'un email
def prepare_mail():
    imap_hook = IMAPHook("mail_conn_id")
    mail_id = imap_hook.get_last_mail(check_seen=True, box="my_box")
    if mail_id is None:
        raise AirflowException("Mailbox vide")

    conn.download_mail_href_attachment(mail_id, "./path.zip")

prepare_mail_data = PythonOperator(task_id="prepare_mail_data", default_args=args, dag=dag, python_callable= prepare_mail)

# Description des autres sommets du graphe
...

# Établir les liens dans le graphe
mail_check_sensor >> prepare_mail_data
prepare_data >> ...
# Description des autres flux de contrôle
D'ailleurs, si votre email d'entreprise est également sur mail.ru, vous n'aurez pas accès à la recherche d'emails par sujet, expéditeur, etc. Ils avaient promis d'implémenter ça en 2016, mais apparemment, ils ont changé d'avis. J'ai résolu ce problème en créant un dossier séparé pour les emails nécessaires et en configurant un filtre dans l'interface web de l'email pour les emails désirés. Ainsi, seuls les emails pertinents atterrissent dans ce dossier et les conditions pour la recherche dans mon cas sont simplement (UNSEEN).
En résumé, nous avons la séquence suivante : nous vérifions s'il y a de nouveaux emails correspondant aux conditions, si c'est le cas, nous téléchargeons l'archive à partir du lien du dernier email.
Sous les derniers points de suspension, il est sous-entendu que cette archive sera décompressée, que les données de l'archive seront nettoyées et traitées, et que tout cela contribuera ensuite au pipeline du processus ETL, mais cela dépasse le cadre de l'article. Si cela vous semble intéressant et utile, je serai ravi de continuer à décrire les solutions ETL et leurs parties pour Apache Airflow.
Source : habr.com
