

Les professions de Data Scientist et de Data Engineer sont souvent confondues. Chaque entreprise a sa spécificité dans le traitement des données, des objectifs d'analyse différents et une conception variée de la répartition des tâches entre ces spécialistes, ce qui entraîne des exigences distinctes.
Nous clarifions la différence entre ces spécialistes, les tâches commerciales qu'ils accomplissent, les compétences qu'ils possèdent et leurs niveaux de salaire. Le document étant conséquent, nous l'avons divisé en deux publications.
Dans le premier article, Elena Gerasimova, responsable du département «» chez Netology, explique la différence entre Data Scientist et Data Engineer et les outils qu'ils utilisent.
Comment se différencient les rôles des ingénieurs et des data scientists
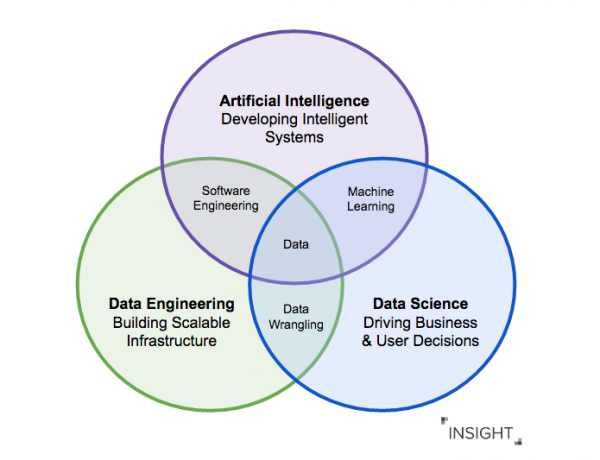
Le Data Engineer est un spécialiste qui, d'une part, conçoit, teste et maintient l'infrastructure de traitement des données : bases de données, entrepôts de données et systèmes de traitement de masse. D'autre part, il s'occupe de nettoyer et de structurer les données pour les rendre utilisables par les analystes et les data scientists, c'est-à-dire il crée des pipelines de traitement des données.
Le Data Scientist crée et entraîne des modèles prédictifs (et d'autres) à l'aide d'algorithmes d'apprentissage automatique et de réseaux neuronaux, aidant les entreprises à détecter des schémas cachés, à prévoir des événements et à optimiser des processus commerciaux clés.
La principale différence entre le Data Scientist et le Data Engineer réside dans le fait qu'ils ont généralement des objectifs différents. Tous deux travaillent pour que les données soient accessibles et de qualité. Cependant, le Data Scientist cherche des réponses à ses questions et teste des hypothèses dans l'écosystème de données (par exemple, sur une base Hadoop), tandis que le Data Engineer crée le pipeline de maintenance de l'algorithme d'apprentissage automatique élaboré par le data scientist, au sein du même écosystème Spark.
Le Data Engineer apporte de la valeur à l'entreprise en travaillant en équipe. Sa tâche consiste à établir un lien crucial entre les différents acteurs : des développeurs aux consommateurs d'analyses, et à accroître la productivité des analystes – qu'ils soient en marketing, en développement produit ou en Business Intelligence.
Le Data Scientist, quant à lui, participe activement à la stratégie de l'entreprise et à l'extraction d'insights, à la prise de décisions, à la mise en œuvre des algorithmes d'automatisation, de modélisation et à la génération de valeur à partir des données.
Le travail avec les données est soumis au principe GIGO (garbage in — garbage out) : si les analystes et les data scientists manipulent des données non préparées et potentiellement incorrectes, les résultats, même avec les algorithmes d'analyse les plus sophistiqués, seront erronés.
Les ingénieurs des données résolvent ce problème en construisant des pipelines pour le traitement, le nettoyage et la transformation des données, permettant ainsi aux data scientists de travailler avec des données de qualité.
Il existe de nombreux outils sur le marché pour travailler avec les données, couvrant chaque étape : de l'apparition des données à leur affichage sur le tableau de bord du conseil d'administration. Il est important que la décision de les utiliser soit prise par un ingénieur, non pas parce que c'est à la mode, mais parce qu'elle aidera réellement les autres participants au processus.
En gros, si une entreprise doit faire collaborer BI et ETL — le chargement des données et les mises à jour des rapports, voici une base héritée typique avec laquelle un Data Engineer devra traiter (idéalement, il y aura aussi un architecte dans l'équipe).
Responsabilités du Data Engineer
- Conception, construction et maintenance de l'infrastructure de travail avec les données.
- Gestion des erreurs et création de pipelines de traitement des données fiables.
- Transformation des données non structurées provenant de diverses sources dynamiques en un format requis pour le travail des analystes.
- Fournir des recommandations pour améliorer la cohérence et la qualité des données.
- Assurer et maintenir l'architecture des données utilisée par les data scientists et les analystes de données.
- Traitement et stockage des données de manière séquentielle et efficace dans un cluster distribué de dizaines ou de centaines de serveurs.
- Évaluation des compromis techniques des outils pour créer des architectures simples mais robustes capables de résister aux pannes.
- Contrôle et maintenance des flux de données et des systèmes associés (configuration de la surveillance et des alertes).
Il existe une autre spécialisation au sein du parcours Data Engineer — l'ingénieur ML. En résumé, ces ingénieurs se spécialisent dans le déploiement de modèles d'apprentissage automatique en conditions industrielles. Souvent, le modèle fourni par le data scientist fait partie d'une recherche et peut ne pas fonctionner dans des conditions réelles.
Responsabilités du Data Scientist
- Extraction de caractéristiques à partir des données pour l'application des algorithmes d'apprentissage automatique.
- Utilisation de divers outils d'apprentissage automatique pour prévoir et classifier des motifs dans les données.
- Amélioration des performances et de la précision des algorithmes d'apprentissage automatique grâce à l'ajustement fin et à l'optimisation des algorithmes.
- Formulation d'hypothèses « fortes » en accord avec la stratégie de l'entreprise, qui doivent être vérifiées.
À la fois le Data Engineer et le Data Scientist contribuent de manière significative au développement d'une culture de traitement des données, permettant à l'entreprise d'augmenter ses profits ou de réduire ses coûts.
Avec quels langages et outils travaillent les ingénieurs et les scientifiques des données
Aujourd'hui, les attentes vis-à-vis des spécialistes du traitement des données ont changé. Auparavant, les ingénieurs rédigeaient de grandes requêtes SQL, écrivaient manuellement des MapReduce et traitaient des données à l'aide d'outils tels qu'Informatica ETL, Pentaho ETL, Talend.
En 2020, un spécialiste ne peut se passer de la connaissance de Python et des outils modernes de calcul (comme Airflow), ainsi que de la compréhension des principes de travail avec les plateformes cloud (en les utilisant pour économiser sur le matériel tout en respectant les principes de sécurité).
SAP, Oracle, MySQL, Redis — ce sont des outils traditionnels pour les ingénieurs de données dans les grandes entreprises. Ils sont bons, mais le coût des licences est si élevé qu'il n'est logique d'apprendre à les utiliser que dans des projets industriels. Il existe néanmoins une alternative gratuite comme Postgres — il est gratuit et convient non seulement pour l'apprentissage.
Historiquement, il y a souvent eu une demande pour Java et Scala, bien que, avec l'évolution des technologies et des approches, ces langages passent au second plan.
Cependant, le Big Data hardcore : Hadoop, Spark et le reste du zoo ne sont plus des conditions indispensables pour un ingénieur de données, mais plutôt un ensemble d'outils pour résoudre des problèmes qui ne peuvent être résolus avec un ETL traditionnel.
Les services sans besoin de connaître le langage dans lequel ils sont écrits (par exemple, Hadoop sans connaissance de Java) sont à la mode, ainsi que la fourniture de services prêts à l'emploi pour le traitement des données en continu (reconnaissance vocale ou d'images sur vidéo).
Les solutions industrielles de SAS et SPSS sont populaires, tandis que Tableau, Rapidminer, Stata et Julia sont également largement utilisés par les data scientists pour des tâches locales.
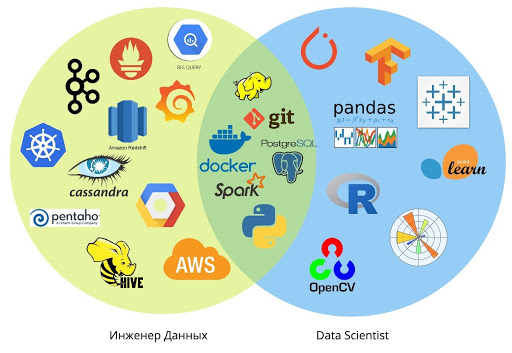
La possibilité de construire soi-même des pipelines est apparue pour les analystes et les data scientists il y a seulement quelques années : par exemple, il est déjà possible d'acheminer des données vers un stockage basé sur PostgreSQL avec des scripts relativement simples.
En général, l'utilisation de pipelines et de structures de données intégrées reste entre les mains des data engineers. Mais aujourd'hui plus que jamais, la tendance des spécialistes en T — avec des compétences larges dans des domaines connexes — est forte, car les outils se simplifient continuellement.
Pourquoi Data Engineer et Data Scientist doivent-ils travailler ensemble
En collaborant étroitement avec les ingénieurs, les Data Scientists peuvent se concentrer sur l'aspect recherche, en créant des algorithmes de machine learning prêts à l'emploi.
Et les ingénieurs peuvent se concentrer sur l'évolutivité, la réutilisation des données et s'assurer que les pipelines d'entrée et de sortie des données dans chaque projet répondent à l'architecture globale.
Une telle répartition des tâches assure une cohérence d'action entre les groupes de spécialistes travaillant sur différents projets de machine learning.
La collaboration aide à créer efficacement de nouveaux produits. La rapidité et la qualité sont atteintes grâce à un équilibre entre la création d'un service pour tous (stockage global ou intégration de tableaux de bord) et la réalisation de chaque besoin ou projet spécifique (pipeline spécialisé, connexion à des sources externes).
Le travail étroit avec les data scientists et les analystes aide les ingénieurs à développer des compétences analytiques et de recherche pour écrire un code de meilleure qualité. L'échange de connaissances entre les utilisateurs de stockages et de lacs de données s'améliore, rendant les projets plus flexibles et assurant des résultats durables à long terme.
Dans les entreprises qui visent à développer une culture de travail des données et à construire des processus commerciaux sur cette base, les Data Scientists et les Data Engineers se complètent et créent un système d'analyse de données complet.
Dans le prochain article, nous allons parler de l'éducation requise pour les Data Engineers et les Data Scientists, des compétences qu'ils doivent développer et de la structure du marché.
De la rédaction de Netology
Si vous envisagez une carrière en tant que Data Engineer ou Data Scientist, nous vous invitons à découvrir nos programmes de cours :
- La profession «».
- La profession «».
Source : habr.com
