

Salut, Habr !
Dans cet article, nous souhaitons parler de l'automatisation des infrastructures réseau. Nous présenterons un schéma de réseau fonctionnant dans une petite mais très fière entreprise. Toute ressemblance avec du matériel réseau réel est purement fortuite. Nous examinerons un cas qui s'est produit dans ce réseau, qui aurait pu entraîner un arrêt prolongé des activités et des pertes financières importantes. La solution à ce cas s'inscrit parfaitement dans le concept d'« Automatisation des infrastructures réseau ». Grâce à des outils d'automatisation, nous montrerons comment résoudre efficacement des problèmes complexes dans des délais réduits et réfléchirons aux raisons pour lesquelles il est préférable de résoudre ces problèmes de cette manière et non une autre (par le biais de la console).
Avertissement
Nos principaux outils d'automatisation sont Ansible (en tant qu'outil d'automatisation) et Git (en tant que système de stockage des playbooks Ansible). Nous tenons à préciser qu'il ne s'agit pas d'un article introductif où nous discutons de la logique de fonctionnement d'Ansible ou de Git, et expliquons les concepts de base (par exemple, qu'est-ce qu'un module, un fichier d'inventaire ou des variables dans Ansible, ou ce qui se passe lorsque l'on introduit les commandes git push ou git commit). Ce n'est pas une histoire sur la façon de pratiquer Ansible, de configurer NTP ou SMTP sur le matériel. C'est une histoire sur la manière de résoudre rapidement, et de préférence sans erreurs, un problème réseau. Il est également souhaitable d'avoir une bonne compréhension de la façon dont fonctionne un réseau, en particulier ce qu'est la pile de protocoles TCP/IP, OSPF, BGP. Nous mettrons également de côté le choix d'Ansible et Git. Si vous hésitez encore sur une solution particulière, nous vous recommandons fortement de lire le livre « Network Programmability and Automation. Skills for the Next-Generation Network Engineer » par Jason Edelman, Scott S. Lowe et Matt Oswalt.
Passons aux choses sérieuses.
Définition du problème
Imaginons la situation : 3 heures du matin, vous dormez profondément et faites de beaux rêves. Le téléphone sonne. C'est le directeur technique qui appelle :
— Oui ?
— ###, ####, #####, le cluster de pare-feu est tombé et ne se relève pas !!!
Vous frottez vos yeux, essayez de comprendre ce qui se passe et envisagez comment cela a pu arriver. On entend le directeur se tirer les cheveux au téléphone, et il demande de rappeler, car il reçoit un appel de la part du directeur général sur la ligne secondaire.
Après une demi-heure, vous avez recueilli les premières informations de l'équipe de garde et réveillé tous ceux qui pouvaient l'être. Au final, le directeur technique n’a pas menti, tout est vrai, le cluster principal des pare-feu est tombé et aucune action de base ne le réveille. Tous les services offerts par l'entreprise ne fonctionnent pas.
Choisissez un problème à votre goût, chacun se souviendra de quelque chose de personnel. Par exemple, après la mise à jour nocturne, en l'absence de forte charge, tout fonctionnait bien et tout le monde était content d'aller se coucher. Le trafic est monté et les tampons des interfaces ont commencé à se remplir à cause d'un bogue dans le pilote de la carte réseau.
La situation peut bien être décrite par Jackie Chan.
Merci, Jackie.
La situation n'est pas très agréable, n'est-ce pas ?
Laissons notre réseau bro avec ses pensées tristes pour un moment.
Discutons de la façon dont les événements vont se dérouler à l'avenir.
Nous proposons le plan suivant pour présenter le matériel.
- Examinons le schéma du réseau et analysons comment il fonctionne;
- Décrivons comment nous transférons les paramètres d'un routeur à un autre à l'aide d'Ansible;
- Parlons de l'automatisation de l'infrastructure IT dans son ensemble.
Schéma du réseau et description
Configuration
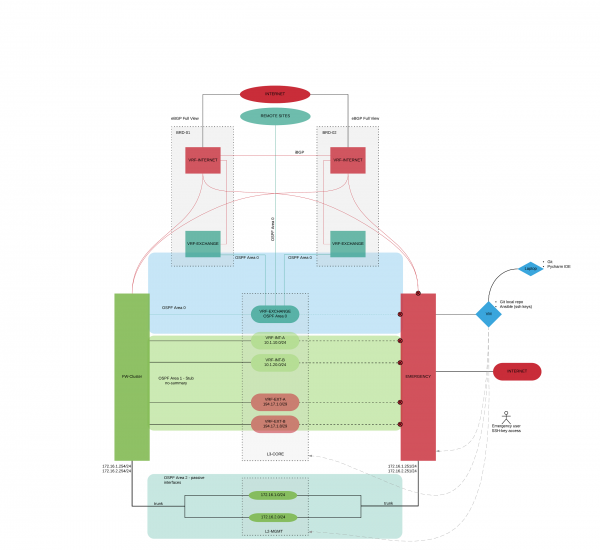
Nous allons examiner le schéma logique de notre organisation. Nous ne mentionnerons pas de fabricants d'équipements spécifiques, cela n'a pas d'importance dans le cadre de cet article. (Le lecteur attentif devinera lui-même quel type d'équipement est utilisé). C'est justement l'un des bons aspects du travail avec Ansible, lors de la configuration, nous nous moquons en général de quel type d'équipement il s'agit. Juste pour comprendre, cet équipement provient de fournisseurs bien connus, comme Cisco, Juniper, Check Point, Fortinet, Palo Alto… vous pouvez mettre votre propre option.
Nous avons deux tâches principales concernant le transfert de trafic :
- Assurer la publication de nos services, qui constituent l'activité de l'entreprise ;
- Assurer la connexion avec les succursales, le centre de données distant et les organisations tiers (partenaires et clients), ainsi que la sortie des succursales sur Internet via le bureau central.
Commençons par les éléments principaux :
- Deux routeurs frontaliers (BRD-01, BRD-02);
- Un cluster de pare-feu (FW-CLUSTER);
- Un commutateur de cœur (L3-CORE);
- Un routeur qui sera une bouée de sauvetage (dans le cadre de la résolution du problème, nous transférerons les paramètres réseau de FW-CLUSTER à EMERGENCY) (EMERGENCY);
- Des commutateurs pour gérer l'infrastructure réseau (L2-MGMT);
- Une machine virtuelle avec Git et Ansible (VM-AUTOMATION);
- Ordinateur portable utilisé pour tester et développer des playbooks pour Ansible (Laptop-Automation).
Un protocole de routage dynamique OSPF est configuré dans le réseau avec les zones suivantes :
- Zone 0 – zone comprenant les routeurs responsables du transport du trafic dans la zone EXCHANGE ;
- Zone 1 – zone comprenant les routeurs chargés des services de l'entreprise ;
- Zone 2 – zone comprenant les routeurs responsables du routage du trafic de gestion ;
- Zone N – zones des réseaux filiales.
Des routeurs virtuels (VRF-INTERNET) ont été créés sur les routeurs frontières, sur lesquels une vue complète eBGP est active avec l'AS assigné. iBGP est configuré entre les VRF. L'entreprise dispose d'un pool d'adresses IP publiques, publiées sur ces VRF-INTERNET. Une partie des adresses publiques est routée directement sur le FW-CLUSTER (adresses sur lesquelles les services de l'entreprise fonctionnent), une autre partie est routée via la zone EXCHANGE (services internes de l'entreprise nécessitant des adresses IP externes, ainsi que des adresses NAT externes pour les bureaux). Le trafic est alors acheminé vers les routeurs virtuels créés sur le L3-CORE avec des adresses publiques et privées (zones de sécurité).
Un réseau de gestion utilise des commutateurs dédiés et représente un réseau physiquement séparé. Le réseau de gestion est également divisé en zones de sécurité.
Le routeur EMERGENCY duplique physiquement et logiquement le FW-CLUSTER. Tous les interfaces sont désactivés sauf celles qui mènent au réseau de gestion.
Automatisation et sa description
Nous avons compris comment fonctionne le réseau. Maintenant, passons en revue étape par étape ce que nous allons faire pour transférer le trafic du FW-CLUSTER vers EMERGENCY :
- Désactiver les interfaces sur le commutateur coeur (L3-CORE) qui le relient au FW-CLUSTER ;
- Désactiver les interfaces sur le commutateur coeur L2-MGMT qui le relient au FW-CLUSTER ;
- Configurer le routeur EMERGENCY (par défaut, toutes les interfaces sont désactivées, sauf celles liées au L2-MGMT) :
- Activer les interfaces sur EMERGENCY ;
- Configurer l'adresse IP externe (pour NAT) qui était sur FW-Cluster ;
- Générer des requêtes gARP pour que les adresses MAC dans les tables ARP du L3-CORE changent de FW-Cluster à EMERGENCY ;
- Configurer la route par défaut statique vers BRD-01, BRD-02 ;
- Créer des règles NAT ;
- Élever sur EMERGENCY l'OSPF Area 1 ;
- Élever sur EMERGENCY l'OSPF Area 2 ;
- Modifier le coût des routes dans la Zone 1 à 10 ;
- Modifier le coût de la route par défaut dans la Zone 1 à 10 ;
- Modifier adresse IP, liés au L2-MGMT (par rapport à ceux qui étaient sur le FW-CLUSTER);
- Nous générons des requêtes gARP afin que les adresses MAC dans les tables ARP L2-MGMT changent de FW-CLUSTER à EMERGENCY.
Nous revenons encore une fois à la question initiale. Trois heures du matin, un stress immense, une erreur à n'importe quelle étape pourrait entraîner de nouveaux problèmes. Êtes-vous prêts à saisir des commandes via le CLI ? Oui ? Très bien, allez vous rincer le visage, prenez un café et rassemblez votre courage.
Bruce, peux-tu aider les gars, s'il te plaît ?
Nous continuons à peaufiner notre automatisation.
Voici le schéma de fonctionnement du playbook en termes d'Ansible. Ce schéma reflète ce que nous avons décrit un peu plus haut, mais sous forme d'implémentation concrète dans Ansible.
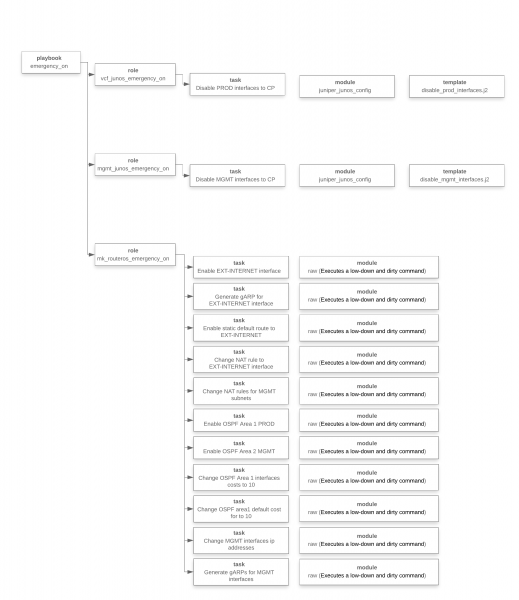
À ce stade, nous avons réalisé ce qu'il fallait faire, élaboré le playbook, effectué des tests et maintenant, nous sommes prêts à le lancer.
Une petite digression. La légèreté du récit ne doit pas vous induire en erreur. Le processus d'écriture des playbooks n'a pas été aussi simple et rapide qu'il pourrait le sembler. Les tests ont pris beaucoup de temps, un stand virtuel a été créé, la solution a été expérimentée plusieurs fois avec environ 100 tests effectués.
Nous lançons... J'ai l'impression que tout se passe très lentement, qu'il y a une erreur quelque part, et que quelque chose ne fonctionnera finalement pas. C'est comme sauter en parachute, et que le parachute ne veut pas s'ouvrir tout de suite... c'est normal.
Ensuite, lisons le résultat des opérations exécutées par le playbook Ansible (les adresses IP ont été remplacées pour des raisons de confidentialité) :
[xxx@emergency ansible]$ ansible-playbook -i /etc/ansible/inventories/prod_inventory.ini /etc/ansible/playbooks/emergency_on.yml

PLAY [------->Urgence sur VCF] ********************************************************

TASK [vcf_junos_emergency_on : Désactiver les interfaces PROD vers FW-CLUSTER] *********************
modifié : [vcf]

PLAY [------->Urgence sur MGMT-CORE] ************************************************

TASK [mgmt_junos_emergency_on : Désactiver les interfaces MGMT vers FW-CLUSTER] ******************
modifié : [m9-03-sw-03-mgmt-core]

PLAY [------->Urgence sur] ****************************************************

TASK [mk_routeros_emergency_on : Activer l'interface EXT-INTERNET] **************************
modifié : [m9-04-r-04]

TASK [mk_routeros_emergency_on : Générer gARP pour l'interface EXT-INTERNET] ****************
modifié : [m9-04-r-04]

TASK [mk_routeros_emergency_on : Activer la route par défaut statique vers EXT-INTERNET] ****************
modifié : [m9-04-r-04]

TASK [mk_routeros_emergency_on : Changer la règle NAT pour l'interface EXT-INTERNET] ****************
modifié : [m9-04-r-04] => (item=12)
modifié : [m9-04-r-04] => (item=14)
modifié : [m9-04-r-04] => (item=15)
modifié : [m9-04-r-04] => (item=16)
modifié : [m9-04-r-04] => (item=17)

TASK [mk_routeros_emergency_on : Activer OSPF Zone 1 PROD] ******************************
modifié : [m9-04-r-04]

TASK [mk_routeros_emergency_on : Activer OSPF Zone 2 MGMT] *****************************
modifié : [m9-04-r-04]

TASK [mk_routeros_emergency_on : Changer les coûts des interfaces OSPF Zone 1 à 10] *****************
modifié : [m9-04-r-04] => (item=VLAN-1001)
modifié : [m9-04-r-04] => (item=VLAN-1002)
modifié : [m9-04-r-04] => (item=VLAN-1003)
modifié : [m9-04-r-04] => (item=VLAN-1004)
modifié : [m9-04-r-04] => (item=VLAN-1005)
modifié : [m9-04-r-04] => (item=VLAN-1006)
modifié : [m9-04-r-04] => (item=VLAN-1007)
modifié : [m9-04-r-04] => (item=VLAN-1008)
modifié : [m9-04-r-04] => (item=VLAN-1009)
modifié : [m9-04-r-04] => (item=VLAN-1010)
modifié : [m9-04-r-04] => (item=VLAN-1011)
modifié : [m9-04-r-04] => (item=VLAN-1012)
modifié : [m9-04-r-04] => (item=VLAN-1013)
modifié : [m9-04-r-04] => (item=VLAN-1100)

TASK [mk_routeros_emergency_on : Changer le coût par défaut de la zone 1 de OSPF à 10] ******************
modifié : [m9-04-r-04]

TASK [mk_routeros_emergency_on : Changer les adresses IP des interfaces MGMT] ********************
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n.254', u'name': u'VLAN-803'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+1.254', u'name': u'VLAN-805'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+2.254', u'name': u'VLAN-807'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+3.254', u'name': u'VLAN-809'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+4.254', u'name': u'VLAN-820'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+5.254', u'name': u'VLAN-822'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+6.254', u'name': u'VLAN-823'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+7.254', u'name': u'VLAN-824'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+8.254', u'name': u'VLAN-850'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+9.254', u'name': u'VLAN-851'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+10.254', u'name': u'VLAN-852'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+11.254', u'name': u'VLAN-853'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+12.254', u'name': u'VLAN-870'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+13.254', u'name': u'VLAN-898'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+14.254', u'name': u'VLAN-899'})

TASK [mk_routeros_emergency_on : Générer gARPs pour les interfaces MGMT] *********************
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n.254', u'name': u'VLAN-803'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+1.254', u'name': u'VLAN-805'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+2.254', u'name': u'VLAN-807'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+3.254', u'name': u'VLAN-809'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+4.254', u'name': u'VLAN-820'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+5.254', u'name': u'VLAN-822'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+6.254', u'name': u'VLAN-823'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+7.254', u'name': u'VLAN-824'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+8.254', u'name': u'VLAN-850'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+9.254', u'name': u'VLAN-851'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+10.254', u'name': u'VLAN-852'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+11.254', u'name': u'VLAN-853'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+12.254', u'name': u'VLAN-870'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+13.254', u'name': u'VLAN-898'})
modifié : [m9-04-r-04] => (item={u'ip': u'х.х.n+14.254', u'name': u'VLAN-899'})

PLAY RECAP ************************************************************************
C'est fait !
En réalité, ce n'est pas tout à fait prêt, n'oublions pas la convergence des protocoles de routage dynamique et le chargement d'un grand nombre de routes dans le FIB. Sur cela, nous n'avons aucun contrôle. Nous attendons. C'est réglé. Voilà, c'est maintenant prêt.
Et dans le village de Vilabaggio (qui ne souhaite pas automatiser la configuration du réseau), ils continuent à faire la vaisselle. Bruce (bien qu’il soit déjà un autre, mais tout aussi impressionnant) essaie de comprendre combien d'équipements il va encore devoir reconfigurer manuellement.
J'aimerais m'arrêter sur un point important. Comment pouvons-nous tout remettre en arrière ? Après un certain temps, nous redémarrerons notre FW-CLUSTER. C'est l'équipement principal, pas de secours, il doit faire fonctionner le réseau.
Ressentez-vous comme les techniciens réseau commencent à s'énerver ? Le directeur technique entendra des milliers d'arguments sur pourquoi cela ne devrait pas être fait, pourquoi cela peut être fait plus tard. Malheureusement, c'est ainsi que le fonctionnement du réseau est constitué d'un tas de rustines, de morceaux, de vestiges d'un luxe passé. Cela ressemble à un patchwork. Notre objectif en général, pas dans cette situation particulière, mais en principe, en tant que spécialistes IT, est d'amener le fonctionnement du réseau à ce mot anglais magnifique « consistency », qui est très riche, et peut être traduit par : cohérence, non-contradiction, logique, coordination, systématicité, comparabilité, connectivité. Tout cela le concerne. Ce n'est qu'à cet état que le réseau est gérable, nous comprenons clairement ce qui fonctionne et comment cela fonctionne, nous savons exactement ce qu'il faut changer si nécessaire, nous savons exactement où regarder en cas de problème. Et ce n'est que dans un tel réseau que l'on peut réaliser des tours de magie, comme ceux que nous avons décrits.
En fait, un autre playbook a été préparé, qui ramenait les paramètres à leur état d'origine. Sa logique de fonctionnement est la même (il est important de se souvenir que l'ordre des tâches est très important), pour ne pas prolonger un article déjà assez long, nous avons décidé de ne pas publier le listing de l'exécution du playbook. En menant de telles manœuvres, vous vous sentirez beaucoup plus calme et confiant pour l'avenir, de plus, tous les bricolages que vous avez réalisés s'identifieront immédiatement.
Tous ceux qui le souhaitent peuvent nous écrire et obtenir les sources de tout le code écrit, ainsi que tous les playbooks. Les coordonnées sont dans le profil.
Conclusions
À notre avis, les processus susceptibles d'être automatisés ne se sont pas encore cristallisés. D'après ce que nous avons rencontré et ce que discutent nos collègues occidentaux, les thèmes suivants sont pour l'instant visibles :
- Provisionnement des périphériques ;
- Collecte de données ;
- Rapports ;
- Dépannage ;
- Conformité.
S'il y a de l'intérêt, nous pourrons continuer la discussion sur l'un des sujets proposés.
Nous aimerions aussi réfléchir un peu sur le thème de l'automatisation. Quelle devrait-elle être selon nous :
- Le système doit fonctionner sans intervention humaine, tout en étant amélioré par un humain. Le système ne doit pas dépendre d'une personne ;
- L'exploitation doit être experte. Il manque une classe de spécialistes effectuant des tâches routinières. Il y a des experts qui ont automatisé toute la routine et ne s'occupent que des tâches complexes ;
- Les tâches routinières et standards sont effectuées automatiquement « d'un simple clic », sans gaspiller de ressources. Le résultat de ces tâches est toujours prévisible et clair.
Et à quoi ces points doivent-ils mener :
- Transparence de l'infrastructure informatique (moins de risques d'exploitation, de modernisation, de mise en œuvre. Moins de temps d'arrêt par an) ;
- Capacité à planifier les ressources informatiques (système de planification de capacités — il est visible combien est consommé, combien de ressources sont nécessaires dans un système unique, et non par courriers et visites chez les responsables des départements) ;
- Possibilité de réduire le nombre de personnels informatiques de maintenance.
Auteurs de l'article : Alexandr Tchéléakov (CCIE RS, CCIE SP) et Pavel Kirilov. Nous sommes intéressés à discuter et à proposer des solutions sur le thème de l'automatisation de l'infrastructure informatique.
Source : habr.com
