

Note de traduction.: cette histoire instructive d'Omio — un agrégateur de voyages européen — guide les lecteurs de la théorie de base aux aspects pratiques captivants de la configuration de Kubernetes. Découvrir de tels cas aide non seulement à élargir ses horizons, mais aussi à prévenir des problèmes non triviaux.
Avez-vous déjà été confronté au fait qu'une application « se bloquait » sur place, cessait de répondre aux demandes de vérification de l'état (health checks) et que vous ne pouviez pas comprendre la raison d'un tel comportement ? L'une des explications possibles est liée à la limite de quota sur les ressources CPU. C'est ce dont nous allons parler dans cet article.
TL;DR :
Nous recommandons vivement d'éviter les limites de CPU dans Kubernetes (ou de désactiver les quotas CFS dans Kubelet), si vous utilisez une version du noyau Linux comportant un bogue de quotas CFS. Dans le noyau il existe un bogue sérieux et qui entraîne un throttling excessif et des retards.
Chez Omio toute notre infrastructure est gérée par Kubernetes. Tous nos workloads stateful et stateless fonctionnent exclusivement sur Kubernetes (nous utilisons Google Kubernetes Engine). Au cours des six derniers mois, nous avons commencé à observer des lenteurs aléatoires. Les applications se bloquent ou cessent de répondre aux health checks, perdent la connexion au réseau, etc. Ce comportement nous a longtemps mis dans l'impasse, et finalement, nous avons décidé de nous pencher sérieusement sur le problème.
Résumé de l'article :
- Quelques mots sur les conteneurs et Kubernetes ;
- Comment sont implémentées les demandes et les limites de CPU ;
- Comment la limite de CPU fonctionne dans les environnements à plusieurs cœurs ;
- Comment surveiller le throttling de CPU ;
- Solution du problème et nuances.
Quelques mots sur les conteneurs et Kubernetes
Kubernetes est essentiellement la norme moderne dans le monde de l'infrastructure. Sa tâche principale est l'orchestration des conteneurs.
Conteneurs
Par le passé, nous devions créer des artefacts tels que des JAR/WAR Java, des Egg Python ou des exécutables pour les lancer ultérieurement sur des serveurs. Cependant, pour les faire fonctionner, il fallait effectuer un travail supplémentaire : installer l'environnement d'exécution (Java/Python), placer les fichiers nécessaires au bon endroit, assurer la compatibilité avec une version spécifique du système d'exploitation, etc. En d'autres termes, il fallait prêter une attention particulière à la gestion des configurations (ce qui était souvent la source de conflits entre développeurs et administrateurs systèmes).
Les conteneurs ont tout changé. Maintenant, un artefact prend la forme d'une image de conteneur. On peut le considérer comme un fichier exécutable étendu, contenant non seulement le programme mais également un environnement d'exécution complet (Java/Python/etc.), ainsi que les fichiers/packages nécessaires, préinstallés et prêts à être lancés. Les conteneurs peuvent être déployés et exécutés sur différents serveurs sans aucune action supplémentaire.
De plus, les conteneurs fonctionnent dans leur propre environnement isolé. Ils disposent de leur propre adaptateur réseau virtuel, d'un système de fichiers avec un accès restreint, d'une hiérarchie de processus, de limitations sur le CPU et la mémoire, etc. Tout cela est réalisé grâce à une sous-système particulier du noyau Linux — les namespaces.
Kubernetes
Comme mentionné précédemment, Kubernetes est un orchestrateur de conteneurs. Son fonctionnement est le suivant : vous lui fournissez un pool de machines, puis vous dites : « Hé, Kubernetes, lance dix instances de mon conteneur avec 2 processeurs et 3 Go de mémoire chacune, et maintiens-les en état de marche ! ». Kubernetes s'occupe de tout le reste. Il trouvera les ressources disponibles, lancera les conteneurs et les redémarrera si nécessaire, appliquera des mises à jour lors des changements de version, etc. En gros, Kubernetes permet d'abstraire le matériel et rend la diversité des systèmes utilisable pour le déploiement et le fonctionnement des applications.
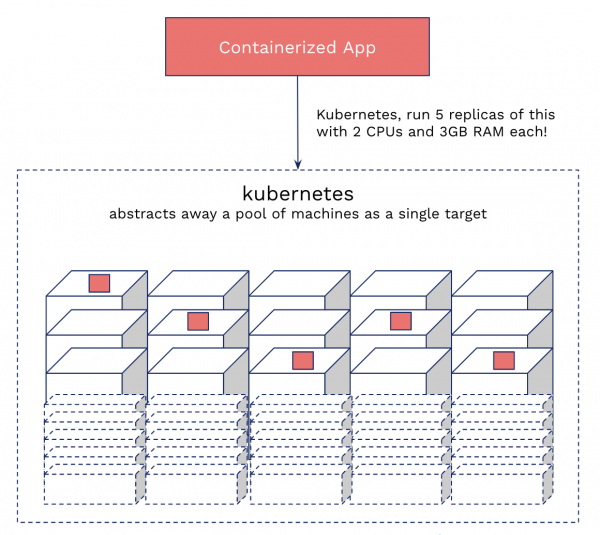
Kubernetes du point de vue d'un simple citoyen
Que sont les requêtes et les limites dans Kubernetes
D'accord, nous avons compris les conteneurs et Kubernetes. Nous savons également que plusieurs conteneurs peuvent se trouver sur une seule machine.
On peut faire une analogie avec un appartement communautaire. On prend un grand espace (machines/nœuds) et on le loue à plusieurs locataires (conteneurs). Kubernetes joue le rôle d'agent immobilier. La question se pose : comment empêcher les locataires de se disputer ? Que se passe-t-il si l'un d'eux, disons, décide d'occuper la salle de bains pendant une demi-journée ?
C'est ici qu'entrent en jeu les requêtes et les limites du CPU. Request Le CPU est uniquement utilisé pour la planification. C'est un peu comme une « liste de souhaits » du conteneur, utilisée pour sélectionner le nœud le plus adapté. En même temps, le CPU Limite peut être comparé à un contrat de location — une fois que nous avons trouvé un nœud pour le conteneur, celui-ci ne pourra pas dépasser les limites établies. Et c'est là que le problème se pose...
Comment les demandes et les limites sont-elles mises en œuvre dans Kubernetes
Kubernetes utilise un mécanisme de throttling intégré au noyau pour réaliser les limites de CPU. Si une application dépasse la limite, le throttling se met en place (c'est-à-dire qu'elle reçoit moins de cycles CPU). Les demandes et limites pour la mémoire sont organisées différemment, ce qui les rend plus faciles à détecter. Il suffit de vérifier le dernier statut de redémarrage du pod : n'est-il pas « OOMKilled ». Avec le throttling CPU, c'est un peu plus complexe, car K8s ne rend disponibles que les métriques d'utilisation, et non celles des cgroups.
Demande de CPU
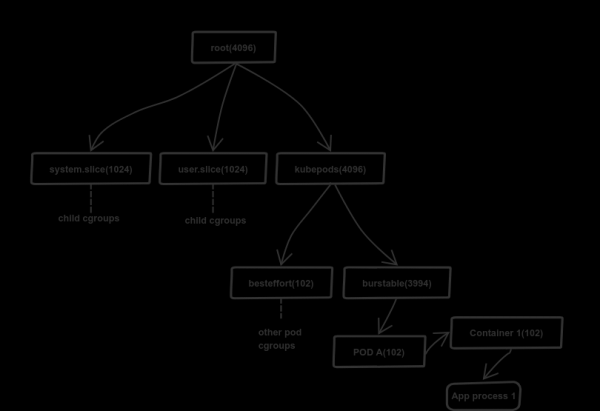
Comment est mise en œuvre la demande CPU
Pour simplifier, prenons un exemple avec une machine à CPU 4 cœurs.
K8s utilise le mécanisme des groupes de contrôle (cgroups) pour gérer la distribution des ressources (mémoire et processeur). Il existe un modèle hiérarchique : un enfant hérite des limites du groupe parent. Les détails de la distribution sont stockés dans un système de fichiers virtuel (/sys/fs/cgroup). Dans le cas du processeur, cela /sys/fs/cgroup/cpu,cpuacct/*.
K8s utilise le fichier cpu.share pour distribuer les ressources processeur. Dans notre cas, le groupe de contrôle racine reçoit 4096 parts de ressources CPU — 100% de la puissance CPU disponible (1 cœur = 1024 ; c'est une valeur fixe). Le groupe racine distribue les ressources de manière proportionnelle en fonction des parts des enfants, inscrites dans cpu.share, et ceux-ci, à leur tour, agissent de même avec leurs enfants, etc. Dans un nœud Kubernetes typique, le groupe de contrôle racine a trois enfants : system.slice, user.slice et kubepods. Les deux premiers sous-groupes sont utilisés pour distribuer les ressources entre les charges système critiques et les programmes utilisateur en dehors de K8s. Le dernier — kubepods — est créé par Kubernetes pour distribuer les ressources entre les pods.
Dans le schéma ci-dessus, on peut voir que le premier et le deuxième sous-groupe ont reçu chacun 1024 parts, tandis que le sous-groupe kubepod a été alloué 4096 parts. Comment cela est-il possible ? Après tout, le groupe racine a accès à un total de 4096 parts, et la somme des parts de ses enfants dépasse considérablement ce chiffre (6144) ? La raison en est que la valeur a un sens logique, et le planificateur Linux (CFS) l'utilise pour la distribution proportionnelle des ressources CPU. Dans notre cas, les deux premiers groupes reçoivent chacun 680 parts réels (16,6% de 4096), tandis que kubepod reçoit les parts restantes. 2736 En cas d'inactivité, les deux premiers groupes n'utiliseront pas les ressources allouées.
Heureusement, le planificateur dispose d'un mécanisme permettant d'éviter la perte de ressources CPU inutilisées. Il transfère les capacités « inactives » dans un pool global, à partir duquel elles sont réparties aux groupes nécessitant des ressources supplémentaires du processeur (le transfert se fait par lots pour éviter des pertes dues à l'arrondi). Une méthode similaire est appliquée à tous les descendants des descendants.
Ce mécanisme assure une répartition équitable des capacités du processeur et veille à ce qu'aucun processus ne « vole » de ressources aux autres.
Limite CPU
Bien que les configurations de limites et de demandes dans K8s semblent similaires, leur mise en œuvre diffère radicalement : c'est la partie la plus trompeuse et la moins documentée.
K8s utilise pour mettre en œuvre les limites. Leurs paramètres sont définis dans les fichiers cfs_period_us et cfs_quota_us dans le répertoire cgroup (le fichier se trouve également là) cpu.share).
Contrairement à cpu.share, la quota est basée sur une période de temps, et non sur la puissance du processeur disponible. cfs_period_us définit la durée de la période (époque) — c’est toujours 100000 μs (100 ms). Dans K8s, il est possible de changer cette valeur, mais cette option est encore disponible uniquement en version alpha. Le planificateur utilise l'époque pour redémarrer les quotas utilisés. Le deuxième fichier, cfs_quota_us, définit le temps disponible (quota) à chaque époque. Notez qu'il est également indiqué en microsecondes. La quota peut dépasser la durée de l'époque ; en d'autres termes, elle peut être supérieure à 100 ms.
Examinons deux scénarios sur des machines à 16 cœurs (le type d'ordinateur le plus courant chez nous chez Omio) :
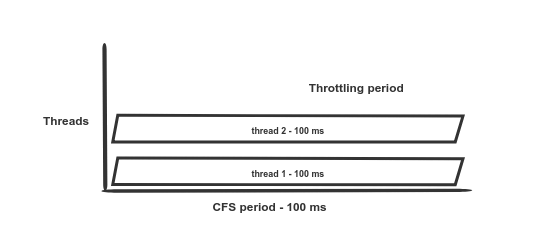
Scénario 1 : 2 flux et une limite de 200 ms. Sans throttling
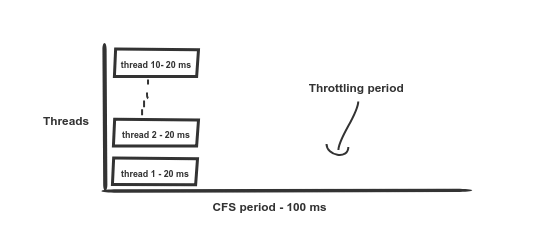
Scénario 2 : 10 flux et une limite de 200 ms. Le throttling commence après 20 ms, l'accès aux ressources du processeur est rétabli encore après 80 ms.
Supposons que vous ayez fixé une limite CPU à 2 cœurs ; Kubernetes convertira cette valeur en 200 ms. Cela signifie que le conteneur peut utiliser au maximum 200 ms de temps processeur sans throttling.
Et c'est là que ça devient intéressant. Comme mentionné ci-dessus, le quota disponible est de 200 ms. Si vous avez dix flux en parallèle sur une machine à 12 cœurs (voir l'illustration du scénario 2), tant que tous les autres pods sont inactifs, le quota sera épuisé en seulement 20 ms (puisque 10 * 20 ms = 200 ms), et tous les flux de ce pod seront « throttlés » (throttle) (limiter) sur les 80 ms suivants. La situation est aggravée par le déjà mentionné , qui provoque un throttling excessif et rend le conteneur incapable de consommer même sa propre quota.
Comment évaluer le throttling dans les pods ?
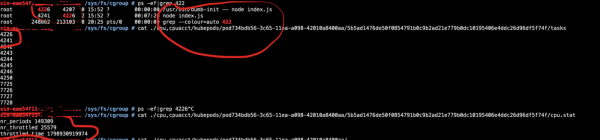
Il suffit d'entrer dans le pod et d'exécuter cat /sys/fs/cgroup/cpu/cpu.stat.
-
nr_periods— le nombre total de périodes du planificateur ; -
nr_throttled— le nombre de périodes throttlées parminr_periods; -
throttled_time— le temps total throttlé en nanosecondes.
Que se passe-t-il réellement ?
En fin de compte, nous avons un haut niveau de throttling dans toutes les applications. Parfois, il est une fois et demie plus fort que prévu !
Cela entraîne diverses erreurs — des échecs de vérification de disponibilité (readiness), des blocages de conteneurs, des interruptions de connexions réseau, des délais d'attente dans les appels de services. Au final, cela se traduit par une augmentation de la latence et du nombre d'erreurs.
Solutions et conséquences
C'est assez simple. Nous avons abandonné les limites de CPU et nous avons mis à jour le noyau du système d'exploitation dans nos clusters vers la version la plus récente, dans laquelle le bug a été corrigé. Le nombre d'erreurs (HTTP 5xx) dans nos services a immédiatement considérablement diminué :
Erreurs HTTP 5xx
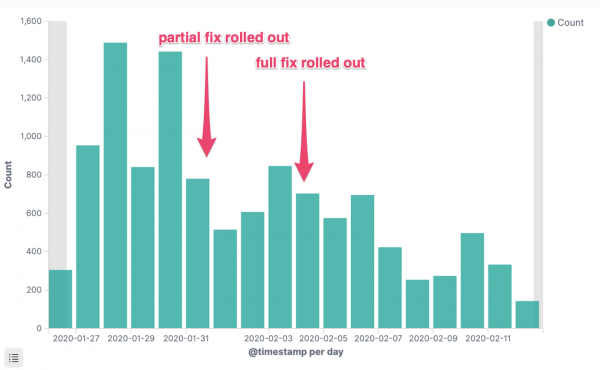
Erreurs HTTP 5xx d'un service critique
Temps de réponse p95
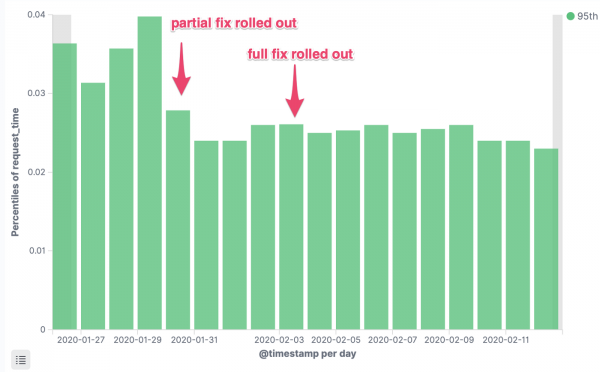
Latence des requêtes d'un service critique, 95e percentile
Coûts d'exploitation
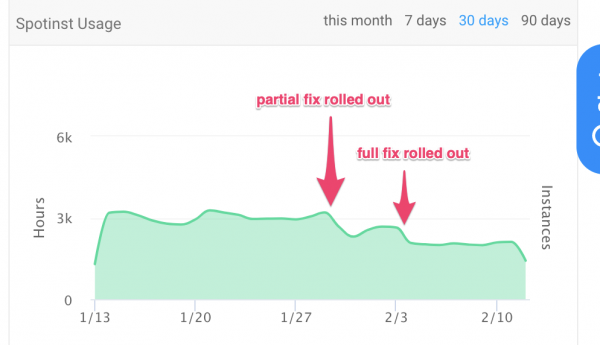
Nombre d'heures d'instance dépensées
Où est le piège ?
Comme mentionné au début de l'article :
On peut faire une analogie avec un appartement en colocation… Kubernetes joue le rôle de l'agent immobilier. Mais comment empêcher les colocataires de se disputer ? Que se passe-t-il si l'un d'eux décide, disons, d'occuper la salle de bain pendant une demi-journée ?
Voilà le piège. Un conteneur malveillant peut consommer toutes les ressources CPU disponibles sur la machine. Si vous avez une architecture applicative bien conçue (par exemple, avec des JVM, Go, Node VM correctement configurés), alors ce n'est pas un problème : on peut travailler dans ces conditions pendant une longue période. Mais si les applications sont mal optimisées ou pas du tout optimisées (FROM java:latest), la situation peut échapper à tout contrôle. Chez Omio, nous avons des Dockerfiles de base automatisés avec des configurations raisonnables par défaut pour les principaux langages, donc ce problème n'existait pas.
Nous recommandons de surveiller les métriques (utilisation, saturation et erreurs), délais API et fréquence des erreurs. Assurez-vous que les résultats correspondent à vos attentes.
Liens
Voici notre histoire. Les documents suivants ont grandement aidé à comprendre ce qui se passe :
- ;
- ;
- ;
- ;
- — recherchez « cpu throttling ».
Rapports d'erreurs Kubernetes :
- ;
- ;
- .
Avez-vous rencontré des problèmes similaires dans votre pratique ou avez-vous de l'expérience liée au throttling dans des environnements de production conteneurisés ? Partagez votre histoire dans les commentaires !
P.S. de l'auteur
Lisez aussi dans notre blog :
- «»;
- «»;
- «».
Source : habr.com
