

C'est exactement ce genre de plaintes que j'ai entendues de nos développeurs. L'aspect le plus intéressant est que cela s'est avéré vrai, initiant une longue enquête. Nous allons parler des serveurs SQL qui fonctionnent chez nous sur VMware.
En soi, obtenir que le serveur de production soit désespérément à la traîne par rapport au laptop est facile. Exécutez (ni sur tempdb ni sur la base avec Delayed Durability) le code :
set nocount on
create table _t (v varchar(100))
declare @n int=300000
while @n > 0 begin
  insert into _t select 'Quel chien de traîne !'
  delete from _t
  set @n=@n-1
  end
GO
drop table _t
Sur mon bureau, cela s'exécute en 5 secondes, alors que sur le serveur de production, cela prend 28 secondes. Parce que SQL doit attendre la fin physique de l'écriture dans le journal des transactions, alors que nous faisons ici des transactions très courtes. En gros, nous avons mis un gros camion puissant dans le trafic urbain et nous observons comment les livreurs de pizza sur scooters le doublent sans effort — ici, le throughput n'a pas d'importance, seule la latence compte. Et aucun stockage réseau, peu importe le prix, ne peut gagner en latence face à un SSD local.
(dans les commentaires, il s'est avéré que j'avais menti - j'ai eu Delayed Durability aux deux endroits. Sans Delayed Durability, cela donne :
Bureau — 39 secondes, 15K tr/s, 0,065 ms /io roundtrip
PROD — 360 secondes, 1600 tr/s, 0,6 ms
J'aurais dû faire attention, c'était inhabituellement rapide)
Cependant, dans ce cas, nous avons affaire à des zéros triviaux de cette fonction de Riemann avec un exemple trivial. Dans l'exemple que m'ont apporté les développeurs, c'était différent. J'ai vérifié qu'ils avaient raison et j'ai commencé à nettoyer l'exemple de toute leur spécificité liée à la logique métier. À un moment donné, j'ai compris que je pouvais entièrement jeter leur code et écrire le mien — qui montre exactement le même problème — dans la production, il s'exécute 3 à 4 fois plus lentement :
create function dbo.isPrime (@n bigint)
returns int
as
  begin
  if @n = 1 return 0
  if @n = 2 return 1
  if @n = 3 return 1
  if @n % 2 = 0 return 0
  declare @sq int
  set @sq = sqrt(@n)+1 -- check odds up to sqrt
  declare @dv int = 1
  while @dv < @sq
    begin
	set @dv=@dv+2
	if @n % @dv = 0 return 0
	end
  return 1
  end
GO
declare @dt datetime set @dt=getdate()
select dbo.isPrime(1000000000000037)
select datediff(ms,@dt,getdate()) as ms
GO
Si tout va bien, le test de primalité d'un nombre s'exécutera en 6-7-8 secondes. Cela a été le cas dans plusieurs serveurs. Mais sur certains, le test a pris 25-40 secondes. Ce qui est intéressant, c'est qu'il n'y avait pas de serveurs où l'exécution aurait duré, disons, 14 secondes — le code fonctionnait soit très rapidement, soit très lentement, donc le problème était, disons, noir ou blanc.
Qu'ai-je fait ? J'ai plongé dans les métriques VMware. Tout semblait en ordre : les ressources étaient en surplus, le temps d'attente = 0, tout était suffisant, pendant le test et sur les serveurs rapides comme lents, le CPU = 100 sur un vCPU. J'ai effectué un test de calcul du nombre Pi — les résultats étaient identiques sur tous les serveurs. L'odeur de magie noire devenait de plus en plus forte.
En sortant sur la ferme DEV, j'ai commencé à jouer avec les serveurs. Il s'est avéré que le vMotion d'un hôte à l'autre pouvait « guérir » un serveur, mais pouvait aussi, au contraire, transformer un serveur « rapide » en « lent ». Il semble que certains hôtes aient un problème… mais… non. Une machine virtuelle traînait sur l'hôte, disons A, mais fonctionnait rapidement sur l'hôte B. Et une autre machine virtuelle, au contraire, fonctionnait rapidement sur A et traînait sur B ! Sur l'hôte, il y avait souvent à la fois des machines « rapides » et « lentes » !
À partir de ce moment, une odeur sulfurique flottait dans l'air. Car le problème ne pouvait pas être attribué à une machine virtuelle (patches Windows, par exemple) — elle devenait « rapide » lors du vMotion. Mais le problème ne pouvait pas non plus être attribué à l'hôte — car il pouvait héberger à la fois des machines « rapides » et « lentes ». Cela n'avait également rien à voir avec la charge — j'ai réussi à obtenir une machine « lente » sur un hôte où il n'y avait rien d'autre que cette machine.
Dans un état de désespoir, j'ai lancé Process Explorer de Sysinternals et j'ai examiné la pile SQL. Sur les machines lentes, une ligne m'a tout de suite frappé :
ntoskrnl.exe!KeSynchronizeExecution+0x5bf6
ntoskrnl.exe!KeWaitForMultipleObjects+0x109d
ntoskrnl.exe!KeWaitForMultipleObjects+0xb3f
ntoskrnl.exe!KeWaitForSingleObject+0x377
ntoskrnl.exe!KeQuerySystemTimePrecise+0x881 < — !!!
ntoskrnl.exe!ObDereferenceObjectDeferDelete+0x28a
ntoskrnl.exe!KeSynchronizeExecution+0x2de2
sqllang.dll!CDiagThreadSafe::PxlvlReplace+0x1a20
… sautéé
sqldk.dll!SystemThread::MakeMiniSOSThread+0xa54
KERNEL32.DLL!BaseThreadInitThunk+0x14
ntdll.dll!RtlUserThreadStart+0x21
C'était déjà quelque chose. Un programme a été écrit :
    class Program
    {
        [DllImport("kernel32.dll")]
        static extern void GetSystemTimePreciseAsFileTime(out FILE_TIME lpSystemTimeAsFileTime);

        [StructLayout(LayoutKind.Sequential)]
        struct FILE_TIME
        {
            public int ftTimeLow;
            public int ftTimeHigh;
        }

        static void Main(string[] args)
        {
            for (int i = 0; i < 16; i++)
            {
                int counter = 0;

                var stopwatch = Stopwatch.StartNew();

                while (stopwatch.ElapsedMilliseconds  0)
                {
                    Console.WriteLine("{0}", counter);
                }
            }
        }
    }
Ce programme a montré un ralentissement encore plus marqué — sur les machines « rapides », il affiche 16 à 18 millions de cycles par seconde, tandis que sur les machines lentes, seulement un million et demi, voire 700 000. Soit une différence de 10 à 20 fois (!!!). C'était déjà une petite victoire : dans tous les cas, il n'y avait pas de risque de rester coincé entre le support de Microsoft et celui de VMware qui se renverrait la balle.
Ensuite, le progrès s'est arrêté — congés, affaires importantes, hystérie virale et augmentation brutale de la charge. J'ai souvent mentionné le problème magique à mes collègues, mais il m'a parfois semblé qu'ils ne me croyaient même pas — la déclaration selon laquelle VMware ralentissait le code de 10 à 20 fois était trop monstrueuse.
J'ai essayé de découvrir moi-même ce qui ralentissait. Par moments, j'avais l'impression d'avoir trouvé la solution — activer et désactiver les Hot plugs, changer la taille de la mémoire ou le nombre de processeurs transformait souvent la machine en « rapide ». Mais pas pour toujours. En revanche, ce qui s'est avéré vrai, c'est que suffirait de sortir et de frapper la roue — c'est-à-dire de modifier par n'importe qui le paramètre de la machine virtuelle
Enfin, mes collègues américains ont soudain trouvé la cause principale.
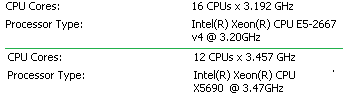
Les hôtes différaient par leur fréquence !
- En général, ce n'est pas grave. Mais : lors du transfert d'un hôte « natif » vers un hôte ayant une « autre » fréquence, VMware doit ajuster le résultat de GetTimePrecise.
- En général, cela ne pose pas de problème, sauf s'il s'avère qu'il y a des applications qui demandent l'heure précise des millions de fois par seconde, comme le serveur SQL.
- Mais cela ne pose même pas problème, car le serveur SQL ne fait pas ça tout le temps (voir Conclusion)
Mais il existe des cas où ces difficultés peuvent être douloureuses. Et oui, en frappant la roue (en changeant quelque chose dans les paramètres de la VM), je forçais VMware à 'recalculer' la configuration, et la fréquence de l'hôte actuel devenait la fréquence 'nativement' de la machine.
Solution
Lorsque vous désactivez la virtualisation du TSC, la lecture du TSC depuis la machine virtuelle renvoie la valeur TSC de la machine physique, et l'écriture du TSC depuis la machine virtuelle n'a aucun effet. La migration de la machine virtuelle vers un autre hôte, sa reprise de l'état suspendu ou son retour à un instantané provoque un saut discontinu du TSC. Certains systèmes d'exploitation invités échouent à démarrer ou présentent d'autres problèmes de gestion du temps lorsque la virtualisation du TSC est désactivée. Dans le passé, cette fonctionnalité était parfois recommandée pour améliorer les performances des applications qui lisent fréquemment le TSC., mais les performances du TSC virtuel ont été considérablement améliorées dans les produits actuels. Cette fonctionnalité a également été recommandée pour une utilisation lors de mesures nécessitant une source précise de temps réel dans la machine virtuelle.
En d'autres termes, il faut ajouter le paramètre
monitor_control.virtual_rdtsc = FALSE
Conclusion
Vous vous demandez sûrement : pourquoi appeler GetTimePrecise si souvent en SQL ?
Je n'ai pas le code source du serveur SQL, mais la logique dit ceci. SQL est presque un système d'exploitation avec une concurrence coopérative, où chaque thread doit, de temps en temps, "céder". Et où est-ce le mieux de le faire ? Là où il y a une attente naturelle — un verrou ou une E/S. D'accord, mais que se passe-t-il quand nous avons des boucles de calcul ? Dans ce cas, l'endroit évident et presque unique pour cela est dans l'interpréteur (ce n'est pas tout à fait un interpréteur), après l'exécution de la prochaine instruction.
En règle générale, le serveur SQL n'est pas utilisé pour des calculs purs, et ce n'est pas un problème. Mais les boucles utilisant divers tableaux temporaires (qui sont immédiatement mis en cache) transforment le code en une séquence d'instructions très rapides.
D'ailleurs, si vous encapsulez la fonction dans NATIVELY COMPILED, elle cesse de demander le temps, et sa vitesse augmente d'environ 10 fois. Qu'en est-il du multitâche coopératif ? C'est pour le code nativement compilé que SQL a dû introduire le MULTITASKING PRÉEMPTIF.
Source : habr.com
