

La mise en production d'une nouvelle version d'un projet nécessite un équilibre minutieux entre la rapidité de déploiement et la fiabilité de la solution. Chez Slack, nous valorisons les itérations rapides, les courts cycles de retour d'information et la réactivité face aux demandes des utilisateurs. De plus, l'entreprise dispose de centaines de programmeurs qui s'efforcent d'atteindre la productivité maximale.
Les auteurs de cet article, dont nous publions aujourd'hui la traduction, affirment qu'une entreprise qui souhaite adhérer à de telles valeurs tout en croissant doit constamment améliorer son système de déploiement de projets. Elle doit investir des efforts dans la transparence et la fiabilité des processus de travail, afin que ceux-ci soient adaptés à l'échelle du projet. Nous allons parler des processus de travail établis chez Slack et des solutions qui ont conduit l'entreprise à adopter le système actuel de déploiement de projets.
Comment fonctionnent aujourd'hui les processus de déploiement de projets
Chaque PR (pull request) chez Slack doit faire l'objet d'une révision de code et réussir tous les tests. Ce n'est qu'après avoir satisfait à ces conditions qu'un développeur peut fusionner son code avec la branche master du projet. Cependant, le déploiement de ce code n'a lieu que pendant les heures de travail selon l'heure de l'Amérique du Nord. En conséquence, nos employés étant présents sur leur lieu de travail, nous sommes entièrement prêts à résoudre tous les problèmes inattendus.
Chaque jour, nous effectuons environ 12 déploiements planifiés. Lors de chaque déploiement, le développeur désigné comme responsable veille à la mise en production de la nouvelle version. Il s'agit d'un processus en plusieurs étapes qui garantit un déploiement en douceur en mode opérationnel. Grâce à cette approche, nous pouvons détecter des erreurs avant qu'elles n'affectent tous nos utilisateurs. Si les problèmes sont trop nombreux, le déploiement peut être annulé. Si un problème spécifique est détecté après la publication, un correctif peut facilement être publié.
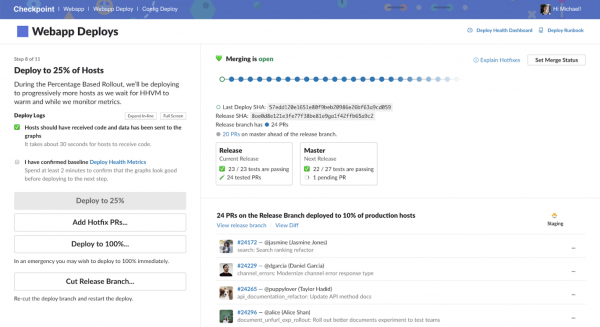
L'interface du système Checkpoint, utilisée chez Slack pour le déploiement de projets
Le processus de déploiement d'une nouvelle version en production peut être présenté comme composé de quatre étapes.
▍1. Création d'une branche de release
Chaque release commence par une nouvelle branche de release à partir d'un point de notre historique Git. Cela permet d'attribuer des étiquettes à la release et offre un espace où l'on peut apporter des corrections rapides pour les bugs identifiés lors de la préparation de la release pour la mise en production.
▍2. Déploiement dans un environnement intermédiaire
L'étape suivante consiste à déployer la build sur les serveurs intermédiaires (staging) et à lancer un test automatique pour vérifier la fonctionnalité générale du projet (smoke test). L'environnement intermédiaire est un environnement de production qui ne reçoit pas de trafic externe. Dans cet environnement, nous effectuons des tests manuels supplémentaires. Cela nous donne une confiance supplémentaire que le projet modifié fonctionne correctement. Les seuls tests automatisés ne suffisent pas pour obtenir une telle certitude.
▍3. Déploiement dans des environnements dogfood et canary
Le déploiement en production commence par l'environnement dogfood, constitué d'un ensemble d'hôtes qui gèrent nos espaces de travail internes Slack. Étant de fervents utilisateurs de Slack, cette approche nous a aidés à détecter de nombreuses erreurs à un stade précoce du déploiement. Après nous être assurés que les fonctionnalités de base du système ne sont pas compromises, nous procédons au déploiement de la build dans l'environnement canary. Cet environnement reçoit environ 2 % du trafic de production.
▍4. Mise en production progressive
Si les indicateurs de surveillance de la nouvelle version restent stables, et si nous ne recevons pas de plaintes après le déploiement du projet dans l'environnement canary, nous continuons à transférer progressivement les serveurs de production vers la nouvelle version. Le processus de déploiement est divisé en plusieurs étapes : 10 %, 25 %, 50 %, 75 % et 100 %. Cela nous permet de transférer lentement le trafic de production vers la nouvelle version du système, en ayant du temps pour analyser la situation en cas d'anomalies.
▍Que faire si quelque chose tourne mal lors du déploiement ?
Modifier le code comporte toujours des risques. Cependant, nous y faisons face grâce à la présence de nos « responsables de déploiement » bien formés, qui supervisent le processus de mise en production de nouvelles versions, surveillent les indicateurs de monitoring et coordonnent le travail des développeurs qui publient le code.
Dans le cas où quelque chose ne se passe pas comme prévu, nous essayons de détecter le problème le plus tôt possible. Nous examinons le problème, trouvons le PR qui cause des erreurs, le régressons, analysons minutieusement et créons un nouveau build. Il arrive cependant que le problème passe inaperçu jusqu'à la mise en production du projet. Dans une telle situation, l'essentiel est de rétablir le service. C'est pourquoi, avant de commencer l'analyse du problème, nous revenons immédiatement à la dernière version fonctionnelle.
Les briques du système de déploiement
Examinons les technologies qui sous-tendent notre système de déploiement de projets.
▍Déploiements rapides
Le processus de travail décrit ci-dessus peut sembler, avec du recul, complètement évident. Mais notre système de déploiement n'a pas atteint cette efficacité instantanément.
Lorsque l'entreprise était beaucoup plus petite, l'ensemble de notre application pouvait fonctionner sur 10 instances Amazon EC2. Déployer le projet dans cette situation impliquait d'utiliser rsync pour synchroniser rapidement tous les serveurs. Auparavant, un seul pas séparait le nouveau code de la production, ce qui se présentait sous la forme d'un environnement intermédiaire. Les builds étaient créés et vérifiés dans cet environnement, puis envoyaient directement en production. Comprendre ce système était très simple, il permettait à n'importe quel développeur de déployer son code à tout moment.
Mais à mesure que le nombre de nos clients augmentait, l'infrastructure nécessaire pour faire fonctionner le projet s'est également élargie. Rapidement, face à la croissance continue du système, notre modèle de déploiement, basé sur l'envoi de nouveau code vers les serveurs, a cessé de fonctionner. En effet, l'ajout de chaque nouveau serveur signifiait une augmentation du temps nécessaire pour réaliser le déploiement. Même les stratégies basées sur l'application parallèle de rsync ont leurs limitations.
Nous avons donc résolu ce problème en passant à un système de déploiement entièrement parallèle, conçu différemment de l'ancien système. En effet, nous n'envoyions plus le code sur les serveurs en utilisant un script de synchronisation. Chaque serveur charge désormais la nouvelle version de manière autonome, se rendant compte qu'il doit le faire grâce à l'observation du changement de clé Consul. Les serveurs chargeaient le code en parallèle. Cela nous a permis de maintenir une vitesse de déploiement élevée même dans une situation de croissance constante du système.
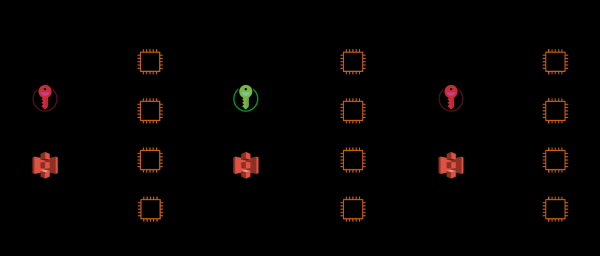
1. Les serveurs de production observent la clé Consul. 2. La clé change, ce qui informe les serveurs qu'ils doivent commencer à charger le nouveau code. 3. Les serveurs chargent les fichiers tarball contenant le code de l'application.
▍Déploiements atomiques
Une autre solution qui nous a permis d'atteindre un système de déploiement à plusieurs niveaux a été le déploiement atomique.
Avant d'utiliser des déploiements atomiques, chaque déploiement pouvait entraîner un grand nombre de messages d'erreur. En effet, le processus de copie des nouveaux fichiers sur les serveurs de production n'était pas atomique. Cela créait une courte période durant laquelle le code appelant les nouvelles fonctions était accessible avant que ces fonctions ne le soient. Lorsque ce code était appelé, il entraînait des erreurs internes. Cela se manifestait par des requêtes API échouées et des pages web "cassées".
L'équipe chargée de ce problème l'a résolu en introduisant les concepts de répertoires "chauds" (hot) et "froids" (cold). Le code dans le répertoire "chaud" traite le trafic de production. Dans les répertoires "froids", le code se prépare simplement à être utilisé pendant que le système fonctionne. Lors du déploiement, le nouveau code est copié dans un répertoire "froid" inutilisé. Ensuite, lorsque le serveur ne comporte plus de processus actifs, un basculement instantané des répertoires est effectué.
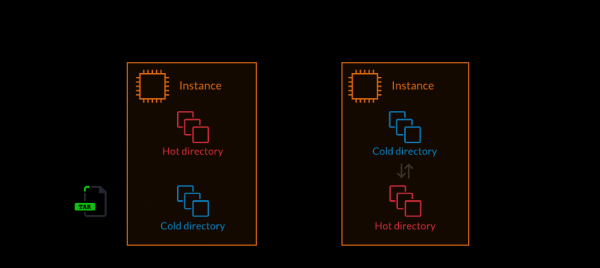
1. Décompression du code de l'application dans le répertoire "froid". 2. Basculement du système vers le répertoire "froid", qui devient "chaud" (opération atomique).
Résumé : un changement de focus vers la fiabilité.
En 2018, le projet a atteint une taille telle que le déploiement très rapide a commencé à nuire à la stabilité du produit. Nous avions un système de déploiement assez avancé, dans lequel nous avions investi beaucoup d'efforts et de temps. Nous devions simplement restructurer et améliorer les processus d'organisation du déploiement. Nous étions devenus une entreprise suffisamment importante, dont les développements étaient utilisés dans le monde entier pour assurer une communication ininterrompue et résoudre des problèmes cruciaux. C'est pourquoi la fiabilité est devenue notre priorité.
Nous devions rendre le processus de déploiement des nouvelles versions de Slack plus sécurisé. Ce besoin nous a conduits à améliorer notre système de déploiement. En effet, nous avons discuté de ce système perfectionné plus haut. Au sein du système, nous continuons à utiliser des technologies de déploiement rapide et atomique. Ce qui a changé, c'est la manière dont le déploiement est effectivement réalisé. Notre nouveau système est conçu pour exécuter progressivement le déploiement de nouveau code à différents niveaux et dans différents environnements. Nous utilisons désormais des outils de soutien et de surveillance du système plus avancés qu'auparavant. Cela nous permet d'identifier et de corriger les erreurs bien avant qu'elles n'aient une chance d'atteindre l'utilisateur final.
Mais nous ne comptons pas en rester là. Nous continuons à améliorer ce système en appliquant des outils de soutien et des moyens d'automatisation plus sophistiqués.
Chers lecteurs ! Comment se déroule le processus de déploiement des nouvelles versions de projets là où vous travaillez ?
Source : habr.com
