

Le rapport présente certaines approches permettant de surveiller les performances des requêtes SQL, lorsqu'il y en a des millions par jour,, et des serveurs PostgreSQL contrôlés - des centaines.
Quelles solutions techniques nous permettent de traiter efficacement un tel volume d'informations, et comment cela simplifie-t-il la vie des développeurs ordinaires.
À qui cela pourrait-il intéresser l'analyse de problèmes spécifiques et les différentes techniques d'optimisations des requêtes SQL et les solutions aux problèmes DBA typiques dans PostgreSQL - vous pouvez également à ce sujet.
Je m'appelle Kirill Borovikov, je représente . Plus précisément, je me spécialise dans le travail avec des bases de données dans notre entreprise.
Aujourd'hui, je vais vous expliquer comment nous optimisons les requêtes, lorsque vous devez non pas « déterrer » les performances d'une seule requête, mais résoudre le problème de manière massive. Quand il y a des millions de requêtes et que vous devez trouver quelques approches pour résoudre ce grand problème.
En fait, « Tensor » pour un million de nos clients, c'est : un réseau social d'entreprise, des solutions pour la vidéoconférence, pour la circulation des documents internes et externes, des systèmes de comptabilité et de gestion d'entrepôts,… C'est donc un « méga-combine » pour la gestion complète des affaires, avec plus de 100 projets internes différents.
Pour que tout cela fonctionne correctement et se développe - nous avons 10 centres de développement à travers le pays, avec plus de 1000 développeurs.
Nous travaillons avec PostgreSQL depuis 2008 et avons accumulé un grand volume de ce que nous traitons - ce sont des données client, des données statistiques, analytiques, provenant de systèmes d'information externes - plus de 400 To. Il y a environ 250 serveurs « en production », et au total, nous surveillons environ 1000 serveurs de bases de données.
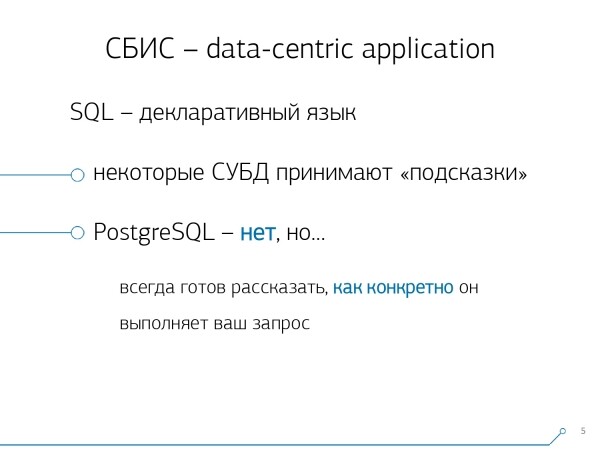
Le SQL est un langage déclaratif. Vous décrivez non pas « comment » quelque chose doit fonctionner, mais « ce que » vous voulez obtenir. La SGBD sait mieux comment faire un JOIN - comment relier vos tables, quelles conditions appliquer, ce qui passera par l'index, et ce qui ne le fera pas...
Certaines SGBD acceptent des suggestions : « Non, relie ces deux tables dans tel ordre », mais PostgreSQL ne sait pas faire cela. C'est une position délibérée des développeurs principaux : « Mieux vaut que nous améliorions l'optimiseur de requête que de permettre aux développeurs d'utiliser des hints quelconques ».
Cependant, bien que PostgreSQL n'offre pas de gestion « externe », il permet d'explorer ce qui se passe « en interne » lorsque vous exécutez votre requête, et où se trouvent ses problèmes.En général, quels problèmes classiques un développeur [vers le DBA] amène-t-il habituellement ? « Nous avons exécuté une requête, et
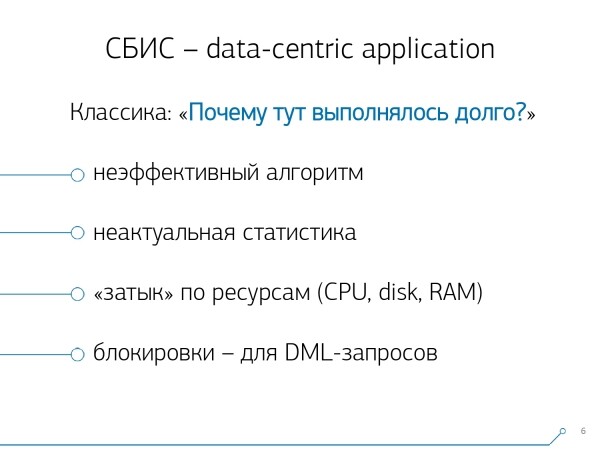
tout est lent , tout est bloqué, il se passe quelque chose… C'est la catastrophe ! »Les raisons sont presque toujours les mêmes :
un algorithme de requête inefficace
- Développeur : « Je fais actuellement un JOIN sur 10 tables dans le SQL... » — et s'attend à ce que ses conditions se « dénouent » de manière magique et qu'il obtienne tout rapidement. Mais il n'y a pas de miracles, et tout système, avec une telle variabilité (10 tables dans un FROM), présente toujours une certaine marge d'erreur. [
des statistiques obsolètes] - Ce point est particulièrement important pour PostgreSQL, lorsque vous avez « déversé » un grand ensemble de données sur le serveur, vous faites une requête — et celui-ci effectue une « scan séquentielle » sur la table. Parce qu'hier, il y avait 10 enregistrements, et aujourd'hui 10 millions, mais PostgreSQL n'est pas encore au courant, et il faut le lui signaler. [
un « goulot d'étranglement » au niveau des ressources] - Vous avez installé une grande base de données lourde sur un serveur faible, manquant d'espace disque, de mémoire et de puissance processeur. Et voilà… Il y a un seuil de performance au-delà duquel vous ne pouvez plus sauter.
Un point complexe, mais il est le plus pertinent pour diverses requêtes modifiant les données (INSERT, UPDATE, DELETE) — c'est un sujet distinct. - de blocage
Obtention du plan
… Et pour tout le reste, nous
avons besoin d'un plan ! Nous devons voir ce qui se passe à l'intérieur du serveur.Le plan d'exécution des requêtes pour PostgreSQL est un arbre représentant l'algorithme d'exécution de la requête sous forme textuelle. C'est justement cet algorithme qui a été reconnu comme le plus efficace suite à l'analyse effectuée par le planificateur.
Chaque nœud de l'arbre représente une opération : extraction de données d'une table ou d'un index, construction d'une carte binaire, jointure de deux tables, union, intersection ou exclusion de jeux de résultats. L'exécution de la requête consiste à parcourir les nœuds de cet arbre.
Pour obtenir un plan de requête, le moyen le plus simple est d'exécuter l'instruction
EXPLAIN . Pour obtenir tous les attributs réels, c'est-à-dire exécuter réellement la requête sur la base —EXPLAIN (ANALYZE, BUFFERS) SELECT ... EXPLAIN (ANALYZE, BUFFERS) SELECT ....
Mauvais moment : lorsque vous l'exécutez, cela se passe « ici et maintenant », donc c'est uniquement adapté pour le débogage local. Si vous prenez un serveur très chargé, qui subit un fort flux de modifications de données, et que vous voyez : « Aïe ! Voici un point où cela s'exécute lentement.se la requête. » Une demi-heure, une heure auparavant — pendant que vous couriez et que vous récupériez cette requête dans les journaux, la statistique de votre ensemble de données avait complètement changé. Vous l'exécutez pour le débogage — et elle s'exécute rapidement ! Et vous ne pouvez pas comprendre « pourquoi », pourquoi c'était lent.
Pour comprendre ce qui se passait exactement au moment où la requête est exécutée sur le serveur, des esprits éclairés ont écrit . Il est présent dans presque toutes les distributions les plus courantes de PostgreSQL et peut simplement être activé dans le fichier de configuration.
S'il comprend qu'une requête s'exécute au-delà de la limite que vous lui avez donnée, il fait un « instantané » du plan de cette requête et l'écrit avec les logs..
Tout semble bien maintenant, nous allons dans le log et voyons là… [portée de texte]. Mais nous ne pouvons rien dire à ce sujet, à part le fait que c'est un excellent plan, car il s'est exécuté en 11ms.
Tout semble bien — mais rien n'est clair sur ce qui se passait réellement. Hormis le temps général, nous ne voyons pas grand-chose. Parce que regarder un tel « texte brut » n'est pas du tout visuel.
Mais même si ce n'est pas visuel, en effet peu pratique, il y a des problèmes plus fondamentaux :
- Dans le nœud, est indiquée la somme des ressources de tout l'arbre sous-jacent en dessous. Donc, il n'est pas possible de simplement savoir combien de temps a été consacré ici spécifiquement sur cet Index Scan — si en dessous il y a une condition imbriquée. Nous devons vérifier dynamiquement s'il y a des « enfants » et des variables conditionnelles, CTE — et déduire tout cela « dans notre tête ».
- Deuxième point : le temps indiqué dans le nœud — c'est le temps d'exécution unique du nœud.Si ce nœud a été exécuté en conséquence, par exemple, d'une boucle sur les enregistrements d'une table, plusieurs fois, alors dans le plan augmente le nombre de boucles — cycles de ce nœud. Mais le temps d'exécution atomique reste le même dans le plan. Donc, pour comprendre combien de temps ce nœud a été exécuté au total, il faut multiplier un par l'autre — encore une fois « dans notre tête ».
Dans de telles conditions, comprendre « Qui est le maillon faible ? » est pratiquement impossible. C'est pourquoi même les développeurs eux-mêmes écrivent dans le « manuel » que « Comprendre le plan est un art qui s'apprend, c'est une expérience... ».
Mais nous avons 1000 développeurs, et on ne peut pas transmettre cette expérience à chacun d'eux. Moi, toi, lui — savent, mais quelqu'un là-bas — ne sait pas. Peut-être qu'il va apprendre, ou peut-être pas, mais il doit déjà travailler — alors d'où pourrait-il obtenir cette expérience.
Visualisation du plan
C'est pourquoi nous avons compris que pour résoudre ces problèmes, nous avons besoin d'une bonne visualisation du plan.
Nous avons d'abord « exploré le marché » — allons chercher sur Internet ce qui existe.
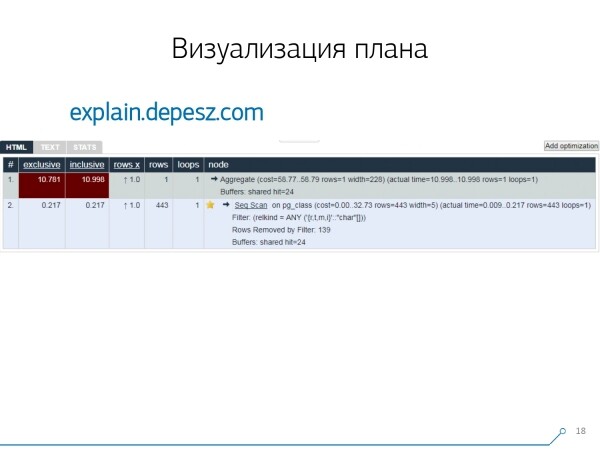
Mais, il s'est avéré qu'il y a très peu de solutions « vivantes », qui se développent plus ou moins — littéralement, une seule : de Hubert Lubaczewski. Dans le champ d'entrée, tu « alimenes » une représentation textuelle du plan, et il te montre un tableau avec les données analysées :
- le temps d'exécution propre au nœud
- le temps total pour tout le sous-arbre
- le nombre d'enregistrements qui ont été extraits et qui étaient statistiquement attendus
- le corps même du nœud
Ce service a également la possibilité de partager un archive de liens. Tu y mets ton plan et dis : « Hé, Vasya, voici le lien, quelque chose ne va pas là-bas ».
Mais il y a aussi quelques petits problèmes.
Tout d'abord, une quantité énorme de « copiés-collés ». Tu prends un morceau de log, tu le mets ici, encore, et encore.
Deuxièmement, il n'y a pas d'analyse du nombre de données lues — ces fameux buffers, qui sont affichés par EXPLAIN (ANALYZE, BUFFERS), là, nous ne les voyons pas. Il ne sait tout simplement pas les analyser, comprendre et travailler avec. Quand tu lis beaucoup de données et comprends que tu peux mal « te répartir » sur le disque et le cache en mémoire, cette information est très importante.
Le troisième point négatif — le développement de ce projet est très faible. Les commits sont très petits, à peine une fois par semestre, et le code est en Perl.
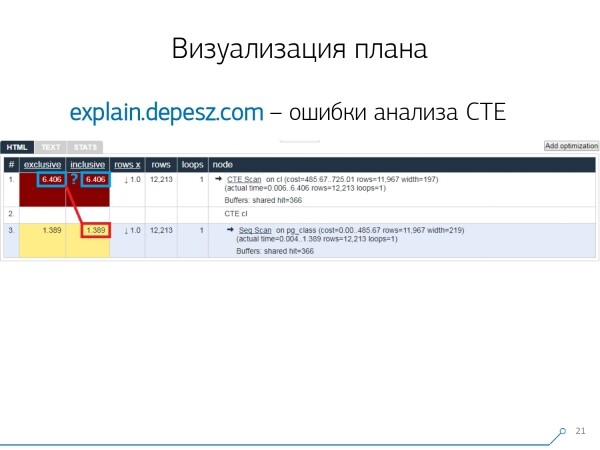
Mais tout cela est « lyrique », on pourrait vivre avec ça d'une certaine manière, mais il y a une chose qui nous a fortement éloignés de ce service. Ce sont les erreurs d'analyse des Common Table Expressions (CTE) et des différents nœuds dynamiques comme InitPlan/SubPlan.
Si l'on croit cette image, alors le temps total d'exécution de chaque nœud individuel est supérieur au temps total d'exécution de toute la requête. C'est simple — nous n'avons pas soustrait le temps de génération de ce CTE du nœud CTE Scan.. Donc, nous ne savons plus combien de temps a réellement pris le scan CTE.
Ici, nous avons compris qu'il était temps d'écrire le nôtre - youpi ! Chaque développeur dit : « Maintenant, nous allons écrire le nôtre, ce sera super simple ! »
Nous avons pris une pile typique pour les services web : le noyau en Node.js + Express, ajouté Bootstrap et pour des beaux diagrammes - D3.js. Et nos attentes ont totalement été satisfaites - nous avons obtenu le premier prototype en 2 semaines :
- notre propre parseur de plan
C'est-à-dire que désormais nous pouvons analyser n'importe quel plan généré par PostgreSQL. - analyse correcte des nœuds dynamiques — CTE Scan, InitPlan, SubPlan
- analyse de la distribution des buffers — où les pages de données sont lues de la mémoire, où depuis le cache local, où depuis le disque
- nous avons obtenu une clarté
Pour ne pas avoir à « creuser » cela dans les logs, mais pour voir « le point faible » directement sur l'image.
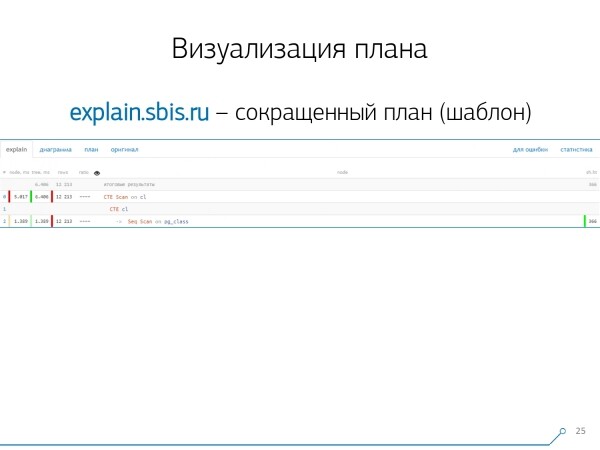
Nous avons obtenu une image similaire — directement avec la mise en évidence de la syntaxe. Mais en général, nos développeurs n travaillent pas avec la présentation complète du plan, mais avec une version plus courte. En effet, tous les chiffres ont déjà été analysés et nous les avons mis de côté, ne laissant que la première ligne, indiquant quel nœud il s'agit : CTE Scan, génération CTE ou Seq Scan pour une certaine table.
Cette version abrégée, nous l'appelons modèle de plan.
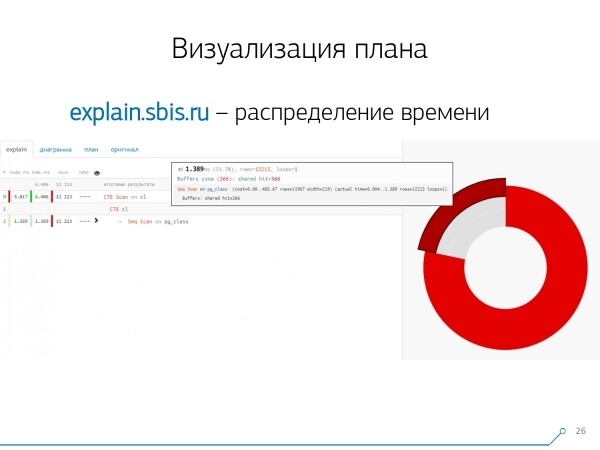
Quoi d'autre serait pratique ? Il serait utile de voir quelle part de temps total est attribuée à chaque nœud - et nous l'avons simplement « collé » sur le côté diagramme circulaire.
Nous survolons le nœud et voyons - en fait, Seq Scan a pris moins d'un quart du temps total, tandis que les 3/4 restants étaient pour CTE Scan. Horrible ! C'est une petite remarque concernant la « rapidité » de CTE Scan, si vous les utilisez activement dans vos requêtes. Ils ne sont pas très rapides - ils sont même plus lents qu'un scan de table normal.
Mais ces diagrammes sont généralement plus intéressants et plus complexes, lorsque nous survolons un segment et voyons, par exemple, que plus de la moitié de tout le temps a été « absorbé » par un certain Seq Scan. Et encore à l'intérieur, il y avait un filtre, un tas d'enregistrements ont été rejetés par celui-ci... On peut directement envoyer cette image au développeur en disant : « Vasya, ici tout va très mal ! Regarde, il y a quelque chose qui ne va pas ! »
Naturellement, sans « couacs », cela ne s'est pas fait.
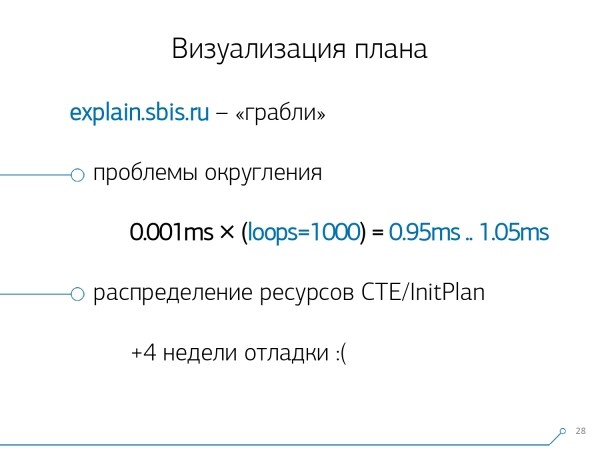
La première chose sur laquelle nous avons "buté" est le problème d'arrondi. Le temps d'un nœud dans chaque plan est indiqué avec une précision de 1µs. Et lorsque le nombre de cycles d'un nœud dépasse, par exemple, 1000 — après exécution, PostgreSQL a divisé "avec précision", donc dans le calcul inverse, nous obtenons un temps total "quelque part entre 0,95 ms et 1,05 ms". Quand on parle de microsecondes, cela va encore, mais quand cela atteint les [millis]secondes — il faut prendre en compte cette information lors de la "démêlage" des ressources par nœud dans le plan "qui a consommé combien".
Le deuxième point, plus complexe, est la distribution des ressources (ces fameux buffers) entre les nœuds dynamiques. Cela nous a coûté environ 4 semaines supplémentaires au cours des 2 premières semaines sur le prototype.
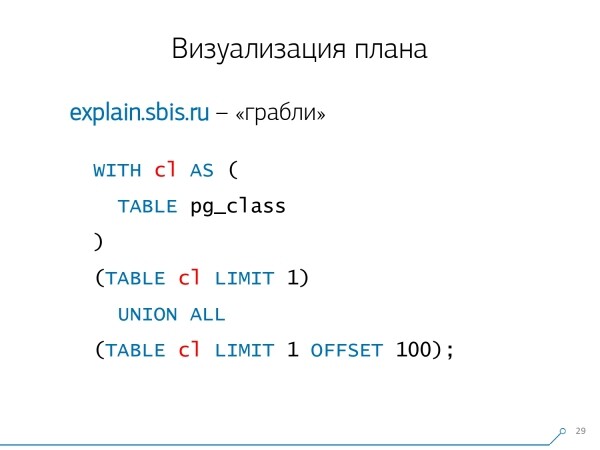
Le problème est assez simple à obtenir — nous faisons un CTE et y lisons soi-disant quelque chose. En réalité, PostgreSQL est "intelligent" et ne lira rien directement là-bas. Ensuite, nous prenons le premier enregistrement, et celui-ci — le cent-unième du même CTE.
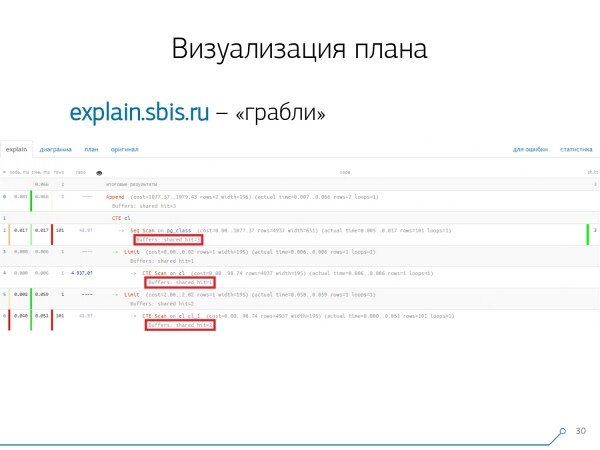
Nous examinons le plan et comprenons — c'est étrange, nous avons consommé 3 buffers (pages de données) dans Seq Scan, 1 dans CTE Scan, et encore 2 dans le second CTE Scan. Donc si nous additionnons simplement, nous pourrions obtenir 6, mais nous n'avons en fait lu que 3 depuis la table ! CTE Scan ne lit rien d'ailleurs, mais travaille directement avec la mémoire du processus. Donc ici, il y a clairement quelque chose qui cloche !
En réalité, il s'avère que ces 3 pages de données, qui ont été demandées par Seq Scan, ont d'abord été demandées par le premier CTE Scan, puis le second, et ce dernier a encore demandé 2 de plus. Donc au total, seulement 3 pages de données ont été lues, et non 6.
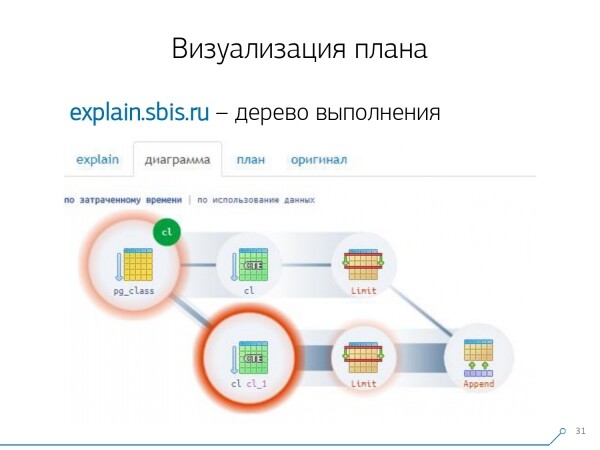
Et cette image nous a conduits à comprendre que l'exécution d'un plan n'est plus un arbre, mais simplement un graphique acyclique. Et nous avons obtenu un diagramme à peu près comme celui-ci, afin de comprendre "d'où vient quoi". Donc ici, nous avons créé un CTE à partir de pg_class, et l'avons demandé deux fois, et presque tout notre temps s'est écoulé sur la branche où nous l'avons demandé la deuxième fois. Évidemment, lire la 101e entrée est beaucoup plus coûteux que de lire simplement la première depuis la table.

Nous avons respiré un instant. Nous avons dit : "Maintenant, Neo, tu sais le kung-fu ! Maintenant, notre expérience est directement sur ton écran. Tu peux maintenant l'utiliser."
Consolidation des logs
Nos 1000 développeurs ont poussé un soupir de soulagement. Mais nous comprenions que nous n'avions que des centaines de serveurs « opérationnels », et que tout ce « copier-coller » de la part des développeurs n'est vraiment pas pratique. Nous avons réalisé qu'il fallait rassembler cela nous-mêmes.
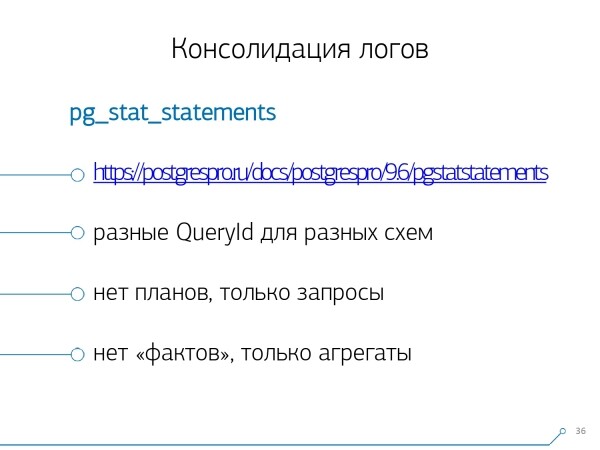
En fait, il existe un module standard qui peut collecter des statistiques, mais il doit également être activé dans la configuration — c'est . Mais cela ne nous a pas convenu.
Premièrement, ce module attribue des QueryId différentsaux mêmes requêtes selon différents schémas au sein d'une même base. Donc, si je commence par SET search_path = '01'; SELECT * FROM user LIMIT 1;, puis SET search_path = '02'; et la même requête, alors dans les statistiques de ce module, il y aura des enregistrements différents, et je ne pourrai pas collecter de statistiques globales précisément en fonction de ce profil de requête, sans tenir compte des schémas.
Deuxième point qui a empêché son utilisation — l'absence de plans. C'est-à-dire qu'il n'y a pas de plan — il n'y a que la requête elle-même. Nous voyons ce qui a ralenti, mais nous ne comprenons pas pourquoi. Et là, nous revenons au problème du jeu de données en rapide évolution.
Et le dernier point — l'absence de « faits ». Il n'est pas possible de faire référence à une instance spécifique de l'exécution d'une requête — elle n'existe pas, il n'y a que des statistiques agrégées. On peut y travailler, mais c'est juste très difficile.
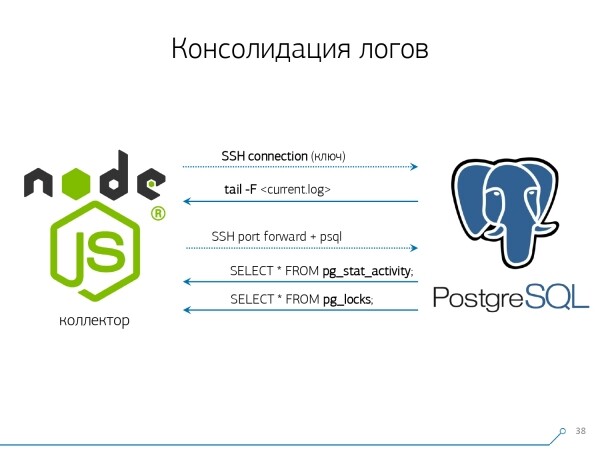
C'est pourquoi nous avons décidé de lutter contre le « copier-coller » et de commencer à écrire un collecteur.
. Le collecteur se connecte via SSH, crée une connexion protégée jusqu'au serveur de la base grâce à un certificat et tail -F s'accroche à son fichier log. Ainsi, dans cette session nous obtenons un miroir complet de tout le fichier log, qui est généré par le serveur. La charge sur le serveur lui-même est minimale, car nous ne faisons rien d'autre que de miroiter le trafic.
Puisque nous avons déjà commencé à écrire l'interface en Node.js, nous avons également continué à écrire le collecteur dessus. Et cette technologie s'est révélée efficace, car pour travailler avec des données textuelles mal formatées, comme celles des logs, il est très pratique d'utiliser JavaScript. Et l'infrastructure Node.js en tant que plateforme backend permet de travailler facilement et confortablement avec des connexions réseau, ainsi que sur divers flux de données.
Ainsi, nous "établissons" deux connexions : la première pour "écouter" le log et le récupérer, et la seconde pour interroger périodiquement la base. "Eh bien, le log a enregistré qu'une table avec l'oid 123 a été bloquée", mais cela ne dit rien au développeur, et il serait bon de demander à la base "Qu'est-ce que c'est que OID = 123 ?" Et ainsi nous interrogeons périodiquement la base sur ce que nous ne savons pas encore.
"Il n'y a qu'une chose que tu n'as pas prise en compte, il existe une espèce d'abeilles ressemblant à des éléphants..." Nous avons commencé à développer ce système lorsque nous voulions surveiller 10 serveurs. Les plus critiques selon notre compréhension, où des problèmes surgissaient, et qui étaient difficiles à gérer. Mais dès le premier trimestre, nous avons obtenu des centaines de serveurs à surveiller — car le système a été adopté, tout le monde en a voulu, tout le monde a trouvé cela pratique.
Tout cela doit être accumulé, il y a un grand flux de données, actif. En gros, ce que nous surveillons, sur quoi nous sommes capables d'agir — c'est ce que nous utilisons. Nous utilisons également PostgreSQL comme entrepôt de données. Et rien n'est plus rapide pour "injecter" des données que l'opérateur COPY pas encore.
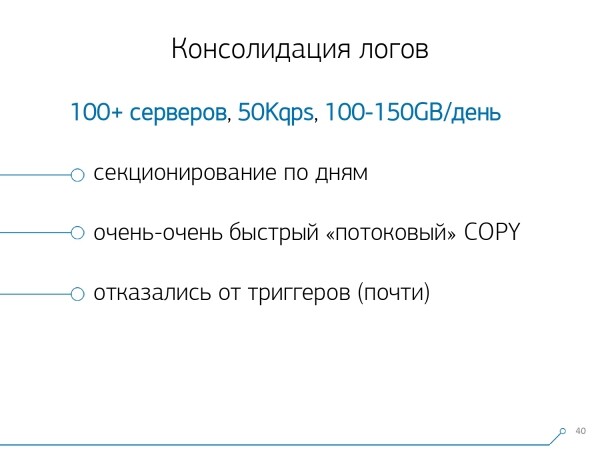
Mais simplement "injecter" des données — ce n'est pas tout à fait notre technologie. Parce que si vous avez une centaine de serveurs, générant environ 50k requêtes par seconde, cela vous produit 100-150 Go de logs par jour. Donc, nous avons dû façonner la base avec précaution.
Tout d'abord, nous avons créé un partitionnement par jours, parce qu'au fond, personne ne s'intéresse à la corrélation entre les jours. Quelle différence cela fait-il ce qui s'est passé hier, si cette nuit vous avez déployé une nouvelle version de l'application — et déjà une nouvelle statistique.
Deuxièmement, nous avons appris (nous avons dû) à écrire très très rapidement à l'aide de COPY. C’est-à-dire pas seulement COPY, parce qu'il est plus rapide que INSERT, mais encore plus rapide.
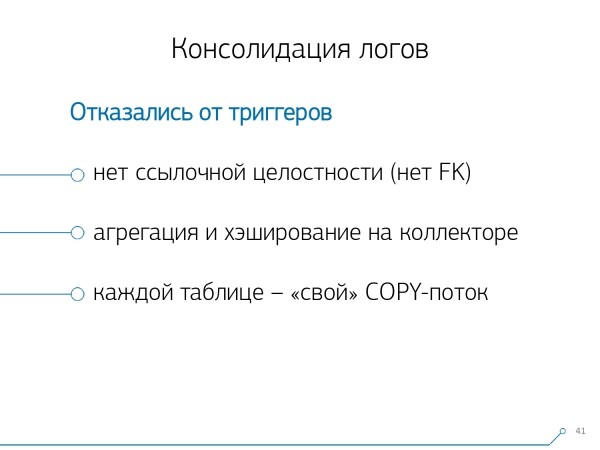
Troisième point — nous avons dû renoncer aux triggers, donc aux clés étrangères. Cela signifie que nous n’avons pas de cohérence référentielle du tout. Parce que si vous avez une table avec une paire de FK, et que vous dites dans la structure de la base de données que "cette entrée dans le log fait référence par FK, par exemple, à un groupe d'entrées", alors quand vous insérez, PostgreSQL n'a d'autre choix que de prendre et d'exécuter honnêtement SELECT 1 FROM master_fk1_table WHERE ... avec l'identifiant que vous essayez d'insérer — juste pour vérifier que cette entrée est présente, que vous ne "brisez" pas cette clé étrangère avec votre insertion.
Nous recevons, au lieu d'un seul enregistrement dans la table cible et de ses index, un plus de lecture dans toutes les tables auxquelles il fait référence. Et cela ne nous est pas du tout nécessaire — notre objectif est d'écrire le plus possible et le plus rapidement avec le minimum de charge. Donc, FK — dehors !
Le point suivant — l'agrégation et le hachage. Au départ, nous les avons réalisés dans la base de données — car c'est pratique de pouvoir, dès qu'un enregistrement arrive, le faire dans une certaine table. « plus un » directement dans le trigger.. Bien, pratique, mais mauvais en même temps — vous insérez un enregistrement et vous devez encore lire et écrire quelque chose d'une autre table. De plus, non seulement vous devez lire et écrire, mais encore le faire à chaque fois.
Et maintenant, imaginez que vous avez une table dans laquelle vous vous contentez de compter le nombre de requêtes passées par un hôte spécifique : +1, +1, +1, ..., +1. Et cela ne vous est pas vraiment nécessaire — tout cela peut être sommé en mémoire sur le collecteur et envoyé à la base en une fois. +10.
Oui, dans le cas de problèmes, votre intégrité logique peut « s'effondrer », mais c'est pratiquement un cas irréel — parce que vous avez un serveur normal, avec une batterie dans le contrôleur, vous avez un journal des transactions, un journal sur le système de fichiers… En gros, ça n'en vaut pas la peine. La perte de performance que vous subissez à cause du travail des triggers/FK, les frais associés, ne valent pas ce prix.
Il en va de même pour le hachage. Une certaine requête arrive à vous, vous calculez dans la base un certain identifiant, vous l'écrivez dans la base et ensuite vous le communiquez à tous. Tout va bien, jusqu'à ce qu'à l'instant de l'écriture, vous ayez un deuxième souhaitant écrire le même identifiant — et vous aurez un blocage, ce qui est déjà mauvais. Donc, si vous pouvez déplacer la génération de certains ID vers le client (relativement à la base), il est préférable de le faire.
Il nous a simplement parfaitement convenu d'utiliser MD5 du texte — de la requête, du plan, du modèle,… Nous le calculons du côté du collecteur et « l'injectons » dans la base déjà sous forme d'ID prêt à l'emploi. La longueur de MD5 et le partitionnement journalier nous permettent de ne pas nous soucier des colisions potentielles.
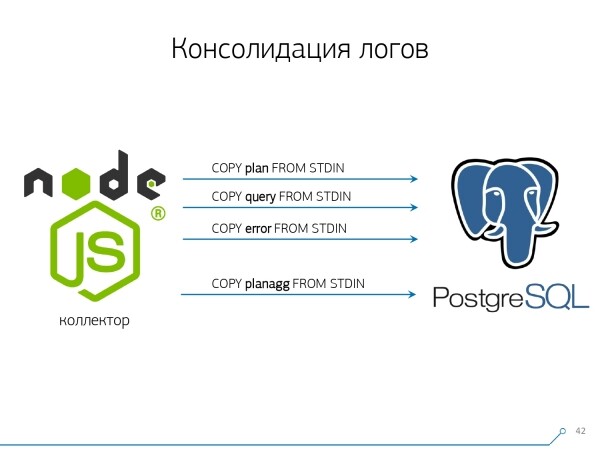
Mais pour tout cela soit enregistré rapidement, nous avons dû modifier la procédure d'enregistrement elle-même.
Comment les données sont-elles généralement écrites ? Nous avons un ensemble de données, nous le répartissons sur plusieurs tables, puis nous effectuons un COPY — d'abord dans la première, puis dans la deuxième, puis dans la troisième… Ce n'est pas pratique, car nous semblons écrire un flux de données en trois étapes consécutives. Pas agréable. Est-il possible d'accélérer cela ? Oui !
Pour cela, il suffit de faire passer ces flux en parallèle. Ainsi, nous avons des erreurs, des requêtes, des modèles, des blocages qui circulent dans des flux distincts,… — et nous écrivons tout cela en parallèle. Pour cela, il suffit de maintenir un canal COPY constamment ouvert pour chaque table cible distincte.
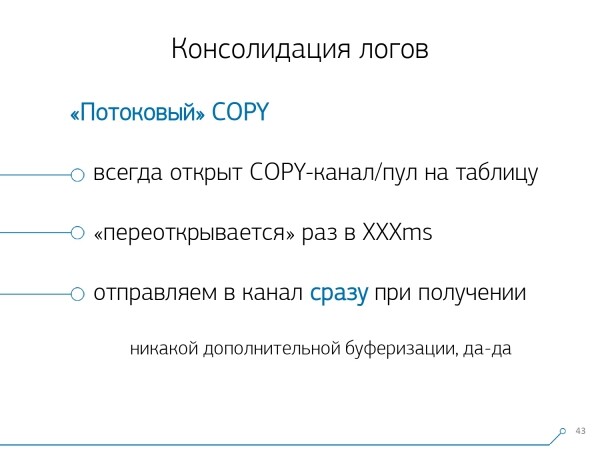
C'est-à-dire que le collecteur a toujours un flux, dans lequel je peux écrire les données dont j'ai besoin. Mais pour que la base voie ces données, sans que quelqu'un ne soit bloqué en attendant que ces données soient écrites, il faut interrompre le COPY à intervalles réguliers. Pour nous, le délai le plus efficace s'est avéré être d'environ 100 ms — nous fermons et rouvrons immédiatement la même table. Et si nous avons besoin de plus d'un flux pendant certains pics, nous faisons un poll jusqu'à un certain seuil.
De plus, nous avons découvert que pour ce type de profil de charge, toute agrégation, lorsqu'enregistrements sont regroupés par paquets, est nuisible. Le mal classique est INSERT ... VALUES et ensuite 1000 enregistrements. Car à ce moment-là, vous atteignez un pic d'écriture sur le support, et tous les autres qui tentent d'écrire sur le disque devront attendre.
Pour éviter de telles anomalies, il suffit de ne rien agréger, de ne pas tamponner du tout. Et si un tampon sur le disque se produit quand même (heureusement, le Stream API dans Node.js permet de le savoir) — retarde cette connexion. Quand vous recevez l'événement qu'elle est de nouveau libre — écrivez-y depuis la file d'attente accumulée. Pendant qu'elle est occupée — prenez le suivant, qui est libre et écrivez y.
Avant la mise en œuvre de cette approche pour l'écriture des données, nous avions environ 4000 opérations d'écriture, et grâce à cette méthode, nous avons réduit la charge par quatre. Maintenant, nous avons encore augmenté notre capacité de six fois grâce aux nouvelles bases observables — jusqu'à 100 Mo/s. Et maintenant, nous stockons les journaux des trois derniers mois dans un volume d'environ 10-15 To, en espérant que pendant trois mois, tout problème pourra être résolu par n'importe quel développeur.
Nous comprenons les problèmes
Mais rassembler toutes ces données — c'est bien, utile et pertinent, mais insuffisant — il faut les comprendre. Parce que ce sont des millions de différents plans par jour.
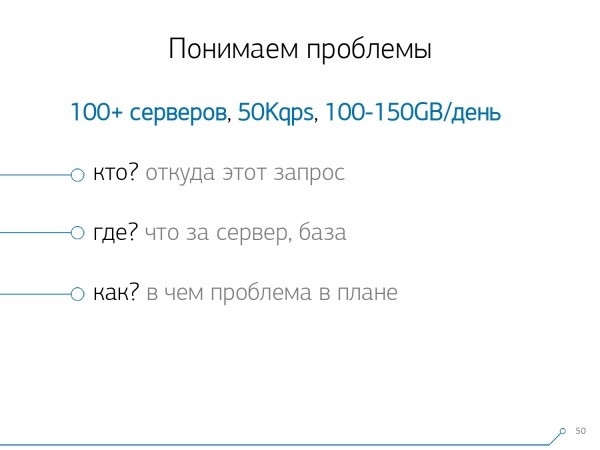
Mais des millions, c'est ingérable, il faut d'abord réduire à « moins ». Et, en premier lieu, il faut décider comment vous allez organiser ce « moins ».
Nous avons identifié trois points clés :
- qui Cette requête a été envoyée par
C'est-à-dire de quelle application elle "est venue": interface web, backend, système de paiement ou autre. - où cela s'est produit
Sur quel serveur précis. Parce que si vous avez plusieurs serveurs pour une même application, et qu’un d’eux subit soudainement un problème (parce que « le disque est mort », « la mémoire a fuit », ou autre problème), il faut cibler précisément le serveur. - comment la problématique se manifestait dans tel ou tel plan
Pour comprendre « qui » nous a envoyé la requête, nous utilisons un outil standard — avec l'installation d'une variable de session : SET application_name = '{bl-host}:{bl-method}'; — nous extrayons le nom de l'hôte de la logique métier à partir duquel la requête est faite, et le nom de la méthode ou de l'application qui l'a initiée.
Une fois que nous avons passé « le propriétaire » de la requête, il faut l'enregistrer dans le log — pour cela, nous configurons la variable log_line_prefix = ' %m [%p:%v] [%d] %r %a'. Pour ceux qui sont intéressés, ils peuvent , pour voir ce que cela signifie. Donc, dans le log, nous voyons :
- du temps
- les identifiants de processus et de transaction
- le nom de la base de données
- l'IP de celui qui a envoyé cette requête
- et le nom de la méthode
Ensuite, nous avons compris qu'il n'était pas très intéressant de regarder la corrélation d'une seule requête entre différents serveurs. Il est rare que vous ayez une application qui échoue de la même manière à deux endroits différents. Mais même si c'est le cas - regardez l'un de ces serveurs.
Donc, nous avons trouvé que la coupure « un serveur — un jour » était suffisante pour toute analyse.
Le premier angle d'analyse — c'est le fameux « modèle » — une forme abrégée de la représentation du plan, nettoyée de tous les indicateurs numériques. Le deuxième angle — l'application ou la méthode, et le troisième — c'est le nœud spécifique du plan qui a causé des problèmes.
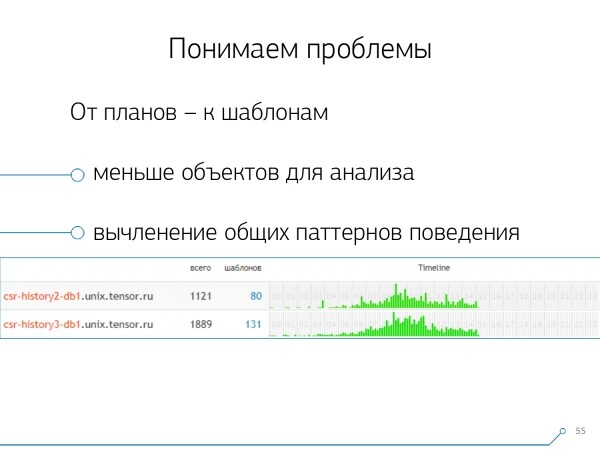
Quand nous sommes passés des instances concrètes aux modèles, nous avons immédiatement obtenu deux avantages :
- une réduction significative du nombre d'objets à analyser
Il faut maintenant examiner le problème non pas par milliers de requêtes ou de plans, mais par dizaines de modèles. - timeline
En d'autres termes, en résumant les « faits » dans le cadre d'une certaine coupe, vous pouvez montrer leur apparition tout au long de la journée. Et ici, vous pouvez comprendre que si vous avez un certain modèle qui se produit, par exemple, une fois par heure, alors qu'il devrait se produire une fois par jour, il vaut la peine de se demander ce qui ne va pas — qui l'a provoqué et pourquoi, peut-être qu'il n'a pas sa place ici. C'est un autre moyen non numérique, purement visuel, d'analyse.
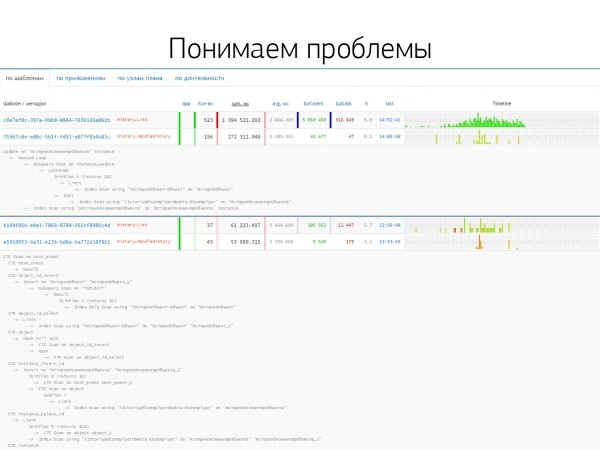
Les autres méthodes se basent sur les indicateurs que nous extrayons du plan : combien de fois ce modèle s'est produit, le temps total et moyen, combien de données ont été lues depuis le disque, et combien depuis la mémoire…
Parce que par exemple, vous arrivez sur la page d'analyse de l'hôte, vous regardez — il y a trop de lectures du disque. Le disque sur le serveur ne suit pas — mais qui lit là-dessus ?
Et vous pouvez trier par n'importe quelle colonne et décider sur quoi vous allez vous concentrer en ce moment — sur la charge du processeur ou celle du disque, ou sur le nombre total de requêtes… Vous avez trié, regardé les « meilleurs », corrigé — vous avez déployé une nouvelle version de l'application.
Et immédiatement, vous pouvez voir différentes applications qui suivent le même modèle à partir de la requête de type SELECT * FROM users WHERE login = 'Vasya'. Frontend, backend, traitement… Et vous vous demandez pourquoi le traitement devrait lire l'utilisateur s'il n'interagit pas avec lui.
L'approche inverse consiste à voir immédiatement ce que fait l'application. Par exemple, le frontend — c'est ça, ça, et ça, et puis ça encore une fois par heure (le timeline aide justement). Et la question se pose — il semble que ce ne soit pas le rôle du frontend de faire quelque chose une fois par heure…
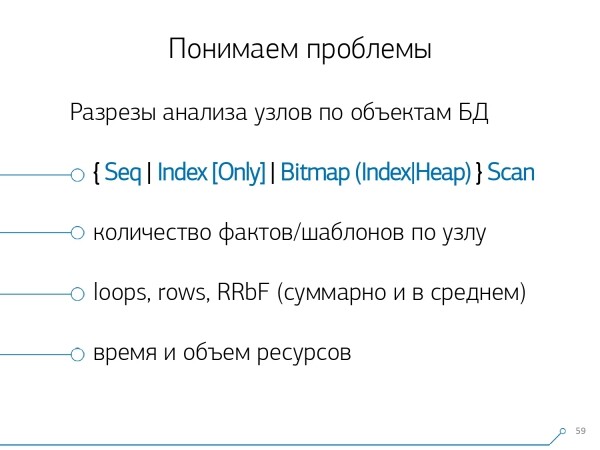
Au bout d'un certain temps, nous avons compris qu'il nous manquait des statistiques agrégées. Nous avons extrait des plans uniquement les noeuds qui effectuent des opérations sur les données des tableaux eux-mêmes (les lisent/écrivent selon l'index ou non). En gros, par rapport à l'image précédente, un seul aspect est ajouté —combien d'enregistrements ce noeud nous a apportés , et combien il en a rejetés (Rows Removed by Filter).Vous n'avez pas d'index approprié sur la table, vous exécutez une requête, elle passe à côté de l'index, elle tombe dans Seq Scan… vous avez filtré tous les enregistrements, sauf un. Pourquoi auriez-vous besoin de 100 millions d'enregistrements filtrés en un jour, ne serait-il pas mieux d'appliquer un index ?
Vous n'avez pas d'index approprié sur la table, vous effectuez une requête, elle passe à côté de l'index, tombe en Seq Scan... toutes les entrées sauf une ont été filtrées. Et pourquoi avez-vous besoin de 100 millions d'enregistrements filtrés en une journée ? Ne serait-il pas préférable de créer un index ?
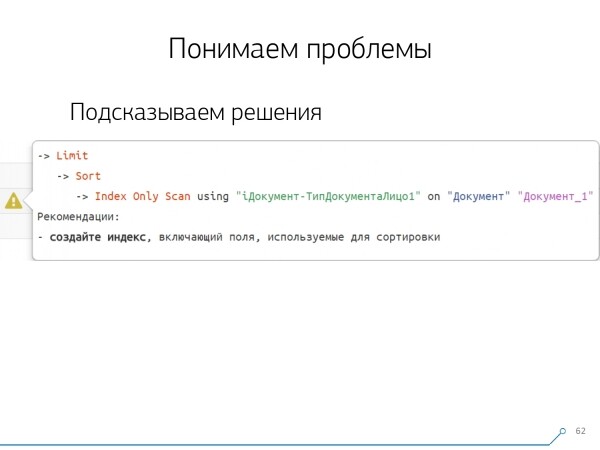
Après avoir analysé tous les plans par nœuds, nous avons compris qu'il existe certaines structures typiques dans les plans qui semblent très suspectes. Il serait utile de conseiller au développeur : « Mon ami, tu lis d'abord par index, ensuite tu trier, puis tu coupes » — en général, il n'y a qu'un seul enregistrement là.
Tous ceux qui ont fait des requêtes avec un tel modèle ont sûrement rencontré cela : « Donne-moi la dernière commande pour Vassia, sa date » Et si vous n'avez pas d'index par date, ou si la date n'est pas dans l'index utilisé, alors c'est exactement sur ces « râteaux » que vous allez marcher.
Mais nous savons que ce sont des « râteaux » — alors pourquoi ne pas dire immédiatement au développeur ce qu'il devrait faire. Ainsi, en ouvrant maintenant le plan, notre développeur voit immédiatement une belle image avec des conseils, où il est directement indiqué : « Tu as des problèmes ici et ici, et ils se résolvent comme ça et ça. »
En conséquence, le volume de l’expérience nécessaire pour résoudre les problèmes au début et maintenant a chuté de plusieurs fois. C'est l'outil que nous avons obtenu.
Source : habr.com
