

À l'approche du lancement du cours a préparé pour vous la traduction d'un autre matériel utile.
Le codage de Huffman est un algorithme de compression de données qui formule l'idée principale de la compression des fichiers. Dans cet article, nous allons parler du codage de longueur fixe et variable, des codes décodables de manière unique, des règles de préfixe et de la construction de l'arbre de Huffman.
Nous savons que chaque symbole est stocké sous la forme d'une séquence de 0 et 1 et occupe 8 bits. Cela s'appelle le codage de longueur fixe, car chaque symbole utilise le même nombre fixe de bits pour le stockage.
Supposons qu'un texte soit donné. Comment pouvons-nous réduire l'espace nécessaire pour stocker un symbole ?
L'idée principale est de coder de manière variable. Nous pouvons utiliser le fait que certains symboles dans le texte apparaissent plus souvent que d'autres (), pour développer un algorithme qui représentera la même séquence de symboles avec moins de bits. Lors du codage de longueur variable, nous attribuons aux symboles un nombre variable de bits en fonction de leur fréquence dans le texte donné. En fin de compte, certains symboles peuvent ne prendre qu'un bit, tandis que d'autres en prendront 2, 3 ou plus. Le problème du codage de longueur variable réside uniquement dans le décodage ultérieur de la séquence.
Comment, en connaissant la séquence de bits, la décoder de manière univoque ?
Considérons la chaîne «aabacdab». Elle contient 8 symboles, et en utilisant le codage de longueur fixe, son stockage nécessitera 64 bits. Notons que la fréquence des symboles «a», «b», «c» et «d» est respectivement de 4, 2, 1, 1. Essayons de la représenter «aabacdab» avec moins de bits, en utilisant le fait que «a» apparaît plus souvent que «b», et «b» apparaît plus souvent que «c» et «d». Commençons par coder «a» en utilisant un bit, égal à 0, «b» nous attribuerons un code de deux bits 11, et avec trois bits 100 et 011 nous coderons «c» et «d».
En fin de compte, nous obtiendrons :
a
0
b
11
c
100
d
011
Ainsi, la chaîne «aabacdab» sera encodée comme 00110100011011 (0|0|11|0|100|011|0|11), en utilisant les codes présentés ci-dessus. Cependant, le principal problème résidera dans le décodage. Lorsque nous tenterons de décoder la chaîne 00110100011011, nous obtiendrons un résultat ambigu, car elle peut être représentée comme :
0|011|0|100|011|0|11    adacdab
0|0|11|0|100|0|11|011   aabacabd
0|011|0|100|0|11|0|11   adacabab
…
etc.
Pour éviter cette ambiguïté, nous devons garantir que notre codage satisfait au concept de règle de préfixe, ce qui implique que les codes ne peuvent être décodés que d'un seul moyen unique. La règle de préfixe garantit qu'aucun code ne sera un préfixe d'un autre. Par code, nous entendons les bits utilisés pour représenter un caractère spécifique. Dans l'exemple ci-dessus, 0 – c'est un préfixe 011, ce qui viole la règle de préfixe. Donc, si nos codes satisfont à la règle de préfixe, alors le décodage peut être fait de manière unique (et vice versa).
Réexaminons l'exemple ci-dessus. Cette fois, nous allons assigner aux caractères «a», «b», «c» et «d» des codes qui respectent la règle de préfixe.
a
0
b
10
c
110
d
111
Avec ce type de codage, la chaîne «aabacdab» sera codée comme 00100100011010 (0|0|10|0|100|011|0|10). Cependant, 00100100011010 nous pourrons déjà décoder de manière unique et revenir à notre chaîne d'origine. «aabacdab».
Codage de Huffman
Maintenant que nous avons compris le codage à longueur variable et la règle de préfixe, parlons du codage de Huffman.
La méthode repose sur la création d'arbres binaires. Dans celui-ci, un nœud peut être soit terminal, soit interne. Initialement, tous les nœuds sont considérés comme des feuilles (terminaux), représentant le caractère lui-même et son poids (c'est-à-dire sa fréquence d'apparition). Les nœuds internes contiennent le poids du caractère et pointent vers deux nœuds descendants. Par convention, le bit "0" représente le suivi de la branche gauche, tandis que "1" indique la droite. Dans un arbre complet, il y a N des feuilles et N-1 nœuds internes. Il est recommandé d'éliminer les caractères inutilisés lors de la construction de l'arbre de Huffman pour obtenir des codes de longueur optimale.
Nous allons utiliser une file de priorité pour construire l'arbre de Huffman, où le nœud avec la fréquence la plus basse se voit attribuer la priorité la plus élevée. Les étapes de construction sont les suivantes :
- Créez un nœud feuille pour chaque caractère et ajoutez-les à la file de priorité.
- Tant qu'il y a plus d'une feuille dans la file, faites ce qui suit :
- Supprimez les deux nœuds les plus prioritaires (avec la fréquence la plus basse) de la file ;
- Créez un nouveau nœud interne, où ces deux nœuds seront descendants, et la fréquence d'apparition sera égale à la somme des fréquences de ces deux nœuds.
- Ajoutez le nouveau nœud à la file de priorité.
- Le seul nœud restant sera la racine, ce qui mettra fin à la construction de l'arbre.
Imaginons que nous avons un certain texte ne contenant que des caractères «a», «b», «c», «d» et «e», avec des fréquences d'apparition respectives de 15, 7, 6, 6 et 5. Voici des illustrations qui reflètent les étapes de l'algorithme.
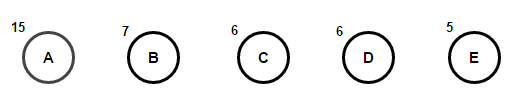
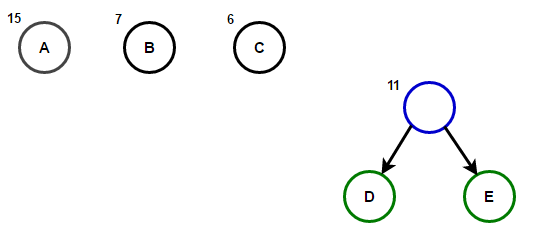
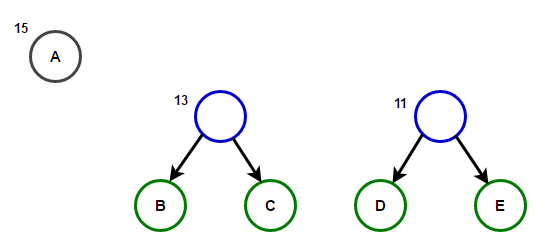
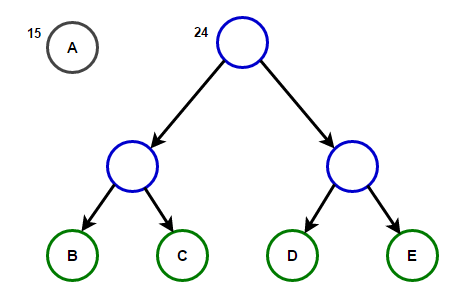
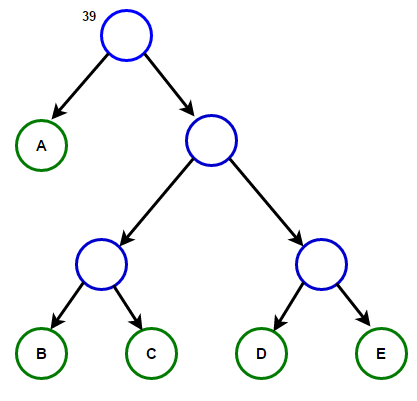
Le chemin de la racine à tout nœud terminal contiendra le code de préfixe optimal (également connu sous le nom de code de Huffman), correspondant au caractère associé à ce nœud terminal.
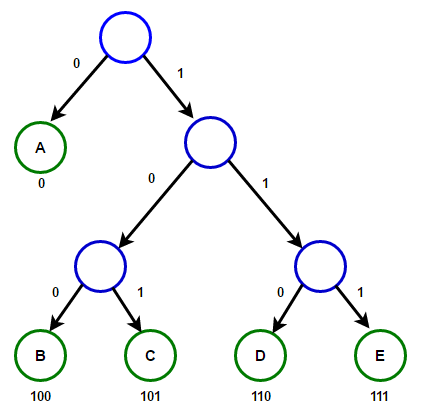
L'arbre de Huffman
Vous trouverez ci-dessous l'implémentation de l'algorithme de compression de Huffman en C++ et en Java :
#include <iostream>
#include <string>
#include <queue>
#include <unordered_map>
using namespace std;

// A Tree node
struct Node
{
	char ch;
	int freq;
	Node *left, *right;
};

// Function to allocate a new tree node
Node* getNode(char ch, int freq, Node* left, Node* right)
{
	Node* node = new Node();

	node->ch = ch;
	node->freq = freq;
	node->left = left;
	node->right = right;

	return node;
}

// Comparison object to be used to order the heap
struct comp
{
	bool operator()(Node* l, Node* r)
	{
		// highest priority item has lowest frequency
		return l->freq > r->freq;
	}
};

// traverse the Huffman Tree and store Huffman Codes
// in a map.
void encode(Node* root, string str,
			unordered_map<char, string> &huffmanCode)
{
	if (root == nullptr)
		return;

	// found a leaf node
	if (!root->left && !root->right) {
		huffmanCode[root->ch] = str;
	}

	encode(root->left, str + "0", huffmanCode);
	encode(root->right, str + "1", huffmanCode);
}

// traverse the Huffman Tree and decode the encoded string
void decode(Node* root, int &index, string str)
{
	if (root == nullptr) {
		return;
	}

	// found a leaf node
	if (!root->left && !root->right)
	{
		cout << root->ch;
		return;
	}

	index++;

	if (str[index] =='0')
		decode(root->left, index, str);
	else
		decode(root->right, index, str);
}

// Builds Huffman Tree and decode given input text
void buildHuffmanTree(string text)
{
	// count frequency of appearance of each character
	// and store it in a map
	unordered_map<char, int> freq;
	for (char ch: text) {
		freq[ch]++;
	}

	// Create a priority queue to store live nodes of
	// Huffman tree;
	priority_queue<Node*, vector<Node*>, comp> pq;

	// Create a leaf node for each character and add it
	// to the priority queue.
	for (auto pair: freq) {
		pq.push(getNode(pair.first, pair.second, nullptr, nullptr));
	}

	// do till there is more than one node in the queue
	while (pq.size() != 1)
	{
		// Remove the two nodes of highest priority
		// (lowest frequency) from the queue
		Node *left = pq.top(); pq.pop();
		Node *right = pq.top();	pq.pop();

		// Create a new internal node with these two nodes
		// as children and with frequency equal to the sum
		// of the two nodes' frequencies. Add the new node
		// to the priority queue.
		int sum = left->freq + right->freq;
		pq.push(getNode(' ', sum, left, right));
	}

	// root stores pointer to root of Huffman Tree
	Node* root = pq.top();

	// traverse the Huffman Tree and store Huffman Codes
	// in a map. Also prints them
	unordered_map<char, string> huffmanCode;
	encode(root, "", huffmanCode);

	cout << "Huffman Codes are :n" << 'n';
	for (auto pair: huffmanCode) {
		cout << pair.first << " " << pair.second << 'n';
	}

	cout << "nOriginal string was :n" << text << 'n';

	// print encoded string
	string str = "";
	for (char ch: text) {
		str += huffmanCode[ch];
	}

	cout << "nEncoded string is :n" << str << 'n';

	// traverse the Huffman Tree again and this time
	// decode the encoded string
	int index = -1;
	cout << "nDecoded string is: n";
	while (index < (int)str.size() - 2) {
		decode(root, index, str);
	}
}

// Huffman coding algorithm
int main()
{
	string text = "Huffman coding is a data compression algorithm.";

	buildHuffmanTree(text);

	return 0;
}
import java.util.HashMap;
import java.util.Map;
import java.util.PriorityQueue;
// Un nœud d'arbre
class Node
{
char ch;
int freq;
Node left = null, right = null;
Node(char ch, int freq)
{
this.ch = ch;
this.freq = freq;
}
public Node(char ch, int freq, Node left, Node right) {
this.ch = ch;
this.freq = freq;
this.left = left;
this.right = right;
}
};
class Huffman
{
// Traverse l'arbre de Huffman et stocke les codes de Huffman
// dans une carte.
public static void encode(Node root, String str,
Map huffmanCode)
{
if (root == null)
return;
// Trouvé un nœud feuille
if (root.left == null && root.right == null) {
huffmanCode.put(root.ch, str);
}
encode(root.left, str + "0", huffmanCode);
encode(root.right, str + "1", huffmanCode);
}
// Traverse l'arbre de Huffman et décode la chaîne
public static int decode(Node root, int index, StringBuilder sb)
{
if (root == null)
return index;
// Trouvé un nœud feuille
if (root.left == null && root.right == null)
{
System.out.print(root.ch);
return index;
}
index++;
if (sb.charAt(index) == '0')
index = decode(root.left, index, sb);
else
index = decode(root.right, index, sb);
return index;
}
// Construit l'arbre de Huffman et le code de Huffman et décode le texte d'entrée donné
public static void buildHuffmanTree(String text)
{
// Compte la fréquence d'apparition de chaque caractère
// et le stocke dans une carte
Map freq = new HashMap();
for (int i = 0 ; i < text.length(); i++) {
if (!freq.containsKey(text.charAt(i))) {
freq.put(text.charAt(i), 0);
}
freq.put(text.charAt(i), freq.get(text.charAt(i)) + 1);
}
// Crée une file de priorité pour stocker les nœuds actifs de l'arbre de Huffman
// Remarquez que l'élément de plus haute priorité a la fréquence la plus basse
PriorityQueue pq = new PriorityQueue(
(l, r) -> l.freq - r.freq);
// Crée un nœud feuille pour chaque caractère et l'ajoute
// à la file de priorité.
for (Map.Entry entry : freq.entrySet()) {
pq.add(new Node(entry.getKey(), entry.getValue()));
}
// Continue tant qu'il y a plus d'un nœud dans la file
while (pq.size() != 1)
{
// Retire les deux nœuds de plus haute priorité
// (fréquence la plus basse) de la file
Node left = pq.poll();
Node right = pq.poll();
// Crée un nouveau nœud interne avec ces deux nœuds comme enfants
// et avec une fréquence égale à la somme des deux nœuds
// fréquences. Ajoute le nouveau nœud à la file de priorité.
int sum = left.freq + right.freq;
pq.add(new Node(' ', sum, left, right));
}
// root stocke le pointeur vers la racine de l'arbre de Huffman
Node root = pq.peek();
// Traverse l'arbre de Huffman et stocke les codes de Huffman dans une carte
Map huffmanCode = new HashMap();
encode(root, "", huffmanCode);
// Affiche les codes de Huffman
System.out.println("Les codes de Huffman sont :\n");
for (Map.Entry entry : huffmanCode.entrySet()) {
System.out.println(entry.getKey() + " " + entry.getValue());
}
System.out.println("\nLa chaîne originale était :\n" + text);
// Affiche la chaîne encodée
StringBuilder sb = new StringBuilder();
for (int i = 0 ; i < text.length(); i++) {
sb.append(huffmanCode.get(text.charAt(i)));
}
System.out.println("\nLa chaîne encodée est :\n" + sb);
// Traverse à nouveau l'arbre de Huffman et cette fois
// décode la chaîne encodée
int index = -1;
System.out.println("\nLa chaîne décodée est : \n");
while (index < sb.length() - 2) {
index = decode(root, index, sb);
}
}
public static void main(String[] args)
{
String text = "Le codage de Huffman est un algorithme de compression de données.";
buildHuffmanTree(text);
}
}Remarque : La mémoire utilisée par la chaîne d'entrée est de 47 * 8 = 376 bits, tandis que la chaîne codée n'occupe que 194 bits, c'est-à-dire que les données sont compressées d'environ 48 %. Dans le programme en C++ ci-dessus, nous utilisons la classe string pour stocker la chaîne codée afin de rendre le programme lisible.
Comme les structures de données efficaces pour les files d'attente prioritaires nécessitent un temps d'insertion O(log(N)) et qu'un arbre binaire complet avec N des feuilles contient 2N-1 nœuds, et l'arbre de Huffman est un arbre binaire complet, l'algorithme fonctionne en O(Nlog(N)) temps, où N est le nombre de symboles.
Sources :
Source : habr.com
