

Un système d'analyse du trafic sans décryptage. Cette méthode est simplement appelée « apprentissage automatique ». Il s'est avéré que si l'on fournit un très grand volume de trafic divers à un classificateur spécial, le système peut détecter avec une très haute probabilité les actions de code malveillant à l'intérieur du trafic chiffré.
Les menaces réseau ont évolué et sont devenues « plus intelligentes ». Au cours de la dernière période, le concept même d'attaque et de protection a changé. Le nombre d'événements dans le réseau a augmenté de manière exponentielle. Les attaques sont devenues plus sophistiquées et les hackers ont un éventail d'attaques plus large.
Selon les statistiques de Cisco, les malfaiteurs ont triplé le nombre de programmes malveillants utilisés pour leurs activités au cours de la dernière année, en particulier pour le camouflage — le chiffrement. On sait par la théorie qu'un algorithme de chiffrement « correct » ne peut pas être piraté. Pour comprendre ce qui se cache à l'intérieur du trafic chiffré, il faut soit le déchiffrer en connaissant la clé, soit essayer de le déchiffrer par des astuces, soit par un piratage frontal, soit en utilisant certaines vulnérabilités dans les protocoles cryptographiques.
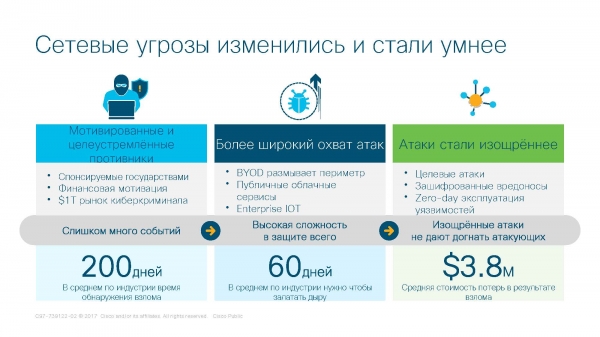
Le tableau des menaces réseau de notre époque
Apprentissage automatique
Connaissez la technologie ! Avant de parler de comment fonctionne la technologie de déchiffrement basée sur l'apprentissage automatique, il est nécessaire d'examiner comment fonctionne la technologie des réseaux de neurones.
L'apprentissage automatique (Machine Learning) est une vaste sous-discipline de l'intelligence artificielle qui étudie les méthodes de construction d'algorithmes capables d'apprendre. Cette science vise à créer des modèles mathématiques d'« apprentissage » pour l'ordinateur. L'objectif de l'apprentissage est de prédire quelque chose. Dans notre compréhension humaine, nous appelons ce processus « sagesse ». « sagesse »La sagesse se manifeste chez les personnes ayant vécu suffisamment d'années (un enfant de 2 ans ne peut pas être sage). En demandant conseil à des personnes plus âgées, nous leur fournissons une certaine information sur un événement (les données d'entrée) et demandons de l'aide. En retour, ils se remémorent toutes les situations de leur vie qui sont liées à votre problème (la base de connaissances) et, sur la base de ces connaissances (données), ils nous donnent, pour ainsi dire, une prévision (un conseil). Ce type de conseils a été appelé prédiction car la personne qui donne le conseil ne sait pas avec certitude ce qui va se passer, elle ne fait qu'émettre une supposition. L'expérience montre qu'une personne peut avoir raison, mais aussi se tromper.
Il ne faut pas comparer les réseaux neuronaux à un algorithme de branchement (if-else). Ce sont des choses différentes et il y a des différences clés entre eux. L'algorithme de branchement a une "compréhension" claire de ce qu'il faut faire. Je vais le démontrer par des exemples.
Tâche. Déterminer la distance de freinage d'une voiture en fonction de sa marque et de son année de fabrication.
Exemple de fonctionnement d'un algorithme de branchement. Si la voiture est de marque 1 et a été fabriquée en 2012, sa distance de freinage est de 10 mètres ; sinon, si la voiture est de marque 2 et a été fabriquée en 2011, et ainsi de suite.
Exemple de fonctionnement d'un réseau neuronal. Nous rassemblons des données sur les distances de freinage des voitures au cours des 20 dernières années. En fonction de la marque et de l'année, nous établissons un tableau du type « marque-année de fabrication-distance de freinage ». Nous fournissons ce tableau au réseau neuronal et commençons à l'entraîner. L'apprentissage se déroule de la manière suivante : nous introduisons des données dans le réseau neuronal, mais sans la distance de freinage. Le réseau essaie de prédire quelle sera la distance de freinage, sur la base du tableau chargé. Il prédit quelque chose et pose la question à l'utilisateur : « Ai-je raison ? ». Avant cette question, il crée une quatrième colonne - la colonne des devinettes. S'il a raison, il inscrit 1 dans la quatrième colonne, s'il s'est trompé, 0. Le réseau neuronal passe à l'événement suivant (même s'il s'est trompé). Ainsi, le réseau apprend et lorsque l'entraînement est terminé (critère de convergence atteint), nous introduisons les données de la voiture qui nous intéresse et obtenons enfin la réponse.
Pour enlever l'ambiguïté concernant le critère de convergence, je vais préciser qu'il s'agit d'une formule mathématiquement dérivée pour la statistique. Un exemple frappant de deux formules de convergence différentes. Rouge - convergence binaire, bleu - convergence normale.
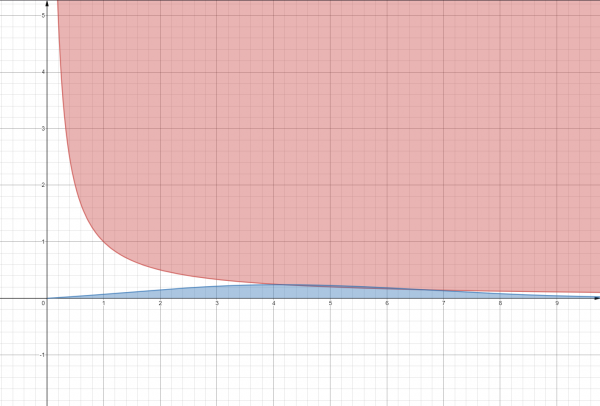
Distribution binomiale et normale des probabilités
Pour rendre cela plus clair, posez la question « Quelle est la probabilité de rencontrer un dinosaure ? ». Il existe 2 réponses possibles. Réponse 1 – très faible (courbe bleue). Réponse 2 – soit je rencontre, soit je ne rencontre pas (courbe rouge).
Bien sûr, un ordinateur n'est pas un humain et il apprend différemment. Il existe 2 types d'apprentissage pour ces machines – apprentissage par analogies et apprentissage déductif.
L'apprentissage par analogies est une méthode d'apprentissage basée sur des lois mathématiques. Les mathématiciens compilent des tableaux statistiques, tirent des conclusions et chargent dans le réseau de neurones le résultat – une formule de calcul.
L'apprentissage déductif se fait entièrement dans le réseau de neurones (de la collecte des données à leur analyse). Ici, un tableau est formé sans formule, mais avec des statistiques.
Une vue d'ensemble élargie de la technologie prendrait encore quelques dizaines d'articles. Pour l'instant, cela suffit pour une compréhension générale.
Neuroplasticité
En biologie, il existe un concept – la neuroplasticité. La neuroplasticité est la capacité des neurones (cellules cérébrales) à agir « en fonction de la situation ». Par exemple, une personne ayant perdu la vue entend mieux les sons, perçoit les odeurs et ressent les objets. Cela est dû au fait qu'une partie du cerveau (une partie des neurones) responsable de la vision redistribue son travail à d'autres fonctions.
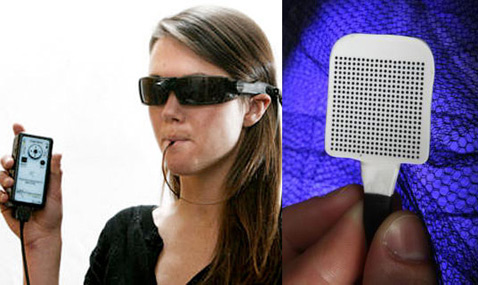
Un exemple frappant de neuroplasticité dans la vie quotidienne est le dispositif BrainPort.
En 2009, l'Université du Wisconsin à Madison a annoncé la sortie d'un nouvel appareil développant les idées du « dispositif d'affichage linguistique » – il a été nommé BrainPort. BrainPort fonctionne selon cet algorithme : le signal vidéo provenant de la caméra est envoyé au processeur, qui contrôle le zoom, la luminosité et d'autres paramètres de l'image. Il convertit également les signaux numériques en impulsions électriques, assumant en fait les fonctions de la rétine.
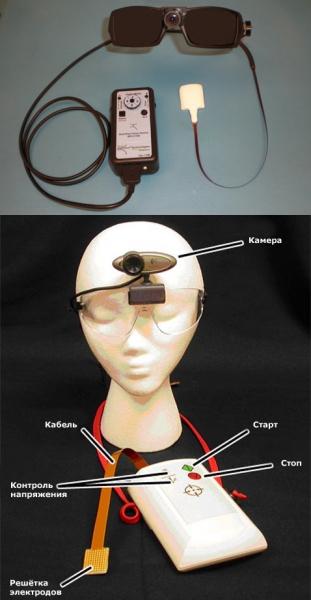
BrainPort avec lunettes et caméra
BrainPort en action
Il en va de même pour un ordinateur. Si un réseau de neurones détecte un changement dans le processus, il s'ajuste en conséquence. C'est là le principal avantage des réseaux de neurones par rapport à d'autres algorithmes – leur autonomie. Une sorte d'humanité.
Analyse du trafic chiffré
Encrypted Traffic Analytics est une partie du système Stealthwatch. Stealthwatch est une solution de Cisco dans le domaine de la surveillance et de l'analyse de la sécurité, utilisant les données de télémétrie d'entreprise provenant de l'infrastructure réseau existante.
La base de Stealthwatch Enterprise est constituée des outils Flow Rate License, Flow Collector, Management Console et Flow Sensor.
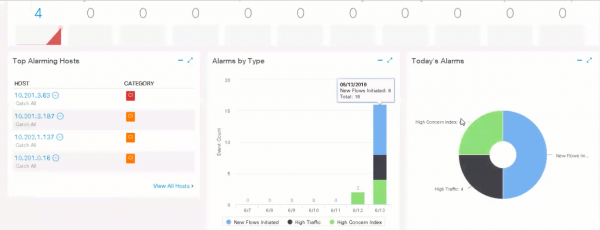
Interface Cisco Stealthwatch
Le problème de l'encryption est devenu particulièrement aigu car de plus en plus de trafic est désormais chiffré. Auparavant, seul le code (principalement) était chiffré, tandis qu'aujourd'hui tout le trafic est sécurisé, rendant la distinction entre les données « propres » et les virus beaucoup plus complexe. Un exemple marquant est WannaCry, qui a utilisé Tor pour masquer sa présence sur le réseau.
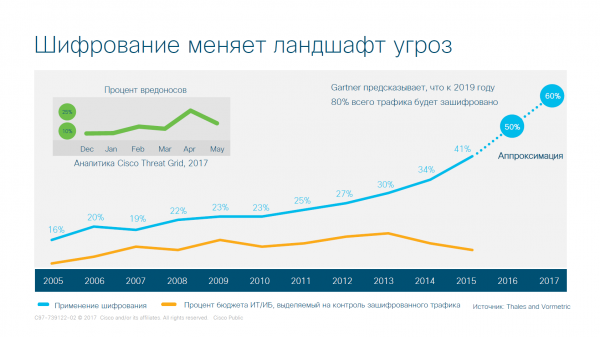
Visualisation de l'augmentation du chiffrement du trafic sur le réseau
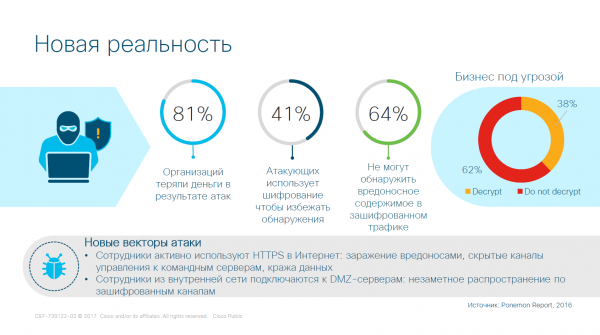
Chiffrement dans la macroéconomie
Le système Encrypted Traffic Analytics (ETA) est justement nécessaire pour traiter le trafic chiffré sans le déchiffrer. Les cybercriminels sont astucieux et utilisent des algorithmes de chiffrement robustes, et les casser représente non seulement un défi, mais également des coûts exorbitants pour les organisations.
Le système fonctionne comme suit. Un certain trafic arrive dans l'entreprise. Il passe par TLS (transport layer security — protocole de sécurité du niveau de transport). Supposons que le trafic soit chiffré. Nous essayons de répondre à plusieurs questions concernant le type de connexion établie.
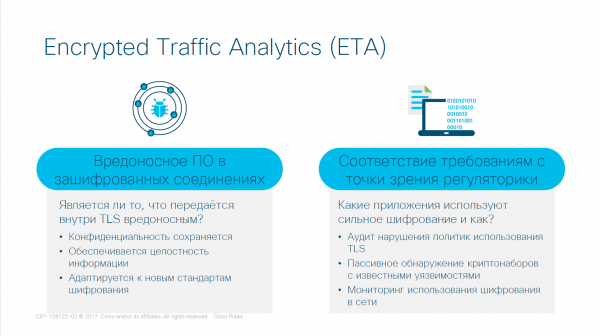
Principe de fonctionnement du système Encrypted Traffic Analytics (ETA)
Pour répondre à ces questions, nous utilisons l'apprentissage automatique dans ce système. Des recherches de Cisco sont prises et sur cette base, un tableau se crée avec 2 résultats – le trafic malveillant et le trafic « bon ». Bien sûr, nous ne savons pas avec certitude quel type de trafic entre dans le système à un moment donné, mais nous pouvons retracer l'historique du trafic à la fois au sein de l'entreprise et à l'extérieur grâce à des données globales. À la sortie de cette étape, nous obtenons un grand tableau de données.
Les résultats de l'étude révèlent des caractéristiques distinctes – des règles spécifiques qui peuvent être exprimées sous forme mathématique. Ces règles varieront considérablement selon différents critères – la taille des fichiers transférés, le type de connexion, le pays d'origine du trafic, etc. En conséquence, un tableau énorme s'est transformé en un ensemble de formules. Leur nombre a diminué, mais cela reste insuffisant pour un travail confortable.
Ensuite, la technologie d'apprentissage automatique est appliquée – la convergence de la formule et, en conséquence, de la convergence, nous recevons un déclencheur – un interrupteur, où lors de la sortie des données, nous obtenons un commutateur (flag) en position levée ou abaissée.
L'étape finale consiste à obtenir un ensemble de déclencheurs qui couvrent 99% du trafic.
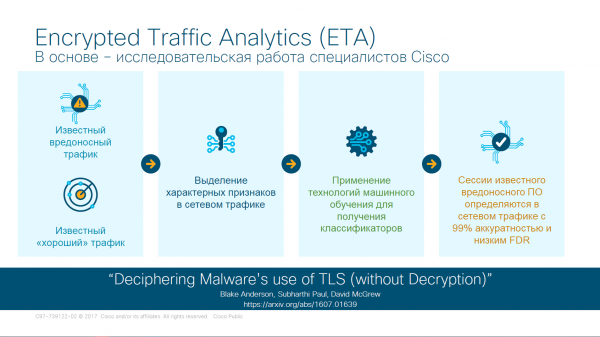
Étapes de vérification du trafic dans l'ETA
En conséquence, un autre problème est résolu – une attaque de l'intérieur. Il n'est plus nécessaire d'avoir des personnes à mi-chemin qui filtrent le trafic manuellement (en ce moment, je me coule moi-même). Premièrement, il n'est plus nécessaire de dépenser beaucoup d'argent pour un administrateur système compétent (je continue à me couler). Deuxièmement, il n'y a plus de risque de piratage de l'intérieur (du moins, partiellement).
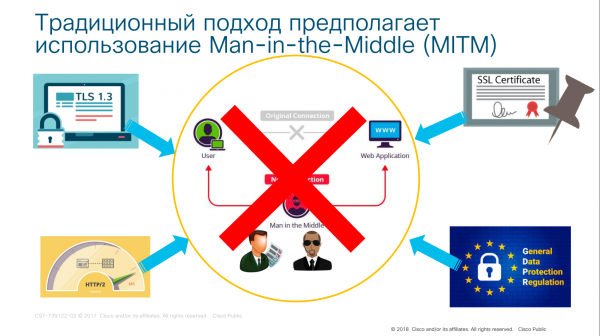
Conception obsolète de Man-in-the-Middle
Maintenant, voyons sur quoi repose le système.
Le système fonctionne sur 4 protocoles de communication : TCP/IP – protocole de transfert de données sur Internet, DNS – serveur de noms de domaine, TLS – protocole de protection de la couche de transport, SPLT (SpaceWire Physical Layer Tester) – testeur de la couche physique de communication.
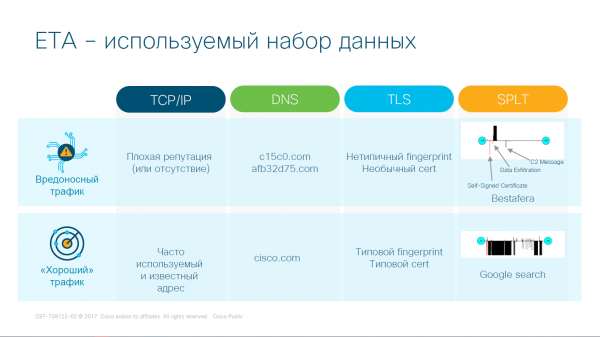
Protocoles fonctionnant avec l'ETA
La comparaison se fait en associant les données. Grâce aux protocoles TCP/IP, nous vérifions la réputation des sites (historique des visites, objectif de création du site, etc.), grâce au protocole DNS, nous pouvons éliminer les « mauvais » adresses de sites. Le protocole TLS travaille avec les « empreintes » du site (fingerprint) et vérifie le site à partir de la base d'une équipe de réponse aux urgences informatiques (cert). La dernière étape de vérification de la connexion – vérification au niveau physique. Les détails de cette étape ne sont pas spécifiés, mais le sens est le suivant : vérification des sinusoïdes et cosinusoïdes des courbes de transmission de données sur des installations oscillographiques, c'est-à-dire qu'en raison de la structure de la demande au niveau physique, nous déterminons l'objectif de la connexion.
À la suite du fonctionnement du système, nous pouvons extraire des données du trafic chiffré. Grâce à l'analyse des paquets, nous pouvons lire un maximum d'informations à partir des champs non chiffrés dans le paquet lui-même. En inspectant le paquet au niveau physique, nous découvrons les caractéristiques du paquet (partiellement ou totalement). Il ne faut pas oublier la réputation des sites. Si la demande provient d'une source .onion, il ne faut pas lui faire confiance. Pour faciliter le travail avec ce type de données, une carte des risques a été créée.
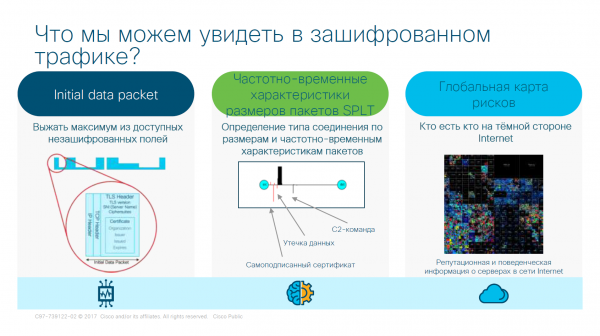
Résultat du fonctionnement d'ETA
Tout semblait aller pour le mieux, mais parlons du déploiement du réseau.
Réalisation physique d'ETA
Ici surgissent plusieurs nuances et subtilités. Premièrement, lors de la création d'un tel
réseau avec un logiciel de haut niveau, une collecte de données est nécessaire. Recueillir les données manuellement est complètement
frustrant, tandis que la mise en place d'un système de réponse – c'est déjà plus intéressant. Deuxièmement, il doit y avoir beaucoup de données, ce qui signifie que les capteurs du réseau doivent fonctionner
non seulement de manière autonome, mais aussi en mode finement réglé, ce qui pose plusieurs difficultés.
Capteurs et système Stealthwatch
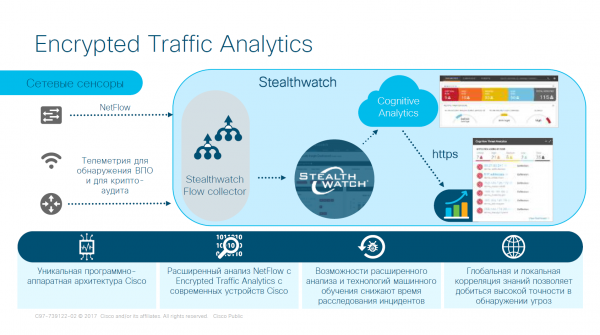
Installer un capteur – c'est une chose, mais le configurer – c'est une tâche complètement différente. Pour configurer les capteurs, il existe un ensemble fonctionnant selon la topologie suivante – ISR = routeur avec intégration de services Cisco (Cisco Integrated Services Router); ASR = routeur avec agrégation de services Cisco (Cisco Aggregation Services Router); CSR = routeur de services cloud Cisco (Cisco Cloud Services Router); WLC = contrôleur de réseaux locaux sans fil Cisco (Cisco Wireless LAN Controller); IE = commutateur Ethernet industriel Cisco (Cisco Industrial Ethernet); ASA = dispositif de protection adaptatif Cisco (Cisco Adaptive Security Appliance); FTD = solution de protection contre les menaces Cisco Firepower Threat Defense; WSA = dispositif de protection du trafic web (Web Security Appliance); ISE = module de services d'identification (Identity Services Engine)
Surveillance complète prenant en compte toutes les données télémétriques
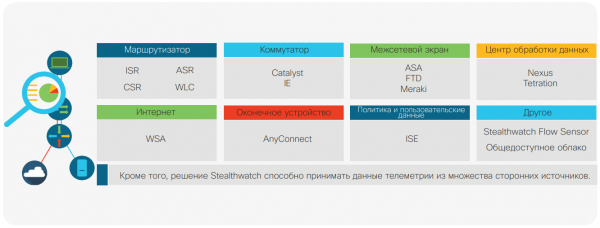
Les administrateurs réseau ressentent une arythmie à cause du nombre de mots « Cisco » dans le paragraphe précédent. Le prix de ce miracle est assez élevé, mais ce n'est pas le sujet d'aujourd'hui…
Le prix de ce miracle est assez élevé, mais ce n'est pas le sujet d'aujourd'hui…
La modélisation du comportement du hacker se déroulera comme suit. Stealthwatch suit de près l'activité de chaque appareil sur le réseau et est capable de créer un modèle de comportement normal. De plus, cette solution offre une compréhension approfondie des comportements inappropriés connus. Dans le cadre de cette solution, environ 100 algorithmes d'analyse ou règles heuristiques sont utilisés, concernant différents types de comportements du trafic, tels que l'exploration, la transmission de trames d'alerte à partir d'un nœud, la tentative de connexion par bruteforce, la capture présumée de données, la fuite présumée de données, etc. Les événements de sécurité énumérés tombent sous la catégorie des alertes logiques de haut niveau. Certains événements de sécurité peuvent également déclencher une alarme à eux seuls. Ainsi, le système est capable de corréler de nombreux incidents anormaux isolés et de les rassembler afin de déterminer le type possible d'attaque, ainsi que de l'associer à un appareil et un utilisateur spécifiques (figure 2). L'incident peut ensuite être examiné dans la dynamique et en tenant compte des données de télémétrie associées. Cela constitue l'information contextuelle à son meilleur. Les médecins, lorsqu'ils examinent un patient pour comprendre ce qui s'est passé, ne considèrent pas les symptômes de manière isolée. Ils examinent l'image dans son ensemble pour établir un diagnostic. De manière similaire, Stealthwatch enregistre chaque activité anormale sur le réseau et l'étudie dans un ensemble pour envoyer des alertes en tenant compte du contexte, aidant ainsi les spécialistes de la sécurité à établir des priorités pour les risques.
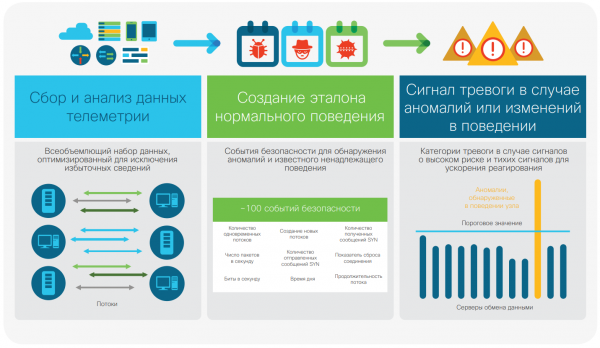
Détection des anomalies par modélisation du comportement
Le déploiement physique du réseau se présente comme suit :
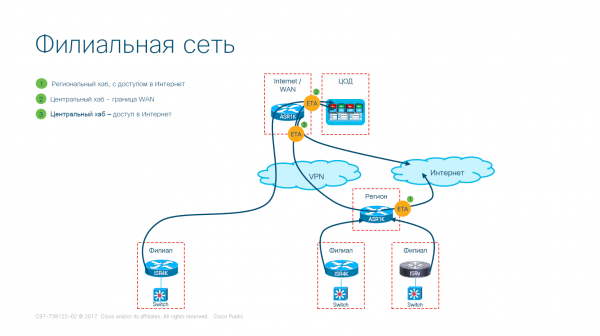
Option de déploiement d'un réseau de succursale (simplifié)
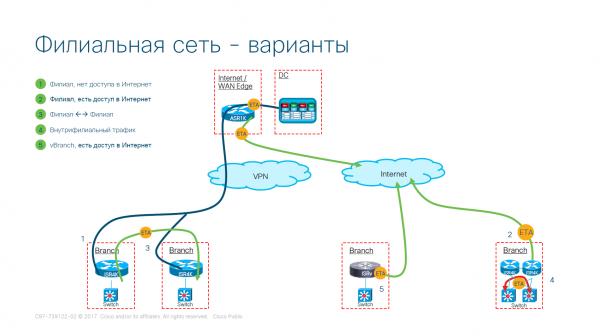
Option de déploiement d'un réseau de succursale
Le réseau est déployé, mais une question subsiste concernant le réseau neuronal. Un réseau de transmission de données a été organisé, des capteurs ont été installés sur les seuils, et le système de collecte d'informations a été lancé, mais le réseau neuronal n'a pas encore pris part. Pour l'instant.
Réseau neuronal multicouche
Le système analyse le comportement des utilisateurs et des appareils pour détecter les infections malveillantes, les communications avec des serveurs de commande, les fuites de données, ainsi que les applications potentiellement indésirables fonctionnant dans l'infrastructure de l'organisation. Il existe plusieurs niveaux de traitement des données, où une combinaison de méthodes d'intelligence artificielle, d'apprentissage automatique et de statistiques mathématiques aide le réseau à apprendre de manière autonome son activité normale, afin de pouvoir identifier l'activité malveillante.
Le pipeline d'analyse de la sécurité du réseau, qui collecte des données de télémétrie de toutes les parties du réseau étendu, y compris le trafic chiffré, est une caractéristique unique de Stealthwatch. Il construit progressivement une compréhension de ce qui est « anormal », puis classe les éléments individuels de « l'activité menaçante » et enfin rend une décision finale quant à savoir si l'appareil ou l'utilisateur a réellement été compromis. La capacité à rassembler de petites pièces, constituant ensemble une preuve pour prendre une décision finale sur la compromission d'un objet, se fait grâce à une analyse et une corrélation très minutieuses.
Cette capacité est cruciale, car une entreprise standard peut recevoir un grand nombre d'alertes chaque jour, et il est impossible d'enquêter sur chacune d'entre elles — les ressources des spécialistes de la sécurité sont limitées. Le module d'apprentissage automatique traite une énorme quantité d'informations presque en temps réel pour identifier des incidents critiques avec un niveau de confiance élevé, et est également capable de proposer un ordre d'action clair pour une résolution rapide.
Explorons plus en détail les nombreuses méthodes d'apprentissage automatique utilisées par Stealthwatch. Lorsqu'un incident est transmis au module d'apprentissage automatique de Stealthwatch, il traverse un entonnoir d'analyse de sécurité, au sein duquel une combinaison de méthodes d'apprentissage supervisé et non supervisé est utilisée.
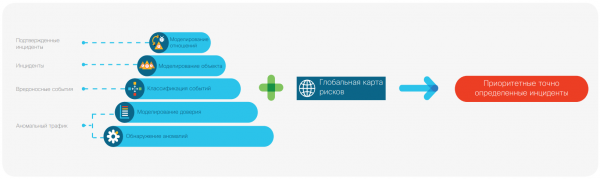
Capacités d'apprentissage automatique multi-niveaux
Niveau 1. Détection des anomalies et modélisation de la confiance
À ce niveau, 99 % du trafic est rejeté grâce à des détecteurs d'anomalies statistiques. Ces capteurs forment ensemble des modèles complexes de ce qui est normal et de ce qui est anormal. Cependant, l'anormal n'est pas nécessairement malveillant. Beaucoup de ce qui se passe dans votre réseau n'est pas lié à une menace — c'est juste étrange. Il est donc important de classer de tels processus indépendamment des comportements menaçants. Pour cette raison, les résultats de ces détecteurs font l'objet d'une analyse plus approfondie afin de cerner les comportements étranges qui peuvent être expliqués et auxquels on peut faire confiance. En fin de compte, seule une petite fraction des flux et requêtes les plus importants passent aux niveaux 2 et 3. Sans ces méthodes d'apprentissage automatique, les coûts opérationnels pour séparer le signal du bruit seraient trop élevés.
Détection des anomalies. Au premier stade de la détection des anomalies, des méthodes statistiques d'apprentissage automatique sont utilisées pour séparer le trafic statistiquement normal du trafic anormal. Plus de 70 détecteurs distincts traitent les données de télémétrie collectées par Stealthwatch sur le trafic qui passe par le périmètre de votre réseau, séparant le trafic interne du système de noms de domaine (DNS) et les données du serveur proxy, le cas échéant. Chaque requête est traitée par plus de 70 détecteurs, chacun utilisant son propre algorithme statistique pour évaluer les anomalies détectées. Ces évaluations sont combinées, et grâce à l'application de plusieurs méthodes statistiques, une évaluation unique est produite pour chaque requête individuelle. Ensuite, cette évaluation collective est utilisée pour séparer le trafic normal du trafic anormal.
Modélisation de la confiance. Les requêtes similaires sont ensuite regroupées, et l'évaluation cumulative des anomalies pour ces groupes est déterminée comme étant la moyenne à long terme. Au fil du temps, un plus grand nombre de requêtes sont soumises à l'analyse et à la détermination de la moyenne à long terme, ce qui permet de réduire les alertes faussement positives et faussement négatives. Les résultats de la modélisation de confiance sont utilisés pour sélectionner un sous-ensemble de trafic dont l'évaluation des anomalies dépasse un certain seuil dynamique déterminé, afin de le déplacer vers le niveau suivant de traitement.
Niveau 2. Classification des événements et modélisation de l'objet
À ce niveau, les résultats obtenus lors des étapes précédentes sont classés, en attribuant des événements malveillants spécifiques. La classification des événements est effectuée selon la valeur attribuée par les classificateurs d'apprentissage automatique, afin de garantir un taux de précision constant supérieur à 90 %. Parmi eux, on trouve :
- des modèles linéaires basés sur le lemme de Neyman-Pearson (loi de la distribution normale tirée du graphique au début de l'article)
- des machines à vecteurs de support utilisant un apprentissage multivarié
- des réseaux neuronaux et l'algorithme « forêt aléatoire ».
Ensuite, ces événements de sécurité isolés sont liés dans le temps à un terminal unique. C'est à ce stade qu'une description de la menace est formée, sur la base de laquelle une image complète est élaborée concernant la façon dont l'agresseur concerné a réussi à atteindre certains résultats.
Classification des événements. Un sous-ensemble statistiquement anormal de l'étape précédente est réparti sur 100 catégories ou plus à l'aide de classificateurs. La plupart des classificateurs sont basés sur le comportement individuel, les relations de groupe ou le comportement à l'échelle mondiale ou locale, tandis que d'autres peuvent être très spécifiques. Par exemple, un classificateur peut indiquer un trafic de serveurs de commande, une extension suspecte ou une mise à jour logicielle non autorisée. À l'issue de cette étape, un ensemble d'événements anormaux dans le système de sécurité est établi, classé dans des catégories spécifiques.
Modélisation de l'objet. Si la quantité de preuves soutenant l'hypothèse de la nocivité d'un objet spécifique dépasse le seuil de signifiance, une menace est déterminée. Les événements pertinents ayant influencé la détermination de la menace sont liés à celle-ci et deviennent partie d'un modèle discret à long terme de l'objet. Au fur et à mesure que les preuves s'accumulent dans le temps, le système détermine de nouvelles menaces lorsque le seuil de signifiance est atteint. Ce seuil est dynamique et fait l'objet d'un ajustement intelligent basé sur le niveau de risque de la menace et d'autres facteurs. Ensuite, la menace apparaît sur le tableau de bord de l'interface web et est portée au niveau suivant.
Niveau 3. Modélisation des relations
L'objectif de la modélisation des relations est de synthétiser les résultats obtenus aux niveaux précédents, en tenant compte non seulement du contexte local mais aussi du contexte global de l'incident concerné. C'est à cette étape que vous pouvez déterminer combien d'organisations ont été confrontées à une telle attaque, afin de comprendre si elle vous était spécifiquement destinée ou si elle fait partie d'une campagne globale dans laquelle vous avez simplement été pris "dans le feu croisé".
Les incidents sont confirmés ou détectés. Un incident confirmé implique une certitude de 99 à 100 %, car les méthodes et outils concernés ont été observés précédemment en action à une échelle plus vaste (globale). Les incidents détectés sont uniques pour vous et font partie d'une campagne ciblée. Les résultats obtenus dans le passé sont transmis en indiquant un ordre d'action connu, ce qui permet d'économiser votre temps et vos ressources lors de la réponse. Ils sont fournis avec les outils d'enquête dont vous aurez besoin pour comprendre qui vous a attaqué et quel est le degré de ciblage de la campagne sur votre entreprise numérique. Comme vous pouvez l'imaginer, le nombre d'incidents confirmés dépasse de loin le nombre d'incidents détectés, pour la simple raison que les incidents confirmés ne sont pas coûteux pour les attaquants, tandis que les incidents détectés engendrent des coûts.
cher, car ils doivent être nouveaux et personnalisés. Grâce à la création d'opportunités pour identifier les incidents confirmés, l'économie du jeu a enfin basculé en faveur des défenseurs, leur donnant un certain avantage.
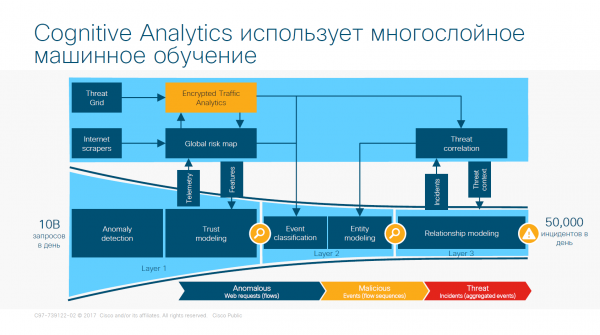
Apprentissage multi-niveaux du système de réseaux neuronaux basé sur ETA
Carte globale des risques
La carte globale des risques est créée à partir de l'analyse appliquée par des algorithmes d'apprentissage automatique à l'un des plus grands ensembles de données de l'industrie. Elle fournit des données statistiques étendues sur le comportement des serveurs en ligne, même s'ils sont inconnus. Ces serveurs sont liés à des attaques, peuvent être impliqués ou utilisés dans le cadre d'attaques futures. Ce n'est pas une « liste noire », mais une image complète du serveur en question du point de vue de la sécurité. De telles informations sur l'activité des serveurs spécifiés, préparées en tenant compte du contexte, permettent aux détecteurs et classificateurs d'apprentissage automatique Stealthwatch de prédire avec précision le niveau de risque associé aux communications avec ces serveurs.
Vous pouvez consulter les cartes disponibles .
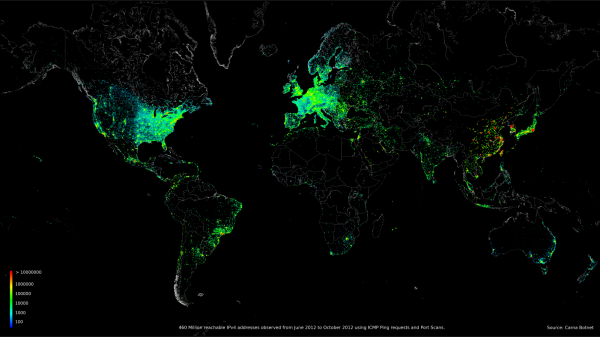
Carte du monde montrant 460 millions adresses IP
Maintenant, le réseau s'entraîne et protège votre réseau.
Enfin, a-t-on trouvé la panacée ?
Malheureusement, non. D'après l'expérience avec le système, je peux dire qu'il y a 2 problèmes globaux.
Problème 1. Prix. L'ensemble du réseau est déployé sur un système Cisco. C'est à la fois bon et mauvais. Le bon côté, c'est que vous n'avez pas à vous soucier de mettre en place des dispositifs comme D-Link, MikroTik, etc. Le point négatif – le coût exorbitant du système. Compte tenu de l'état économique des entreprises russes, à l'heure actuelle, seule un propriétaire fortuné d'une grande entreprise ou d'une banque peut se permettre cette merveille.
Problème 2. Formation. Je n'ai pas mentionné dans l'article la durée d'apprentissage du réseau neuronal, non pas parce qu'il n'y en a pas, mais parce qu'il s'entraîne constamment et que nous ne pouvons pas prédire quand il apprendra. Bien sûr, il existe des outils de statistique mathématique (comme la formulation du critère de convergence de Pearson), mais ce n'est qu'une solution temporaire. Nous obtenons une probabilité de filtration du trafic, et encore avec l'hypothèse que l'attaque est déjà maîtrisée et connue.
Malgré ces deux problèmes, nous avons fait un grand pas en avant dans le développement de la sécurité de l'information en général et de la protection des réseaux en particulier. Ce fait peut être une source de motivation pour explorer les technologies réseau et les réseaux neuronaux, qui sont actuellement un domaine très prometteur.
Source : habr.com
