

Je vous propose de découvrir l'analyse du rapport de Nikolay Samokhvalov "Approche industrielle pour le tuning de PostgreSQL : expériences sur les bases de données"
Shared_buffers = 25 % – est-ce beaucoup ou peu ? Ou est-ce juste ce qu'il faut ? Comment savoir si cette recommandation – quelque peu obsolète – est pertinente dans votre cas spécifique ?
Il est temps d'aborder la question du choix des paramètres postgresql.conf "comme un pro". Pas avec des "auto-tuneurs" aveugles ou des conseils obsolètes venant d'articles et de blogs, mais sur la base de :
- expérimentations rigoureusement menées sur des bases de données, réalisées de manière automatisée, en grande quantité et dans des conditions aussi proches que possible des environnements de production,
- compréhension approfondie des spécificités de fonctionnement des SGBD et des systèmes d'exploitation.
En utilisant Nancy CLI (), nous examinerons un exemple concret – le fameux shared_buffers – dans différentes situations, dans divers projets et tenterons de déterminer comment choisir le réglage optimal pour notre infrastructure, nos bases de données et notre charge.
Nous parlerons des expérimentations sur les bases de données. C'est une histoire qui dure depuis un peu plus de six mois.
Un peu sur moi. J'ai plus de 14 ans d'expérience avec Postgres. J'ai fondé plusieurs entreprises dans le domaine des réseaux sociaux. Postgres a été utilisé et est utilisé partout.
Je fais également partie du groupe RuPostgres sur Meetup, qui est classé deuxième au monde. Nous nous rapprochons lentement des 2 000 membres. RuPostgres.org.
Et lors de diverses conférences, y compris Highload, je suis responsable des bases de données, notamment de Postgres, depuis sa création.
Ces dernières années, j'ai relancé ma pratique de conseil sur Postgres dans 11 fuseaux horaires à partir d'ici.
Quand j'ai repris cette activité il y a quelques années, j'avais eu une certaine pause dans le travail manuel avec Postgres, probablement depuis 2010. J'ai été surpris de constater combien le quotidien des DBA avait peu changé, combien de travail manuel était encore nécessaire. Et j'ai tout de suite pensé qu'il y avait un problème, qu'il fallait automatiser davantage.
Étant donné que tout cela était à distance, la plupart des clients étaient dans le cloud. Beaucoup de choses étaient déjà évidentes à automatiser. Nous en reparlerons plus tard. Cela a donc débouché sur l'idée qu'il fallait une série d'outils, c'est-à-dire une sorte de plateforme qui automatise pratiquement toutes les tâches des DBA, pour pouvoir gérer un plus grand nombre de bases.
Dans cette présentation, il n'y aura pas :
- de « balles d'argent » ou d'affirmations telles que – mettez 8 Go ou 25 % de shared_buffers et vous serez bien. Nous ne parlerons pas beaucoup de shared_buffers.
- Des «intérieurs» hardcore.
Et qu'est-ce qui va se passer ?
- Il y aura des principes d'optimisation que nous appliquons et développons. Il y aura diverses idées qui surgissent sur notre chemin et différents outils que nous créons principalement en Open Source, c'est-à-dire que nous basons la majeure partie dans l'Open Source. De plus, nous avons des tickets, presque toute notre communication se fait dans l'Open Source. Vous pouvez voir ce que nous faisons actuellement, ce qui sera dans la prochaine version, etc.
- Il y aura également certaines expériences d'utilisation de ces principes et outils dans plusieurs entreprises : des petites startups aux grandes sociétés.
Comment tout cela évolue-t-il ?
Tout d'abord, la principale tâche d'un DBA, en plus de garantir la création d'instances, le déploiement de sauvegardes, etc., est de rechercher les goulets d'étranglement et d'optimiser la performance.
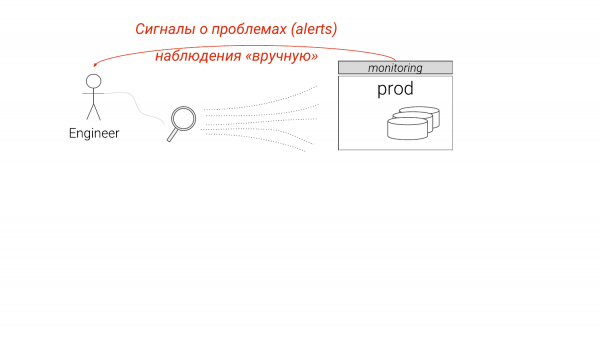
Actuellement, cela fonctionne comme suit. Nous regardons la supervision, nous voyant certaines choses, nous manquons de détails. Nous commençons à fouiller plus attentivement, généralement à la main, et comprenons ce qu'il faut en faire de toute façon.
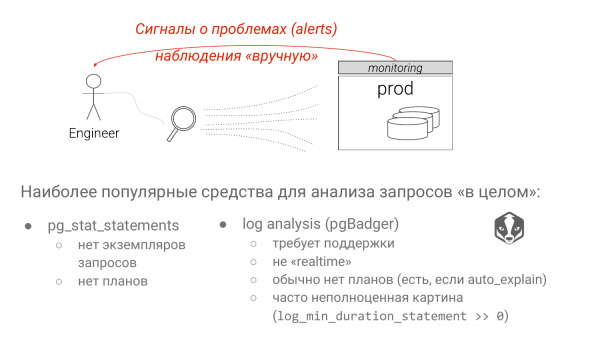
Et il y a deux approches. Pg_stat_statements est la solution standard par défaut pour identifier les requêtes lentes. Et l'analyse des journaux Postgres à l'aide de pgBadger.
Chacune des approches a des défauts sérieux. Dans la première approche, tous les paramètres sont ignorés. Et si nous voyons des groupes SELECT * FROM table where la colonne est égale à «?» ou «$» à partir de la version Postgres 10. Nous ne savons pas si c'est un index scan ou un seq scan. Cela dépend beaucoup du paramètre. Si vous y insérez une valeur rarement rencontrée, ce sera un index scan. Si vous y insérez une valeur qui représente 90 % de la table, ce sera un seq scan évidemment, car Postgres connaît les statistiques. Et c'est un grand inconvénient de pg_stat_statements, bien que des travaux soient en cours.
L'inconvénient principal de l'analyse des journaux est que vous ne pouvez généralement pas vous permettre que «log_min_duration_statement = 0». Et nous allons également parler de cela. En conséquence, vous ne voyez pas l'ensemble du tableau. Une requête qui est très rapide peut consommer une énorme quantité de ressources, mais vous ne la verrez pas car elle est en dessous de votre seuil.
Comment les DBA résolvent-ils les problèmes identifiés ?
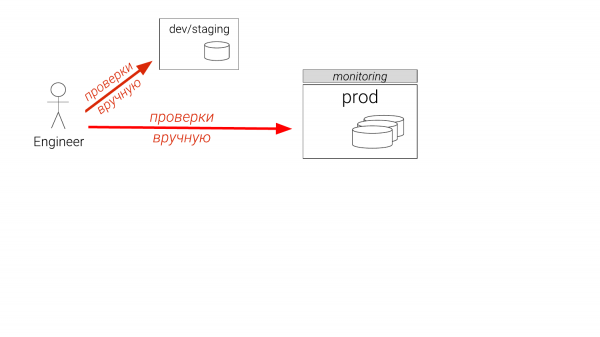
Par exemple, nous avons trouvé un problème. Que fait-on généralement ? Si vous êtes développeur, vous travaillerez sur une instance de taille non optimale. Si vous êtes DBA, vous avez un environnement de staging. Et il ne peut y en avoir qu'un seul. Et cela a six mois de retard. Vous pensez que vous pouvez passer en production. Même les DBA expérimentés vérifient ensuite en production, sur une réplique. Parfois, ils créent un index temporaire, s'assurent qu'il est utile, le suppriment et le renvoient aux développeurs pour qu'ils l'incluent dans les fichiers de migration. Voilà à quoi cela ressemble aujourd'hui. Et c'est un problème.
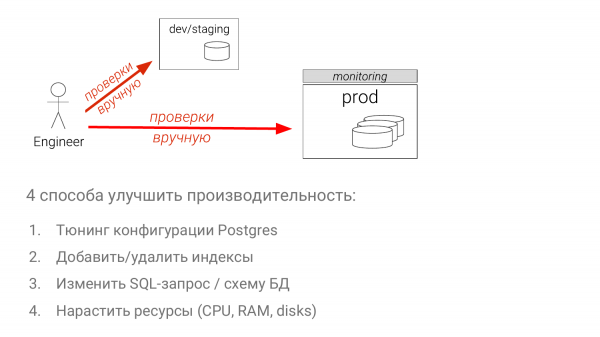
- Optimiser les configurations.
- Optimiser l'ensemble des index.
- Modifier la requête SQL elle-même (c'est la méthode la plus complexe).
- Ajouter des ressources (c'est généralement la méthode la plus simple).
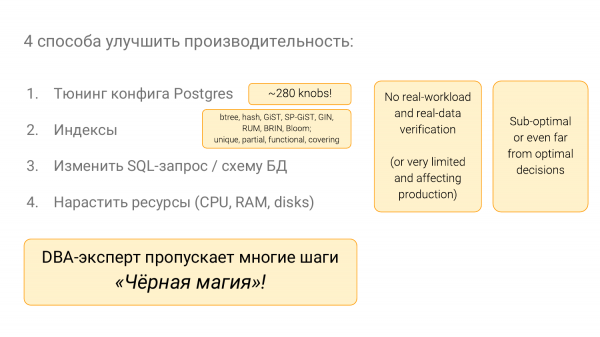
Il y a énormément de choses à connaître à ce sujet. Il y a beaucoup de nuances dans Postgres. Il faut en savoir beaucoup. Beaucoup d'index dans Postgres, grâce notamment aux organisateurs de cette conférence. Et il faut tout savoir, c'est ce qui donne aux non-DBA l'impression que les DBA pratiquent une magie noire. En d'autres termes, il faut environ dix ans pour bien comprendre tout cela.
Et je suis un combattant de cette magie noire. Je veux que tout soit fait de manière technologique et qu'il n'y ait pas d'intuition dans tout cela.
Exemples de la vie réelle
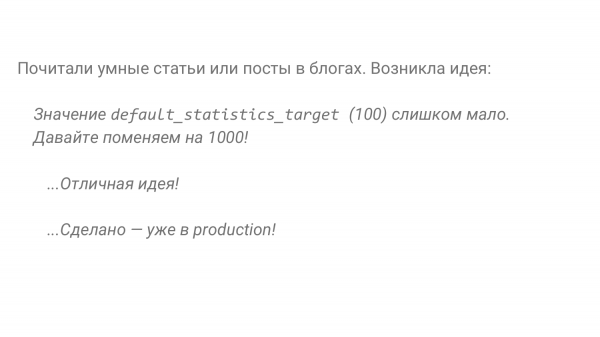
J'ai observé cela dans au moins deux projets, y compris le mien. Un autre billet de blog nous dit que la valeur 1000 pour default_statistic_target est correcte. D'accord, essayons cela en production.
Et ici, nous, en utilisant notre outil deux ans plus tard avec des expériences sur des bases de données dont nous parlons aujourd'hui, nous pouvons comparer ce qui était et ce qui est devenu.
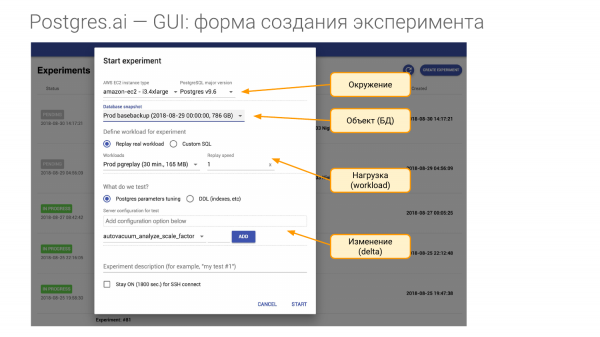
Et pour cela, nous devons créer une expérience. Elle se compose de quatre parties.
- La première est l'environnement. Nous avons besoin du matériel. Lorsque je viens dans une entreprise et que je signe un contrat, je demande qu'on me donne un matériel identique à celui de la production. Pour chacun de vos Masters, j'ai besoin d'au moins un matériel identique. Que ce soit une machine virtuelle dans Amazon ou Google, ou que j'ai besoin exactement du même matériel. En d'autres termes, je veux reproduire l'environnement. Et dans la notion d'environnement, nous incluons la version majeure de Postgres.
- La deuxième partie concerne l'objet de nos recherches. C'est la base de données. Elle peut être créée de plusieurs manières. Je vais montrer comment.
- La troisième partie est la charge. C'est le moment le plus complexe.
- Et la quatrième partie consiste à vérifier ce que nous allons comparer. Par exemple, nous pouvons modifier un ou plusieurs paramètres dans la configuration, ou nous pouvons créer un index, etc.
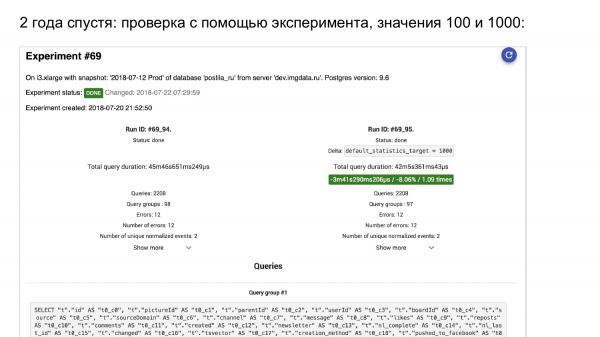
Nous lançons une expérience. Voici pg_stat_statements. À gauche, ce qui était. À droite, ce qui est devenu.
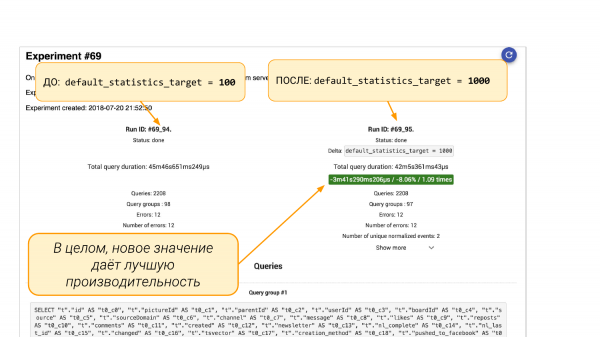
À gauche, default_statistics_target = 100, à droite = 1 000. Nous voyons que cela nous a aidés. En général, cela s'est amélioré de 8 %.
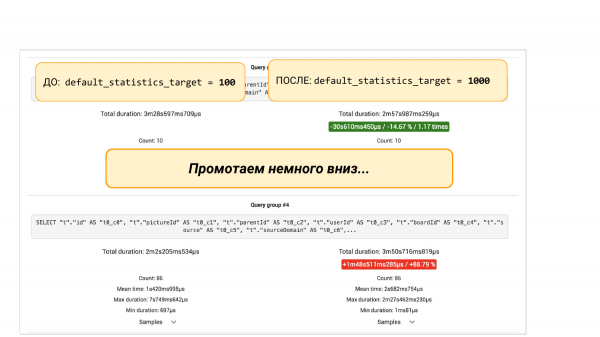
Mais si nous faisons défiler vers le bas, nous verrons des groupes de requêtes provenant de pgBadger ou de pg_stat_statements. Il y a deux options. Nous allons voir qu'une certaine requête a chuté de 88 %. Et c'est ici que l'approche ingénierie entre en jeu. Nous pouvons approfondir, car il est intéressant de comprendre pourquoi elle a chuté. Il faut comprendre ce qui s'est passé avec les statistiques. Pourquoi plus de buckets dans les statistiques conduisent à des résultats pires.
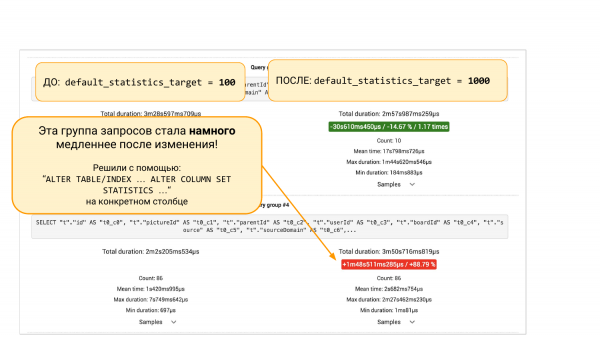
Ou nous pouvons ne pas approfondir, mais faire un « ALTER TABLE … ALTER COLUMN » et ramener 100 buckets dans la statistique de cette colonne. Ensuite, par une autre expérience, nous pouvons nous assurer que ce correctif a aidé. Voilà. C'est l'approche ingénierie qui nous aide à voir le tableau et à prendre des décisions basées sur des données, et non sur l'intuition.
Quelques exemples d'autres domaines. Dans les tests, il existe des tests CI depuis de nombreuses années. Et aucun projet sensé ne fonctionnerait sans tests automatisés.
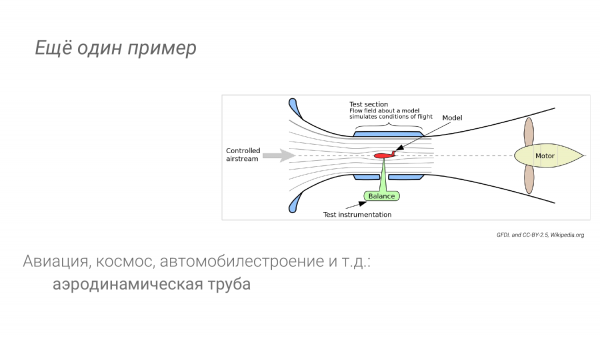
Dans d'autres secteurs : dans l'aviation, dans l'automobile, lorsque nous testons l'aérodynamique, nous avons également la possibilité de faire des expériences. Nous ne mettrons pas quelque chose du dessin directement dans l'espace, ni ne mettrons une voiture directement sur la route. Par exemple, il y a une soufflerie.
Des observations d'autres secteurs nous permettent de tirer des conclusions.
Tout d'abord, nous avons un environnement spécial. Il est proche de la production, mais pas tout à fait. Sa principale caractéristique est qu'il doit être bon marché, répétable et aussi automatisé que possible. De plus, il doit y avoir des moyens spéciaux pour réaliser une analyse détaillée.
Il est probable que lorsque nous avons lancé l'avion et que nous volons, nous avons moins d'opportunités d'étudier chaque millimètre de la surface de l'aile que ce que nous avons dans une soufflerie. Nous avons plus de moyens pour le diagnostic. Nous pouvons nous permettre d'accrocher davantage de choses lourdes que nous ne pouvons pas nous permettre d'introduire dans l'avion en vol. Il en va de même avec Postgres. Dans certains cas, nous pouvons activer la journalisation complète des requêtes lors des expériences. Et nous ne voulons pas faire cela en production. Nous pourrions même activer cela avec les plans grâce à auto_explain.
Et comme je l'ai déjà dit, un haut niveau d'automatisation signifie que nous avons appuyé sur un bouton et répété. C'est ainsi que cela doit être, pour qu'il y ait beaucoup d'expériences, pour que cela soit en continu.
Nancy CLI – la base du « laboratoire de base de données »
Et nous avons créé quelque chose comme ça. C'est-à-dire que j'ai parlé de ces idées en juin, il y a presque un an. Et nous avons déjà dans l'Open Source ce qu'on appelle Nancy CLI. C'est la base pour construire un laboratoire de base de données.
– C'est dans l'Open Source, sur Gitlab. Vous pouvez le dire, vous pouvez l'essayer. J'ai donné un lien dans les diapos. Vous pouvez cliquer dessus et y accéder. pour tous les paramètres.
Bien sûr, beaucoup de choses sont encore en développement. Il y a beaucoup d'idées. Mais c'est déjà quelque chose que nous utilisons pratiquement tous les jours. Et quand nous avons une idée – par exemple, que se passe-t-il lorsque nous supprimons 40 000 000 de lignes et que tout est bloqué dans les E/S, nous pouvons mener une expérience et examiner cela de plus près pour comprendre ce qui se passe et ensuite tenter de le corriger en cours de route. C'est-à-dire que nous menons une expérience. Par exemple, nous ajustons quelque chose et voyons quel est le résultat. Et nous ne le faisons pas en production. C'est l'essence de l'idée.
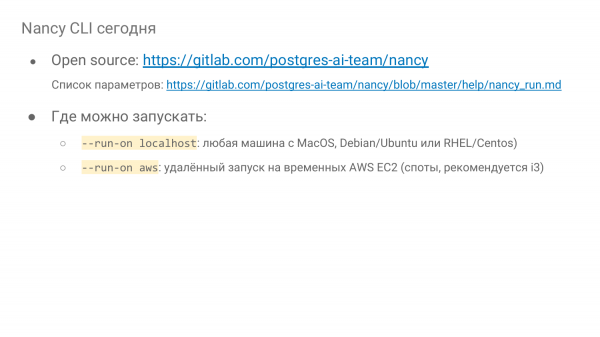
Où cela peut-il fonctionner ? Cela peut fonctionner localement, c'est-à-dire que cela peut être fait partout, même sur un MacBook. Vous avez besoin de Docker, allons-y. Et voilà. Vous pouvez le lancer sur un serveur physique, ou dans une machine virtuelle, n'importe où.
Il existe également la possibilité de lancer des instances EC2 sur Amazon, en spots. C'est une fonctionnalité très intéressante. Par exemple, hier, nous avons réalisé plus de 500 expériences sur une instance i3, allant de la plus petite à l'i3-16-xlarge. Et ces 500 expériences ne nous ont coûté que 64 dollars. Chacune a duré 15 minutes. Grâce aux spots, cela reste très abordable – avec une remise de 70 %, et la facturation à la seconde d'Amazon. Vous pouvez réaliser énormément de choses. Vous pouvez mener des recherches concrètes.
Trois versions majeures de Postgres sont prises en charge. Ce n'est pas si difficile de peaufiner certaines anciennes versions et la nouvelle version 12 également.
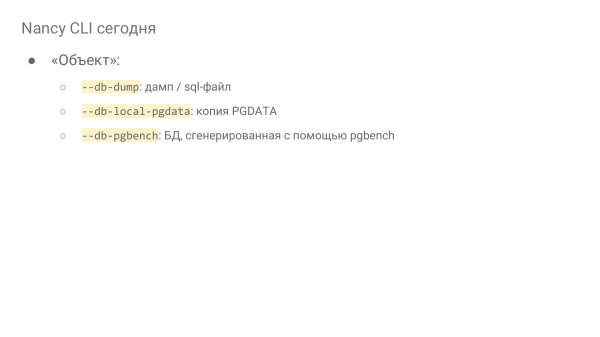
Nous pouvons définir l'objet de trois manières. Ce sont :
- Dump/fichier sql.
- La méthode principale est de cloner le répertoire PGDATA. En général, cela se fait à partir d'un serveur de sauvegarde. Si vous avez de bonnes sauvegardes binaires, vous pouvez en faire des clones. Si vous avez des solutions cloud, c'est le fournisseur de cloud comme Amazon ou Google qui s'en occupera. C'est la méthode principale pour cloner un environnement de production réel. C'est de cette manière que nous déployons.
- Et la dernière méthode est adaptée aux recherches, quand on souhaite comprendre comment certaines choses fonctionnent dans Postgres. C'est pgbench. Vous pouvez générer avec pgbench. C'est simplement une option 'db-pgbench'. Vous lui indiquez l'échelle. Et tout sera généré dans le cloud comme prévu.
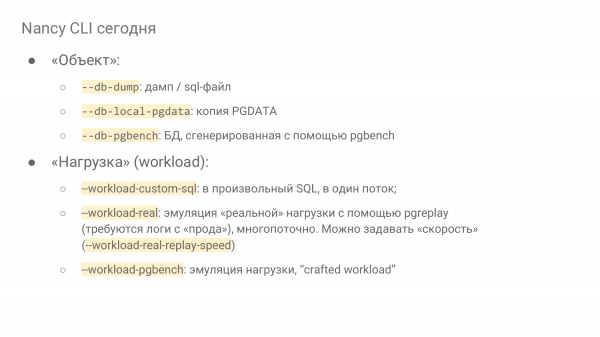
Et la charge :
- Nous pouvons exécuter la charge en un seul flux SQL. C'est la méthode la plus basique.
- Ou nous pouvons émuler la charge. Et nous pouvons l'émuler principalement de la manière suivante. Nous devons rassembler tous les logs. Et c'est douloureux. Je vais vous montrer pourquoi. Et avec pgreplay, qui est intégré dans Nancy, nous le reproduisons.
- Ou une autre option. Ce qu'on appelle une charge artisanale, que nous réalisons avec un certain effort. En analysant notre charge actuelle sur le système de production, nous extrayons les groupes de requêtes les plus fréquents. Et avec pgbench, nous pouvons émuler cette charge en laboratoire.
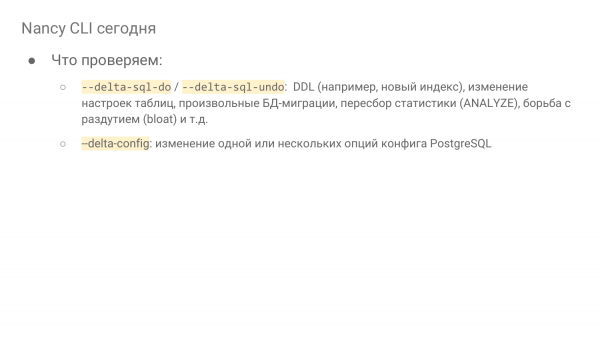
- Ou nous devons exécuter une requête SQL, par exemple pour vérifier une migration, créer un index, exécuter ANALYZE. Et nous voyons ce qu'il y avait avant et après le vide. En somme, n'importe quel SQL.
- Soit nous modifions un ou plusieurs paramètres dans la configuration. Nous pouvons demander par exemple de vérifier 100 valeurs sur Amazon pour notre base de données d'un téraoctet. Et après quelques heures, vous aurez le résultat. En général, la mise en place d'une base d'un téraoctet prend plusieurs heures. Mais en développement, il existe un patch, ce qui signifie que vous pouvez utiliser la même pgdata de manière séquentielle sur le même serveur et effectuer des vérifications. Postgres va redémarrer, les caches vont être réinitialisés. Et vous pouvez exécuter des charges.
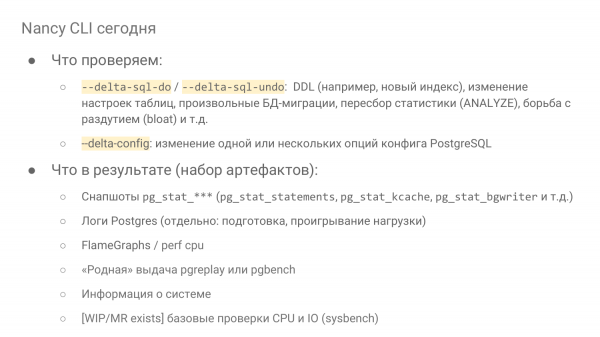
- Une répertoire arrive, contenant une multitude de petits fichiers, allant des snapshots pg.stat***. Et là où cela devient intéressant, ce sont pg_stat_statements et pg_stat_kcache. Ce sont deux extensions qui analysent les requêtes. Et pg_stat_bgwriter contient non seulement des statistiques sur pgwriter, mais aussi sur les checkpoints et sur la manière dont les backend évacuent les buffers sales. Tout cela mérite d'être examiné. Par exemple, lorsque nous configurons shared_buffers, il est très intéressant de voir quelles ont été les évacuations.
- Des journaux Postgres arrivent également. Deux journaux : le journal de préparation et le journal de lecture des charges.
- Une fonctionnalité relativement nouvelle – ce sont les FlameGraphs.
- De plus, si vous avez utilisé pgreplay ou les options pgbench pour lire les charges, leur sortie sera d'origine. Vous verrez la latence et le TPS. Vous pourrez comprendre comment ils l'ont perçu.
- Informations sur le système.
- Vérifications de base du CPU et des IO. Cela concerne davantage les instances EC2 sur Amazon, lorsque vous souhaitez lancer 100 instances identiques en parallèle et y exécuter 100 tests différents, vous aurez alors 10 000 expériences. Vous devez vous assurer que vous n'avez pas eu d'instance défectueuse, déjà soumise à contrainte. Sur ce matériel, d'autres utilisent des ressources et il vous en restera peu. Il vaut mieux jeter ces résultats. Grâce à sysbench d'Alexey Kopytov, nous effectuons plusieurs vérifications rapides qui arrivent et peuvent être comparées avec d'autres, c'est-à-dire que vous comprendrez comment le CPU se comporte et comment l'IO se comporte.
Quelles sont les difficultés techniques sur l'exemple de différentes entreprises ?
Supposons que nous souhaitons reproduire une charge réelle à l'aide des journaux. Excellente idée, si cela a été écrit sur Open Source pgreplay. Nous l'utilisons. Mais pour qu'il fonctionne bien, vous devez activer la journalisation complète des requêtes avec les paramètres et les temps de réponse.
Il y a certaines complexités concernant la durée et le timestamp. Nous allons ignorer toute cette complexité. La question principale est : pouvez-vous vous permettre cela ou non ?
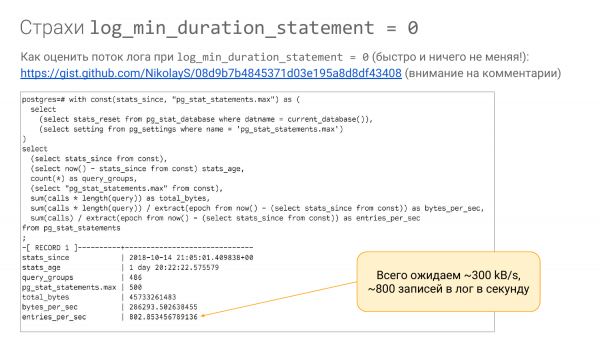
Le problème est que cela peut ne pas être accessible. Vous devez d'abord comprendre quel flux sera écrit dans le log. Si vous avez pg_stat_statements, vous pouvez utiliser cette requête (un lien sera disponible dans les diapositives) pour évaluer combien de bytes seront écrits par seconde.
Nous regardons la longueur de la requête. Nous négligeons le fait qu'il n'y ait pas de paramètres, mais nous connaissons la longueur de la requête et combien de fois elle a été exécutée par seconde. Ainsi, nous pouvons estimer combien de bytes seront écrits par seconde. Nous pouvons nous tromper d'un facteur deux, mais l'ordre de grandeur sera correct.
Nous pouvons voir que cette requête s'exécute 802 fois par seconde. Et nous voyons que le débit est d'environ 300 kB/s. En général, nous pouvons nous permettre un tel flux.
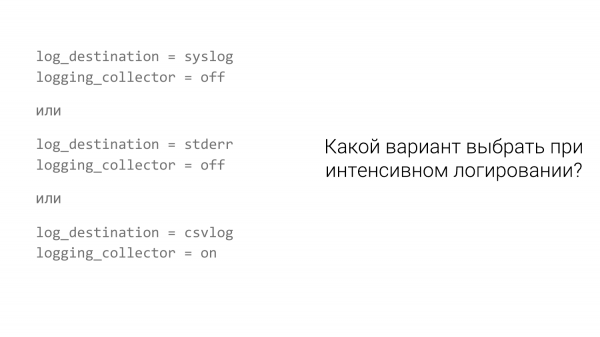
Mais ! Le fait est qu'il existe différents systèmes de journalisation. Par défaut, les gens utilisent généralement « syslog ».
Et si vous avez syslog, vous pouvez avoir une image comme celle-ci. Nous prendrons pgbench, activerons la journalisation des requêtes et verrons ce qui en résulte.
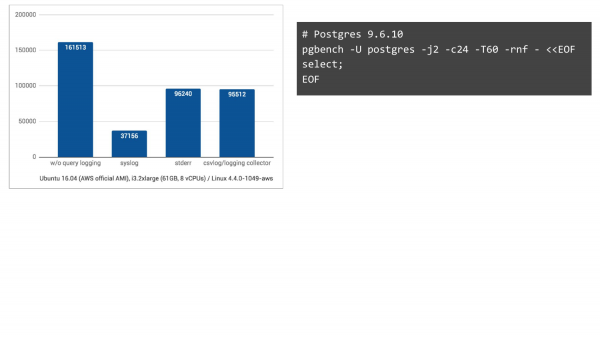
Sans journalisation, c'est la colonne de gauche. Nous avons obtenu 161 000 TPS. Avec syslog – sous Ubuntu 16.04 sur Amazon, nous obtenons 37 000 TPS. Et si nous passons à deux autres méthodes de journalisation, la situation s'améliore considérablement. En d'autres termes, nous nous attendions à une baisse, mais pas à ce point.
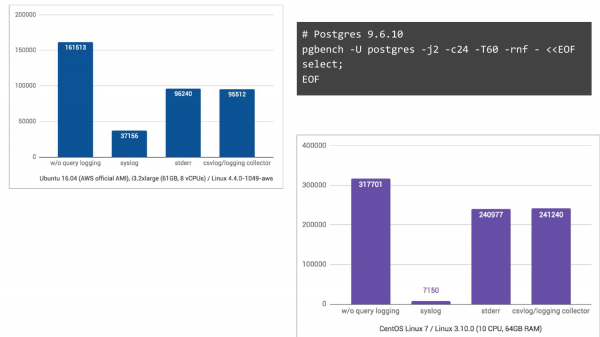
Et sous CentOS 7, où journald est également impliqué, transformant les logs en format binaire pour une recherche facile, c'est un véritable cauchemar, nous perdons 44 fois en TPS.
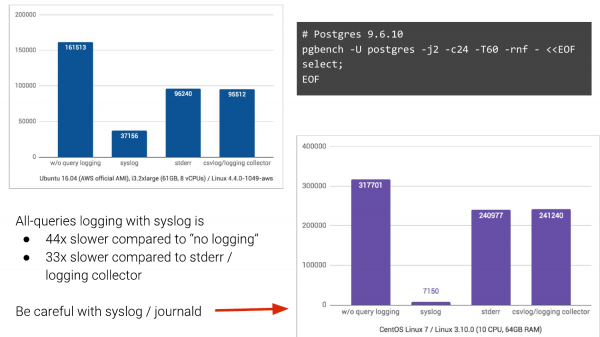
Et c'est ce avec quoi les gens doivent composer. Et souvent, dans les entreprises, surtout les grandes, il est très difficile de changer cela. Si vous pouvez vous éloigner de syslog, n'hésitez pas à le faire.
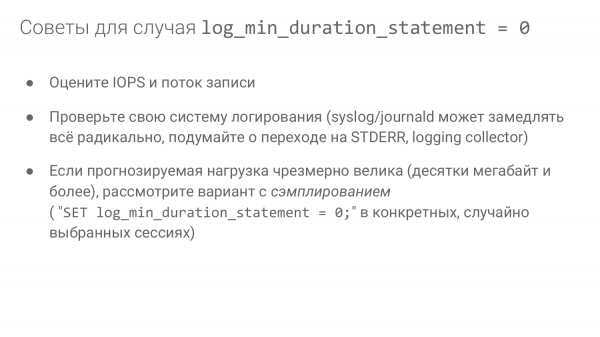
- Évaluez les IOPS et le débit d'écriture.
- Vérifiez votre système de journalisation.
- Si la charge prévue est excessivement élevée, envisagez l'option d'échantillonnage.
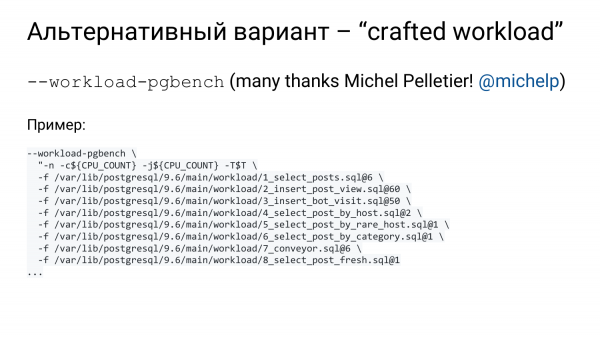
Nous avons pg_stat_statements. Comme je l'ai dit, il doit absolument être présent. Nous pouvons prendre chaque groupe de requêtes et le décrire de manière spécifique dans un fichier. Ensuite, nous pouvons utiliser une fonctionnalité très pratique dans pgbench – la possibilité d'introduire plusieurs fichiers à l'aide de l'option « -f ».
Il comprend beaucoup de « -f ». Et on peut dire avec « @ » à la fin quelle part chaque fichier doit avoir. C'est-à-dire qu'on peut dire que celui-ci doit être exécuté dans 10 % des cas, et celui-là dans 20 %. Cela nous rapprochera de ce que nous voyons en production.
Comment comprendrons-nous ce que nous avons en production ? Quelle part et quoi exactement ? Ici, il y a un léger détour. Nous avons un autre produit. . C'est aussi une base en Open Source. Et nous sommes en train de le développer activement.
Il est né pour des raisons un peu différentes. Parce qu'il y a un manque de surveillance. C'est-à-dire que vous arrivez, vous regardez la base, vous examinez les problèmes qui existent. En règle générale, vous effectuez un health_check. Si vous êtes un DBA expérimenté, vous effectuez un health_check. Vous avez vérifié l'utilisation des index, etc. Si vous avez OKmeter, c'est super. C'est un excellent outil de surveillance pour Postgres. OKmeter.io – s'il vous plaît, installez-le, c'est très bien fait. C'est payant.
Si vous ne l'avez pas, en règle générale, vous avez très peu de données. En surveillance, il y a généralement le CPU, l'IO et sans beaucoup de détails, c'est tout. Nous avons besoin de plus. Nous avons besoin de voir comment fonctionne l'autovacuum, comment fonctionne le checkpoint, et dans l'IO, nous devons séparer le checkpoint du bgwriter et des backends, etc.
Le problème, c'est que lorsque vous aidez une grande entreprise, ils ne peuvent pas mettre en œuvre quelque chose rapidement. Ils ne peuvent pas acheter OKmeter rapidement. Peut-être qu'ils l'achèteront dans six mois. Ils ne peuvent pas installer rapidement certains paquets.
Et nous avons eu l'idée qu'il nous fallait un outil spécial qui ne nécessite rien en termes d'installation, c'est-à-dire que vous ne devez rien installer en production. Vous l'installez sur votre ordinateur portable ou sur un serveur d'observation, depuis lequel vous allez l'exécuter. Et il va analyser beaucoup de choses : le système d'exploitation, le système de fichiers, et même Postgres, en faisant des requêtes légères que vous pouvez exécuter directement en production sans rien faire tomber.
Nous l'avons appelé Postgres-checkup. En termes médicaux, c'est un contrôle régulier de la santé. Dans le domaine automobile, c'est comme un entretien. Vous faites un entretien pour votre voiture tous les six mois ou chaque année, selon la marque. Mais faites-vous un entretien pour votre base de données ? C'est-à-dire effectuez-vous une recherche approfondie régulièrement ? Cela doit être fait. Si vous faites des sauvegardes, faites aussi un checkup, c'est tout aussi important.
Et nous avons un tel outil. Il a commencé à se développer activement il y a seulement trois mois. Il est encore jeune, mais il y a déjà beaucoup de fonctionnalités.
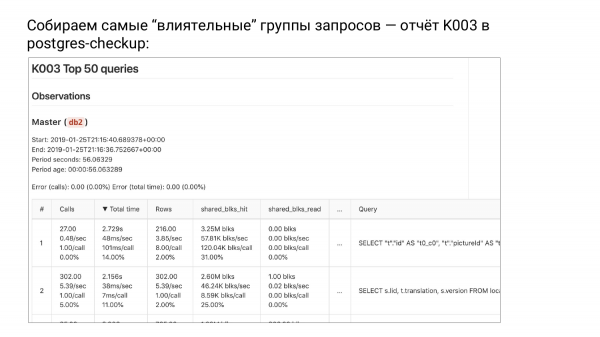
Nous rassemblons les groupes de requêtes les plus « influents » – rapport K003 dans Postgres-checkup
Il existe un groupe de rapports K. Pour le moment, trois rapports. Et il y a ce rapport K003. C'est le sommet de pg_stat_statements, trié par total_time.
Lorsque nous trions les groupes de requêtes par total_time, nous observons un groupe en tête qui sollicite le plus notre système, c'est-à-dire qui consomme le plus de ressources. Pourquoi parle-t-on de groupes de requêtes ? Parce que nous avons éliminé les paramètres. Ce ne sont plus des requêtes, mais des groupes de requêtes, c'est-à-dire qu'ils sont abstraits.
En optimisant de haut en bas, nous allégeons nos ressources et repoussons le moment où nous devrons effectuer une mise à niveau. C'est un excellent moyen d'économiser de l'argent.
Cela dit, ce n'est peut-être pas la meilleure approche en matière de satisfaction des utilisateurs, car nous ne voyons peut-être pas des cas rares mais très gênants où une personne a dû attendre 15 secondes. Ces cas sont si rares qu'ils passent inaperçus, mais nous gérons les ressources.
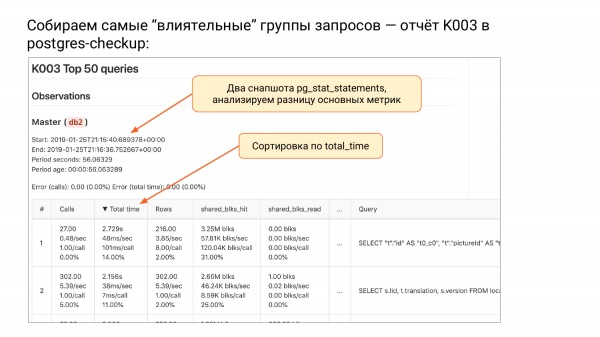
Que s'est-il passé dans ce tableau ? Nous avons fait deux instantanés. Postgres_checkup vous donnera la différence pour chaque métrique : total-time, appels, lignes, shared_blks_read, etc. Voilà, la différence est calculée. Un gros problème avec pg_stat_statements est qu'il n'oublie pas quand il y a eu réinitialisation. Pendant que pg_stat_database s'en souvient, pg_stat_statements ne s'en souvient pas. Vous voyez un nombre de 1 000 000, mais nous ne savons pas d'où nous l'avons calculé.
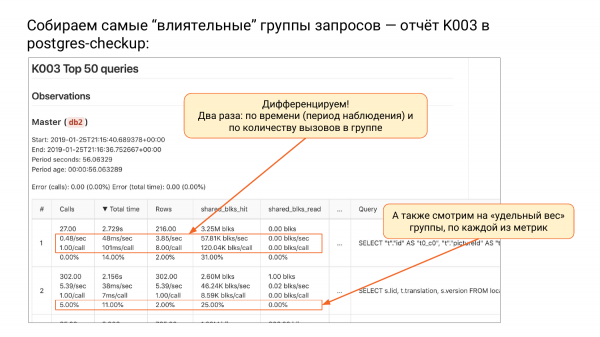
Ici, nous savons, nous avons deux instantanés. Nous savons que la différence dans ce cas était de 56 secondes. Un intervalle très court. Nous avons trié par total_time. Ensuite, nous pouvons différencier, c'est-à-dire que nous divisons toutes les métriques par la durée. Si nous divisons chaque métrique par la durée, nous obtenons le nombre d'appels par seconde.
Ensuite, total_time par seconde – c'est ma métrique préférée. Elle est mesurée en secondes, par seconde, c'est-à-dire combien de secondes notre système a mises pour exécuter ce groupe de requêtes par seconde. Si vous voyez plus d'une seconde par seconde, cela signifie que vous auriez eu besoin de plus d'un cœur. C'est une très bonne métrique. Vous pouvez comprendre que cette personne, par exemple, a besoin d'au moins trois cœurs.
Voici notre innovation, je n'ai jamais vu cela ailleurs. Faites attention – c'est une chose très simple – une seconde par seconde. Parfois, lorsque votre CPU est à 100 %, pendant une demi-heure par seconde, c'est-à-dire que vous n'avez traité que ces requêtes pendant une demi-heure.
Nous voyons ensuite les lignes par seconde. Nous savons combien de lignes ont été renvoyées par seconde.
Et ensuite, il y a aussi une chose intéressante. Combien d'entrées nous avons lues de shared_buffers par seconde. Les hits y étaient déjà, et les lignes ont été prises dans le cache du système d'exploitation, ou sur le disque. La première option est rapide, tandis que la seconde peut être rapide ou non, cela dépend de la situation.
La deuxième méthode de différenciation consiste à diviser le nombre de requêtes dans ce groupe. Dans la deuxième colonne, vous aurez toujours une requête divisé par requête. Et ensuite, c'est intéressant – combien de millisecondes ont été nécessaires pour cette requête. Nous savons comment cette requête se comporte en moyenne. Il fallait 101 millisecondes pour chaque requête. C'est une métrique traditionnelle qui est nécessaire pour notre compréhension.
Combien de lignes chaque requête a renvoyées en moyenne. Nous voyons que ce groupe renvoie 8. Combien en moyenne ont été récupérées et lues depuis le cache. Nous constatons que tout est parfaitement mis en cache. Un taux de hits constant pour le premier groupe.
Et la quatrième sous-ligne dans chaque ligne – c'est combien de pourcentage du nombre total. Nous avons des appels. Disons, à 1 000 000. Et nous pouvons comprendre quelle contribution ce groupe apporte. Nous voyons qu'ici, le premier groupe contribue à moins de 0,01 %. C'est-à-dire qu'il est si lent que nous ne le voyons pas dans le tableau général. Et le deuxième groupe – 5 % des appels. C'est-à-dire que 5 % de tous les appels proviennent du deuxième groupe.
Pour total_time, c'est aussi intéressant. Pour le premier groupe de requêtes, nous avons dépensé 14 % de tout le temps de fonctionnement. Et pour le second – 11 %, etc.
Je ne vais pas entrer dans les détails, mais il y a des subtilités. Nous affichons une erreur en haut, car lorsque nous comparons, les instantanés peuvent être décalés, c'est-à-dire que certaines requêtes peuvent disparaître et ne plus apparaître dans le deuxième instantané, tandis que d'autres peuvent apparaître. Et nous calculons l'erreur là-bas. Si vous voyez 0, c'est bien. Cela signifie qu'il n'y a pas d'erreurs. Si le taux d'erreur est jusqu'à 20 %, c'est OK.
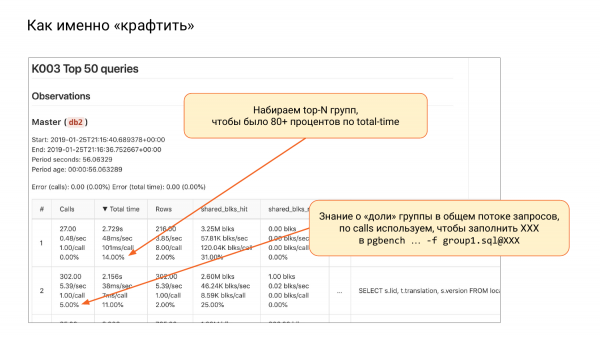
Nous revenons ensuite à notre thème. Nous devons concevoir une charge de travail. Nous procédons de haut en bas jusqu'à ce que nous atteignions 80 % ou 90 %. En général, cela représente 10 à 20 groupes. Et nous préparons des fichiers pour pgbench. Là, nous utilisons random. Malheureusement, cela ne fonctionne pas toujours. Et dans Postgres 12, il y aura plus de possibilités d'utiliser cette approche.
Et ensuite, nous obtenons ainsi 80-90 % sur le total_time. Que devons-nous mettre après «@» ? Nous regardons les appels, nous vérifions le pourcentage et nous comprenons que nous devrions avoir ce pourcentage ici. À partir de ces pourcentages, nous pouvons comprendre comment équilibrer chacun des fichiers. Après cela, nous utilisons pgbench et nous commençons à travailler.
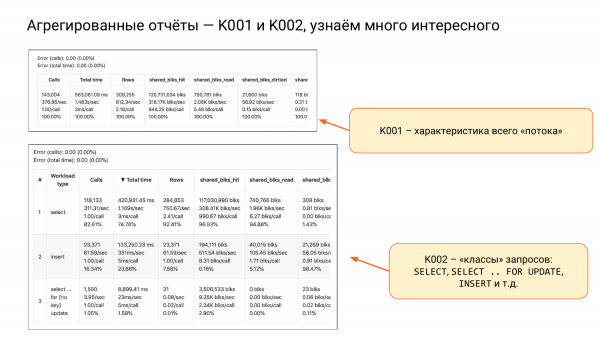
Nous avons aussi K001 et K002.
K001 est une grande chaîne avec quatre sous-chaînes. C'est la caractéristique de notre charge globale. Regardez la deuxième colonne et la deuxième sous-chaîne. Nous voyons qu'il y a environ une seconde et demie par seconde, c'est-à-dire que si nous avons deux cœurs, ce sera bien. Cela donnera environ 75 % de charge. Et cela fonctionnera ainsi. Si nous avons 10 cœurs, nous serons complètement tranquilles. Ainsi, nous pouvons évaluer les ressources.
K002 est ce que j'appelle les classes de requêtes, c'est-à-dire SELECT, INSERT, UPDATE, DELETE. Et séparément SELECT FOR UPDATE, car il bloque.
Et ici, nous pouvons conclure que les SELECT normaux de lecture représentent 82 % de tous les appels, mais en même temps, ils consomment 74 % du total_time. C'est-à-dire qu'ils sont souvent appelés, mais consomment moins de ressources.
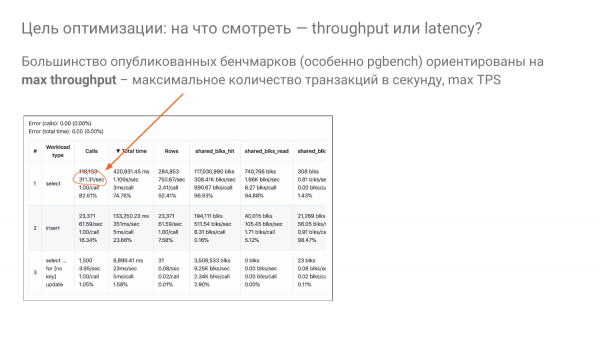
Et revenons à la question : « Comment choisir correctement les shared_buffers ? ». Je constate que la plupart des benchmarks sont basés sur l'idée de regarder quel sera le throughput, c'est-à-dire quelle sera la capacité de traitement. Cela est généralement mesuré en TPS ou en QPS.
Et nous essayons d'optimiser les paramètres de réglage pour obtenir le maximum de transactions par seconde. Ici, il s'agit de 311 par seconde pour les sélections.
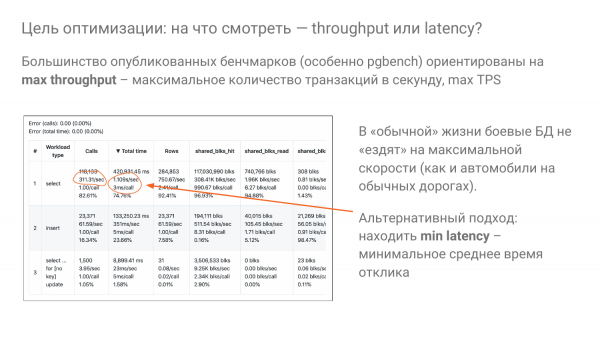
Mais personne ne va travailler et revenir chez soi en voiture à pleine vitesse. C'est stupide. Il en va de même pour les bases de données. Nous ne devrions pas fonctionner à pleine vitesse, personne ne le fait d'ailleurs. Personne ne vit dans une production avec 100 % de CPU. Bien que, peut-être, certains le fassent, mais ce n'est pas bon.
L'idée est que nous fonctionnons généralement à environ 20 % de notre capacité, de préférence pas plus de 50 %. Et nous essayons d'optimiser le temps de réponse pour nos utilisateurs en premier lieu. Cela signifie que nous devons ajuster nos paramètres de manière à minimiser la latence à une vitesse de 20 %, de manière conditionnelle. C'est une idée que nous essayons également d'utiliser dans nos expériences.
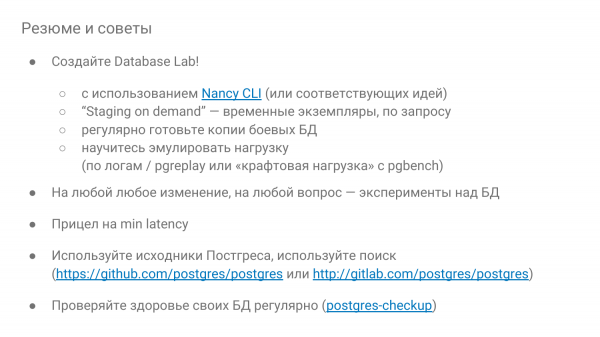
Et pour conclure, voici quelques recommandations :
- Assurez-vous de créer un Database Lab.
- Si possible, faites-le à la demande, de sorte qu'il se déploie pour un certain temps - jouez avec et détruisez-le ensuite. Si vous êtes dans le cloud, cela va de soi, c'est-à-dire ayez beaucoup de standing.
- Soyez curieux. Et si quelque chose ne va pas, vérifiez par des expériences comment cela se comporte. On peut utiliser Nancy pour s'entraîner et voir comment fonctionne la base.
- Et visez un temps de réponse minimal.
- Et n'ayez pas peur des sources de Postgres. Lorsque vous travaillez avec les sources, vous devez connaître l'anglais. Il y a beaucoup de commentaires, tout est expliqué.
- Et vérifiez régulièrement la santé de la base, au moins une fois tous les trois mois manuellement, ou avec Postgres-checkup.
Questions
Merci beaucoup ! C'est très intéressant.
Deux choses.
Oui, deux choses. Mais je n'ai pas tout à fait compris. Lorsque nous travaillons avec Nancy, ne pouvons-nous ajuster qu'un seul paramètre ou tout un groupe ?
Nous avons un paramètre delta-config. Vous pouvez en modifier autant que vous le souhaitez en même temps. Mais il faut comprendre que lorsque vous changez beaucoup de choses, vous pourriez tirer des conclusions erronées.
Oui. Pourquoi ai-je demandé ? Parce qu'il est difficile de mener des expériences lorsque vous avez seulement un paramètre. Vous l'ajustez, vous regardez comment cela fonctionne. Vous l'installez. Puis vous commencez avec le suivant.
Vous pouvez ajuster plusieurs paramètres en même temps, mais cela dépend de la situation, bien sûr. Mais il vaut mieux vérifier une seule idée à la fois. Hier, nous avons eu une idée. Nous avions une situation très similaire. Il y avait deux configs. Et nous ne comprenions pas pourquoi il y avait une si grande différence. Nous avons eu l'idée d'utiliser la dichotomie pour comprendre successivement et trouver en quoi cela différait. On peut commencer par rendre la moitié des paramètres identiques, puis un quart, etc. C'est tout flexible.
Et j'ai une autre question. Le projet est jeune, il évolue. La documentation est-elle déjà prête, y a-t-il une description détaillée ?
J'ai mis un lien spécialement vers la description des paramètres. Cela existe. Mais il y a encore beaucoup de choses qui manquent. Je cherche des personnes partageant les mêmes idées. Et je les trouve lorsque je fais des présentations. C'est vraiment génial. Certaines personnes travaillent déjà avec moi, d'autres m'ont aidé et ont fait quelque chose. Et si ce sujet vous intéresse, faites-moi savoir ce qui manque.
Une fois que nous aurons établi le laboratoire, il pourrait y avoir des retours. Nous verrons. Merci !
Bonjour ! Merci pour la présentation ! J'ai vu qu'il y a un soutien pour Amazon. Une prise en charge de GSP est-elle prévue ?
C'est une bonne question. Nous avons commencé à travailler là-dessus. Et pour l'instant, c'est en pause, car nous voulons économiser. C'est-à-dire qu'il y a un support via l'exécution sur localhost. Vous pouvez créer une instance vous-même et travailler localement. D'ailleurs, c'est ce que nous faisons. Je fais cela sur Getlab, là sur GSP. Mais nous ne voyons pas encore l'intérêt de faire une orchestration comme celle-ci, car il n'y a pas d'instances bon marché chez Google. Il y a des instances ???, mais elles ont des restrictions. Tout d'abord, elles ont toujours une remise de 70 % et il n'est pas possible de jouer avec le prix. Nous augmentons le prix des instances spot de 5 à 10 % pour réduire la probabilité que vous soyez interrompu. Donc, avec les instances spot, vous économisez, mais elles peuvent être retirées à tout moment. Si vous fixez un prix légèrement supérieur à celui des autres, vous serez tué plus tard. Chez Google, la spécificité est complètement différente. Et il y a une autre contrainte très désagréable : elles ne vivent que 24 heures. Parfois, nous voulons mener une expérience pendant 5 jours. Mais cela peut être fait avec des instances spot, qui peuvent parfois vivre des mois.
Bonjour ! Merci pour la présentation ! Vous avez mentionné le checkup. Comment calculez-vous les erreurs stat_statements ?
C'est une très bonne question. Je peux montrer et expliquer en détail. En résumé, nous examinons comment a évolué le groupe de requêtes : combien ont échoué et combien de nouvelles sont apparues. Ensuite, nous examinons deux métriques : total_time et calls, donc il y a deux erreurs. Et nous regardons quel est l'impact des groupes affectés. Il y a deux sous-groupes : celui qui est parti et celui qui est arrivé. Nous étudions leur contribution à l'ensemble.
Avez-vous peur qu'elle soit traitée deux ou trois fois entre les snapshots ?
C'est-à-dire qu'ils se sont réinscrits ou quoi ?
Par exemple, cette requête a déjà été évincée une fois, puis est revenue et a de nouveau été évincée, puis est encore revenue et a été évincée. Et vous avez calculé quelque chose ici, où est tout cela ?
C'est une bonne question, il faut regarder.
J'ai fait quelque chose d'analogue. Bien sûr, je l'ai fait plus simplement, tout seul. Mais j'ai dû annuler, faire un reset des stat_statements et m'orienter au moment du snapshot, en vérifiant qu'il y avait moins d'une certaine portion, afin de m'assurer que je n'avais pas atteint le plafond de ce que peuvent accumuler les stat_statements. Je suppose donc qu'il n'y a probablement rien qui a été évincé.
Oui-oui.
Mais je ne comprends pas comment faire de manière fiable autrement.
Malheureusement, je ne me souviens pas exactement – utilisons-nous le texte de la requête ou le queryid avec pg_stat_statements et nous nous basons dessus. Si nous nous basons sur le queryid, alors en théorie, nous comparons des éléments comparables.
Non, il peut être évincé plusieurs fois entre les snapshots et revenir à nouveau.
Avec ce même identifiant ?
Oui.
Nous allons étudier cela. C'est une bonne question. Il faut l'examiner. Mais pour l'instant, ce que nous voyons, c'est que nous avons soit 0 inscrit...
C'est un cas rare, mais j'ai été surpris d'apprendre que stat_statements peut être évincé.
Il peut y avoir beaucoup de choses dans pg_stat_statements. Nous avons constaté que si track_utility est activé, les ensembles sont également suivis.
Oui, bien sûr.
Et si vous utilisez Java Hibernate, qui est aléatoire, cela commence à verrouiller la table de hachage. Et dès que vous désactivez une application très chargée, vous avez entre 50 et 100 groupes. Et là, tout devient plus ou moins stable. L'une des façons de lutter contre cela est d'augmenter pg_stat_statements.max.
Oui, mais il faut savoir de combien. Et il faut y faire attention. C'est ce que je fais. C'est-à-dire que j'ai pg_stat_statements.max. Et je surveille si, au moment du snapshot, je n'ai pas dépassé 70 %. Très bien, cela signifie que nous n'avons rien perdu. Nous faisons un reset. Et nous accumulons à nouveau. Si au prochain snapshot, c'est moins de 70, cela signifie que nous n'avons probablement rien perdu.
Oui. Par défaut, c'est maintenant 5 000. Et beaucoup de gens s'en contentent.
En général, oui.
Vidéo :
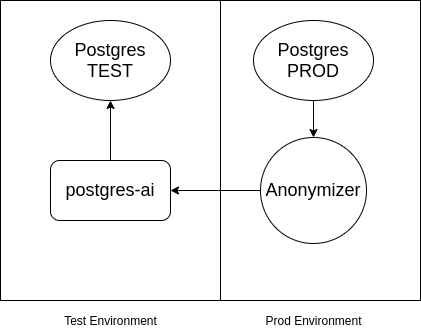
P.S. J'ajoute que si des données confidentielles se trouvent dans Postgres et ne doivent pas se retrouver dans l'environnement de test, il est possible d'utiliser . Le schéma est à peu près le suivant :
Source : habr.com
