

Aujourd'hui, je vais vous raconter une histoire. Une histoire de l'évolution de l'informatique et de l'émergence des postes de travail à distance depuis les temps anciens jusqu'à nos jours.
Développement IT
La principale leçon à tirer de l'histoire de l'IT est que...
Il est évident que l'IT se développe en spirale. Les mêmes solutions et concepts qui ont été abandonnés il y a des décennies retrouvent un nouveau sens et commencent à fonctionner avec succès dans de nouvelles conditions, face à de nouveaux défis et avec de nouvelles capacités. Dans ce domaine, l'IT ne diffère en rien d'autres champs de la connaissance humaine et de l'histoire de la Terre en général.
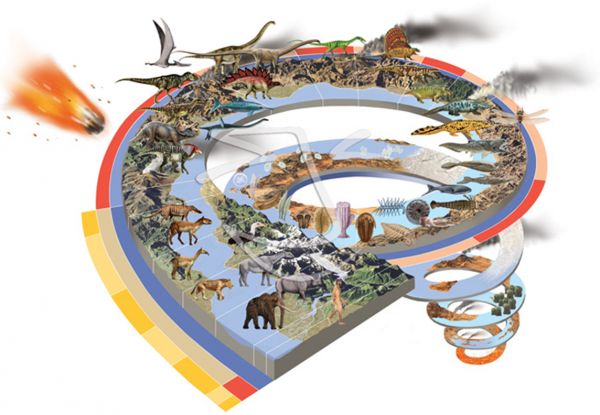
Il y a très longtemps, lorsque les ordinateurs étaient volumineux
« Je pense qu'il y a un marché pour environ cinq ordinateurs dans le monde », a déclaré Thomas Watson, président d'IBM, en 1943.
Les premiers ordinateurs étaient énormes. Non, c'est inexact, les premières machines étaient colossales, cyclopéennes. Une machine entièrement informatique occupait une surface comparable à celle d'un gymnase, et coûtait des sommes totalement irréalistes. En guise d'exemple de composants, on peut citer un module de mémoire vive sur des anneaux de ferrite (1964).
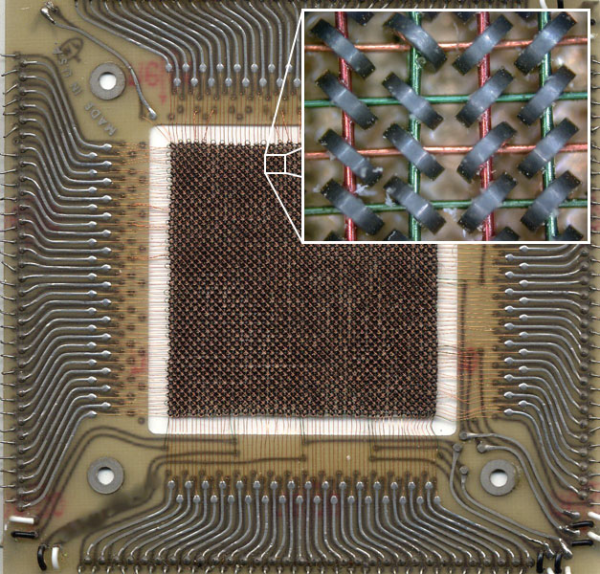
Ce module mesure 11 cm x 11 cm et a une capacité de 512 octets (4096 bits). Une armoire entièrement remplie de ces modules avait à peine la capacité d'une disquette 3,5" (1,44 Mo = 2950 modules), tout en absorbant une puissance électrique considérable et en chauffant comme une locomotive à vapeur.
C'est précisément en raison de leur taille massive que le terme anglais de débogage de code — « debugging » — a vu le jour. L'une des premières programmeuses de l'histoire, Grace Hopper (oui, une femme), officier de marine, a fait une entrée dans son journal des opérations en 1945 après avoir enquêté sur une défaillance d'un programme.
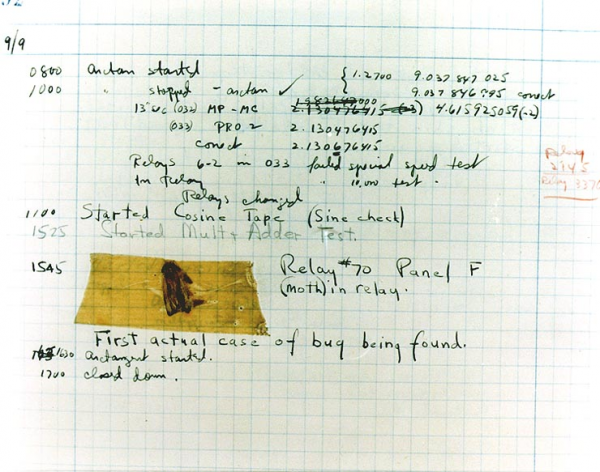
Puisque le mot moth (papillon de nuit) est généralement synonyme de bug (insecte), tous les problèmes et les actions de résolution subséquents étaient rapportés à la direction sous le terme de « debugging » (littéralement dé-angoisser), ce qui a solidement ancré le terme de bug pour une erreur de programme et la débogage est devenue le debugging.
Avec l'évolution de l'électronique et en particulier des semi-conducteurs, les dimensions physiques des machines ont commencé à diminuer, tandis que la puissance de calcul, en revanche, a continué à croître. Mais même dans ce cas, il n'était toujours pas possible de donner un ordinateur à chacun.
« Il n'y a aucune raison pour que quelqu'un veuille garder un ordinateur chez soi » — Ken Olsen, fondateur de DEC, 1977.
Le terme mini-ordinateur apparaît dans les années 70. Je me souviens que lorsque j'ai lu ce terme pour la première fois il y a de nombreuses années, je m'étais imaginé quelque chose comme un netbook, pratiquement un assistant personnel. Je ne pouvais pas être plus éloigné de la vérité.
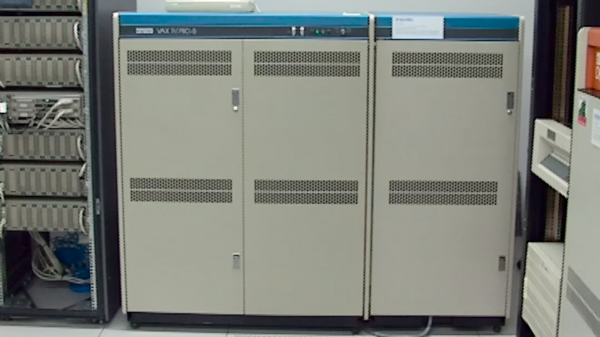
Mini — il n'est petit que par rapport aux immenses salles de machines, mais ce sont encore plusieurs armoires de matériel coûtant des centaines de milliers et des millions de dollars. Cependant, la puissance de calcul a déjà augmenté au point qu'elle n'était pas toujours pleinement exploitée et, en même temps, les ordinateurs ont commencé à être accessibles aux étudiants et aux enseignants des universités.
Et alors il est arrivé !
Peu de gens réfléchissent aux racines latines dans la langue anglaise, mais c'est ce qui nous a apporté l'accès à distance, tel que nous le connaissons aujourd'hui. Terminus (latin) — fin, limite, objectif. L'objectif du Terminator T800 était d'achever la vie de John Connor. Nous savons également que les stations de transport où se fait l'embarquement et le débarquement de passagers ou le chargement et le déchargement de marchandises sont appelées terminaux — objectifs finaux des itinéraires.
C'est ainsi qu'est née la notion d'accès terminal, et vous pouvez voir le terminal le plus célèbre au monde, qui vit toujours dans nos cœurs.
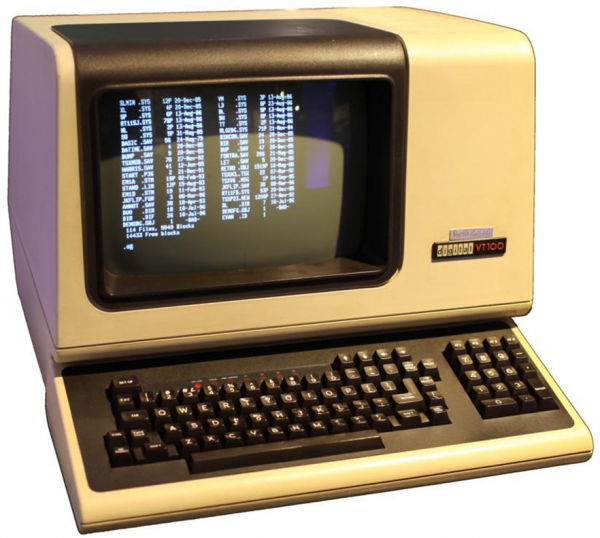
Le DEC VT100 est appelé terminal car il termine la ligne d'information. Il a en fait une puissance de calcul nulle, et sa seule tâche est d'afficher les informations reçues d'une grande machine et de transmettre les entrées de clavier à la machine. Et bien que les VT100 soient physiquement morts depuis longtemps, nous les utilisons encore pleinement.
Nos jours
Je commencerais à compter "nos jours" depuis le début des années 80, avec l'apparition des premiers processeurs accessibles au grand public ayant une puissance de calcul significative. On considère traditionnellement que le principal processeur de l'époque est l'Intel 8088 (famille x86) comme le précurseur de l'architecture victorieuse. Quelle est donc la différence fondamentale avec le concept des années 70 ?
On observe pour la première fois une tendance au transfert du traitement de l'information du centre vers la périphérie. Toutes les tâches ne nécessitent pas les puissances folles d'un mainframe ou même d'un mini-ordinateur. Intel ne reste pas inactif et, dans les années 90, lance la famille Pentium, qui devient le premier ordinateur personnel véritablement grand public en Russie. Ces processeurs sont déjà capables de beaucoup, non seulement d'écrire une lettre, mais aussi de faire de la multimédia et de travailler avec de petites bases de données. En fait, pour les petites entreprises, le besoin de serveurs disparaît complètement - tout peut être effectué sur la périphérie, sur les machines clientes. Chaque année, les processeurs deviennent de plus en plus puissants, et la différence entre serveurs et ordinateurs personnels se réduit de plus en plus en termes de puissance de calcul, ne restant souvent qu'en matière de redondance de l'alimentation, de support du remplacement à chaud et de boîtiers spéciaux pour le montage en rack.
Si l'on compare les processeurs clients modernes, qualifiés de « ridicules » par les administrateurs de serveurs lourds des années 90 d'Intel, aux superordinateurs du passé, on se sent tout à fait mal à l'aise.
Jetons un coup d'œil à un ancêtre, presque du même âge que moi. Cray X-MP/24 de 1984.
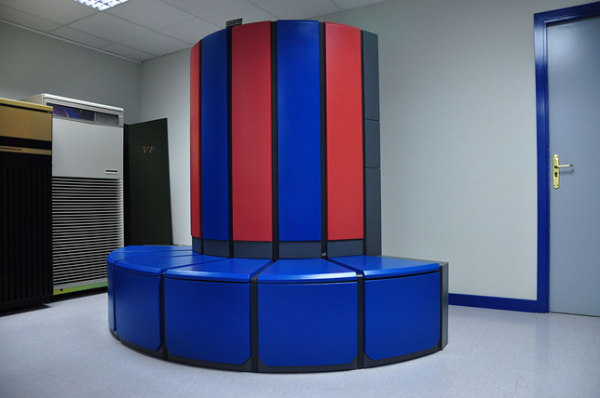
Cette machine figurait parmi les meilleurs superordinateurs de 1984, avec 2 processeurs à 105 MHz et une puissance de calcul de pointe de 400 MFlops (millions d'opérations à virgule flottante). La machine illustrée sur la photo était située dans le laboratoire de cryptographie de la NSA américaine et s'occupait de décryptage. Si l'on convertit 15 millions de dollars de 1984 en dollars de 2020, le coût serait de 37,4 millions de dollars, soit 93 500 dollars/MFlops.
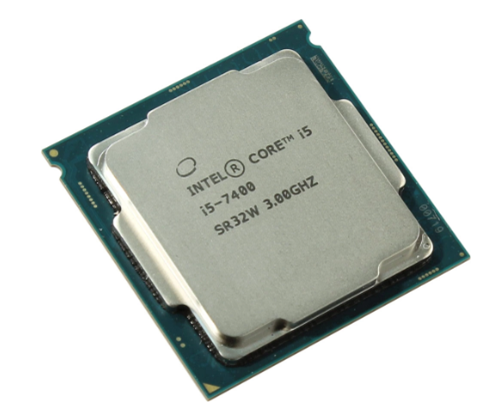
Dans la machine sur laquelle j'écris ces lignes, se trouve un processeur Core i5-7400 de 2017, qui n'est pas si nouveau, même s'il était le plus jeune des processeurs de bureau quad-core de milieu de gamme lors de sa sortie. 4 cœurs à 3,0 GHz de fréquence de base (3,5 avec Turbo Boost) et le double des threads HyperThreading donnent entre 19 et 47 GFlops de puissance selon divers tests, pour un prix de 16 000 roubles par processeur. Si l'on assemble la machine dans son ensemble, on peut estimer son coût à 750 dollars (selon les prix et le taux de change au 1er mars 2020).
Au final, nous observons que la puissance d'un processeur de bureau tout à fait moyen d'aujourd'hui est de 50 à 120 fois supérieure à celle d'un superordinateur du top 10 d'un passé relativement récent, tandis que la chute du coût unitaire des MFlops devient tout simplement monstrueuse, passant de 93 500 / 25 = 3 700 fois.
Pourquoi avons-nous encore besoin de serveurs et de centralisation des calculs avec de telles puissances en périphérie ? C'est résolument incompréhensible !
Le retour en arrière - la spirale a fait un tour
Stations sans disque
Le premier signe que le transfert des calculs vers la périphérie ne sera pas définitif a été l'apparition de la technologie des stations de travail sans disque. Avec une répartition significative des stations de travail sur le territoire de l'entreprise, et surtout dans des locaux pollués, la question de la gestion et du support de ces stations se pose de manière très pressante.
Le concept de "temps de corridor" apparaît - le pourcentage de temps que le technicien de support passe dans le couloir, en route vers l'employé en difficulté. Ce temps est payé, mais complètement improductif. Les pannes de disques durs, surtout dans des locaux pollués, jouent un rôle non négligeable. Éliminons le disque de la station de travail, et faisons tout le reste par réseau, y compris le démarrage. L'adaptateur réseau reçoit, en plus de l'adresse DHCP, des informations supplémentaires - l'adresse du serveur TFTP (un service de fichiers simplifié) et le nom de l'image de démarrage, la charge dans la mémoire vive et lance la machine.
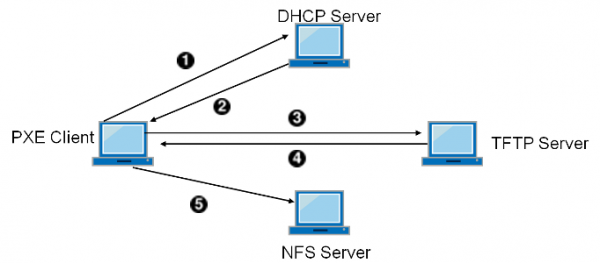
En plus de réduire le nombre de pannes et le temps de corridor, la machine peut maintenant ne pas être configurée sur place, mais simplement apporter une nouvelle et emporter l'ancienne pour diagnostic à un poste de travail équipé. Mais ce n'est pas tout !
La station sans disque devient considérablement plus sûre - si quelqu'un devait s'introduire dans la pièce et emporter tous les ordinateurs, ce ne serait que des pertes matérielles. Aucune donnée n'est stockée sur les stations sans disque.
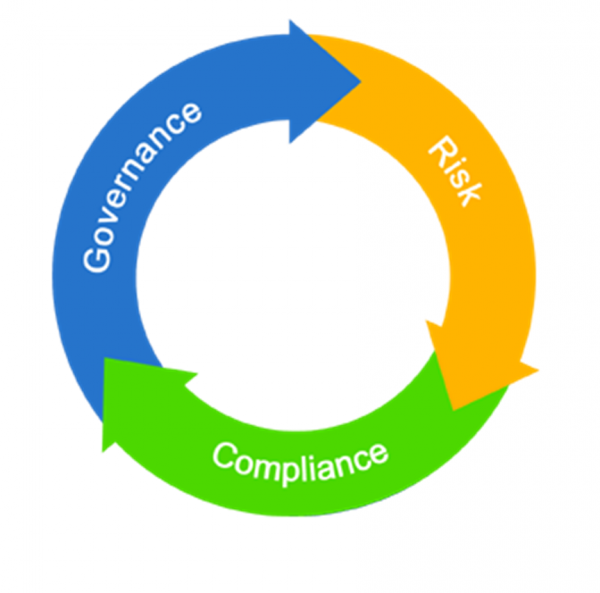
Souvenons-nous de ce moment, la sécurité de l'information commence à jouer un rôle de plus en plus important après l'"enfance insouciante" des technologies de l'information. Et dans les TI, s'imposent de plus en plus les trois lettres inquiétantes et importantes - GRC (Gouvernance, Risque, Conformité), ou en russe "Управляемость, Риск, Соответствие".
Serveurs de terminaux
La diffusion généralisée de PC de plus en plus puissants en périphérie a largement devancé le développement des réseaux publics. Les applications classiques de type client-serveur des années 90 et début 2000 ne fonctionnaient pas très bien sur des canaux étroits, surtout si les échanges de données dépassaient un certain seuil. Cela était particulièrement difficile pour les bureaux distants se connectant via modem et ligne téléphonique, qui étaient en plus parfois instables ou interrompues. Et...
La spirale a opéré un tour et s'est retrouvée à nouveau en mode terminal avec le concept de serveurs terminaux.
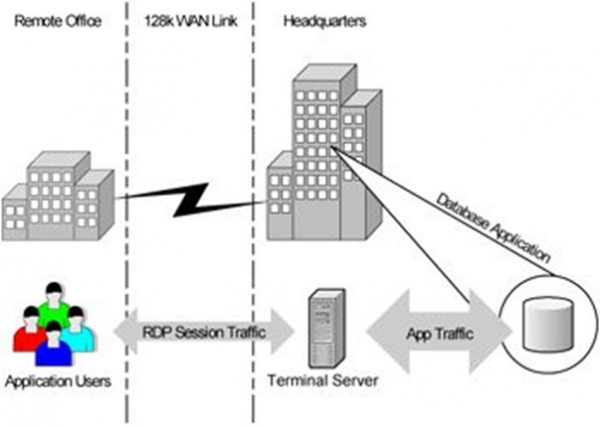
En fait, nous sommes revenus aux années 70 avec leurs clients légers et la centralisation de la puissance de calcul. Il est rapidement devenu évident qu'au-delà de l'arrière-plan purement économique lié aux canaux, l'accès terminal offre d'énormes opportunités pour organiser un accès sécurisé de l'extérieur, y compris le télétravail pour les employés, ou un accès très limité et contrôlé pour les contractants provenant de réseaux et d'appareils non fiables.
Cependant, les serveurs terminaux, malgré tous leurs avantages et leur caractère progressiste, avaient également un certain nombre d'inconvénients : faible flexibilité, problèmes de voisin bruyant, Windows strictement serveur, etc.
L'avènement du proto VDI
Cependant, au début du milieu des années 2000, la virtualisation industrielle de la plateforme x86 faisait déjà une forte apparition. Et quelqu'un a simplement énoncé une idée qui flottait dans l'air : et si au lieu de centraliser tous les clients sur des fermes de serveurs terminaux, nous donnions à chacun sa propre VM avec Windows client et même des droits d'administrateur ?
L'abandon des clients lourds
Parallèlement à la virtualisation des sessions et des systèmes d'exploitation, une approche visant à alléger la fonction du client au niveau de l'application a vu le jour.
La logique derrière cela était assez simple, car les ordinateurs portables personnels étaient encore loin d'être accessibles à tous, l'Internet n'était pas non plus à la portée de tout le monde, et beaucoup ne pouvaient se connecter qu'à partir de cybercafés avec des droits très limités, pour le dire gentiment. En fait, tout ce qui pouvait être exécuté, c'était le navigateur. Le navigateur est devenu un attribut incontournable des systèmes d'exploitation, et l'Internet s'est fermement introduit dans notre vie.
En d'autres termes, un phénomène parallèle était en cours : le transfert de la logique du client vers le centre, sous forme d'applications web, pour lesquelles il suffisait d'un client très simple, d'Internet et d'un navigateur.
Et nous ne sommes pas simplement arrivés là où nous avions commencé - avec zéro client et des serveurs centraux. Nous y sommes arrivés par plusieurs chemins indépendants.
Infrastructure de Bureau Virtuel
Courtier
En 2007, le leader du marché de la virtualisation industrielle, VMware, a lancé la première version de son produit VDM (Virtual Desktop Manager), qui est devenu en fait le premier sur un marché des bureaux virtuels alors en plein essor. Il n'a pas fallu longtemps pour obtenir une réponse du leader des serveurs terminaux Citrix, et en 2008, avec l'acquisition de XenSource, XenDesktop fait son apparition. Bien sûr, il y avait d'autres fournisseurs avec leurs offres, mais ne nous éloignons pas trop de l'histoire, en nous écartant du concept.
Et jusqu'à présent, le concept demeure. Le composant clé de la VDI est le courtier de connexion.
C'est précisément le cœur de l'infrastructure des bureaux virtuels.
Le courtier est responsable des processus les plus importants du fonctionnement de la VDI :
- Il détermine les ressources disponibles pour le client connecté (machines/sessions);
- Il équilibre les clients entre les pools de machines/sessions si nécessaire;
- Il redirige le client vers la ressource choisie.
Aujourd'hui, le client (terminal) pour la VDI peut être pratiquement tout ce qui a un écran - un ordinateur portable, un smartphone, une tablette, un kiosque, un client léger ou nul. Et la partie réciproque, celle qui exécute la charge productive - la session de serveur terminal, une machine physique, une machine virtuelle. Les produits VDI modernes et matures sont étroitement intégrés à l'infrastructure virtuelle et gèrent celle-ci de manière autonome et automatique, déployant ou, au contraire, supprimant déjà les machines virtuelles non nécessaires.
Un peu à part, mais pour certains clients, une technologie VDI extrêmement importante est le support de l'accélération matérielle de la 3D pour le travail des concepteurs ou des designers.
Protocole
Un autre élément extrêmement important d'une solution VDI mature est le protocole d'accès aux ressources virtuelles. S'il s'agit de travailler au sein d'un réseau local d'entreprise avec un excellent réseau fiable de 1 Gbps jusqu'au poste de travail et un retard de 1 ms, il est possible de choisir pratiquement n'importe lequel et de ne pas se poser de questions.
Il est crucial de réfléchir lorsque la connexion se fait via un réseau non contrôlé, où la qualité de ce réseau peut varier énormément, allant jusqu'à des vitesses de quelques kilobits et des latences imprévisibles. C'est précisément pour l'organisation d'un véritable travail à distance, depuis des résidences secondaires, de chez soi, depuis les aéroports et les cafés.
Serveurs terminaux vs machines virtuelles clientes
Avec l'avènement de la VDI, il semblait qu'il était temps de dire adieu aux serveurs terminaux. À quoi servent-ils, si chacun a sa propre machine virtuelle personnelle ?
Cependant, d'un point de vue purement économique, il s'avère que pour des postes de travail standards et uniformes, il n'existe pas encore de solution plus efficace que les serveurs terminaux en termes de coût / session. Malgré tous leurs avantages, l'approche "1 utilisateur = 1 VM" consomme beaucoup plus de ressources sur le matériel virtuel et le système d'exploitation complet, ce qui détériore l'économie pour les postes de travail standards.
En revanche, pour les postes de travail des cadres supérieurs, les postes non standards et chargés, et la nécessité d'avoir des droits élevés (voire d'administrateur), une VM dédiée par utilisateur est préférable. Dans cette VM, il est possible d'allouer des ressources individuellement, d'accorder des droits à tout niveau, et de répartir les VM entre les hôtes de virtualisation lors d'une forte charge.
VDI et économie
Depuis des années, j'entends toujours la même question : pourquoi, la VDI est-elle moins chère que de simplement distribuer des ordinateurs portables à tout le monde ? Et pendant des années, je n'ai pu répondre qu'une seule chose : dans le cas des employés de bureau ordinaires, la VDI n'est pas moins chère si l'on considère les coûts nets d'équipement. Quoi qu'il en soit, les ordinateurs portables deviennent moins chers, mais les serveurs, les SAN et les logiciels systèmes coûtent assez cher. Si le moment est venu de renouveler votre parc informatique et que vous espérez économiser grâce à la VDI — non, vous ne réaliserez pas d'économies.
J'ai précédemment mentionné les sinistres GRC — eh bien, la VDI concerne le GRC. C'est une question de gestion des risques, de sécurité et de commodité dans l'accès contrôlé aux données. Et tout cela coûte généralement un montant non négligeable pour l'implémentation sur une multitude d'équipements hétérogènes. Avec la VDI, le contrôle est simplifié, la sécurité est améliorée, et les cheveux deviennent doux et soyeux.
Solutions HPE pour le travail à distance
Gestion à distance et basée sur le cloud
iLO
La société HPE n'est certainement pas une novice dans la gestion à distance des infrastructures serveurs, c'est une blague - en mars, la légendaire iLO (Integrated Lights Out) a fêté ses 18 ans. En me remémorant mes années d'administration dans les années 2000, je ne pouvais m'en lasser. Le montage initial dans les racks et le branchement des câbles - voici tout ce qu'il fallait faire dans un data center bruyant et froid. Tout le reste de la configuration, y compris l'installation du système d'exploitation, pouvait déjà être réalisé depuis son poste de travail, avec deux écrans et une tasse de café chaud. Et cela fait déjà 13 ans !
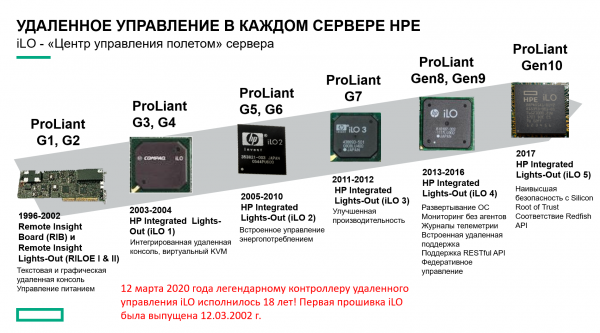
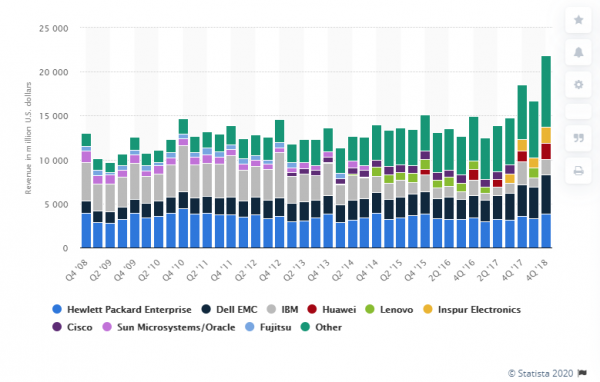
Aujourd'hui, les serveurs HPE sont indiscutablement un standard de qualité établi depuis des années - et le rôle de référence du système de gestion à distance, iLO, y contribue grandement.
Je tiens à souligner les actions d'HPE pour maintenir le contrôle de l'humanité face au coronavirus. , que jusqu'à la fin 2020 (au minimum), la licence iLO Advanced est disponible gratuitement pour tout le monde.
Infosight
Si vous avez plus de 10 serveurs dans l'infrastructure et que l'administrateur ne s'ennuie pas, alors le système de surveillance cloud HPE Infosight basé sur l'intelligence artificielle sera bien sûr un excellent complément aux outils de surveillance standards. Le système non seulement surveille l'état et crée des graphiques, mais recommande également des actions futures en fonction de la situation actuelle et des tendances.
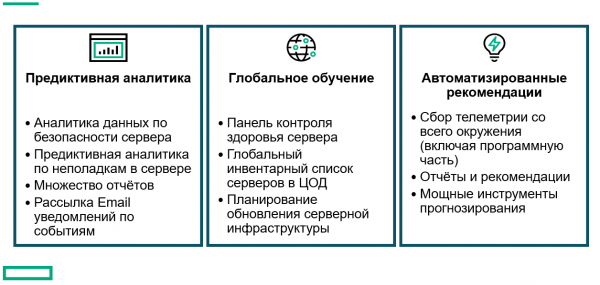
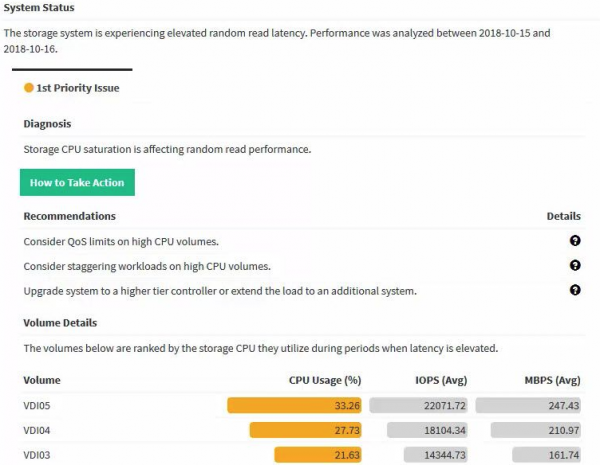
Sois futé, , essaie Infosight !
OneView
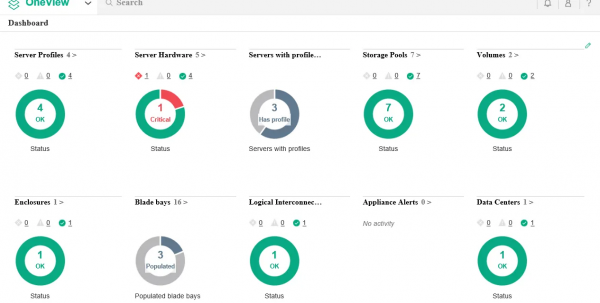
En dernier lieu, mais non des moindres, je souhaite mentionner HPE OneView - un portefeuille de produits avec d'énormes capacités de surveillance et de gestion de l'ensemble de l'infrastructure. Et tout cela sans se lever de son bureau, qui se trouve peut-être d'ailleurs dans une datcha en ce moment.
Les systèmes de stockage ne sont pas en reste !
Bien sûr, tous les systèmes de stockage sont gérés et surveillés à distance - cela a été le cas depuis de nombreuses années. C'est pourquoi je veux parler aujourd'hui d'autre chose, à savoir des méta-clusters.
Les méta-clusters ne sont pas une nouveauté sur le marché, mais c'est précisément pour cela qu'ils ne sont pas encore très populaires - l'inertie de la pensée et les premières impressions se font sentir. Bien sûr, ils existaient déjà il y a 10 ans, mais leur coût était celui d'un pont en fonte. Les années qui se sont écoulées depuis les premiers méta-clusters ont transformé l'industrie et la disponibilité de la technologie pour le grand public.
Je me souviens de projets où les composants des systèmes de stockage étaient délibérément séparés - pour les services ultra critiques dans un métacluster, et pour la réplication synchrone (bien moins chère).
En fait, en 2020, un métacluster ne vous coûte rien, si vous êtes capable d'organiser deux sites et des canaux. Et les canaux pour la réplication synchrone sont exactement les mêmes que ceux pour les métaclusters. La licence des logiciels se fait depuis longtemps par paquets - et la réplication synchrone est incluse avec le métacluster, et la seule chose qui maintient encore la vie de la réplication unidirectionnelle est la nécessité d'organiser un réseau L2 étendu. D'ailleurs, L2 sur L3 fait déjà son chemin à travers le pays.
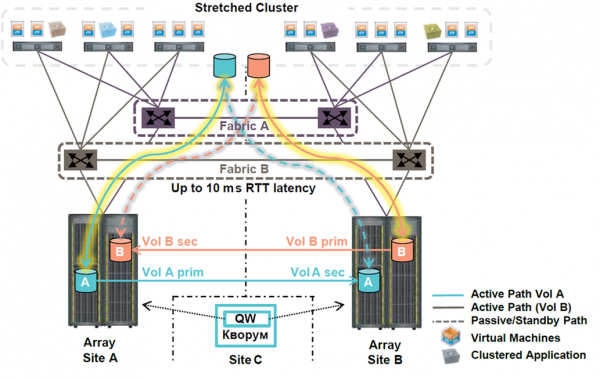
Alors, quelle est la différence fondamentale entre la réplication synchrone et le métacluster en matière de travail à distance ?
C'est très simple. Le métacluster fonctionne de lui-même, automatiquement, tout le temps, pratiquement instantanément.
À quoi ressemble le processus de basculement de charge en réplication synchrone sur une infrastructure d'au moins plusieurs centaines de VM ?
- Un signal d'urgence est reçu.
- L'équipe de garde analyse la situation - on peut facilement prévoir entre 10 et 30 minutes rien que pour recevoir le signal et prendre une décision.
- En l'absence de pouvoir des ingénieurs de garde pour lancer le basculement de manière autonome - encore 30 minutes pour contacter une personne ayant l'autorité et confirmer formellement le début du basculement.
- Appuyer sur le Gros Bouton Rouge.
- 10-15 minutes pour les délais et le remappage des volumes, la réenregistrement des VM.
- 30 minutes pour changer l'adressage IP - une estimation optimiste.
- Et enfin, le démarrage des VM et du lancement des services productifs.
Au total, l'RTO (temps de restauration des processus métier) peut être estimé à 4 heures.
Comparons avec la situation sur le métacluster.
- Le système de stockage comprend que la connexion avec le bras du métacluster est perdue - 15-30 secondes.
- Les hôtes de virtualisation réalisent que le premier DC est perdu - 15-30 secondes (simultanément avec le point 1).
- Redémarrage automatique de la moitié à un tiers des VM dans le second DC - 10-15 minutes jusqu'au chargement des services.
- À peu près à ce moment-là, l'équipe de garde comprend ce qui s'est passé.
Au total : RTO = 0 pour certains services, 10-15 minutes en général.
Pourquoi le redémarrage seulement d'une moitié à un tiers des VM ? Voyez-vous, voici la raison :
- Vous agissez intelligemment en activant l'équilibrage automatique des VM. En moyenne, seule la moitié des VM fonctionne dans l'un des centres de données. En effet, tout le sens du méta-cluster réside dans la minimisation des arrêts, et donc il est dans votre intérêt de minimiser le nombre de VM en danger.
- Certaines services peuvent être optimisés au niveau de l'application, répartis sur différentes VM. Ainsi, ces VM jumelées peuvent être clouées ou attachées par un ruban à différents centres de données, afin que le service n'ait pas à attendre le redémarrage d'une VM en cas de panne.
Avec une infrastructure bien construite et des méta-clusters étendues, les utilisateurs professionnels travaillent avec des latences minimales depuis n'importe quel endroit, même en cas de panne au niveau du centre de données. Dans le pire des cas, la latence sera équivalente à celle d'une tasse de café.
Et bien sûr, les méta-clusters fonctionnent parfaitement à la fois avec les systèmes HPE 3Par en cours de retrait vers Valinor et avec les nouveaux Primera!
Infrastructure des postes de travail distants
Serveurs de terminaux
Pour les serveurs terminaux, il n'est pas nécessaire d'inventer quoi que ce soit de nouveau, HPE fournit depuis de nombreuses années certains des meilleurs serveurs au monde pour cela. Les classiques indémodables — DL360 (1U) ou DL380 (2U), ou pour les amateurs d'AMD — DL385. Bien sûr, il existe aussi des serveurs blade, tant classiques C7000 que la nouvelle plateforme modulaire Synergy.
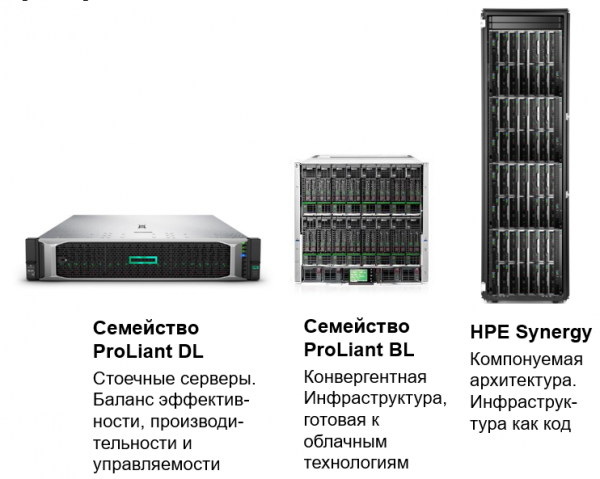
Pour tous les goûts, toutes les couleurs, un maximum de sessions par serveur !
VDI “classique” + HPE Simplivity
Dans ce cas, lorsque je parle de “VDI classique”, je fais référence au concept 1 utilisateur = 1 VM avec Windows client. Bien sûr, il n'y a pas de charge VDI plus proche et plus appropriée pour les systèmes hyper-convergents, d'autant plus avec déduplication et compression.
Ici, HPE peut proposer à la fois sa propre plateforme hyper-convergente Simplivity et des serveurs/matériaux certifiés pour les solutions des partenaires, comme les nœuds prêts pour VSAN pour la construction de VDI sur l'infrastructure VMware VSAN.
Parlons un peu plus de notre solution Simplivity. Comme le suggère délicatement le nom, la simplicité est au cœur de notre approche (en anglais simple — simple). La simplicité de déploiement, de gestion et de mise à l'échelle.
Les systèmes hyper-convergés sont aujourd'hui l'un des sujets les plus brûlants en informatique, et le nombre de fournisseurs de différents niveaux s'élève à environ 40. Selon le carré magique de Gartner, la société HPE est dans le top 5 mondial et fait partie du carré des leaders — ceux qui comprennent et connaissent l'évolution de l'industrie, et sont capables de concrétiser cette compréhension dans le matériel.
Architecturalement, Simplivity est un système hyper-convergé classique avec des machines virtuelles contrôleurs, ce qui signifie qu'il peut prendre en charge différents hyperviseurs, contrairement aux systèmes intégrés à l'hyperviseur. En effet, à partir d'avril 2020, VMware vSphere et Microsoft Hyper-V sont supportés, et des plans pour prendre en charge KVM ont été annoncés. La caractéristique clé de Simplivity depuis son apparition sur le marché a été l'accélération matérielle de la compression et de la déduplication à l'aide d'une carte accélératrice spéciale.
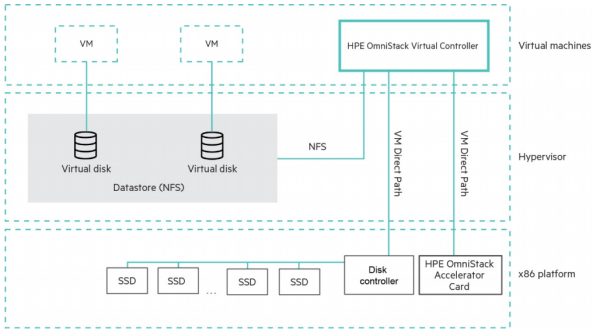
Il convient de noter que la compression avec déduplication est globale et toujours activée, donc ce n'est pas une fonctionnalité optionnelle, mais l'architecture de la solution.
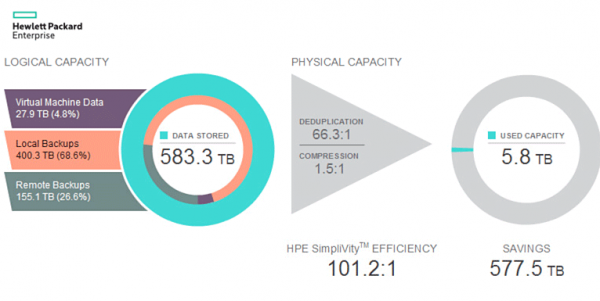
HPE, bien sûr, exagère quelque peu en affirmant une efficacité de 100:1, en calculant d'une manière particulière, mais l'efficacité de l'utilisation de l'espace est effectivement très élevée. Simplement, le chiffre 100:1 est trop joli. Voyons comment Simplivity est techniquement mise en œuvre pour afficher de tels chiffres.
InstantanéLes snapshots (instantanés) sont réalisés correctement à 100 % en tant que RoW (Redirect-on-Write), ce qui signifie qu'ils se produisent immédiatement et n'imposent aucune pénalité de performance. Ce qui les distingue par exemple de certains autres systèmes. Pourquoi avons-nous besoin de snapshots locaux sans pénalités ? C'est très simple, pour réduire le RPO de 24 heures (RPO moyen pour la sauvegarde) à des dizaines ou même à quelques minutes.
SauvegardeUn snapshot se distingue d'une sauvegarde uniquement par la manière dont il est perçu par le système de gestion des machines virtuelles. Si la suppression de la machine entraîne la suppression de tout le reste, alors c'était un snapshot. Si quelque chose reste, alors c'est une sauvegarde. Ainsi, tout snapshot peut être considéré comme une sauvegarde complète s'il est marqué dans le système et n'est pas supprimé.
Bien sûr, beaucoup pourraient s'opposer — quel type de sauvegarde est-ce si elle est stockée sur le même système ? Et ici, il y a une réponse très simple sous forme de question inverse : dites-moi, avez-vous un modèle formel de menace établissant les règles de stockage de la sauvegarde ? C'est une sauvegarde absolument honnête contre la suppression d'un fichier à l'intérieur de la VM, c'est une sauvegarde contre la suppression de la VM elle-même. En cas de nécessité de stocker la sauvegarde uniquement sur un système indépendant, il existe le choix : la réplication de ce snapshot sur un deuxième cluster Simplivity ou sur HPE StoreOnce.
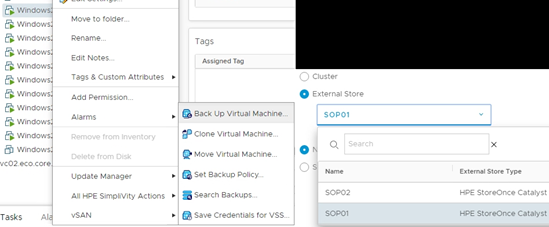
Et c'est précisément ici qu'il s'avère qu'une architecture de ce type est parfaitement adaptée à tout type de VDI. En effet, le VDI consiste en des centaines, voire des milliers de machines très similaires avec le même système d'exploitation et les mêmes applications. La déduplication globale va tout compresser, et ce, même mieux que 100:1. Déployer 1000 VMs à partir d'un seul modèle ? Pas de problème, ces machines mettront plus de temps à s'enregistrer dans vCenter qu'à être clonées.
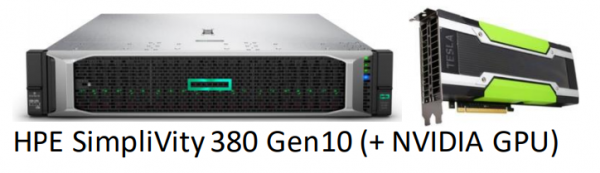
Spécialement pour les utilisateurs ayant des exigences particulières en matière de performances, et pour ceux qui ont besoin de GPU 3D, une gamme Simplivity G a été créée.
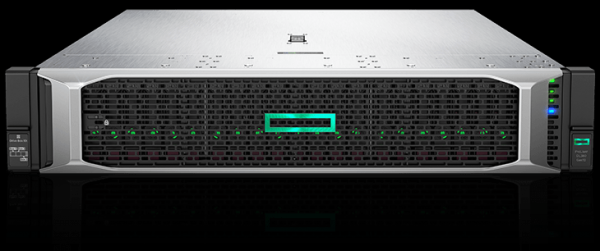
Dans cette série, il n'y a pas d'accélérateur matériel de déduplication, et donc le nombre de disques par nœud est réduit, afin que le contrôleur puisse gérer cela par logiciel. Cela libère des emplacements PCIe pour d'autres accélérateurs. De plus, la capacité de mémoire disponible par nœud est doublée à 3 To pour les charges de travail les plus exigeantes.
Simplivity est idéal pour la création d'infrastructures VDI géographiquement distribuées avec réplication des données vers un centre de données central.
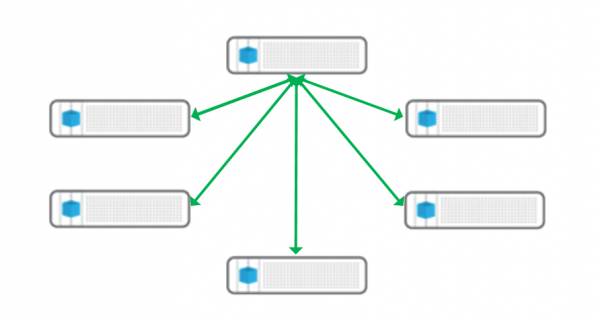
Une telle architecture VDI (et pas seulement VDI) est particulièrement intéressante dans le contexte russe — de grandes distances (et donc des latences) et des canaux loin d'être idéaux. Des centres régionaux sont créés (ou même juste 1 à 2 nœuds Simplivity dans des bureaux très éloignés), où les utilisateurs locaux se connectent via des canaux rapides, tout en conservant un contrôle et une gestion complets depuis le centre, et seules une quantité insignifiante de données déjà valorisées, et non des données inutiles, sont répliquées vers le centre.
Bien sûr, Simplivity se connecte complètement à OneView et InfoSight.
Clients légers et clients nuls
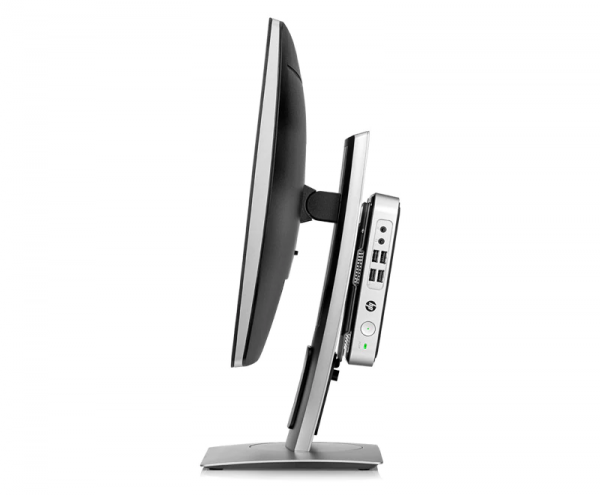
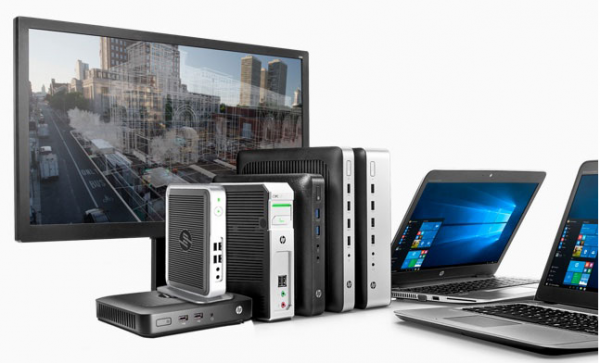
Les clients légers sont des solutions spécialisées conçues exclusivement pour être utilisées en tant que terminaux. Puisqu'il n'y a pratiquement aucune charge sur le client, à part le maintien de la connexion et le déchiffrement vidéo, il est pratiquement toujours équipé d'un processeur à refroidissement passif, d'un petit disque de démarrage uniquement pour initialiser un système d'exploitation embarqué spécifique, et c'est à peu près tout. Il y a peu de choses à casser, et il est inutile de le voler. Le coût est faible et aucune donnée n'y est stockée.
Il existe une catégorie particulière de clients légers, appelés clients zéro. Leur principale différence avec les légers est l'absence même d'un système d'exploitation embarqué générique, et leur fonctionnement est exclusivement basé sur une microchip avec un firmware. Ils sont souvent équipés de processeurs matériels spéciaux pour le déchiffrement des flux vidéo dans des protocoles terminaux tels que PCoIP ou HDX.
Malgré la séparation de la grande entreprise Hewlett Packard en HPE et HP, il est impossible de ne pas mentionner les clients légers fabriqués par HP.
Le choix est vaste, pour tous les goûts et besoins — jusqu'à des postes de travail multi-écrans avec accélération matérielle du flux vidéo.
Le service HPE pour votre travail à distance
Et enfin, mais non des moindres, je tiens à mentionner le service HPE. Il serait trop long de lister tous les niveaux de service HPE et ses possibilités, mais il y a au moins une offre extrêmement importante dans le cadre du travail à distance. En effet, un ingénieur de service d'HPE / un centre de service autorisé. Vous continuez à travailler à distance, depuis votre chère maison de campagne, en écoutant les bourdonnements des abeilles, pendant que l'ingénieur d'HPE, arrivé dans le data center, remplace les disques de vos serveurs ou l'alimentation défectueuse.
HPE CallHome
Dans les conditions actuelles, avec les restrictions de déplacement, la fonction Call Home est plus pertinente que jamais. Tout système HPE doté de cette fonctionnalité peut signaler de manière autonome un dysfonctionnement matériel ou logiciel au centre de support HPE. Il est tout à fait probable qu'une pièce de rechange et/ou un ingénieur de service arrivent chez vous bien avant que vous ne remarquiez les pannes ou les problèmes avec les services critiques.
Personnellement, je recommande vivement d'activer cette fonction.
Source : habr.com
