

Je vous propose de découvrir le compte rendu de la présentation de début 2016 de Vladimir Sitnikov "PostgreSQL et JDBC : tirons-en le meilleur parti"
Bonjour ! Je m'appelle Vladimir Sitnikov. Je travaille depuis 10 ans chez NetCracker et je me consacre principalement à la performance. Tout ce qui touche à Java et tout ce qui concerne SQL, c'est ce que j'aime.
Aujourd'hui, je vais vous parler des défis que nous avons rencontrés dans notre entreprise lorsque nous avons commencé à utiliser PostgreSQL comme serveur de bases de données. Nous travaillons principalement avec Java. Cependant, ce dont je vais parler aujourd'hui concerne également d'autres langages.
Nous allons parler de :
- la sélection de données.
- de la sauvegarde des données.
- et également de la performance.
- Et des pièges dissimulés qui peuvent surgir.
Commençons par une question simple. Nous sélectionnons une ligne d'une table par clé primaire.
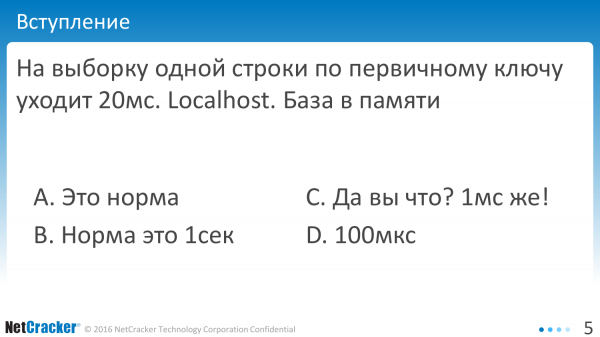
La base de données se trouve sur le même hôte. Et tout cela prend 20 millisecondes.
Ces 20 millisecondes, c'est beaucoup. Si vous avez 100 telles requêtes, vous perdez du temps en secondes pour exécuter ces requêtes, c'est-à-dire que vous gaspillez du temps.
Nous n'aimons pas faire ça et nous regardons ce que la base nous propose pour cela. La base nous offre deux options d'exécution des requêtes.
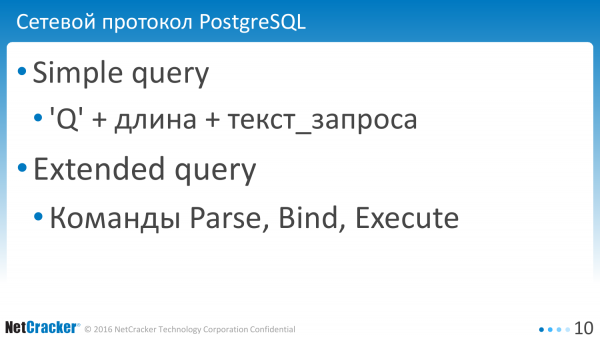
La première option est la requête simple. Qu'est-ce qui est bien ? C'est que nous la prenons et l'envoyons, et rien de plus.
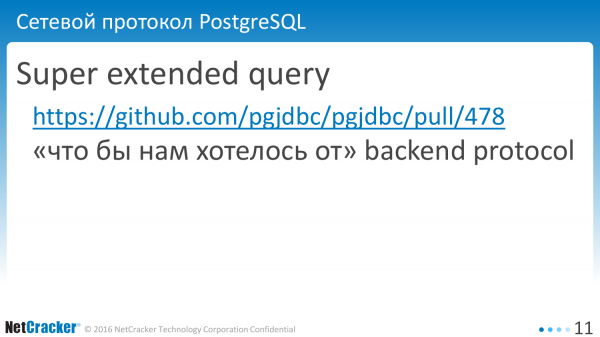
La base a aussi une requête étendue qui est plus astucieuse mais plus fonctionnelle. On peut envoyer séparément des requêtes pour le parsing, l'exécution, la liaison de variables, etc.
La Super extended query est quelque chose que nous ne couvrirons pas dans cette présentation. Peut-être avons-nous certaines attentes vis-à-vis de la base de données, et il existe une liste de souhaits qui est formulée d'une certaine manière, c'est-à-dire ce que nous voulons, mais qui n'est pas réalisable actuellement et dans un avenir proche. Nous l'avons donc simplement notée et nous irons voir les personnes clés.
Ce que nous pouvons faire, c'est utiliser la requête simple et la requête étendue.
Quelle est la particularité de chaque approche ?
La requête simple est bien adaptée pour une exécution unique. On l'exécute une fois et on oublie. Le problème, c'est qu'elle ne prend pas en charge le format binaire des données, donc pour certains systèmes à haute performance, elle n'est pas appropriée.
La requête étendue - permet d'économiser du temps lors de l'analyse. C'est ce que nous avons fait et commencé à utiliser. Cela nous a été très, très utile. Il n'y a pas seulement des économies sur l'analyse. Il y a aussi des économies sur la transmission des données. Transmettre des données au format binaire est beaucoup plus efficace.
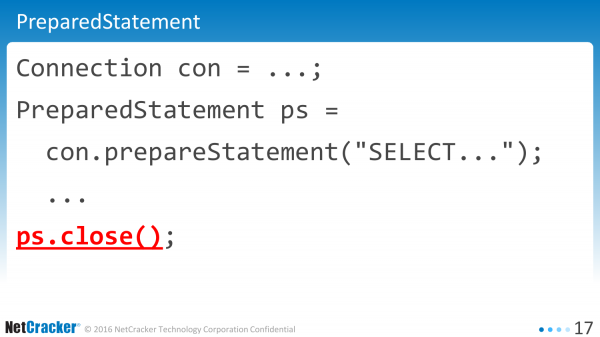
Passons à la pratique. Voici à quoi ressemble une application typique. Cela peut être Java, etc.
Nous avons créé une instruction. Nous avons exécuté la commande. Nous avons créé une fermeture. Où est l'erreur ici ? Quel est le problème ? Aucun problème. C'est ce qui est dit dans tous les livres. C'est ainsi que cela doit être écrit. Si vous voulez une performance maximale, écrivez comme ça.
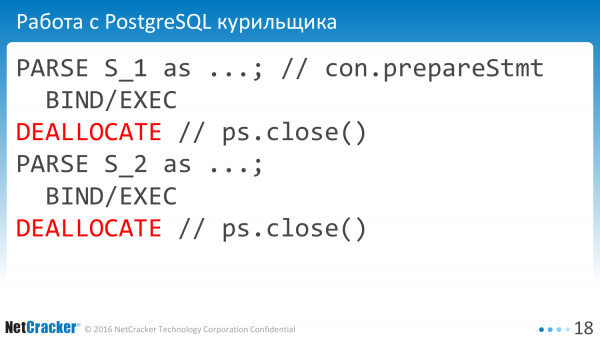
Mais la pratique a montré que cela ne fonctionne pas. Pourquoi ? Parce que nous avons la méthode «close». Et quand nous faisons cela, du point de vue de la base de données, c'est comme si un fumeur travaillait avec la base de données. Nous avons dit «PARSE EXECUTE DEALLOCATE».
Pourquoi créer et décharger ces statements inutiles ? Ils ne sont nécessaires à personne. Mais généralement, dans PreparedStatement, c'est comme ça : quand nous les fermons, ils ferment tout dans la base de données. Ce n'est pas ce que nous voulons.
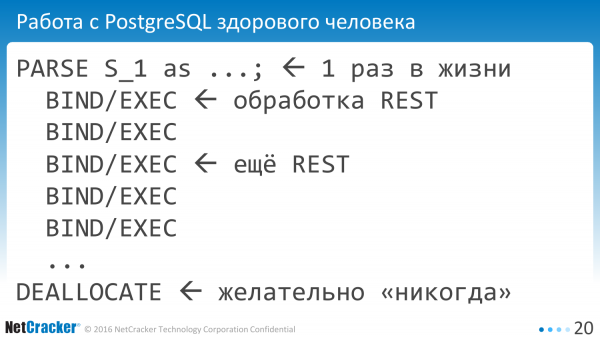
Nous voulons, comme des gens sains, travailler avec la base. Une fois préparé, nous exécutons notre statement plusieurs fois. En fait, plusieurs fois signifie une fois pendant toute la durée de vie de l'application, à chaque fois que nous avons analysé. Et sur différentes REST, nous utilisons le même identifiant de statement. Voici notre objectif.
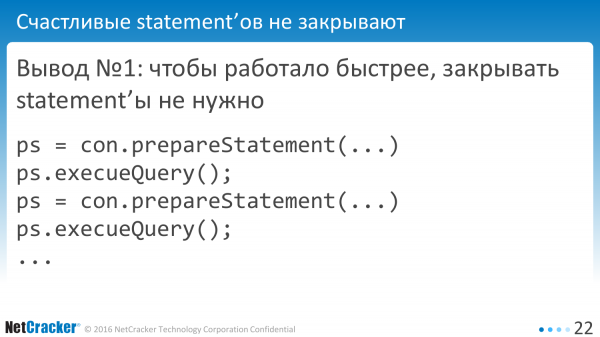
Comment y parvenir ?
C'est très simple - il ne faut pas fermer les statements. Nous écrivons comme ça : «prepare» «execute».
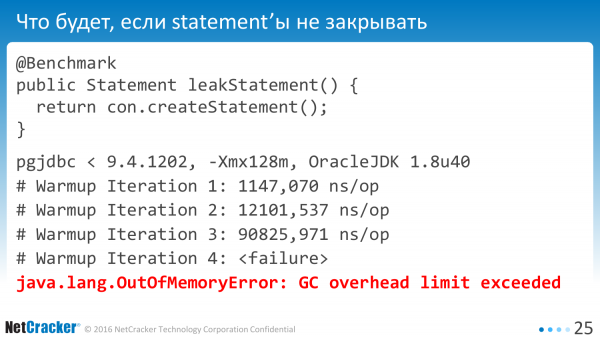
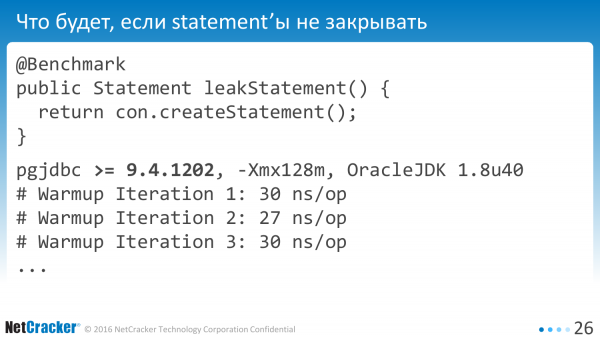
Si nous lançons quelque chose comme ça, il est clair qu'à un moment donné, quelque chose va déborder. Si ce n'est pas clair, nous pouvons le mesurer. Prenons et écrivons un benchmark, où cette méthode simple sera mise en œuvre. Nous créons un statement. Nous le lançons sur une certaine version du driver et obtenons qu'il tombe assez rapidement avec une perte totale de la mémoire que nous avons accumulée.
Il est évident que de telles erreurs sont facilement corrigées. Je ne vais pas en parler. Mais je dirai que dans la nouvelle version, cela fonctionne beaucoup plus rapidement. La méthode est inutile, mais néanmoins.
Comment travailler correctement ? Que devons-nous faire pour cela ?
Dans la réalité, les applications ferment toujours les statements. Tous les livres recommandent de les fermer, sinon la mémoire fuitera.
Et PostgreSQL ne sait pas mettre en cache les requêtes. Il faut que chaque session crée elle-même ce cache.
Et nous ne voulons pas non plus perdre du temps sur l'analyse.
Et comme d'habitude, nous avons deux options.
La première option consiste à dire que nous allons tout envelopper dans PgSQL. Il y a un cache. Il met tout en cache. Cela devrait bien fonctionner. Nous avons regardé cela. Nous avons 100500 requêtes. Cela ne fonctionne pas. Nous ne sommes pas d'accord pour transformer les requêtes en procédures manuellement. Non-non.
Nous avons une deuxième option : prendre et coder nous-mêmes. Nous ouvrons le code source et commençons à coder. Nous codons-codons. Il s'est avéré que ce n'est pas si compliqué à faire.
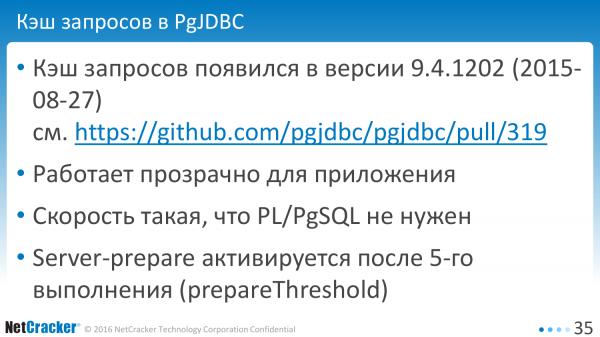
Cela est apparu en août 2015. Maintenant, il y a une version plus moderne. Et tout va bien. Cela fonctionne si bien que nous ne changeons rien dans l'application. Et nous avons même cessé de penser en termes de PgSQL, c'est-à-dire que cela a suffi à réduire pratiquement à zéro toutes les dépenses.
Les instructions préparées du serveur sont activées lors de la cinquième exécution afin de ne pas gaspiller de mémoire dans la base de données pour chaque requête unique.
On peut demander : où sont les chiffres ? Que recevez-vous ? Et ici, je ne donnerai pas de chiffres car chaque requête a les siens.
Nous avions des requêtes où nous dépensions environ 20 millisecondes pour le parsing sur les requêtes OLTP. Il y avait 0,5 millisecondes pour l'exécution, 20 millisecondes pour le parsing. La requête – 10 Ko de texte, 170 lignes de plan. C'est une requête OLTP. Elle demande 1, 5, 10 lignes, parfois plus.
Mais nous ne voulions absolument pas dépenser 20 millisecondes. Nous sommes passés à 0. Tout va bien.
Que pouvez-vous en tirer ? Si vous avez Java, prenez la version moderne du driver et soyez satisfait.
Si vous avez un autre langage, alors pensez : peut-être que vous en avez aussi besoin ? Car du point de vue du langage final, par exemple, si c'est PL 8 ou si vous avez LibPQ, il n'est pas évident que vous passiez du temps à parser, et cela vaut la peine de vérifier. Comment ? Tout est gratuit.
À l'exception des erreurs, certaines particularités. Et nous allons justement en parler maintenant. La plupart portera sur l'archéologie industrielle, sur ce que nous avons trouvé, sur ce qui nous a interpellés.
Si la requête est générée dynamiquement. Cela arrive. Quelqu'un concatène des chaînes, ce qui donne une requête SQL.
Pourquoi est-elle mauvaise ? Elle est mauvaise car à chaque fois nous obtenons en fin de compte une chaîne différente.
Et cette chaîne variée doit recalculer son hashCode. C'est vraiment une tâche CPU – trouver un long texte de requête même dans le hash existant n'est pas si simple. Donc, la solution est simple – ne générez pas de requêtes. Conservez-les dans une variable. Et soyez satisfait.
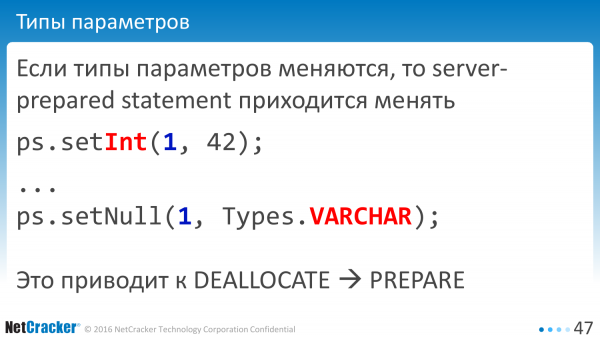
Le problème suivant. Les types de données sont importants. Il existe des ORM qui affirment que peu importe quel NULL, peu importe lequel. Si c'est un Int, alors nous disons setInt. Et si c'est NULL, alors que ce soit toujours VARCHAR. Et quelle différence cela fait-il au final quel type de NULL ? La base de données comprendra tout seule. Et ce tableau ne fonctionne pas.
Dans la pratique, la base de données ne se soucie pas du tout. Si vous avez dit une première fois que c'était un nombre, et la seconde fois que c'était VARCHAR, il est impossible de réutiliser les déclarations préparées du serveur. Dans ce cas, il faut recréer notre déclaration.
Si vous exécutez la même requête, faites attention à ne pas mélanger les types de données dans la colonne. Il faut veiller au NULL. C'est une erreur fréquente que nous avons rencontrée après avoir commencé à utiliser les PreparedStatements.
D'accord, nous avons activé. Nous avons peut-être pris le driver. Et la performance a chuté. Tout est devenu mauvais.
Comment cela se fait-il ? Un bug ou une fonctionnalité ? Malheureusement, nous n'avons pas pu comprendre – est-ce un bug ou une fonctionnalité. Mais il existe un scénario assez simple pour reproduire ce problème. Il nous a pris par surprise. Et cela concerne une sélection littérale à partir d'une seule table. Nous avions bien sûr plus de telles requêtes. En général, elles impliquaient deux à trois tables, mais voici un scénario de reproduction. Prenez n'importe quelle version de votre base et reproduisez.
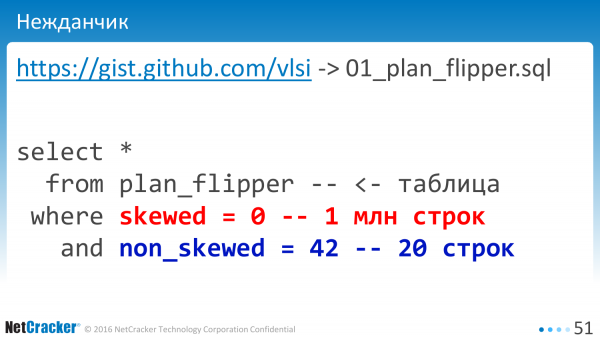
L'idée est que nous avons deux colonnes, chacune indexée. Dans une colonne avec la valeur NULL, il y a un million de lignes. Et dans l'autre colonne, il n'y a que 20 lignes. Lorsque nous exécutons sans variables liées, tout fonctionne bien.
Si nous commençons à exécuter avec des variables liées, c'est-à-dire que nous exécutons le « ? » ou « $1 » pour notre requête, que recevons-nous finalement ?
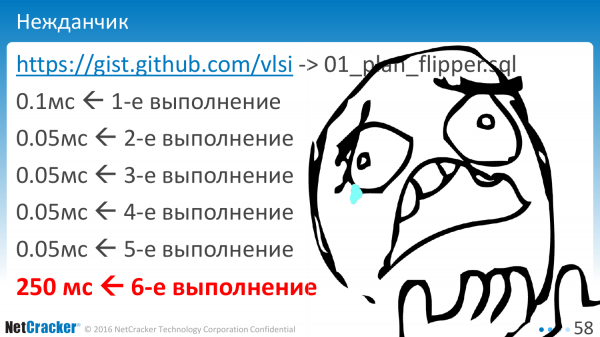
Première exécution – comme il se doit. Deuxième – un peu plus rapide. Quelque chose s'est mis en cache. Troisième-quatrième-cinquième. Puis soudain – et comme ça. Et le pire, c'est que cela se produit à la sixième exécution. Qui savait qu'il fallait faire exactement six exécutions pour comprendre quel était vraiment le plan d'exécution ?
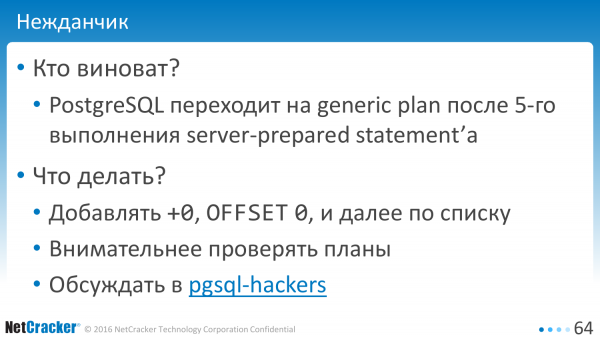
Qui est responsable ? Que s'est-il passé ? La base de données contient une optimisation. Et elle est, en quelque sorte, optimisée pour un cas générique. Et, par conséquent, après un certain temps, elle passe à un plan générique, qui, hélas, peut s'avérer être différent. Il peut être le même, ou il peut être différent. Et il y a une certaine valeur seuil qui conduit à ce comportement.
Que peut-on en faire ? Ici, il est bien sûr plus difficile de faire des hypothèses. Il existe une solution simple que nous utilisons. C'est +0, OFFSET 0. Vous connaissez sûrement de telles solutions. On prend juste et on ajoute « +0 » à la requête et tout va bien. Je vais le montrer plus tard.
Il y a aussi une autre option : regarder les plans de plus près. Le développeur doit non seulement écrire la requête, mais aussi dire « explain analyze » six fois. Si c'est cinq, ça ne convient pas.
Et il y a aussi une troisième option : écrire un mail à pgsql-hackers. J'ai écrit, mais pour l'instant, ce n'est pas clair – est-ce un bug ou une fonctionnalité.
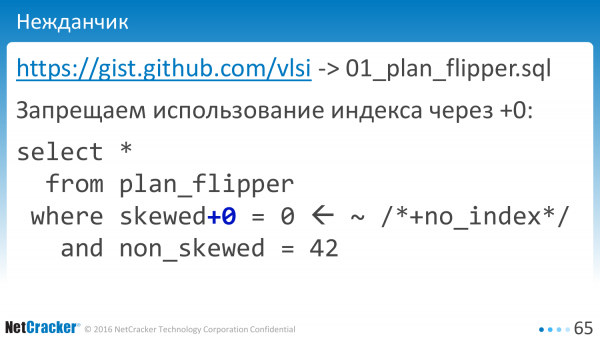
Pendant que nous réfléchissons – est-ce un bug ou une fonctionnalité, réparons-le. Prenons notre requête et ajoutons « +0 ». Tout va bien. Deux symboles et même pas besoin de penser à comment cela fonctionne. C'est très simple. Nous avons simplement empêché la base de données d'utiliser l'index sur cette colonne. Nous n'avons pas d'index sur la colonne « +0 » et tout va bien, la base de données n'utilise pas l'index.
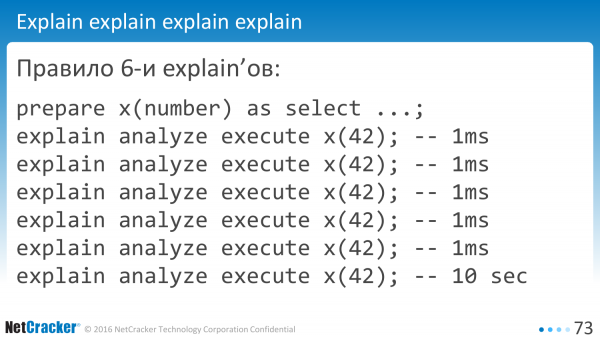
Voici la règle des six « explain ». Dans les versions actuelles, il faut le faire six fois si vous avez des variables liées. Si vous n'avez pas de variables liées, alors nous faisons ainsi. Et en fin de compte, c'est justement cette requête qui échoue. Ce n'est pas sorcier.
On pourrait penser, jusqu'à quand ? Il y a un bug ici, un bug là. Il y a vraiment des bugs partout.
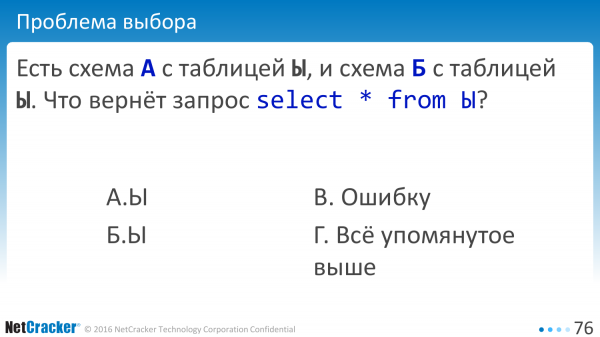
Regardons encore. Par exemple, nous avons deux schémas. Schéma A avec la table Y et schéma B avec la table Y. La requête – sélectionner des données de la table. Que se passera-t-il alors ? Nous aurons une erreur. Nous aurons tout ce qui a été mentionné précédemment. La règle est la suivante : bug partout, nous aurons tout ce qui a été mentionné précédemment.
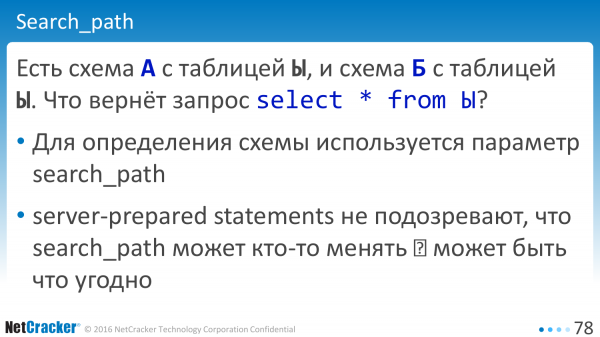
Maintenant, la question : « Pourquoi ? ». On pourrait penser qu'il y a de la documentation indiquant que, si nous avons un schéma, il y a une variable « search_path », qui indique où chercher la table. On pourrait penser qu'il y a une variable.
Quel est le problème ? Le problème est que les instructions préparées par le serveur ne soupçonnent pas que quelqu'un peut changer le search_path. Cette valeur reste, en quelque sorte, constante pour la base de données. Et certaines parties peuvent ne pas saisir les nouvelles valeurs.
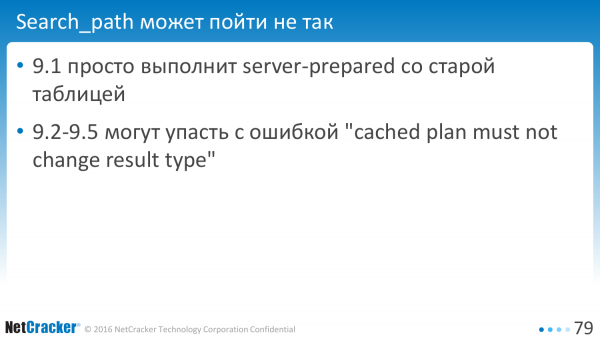
Bien sûr, cela dépend de la version sur laquelle vous testez. Cela dépend de la mesure dans laquelle vos tables diffèrent. Et la version 9.1 exécutera simplement les anciennes requêtes. Les nouvelles versions peuvent détecter des anomalies et indiquer que vous avez une erreur.
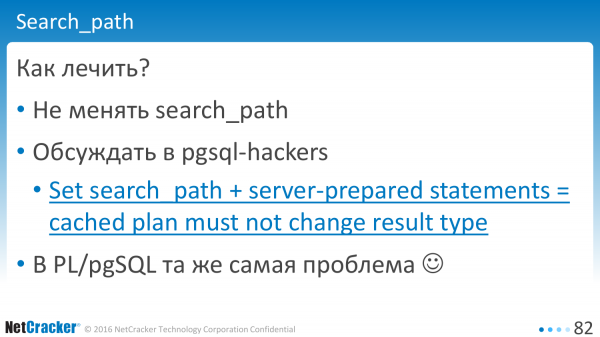
Comment y remédier ? Il existe une recette simple : ne faites pas cela. Ne changez pas le search_path pendant l'exécution de l'application. Si vous le changez, mieux vaut créer une nouvelle connexion.
Nous pouvons en discuter, c'est-à-dire l'ouvrir, en discuter, compléter. Peut-être convaincrons-nous les développeurs de la base de données que, lorsque quelqu'un change une valeur, la base de données devrait le signaler au client : « Regardez, votre valeur a été mise à jour. Peut-être devez-vous réinitialiser les instructions, les recréer ? ». Actuellement, la base de données se comporte discrètement et ne signale pas du tout que quelque chose a changé à l'intérieur des instructions.
Et je vais de nouveau insister - c'est quelque chose de peu typique pour Java. Nous verrons la même chose dans PL/pgSQL un pour un. Mais là, elle sera reproduite.
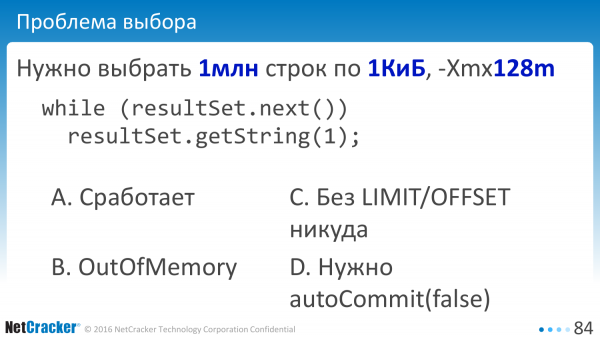
Essayons encore de sélectionner des données. Nous sélectionnons, sélectionnons. Nous avons une table d'un million de lignes. Chaque ligne fait un kilooctet. Environ un gigaoctet de données. Et nous avons une mémoire vive de machine Java de 128 mégaoctets.
Comme recommandé dans tous les livres, nous utilisons le traitement par flux. C'est-à-dire que nous ouvrons resultSet et lisons les données petit à petit. Est-ce que cela fonctionnera ? Va-t-il planter par manque de mémoire ? Va-t-il lire un peu à la fois ? Faisons confiance à la base, faisons confiance à Postgres. Nous ne faisons pas confiance. Va-t-on avoir un OutOfMemory ? Qui a déjà eu un OutOfMemory ? Et qui a réussi à réparer cela ? Quelqu'un a-t-il réussi à récupérer ?
Si vous avez un million de lignes, vous ne pouvez pas simplement sélectionner ainsi. Il est impératif d'utiliser OFFSET/LIMIT. Qui est pour cette option ? Et qui est pour l'idée de jouer avec autoCommit ?
Ici, comme d'habitude, la solution la plus inattendue s'avère être la bonne. Et si vous désactivez autoCommit, cela aidera. Pourquoi cela ? La science ne le sait pas.
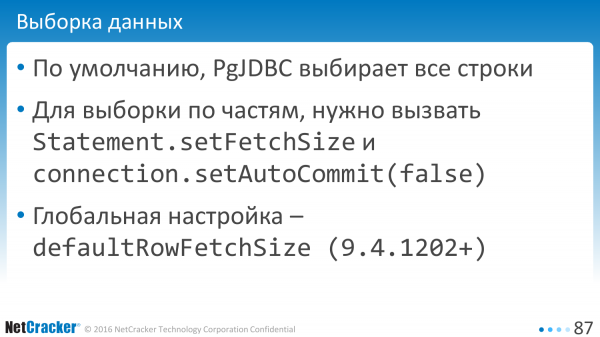
Mais par défaut, tous les clients se connectant à la base de données Postgres sélectionnent toutes les données. PgJDBC n'est pas une exception dans ce cas, il sélectionne toutes les lignes.
Il existe une variation sur le thème FetchSize, c'est-à-dire que l'on peut au niveau d'une instruction individuelle dire ici, s'il vous plaît, sélectionnez les données par 10, 50. Mais cela ne fonctionne pas tant que vous n'avez pas désactivé autoCommit. Vous avez désactivé autoCommit – cela commence à fonctionner.
Mais parcourir le code et mettre setFetchSize partout n'est pas pratique. C'est pourquoi nous avons créé un paramètre qui définit la valeur par défaut pour toute la connexion.
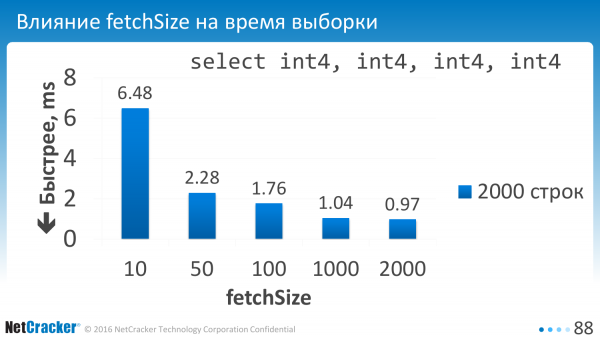
Nous l'avons dit. Nous avons configuré le paramètre. Et qu'est-ce que cela nous a donné ? Si nous choisissons peu de lignes, par exemple 10 lignes, notre surcharge est assez élevée. Il faut donc fixer cette valeur à environ une centaine.
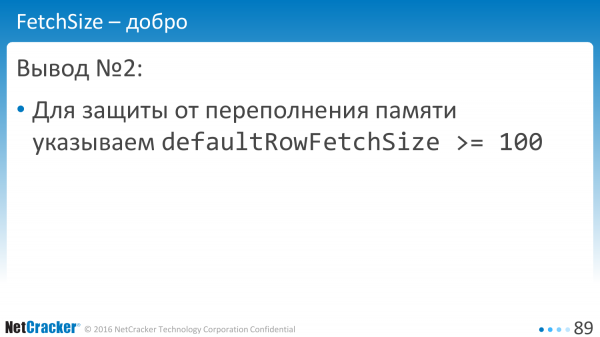
Idéalement, bien sûr, il faudrait aussi apprendre à limiter en octets, mais la recette est la suivante : fixez defaultRowFetchSize à plus de cent et réjouissez-vous.
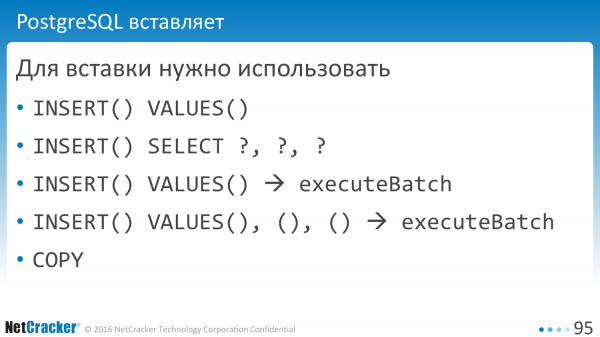
Passons à l'insertion de données. L'insertion est plus simple, il existe différentes options. Par exemple, INSERT, VALUES. C'est une bonne option. On peut dire 'INSERT SELECT'. En pratique, c'est la même chose. Il n'y a pas de différence de performance.
Les livres disent qu'il faut exécuter des Batch statements, les livres disent qu'on peut exécuter des commandes plus complexes avec plusieurs parenthèses. Et dans Postgres, il y a une merveilleuse fonction – on peut faire COPY pour le rendre plus rapide.

Si nous mesurons, nous pouvons faire plusieurs découvertes intéressantes. Comment voulons-nous que cela fonctionne ? Nous voulons éviter de parser et de ne pas exécuter de commandes inutiles.
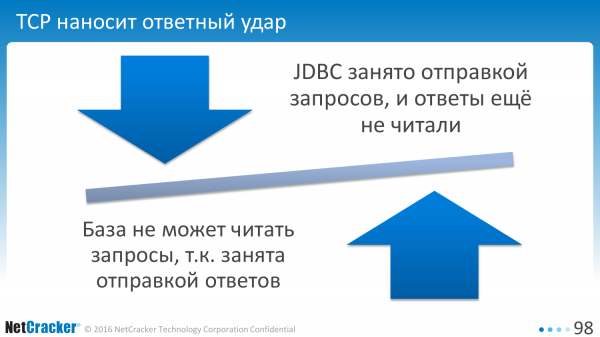
En pratique, TCP ne nous permet pas de faire cela. Si le client est occupé à envoyer une requête, la base de données, en essayant de nous envoyer les réponses, ne lit pas les requêtes. Au final, le client attend la base de données, pendant que celle-ci attend que le client lise la réponse.
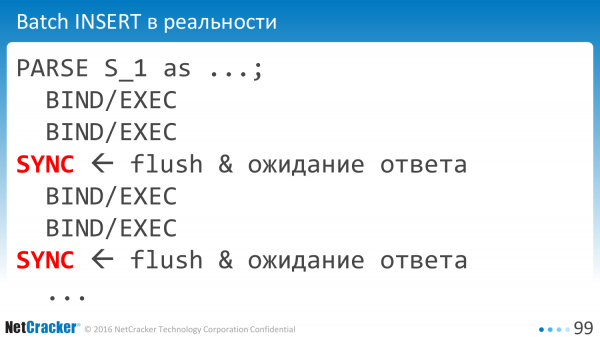
C'est pourquoi le client est contraint d'envoyer régulièrement un paquet de synchronisation. Interactions réseau inutiles, perte de temps superflue.
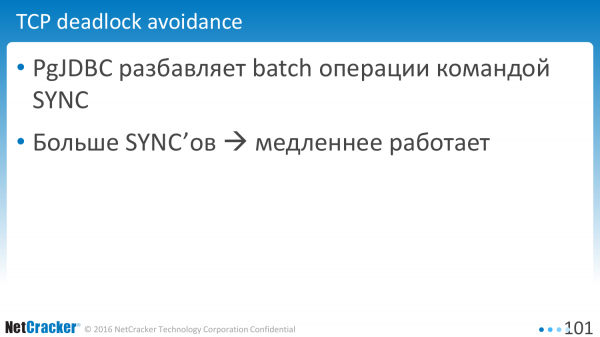 Et plus nous en ajoutons, pire c'est. Le pilote est très pessimiste et les ajoute assez souvent, environ toutes les 200 lignes, selon la taille des lignes, etc.
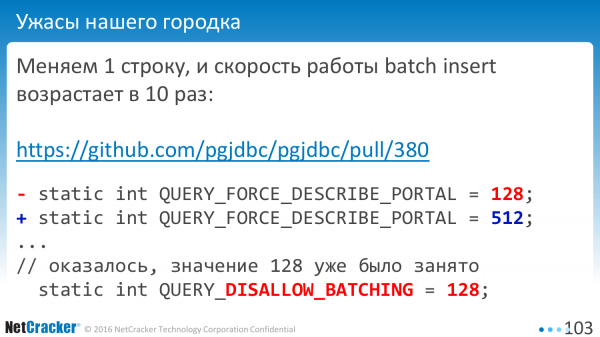
Il arrive que vous corrigiez une seule ligne et que tout s'accélère dix fois. Cela arrive. Pourquoi ? Comme toujours, une constante avait déjà été utilisée quelque part. Et la valeur '128' signifiait - ne pas utiliser le batching.
C'est bien que cela ne soit pas tombé dans la version officielle. Nous l'avons découvert avant de commencer à publier la version. Toutes les valeurs que je mentionne sont basées sur des versions récentes.
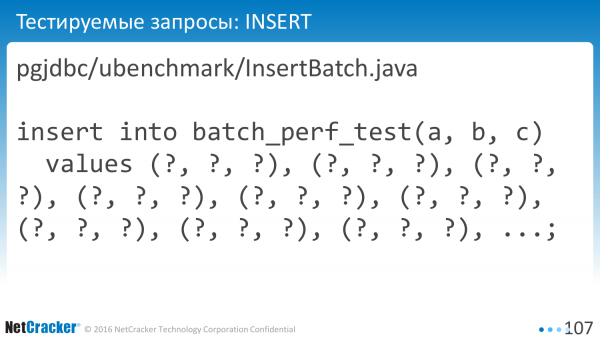
Mesurons. Nous mesurons InsertBatch simple. Nous mesurons InsertBatch multiple, c'est-à-dire la même chose, mais avec beaucoup de valeurs. Une manœuvre astucieuse. Tout le monde ne sait pas faire cela, mais c'est un simple tour, bien plus simple que COPY.
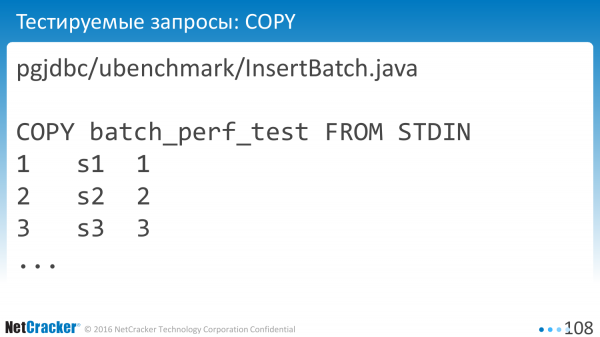
On peut faire COPY.
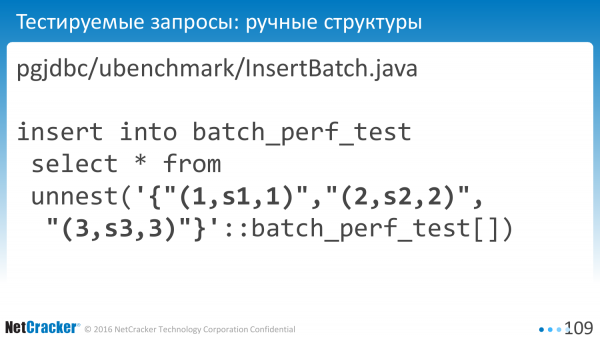
Et vous pouvez le faire avec des structures. Déclarez le type User par défaut, transmettez un tableau et insérez directement dans la table.
Si vous ouvrez le lien : pgjdbc/ubenchmsrk/InsertBatch.java, le code se trouve sur GitHub. Vous pouvez voir précisément quelles requêtes y sont générées. Ce n'est pas le plus important.
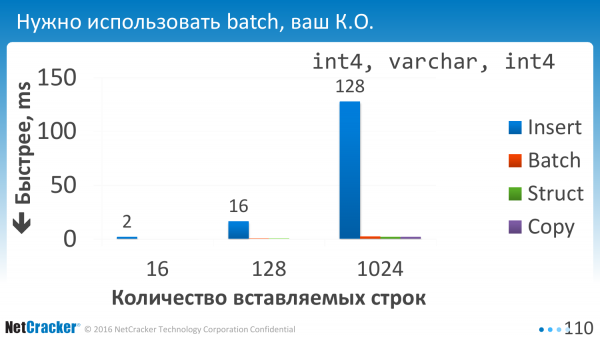
Nous avons lancé. Et la première chose que nous avons comprise, c'est qu'il est tout simplement impossible de ne pas utiliser le batch. Toutes les options de batching sont nulles, c'est-à-dire que le temps d'exécution est pratiquement égal à zéro par rapport à une exécution unique.
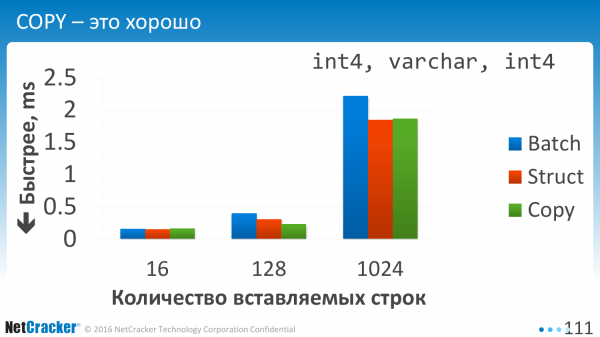
Nous insérons des données. Il s'agit d'une table très simple. Trois colonnes. Et que voyons-nous ici ? Nous voyons que ces trois options sont à peu près comparables. Et COPY, bien sûr, est le meilleur.
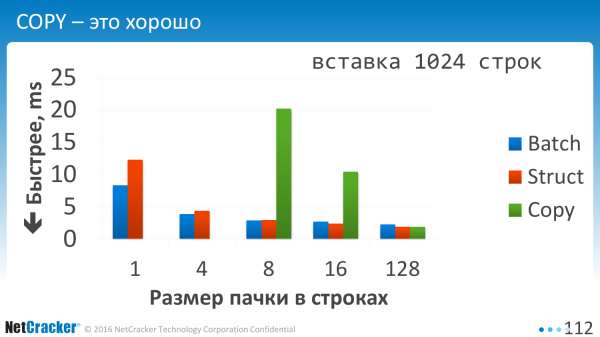
C'est quand nous insérons par morceaux. Quand nous avons dit, une valeur VALUES, deux valeurs VALUES, trois valeurs VALUES ou nous les avons spécifiées 10 par des virgules. C'est exactement ce qui est maintenant horizontal. 1, 2, 4, 128. On voit que l'Insertion par lot, représentée en bleu, est nettement plus légère. C'est-à-dire que lorsque vous insérez un par un ou même quatre, ça devient deux fois mieux, simplement parce que nous avons mis un peu plus dans VALUES. Moins d'opérations EXECUTE.
Utiliser COPY sur de petits volumes est extrêmement peu prometteur. Je n'ai même pas dessiné sur les deux premiers. Ils vont vers les cieux, c'est-à-dire que ces chiffres verts pour COPY.
Il faut utiliser COPY quand vous avez au moins plus de cent lignes de données. Les frais généraux pour ouvrir cette connexion sont élevés. Et, honnêtement, je ne me suis pas penché là-dessus. J'ai optimisé le batch, pas COPY.
Que faisons-nous ensuite ? Nous mesurons. Nous comprenons qu'il faut utiliser soit des structures, soit un batch astucieux combinant plusieurs valeurs.
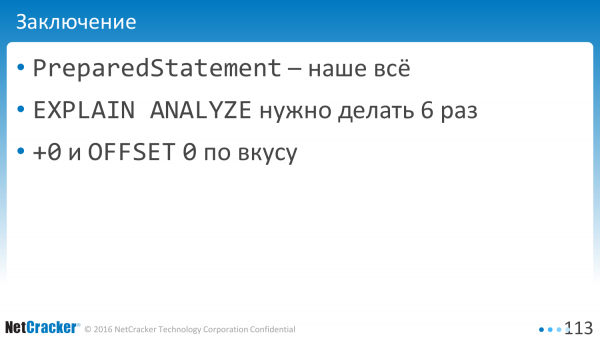
Que faut-il retenir de la présentation d'aujourd'hui ?
- PreparedStatement est notre essentiel. Cela apporte énormément pour la performance. Cela laisse un grand seau de goudron.
- Et il faut faire un EXPLAIN ANALYZE 6 fois.
- Et il faut diluer OFFSET 0, et des astuces comme +0 pour corriger le pourcentage restant de nos requêtes problématiques.
Source : habr.com
