

Salut, Habr !
À la lumière des événements actuels liés au coronavirus, plusieurs services en ligne font face à une charge accrue. Par exemple, car les ressources n'étaient pas suffisantes. De plus, il n'est pas toujours possible d'accélérer un serveur simplement en ajoutant du matériel plus puissant, mais il est nécessaire de traiter les demandes des clients (sinon, ils iront chez les concurrents).
Dans cet article, je vais brièvement parler des pratiques populaires qui permettront de créer un service rapide et résilient. Cependant, parmi les schémas de développement possibles, j'ai sélectionné uniquement ceux que vous pouvez actuellement facilement utiliser.Pour chaque point, vous avez soit déjà des bibliothèques prêtes à l'emploi, soit la possibilité de résoudre le problème en utilisant une plateforme cloud.
Scalabilité horizontale
Le point le plus simple et le plus connu. On distingue généralement deux méthodes de répartition de la charge : la scalabilité horizontale et verticale. vous permettez aux services de fonctionner en parallèle, répartissant ainsi la charge entre eux. vous commandez des serveurs plus puissants ou optimisez le code.
À titre d'exemple, je vais prendre un stockage cloud abstrait de fichiers, c'est-à-dire un certain équivalent d'OwnCloud, OneDrive, etc.
L'image standard de ce type de schéma est ci-dessous, mais elle ne fait qu'illustrer la complexité du système. En effet, nous devons synchroniser les services. Que se passe-t-il si un utilisateur sauvegarde un fichier depuis sa tablette et souhaite ensuite le consulter sur son téléphone ?
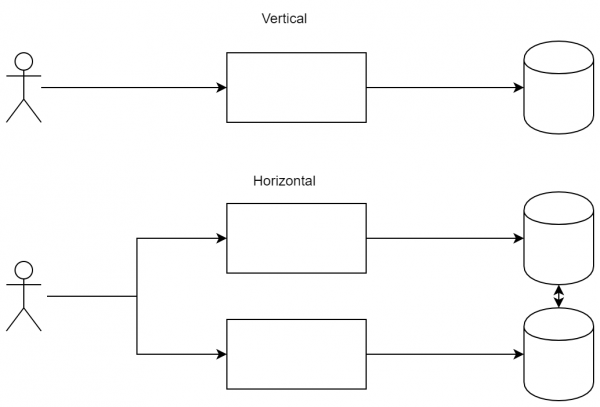
La différence entre les approches : dans la scalabilité verticale, nous sommes prêts à accroître la puissance des nœuds, tandis que dans la scalabilité horizontale, nous ajoutons de nouveaux nœuds pour répartir la charge.
CQRS
est un modèle assez important, car il permet à différents clients non seulement de se connecter à différents services, mais également de recevoir des flux d'événements identiques. Ses avantages ne sont pas si évidents pour une application simple, mais ils sont extrêmement importants (et simples) pour un service chargé. Son principe : les flux de données entrants et sortants ne doivent pas se croiser. En d'autres termes, vous ne pouvez pas envoyer une requête et attendre une réponse, au lieu de cela, vous envoyez une requête au service A, mais vous obtenez une réponse dans le service B.
Le premier avantage de cette approche est la possibilité d'interrompre la connexion (au sens large du terme) pendant l'exécution d'une longue requête. Prenons par exemple une séquence standard :
- Le client a envoyé une requête au serveur.
- Le serveur a lancé un traitement long.
- Le serveur a répondu au client avec un résultat.
Imaginons que, dans le point 2, une interruption de connexion se soit produite (soit en raison d'une déconnexion réseau, soit parce que l'utilisateur est passé à une autre page, rompant ainsi la connexion). Dans ce cas, il sera difficile pour le serveur d'envoyer une réponse à l'utilisateur concernant ce qui a été traité. En appliquant CQRS, la séquence sera légèrement différente :
- Le client s'est abonné aux mises à jour.
- Le client a envoyé une requête au serveur.
- Le serveur a répondu « requête reçue ».
- Le serveur a répondu avec le résultat via le canal du point « 1 ».
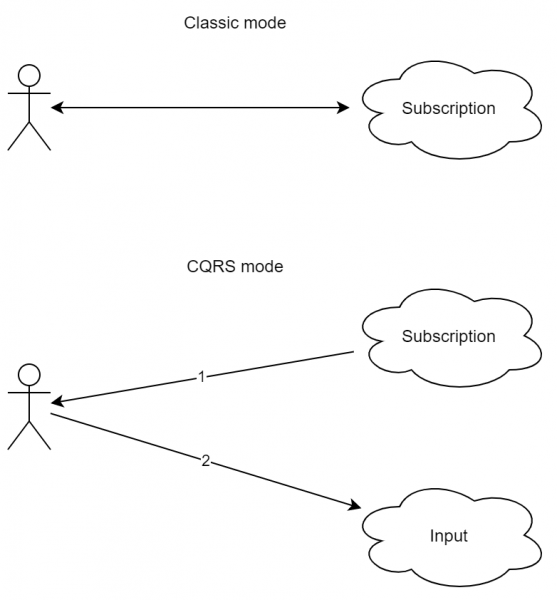
Comme on le voit, le schéma est légèrement plus complexe. De plus, l'approche intuitive request-response est absente ici. Cependant, comme on peut le voir, une interruption de connexion pendant le traitement de la requête ne conduira pas à une erreur. De plus, si l'utilisateur est effectivement connecté au service depuis plusieurs appareils (par exemple, un téléphone mobile et une tablette), il est possible de faire en sorte que la réponse parvienne aux deux appareils.
Il est intéressant de noter que le code de traitement des messages entrants devient identique (à 100 %) tant pour les événements affectés par le client lui-même que pour les autres événements, y compris ceux d'autres clients.
Cependant, dans la réalité, nous obtenons des avantages supplémentaires grâce au fait qu'un flux unidirectionnel peut être traité de manière fonctionnelle (en utilisant RX et des analogues). Et c'est déjà un vrai plus, car en substance, l'application peut devenir complètement réactive, tout en utilisant également une approche fonctionnelle. Pour les applications lourdes, cela peut considérablement économiser des ressources en développement et en maintenance.
Si nous combinons cette approche avec une mise à l'échelle horizontale, alors nous obtenons en prime la possibilité d'envoyer des requêtes à un serveur tout en recevant des réponses d'un autre. Ainsi, le client peut choisir le service qui lui convient le mieux, et le système à l'intérieur pourra tout de même traiter les événements de manière appropriée.
Event Sourcing
Comme vous le savez, l'une des caractéristiques principales d'un système distribué est l'absence de temps commun et de section critique partagée. Pour un seul processus, vous pouvez effectuer une synchronisation (sur les mêmes mutex), où vous êtes sûr que personne d'autre n'exécute ce code. Cependant, pour un système distribué, cela peut être dangereux, car cela entraînera des frais généraux et ruinera tout l'intérêt de l'évolutivité : tous les composants devront attendre les uns les autres.
D'ici, nous obtenons un fait important : un système distribué rapide ne peut pas être synchronisé, car cela diminuerait les performances. D'un autre côté, nous avons souvent besoin d'une certaine cohérence des composants. Et pour cela, nous pouvons utiliser l'approche de , qui garantit qu'en l'absence de modifications des données, après un certain laps de temps après la dernière mise à jour (« en fin de compte »), toutes les requêtes renverront la dernière valeur mise à jour.
Il est important de comprendre qu'une est souvent appliquée aux bases de données classiques, où chaque nœud possède les mêmes informations (ce qui est souvent réalisé lorsqu'une transaction est considérée comme établie uniquement après la réponse d'un deuxième serveur). Il existe certaines concessions dues aux niveaux d'isolation, mais l'idée principale reste la même : vous pouvez vivre dans un monde complètement cohérent.
Cependant, revenons à la tâche initiale. Si une partie du système peut être construite avec , alors on peut construire le schéma suivant.
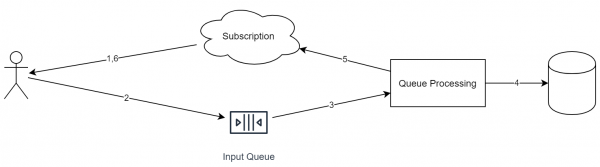
Caractéristiques importantes de cette approche :
- Chaque requête entrante est placée dans une seule file d'attente.
- Au cours du traitement de la requête, le service peut également placer des tâches dans d'autres files d'attente.
- Chaque événement entrant a un identifiant (nécessaire pour la déduplication).
- La file d'attente fonctionne idéologiquement selon le principe "ajout uniquement". On ne peut pas supprimer des éléments ou les réorganiser.
- La file d'attente fonctionne selon le schéma FIFO (désolé pour la tautologie). Si une exécution parallèle est nécessaire, il conviendrait à un des niveaux de redistribuer les objets dans différentes files d'attente.
Je rappelle que nous examinons le cas d'un stockage de fichiers en ligne. Dans ce cas, le système ressemblera, environ, à ceci :
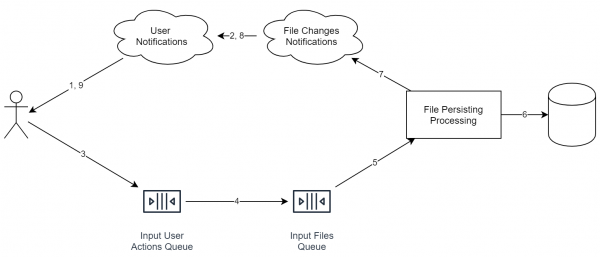
Il est important de noter que les services sur le diagramme ne signifient pas nécessairement un serveur séparé. Le processus peut être identique. Ce qui est crucial, c'est que ces éléments sont idéologiquement séparés de manière à faciliter l'application de l'évolutivité horizontale.
Pour deux utilisateurs, le schéma apparaîtra comme suit (les services destinés à différents utilisateurs sont indiqués en différentes couleurs) :
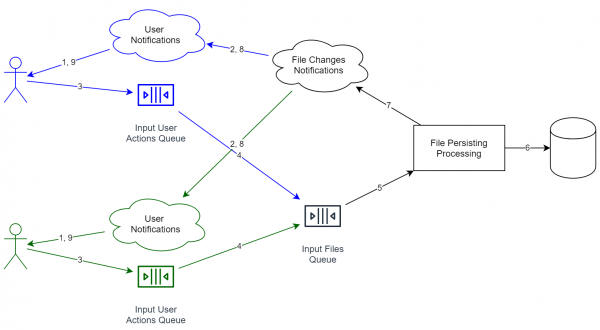
Les avantages d'une telle combinaison :
- Les services de traitement de données sont séparés. Les files d'attente sont également distinctes. Si nous devons augmenter la capacité de la système, il suffit de lancer davantage de services sur un plus grand nombre de serveurs.
- Lorsque nous recevons des informations de l'utilisateur, nous ne devons pas nécessairement attendre la sauvegarde complète des données. Au contraire, il est suffisant de répondre « ok », puis de commencer progressivement à travailler. De plus, la file d'attente atténue les pics, car l'ajout d'un nouvel objet se fait rapidement, et l'utilisateur n'a pas à attendre un passage complet par tout le cycle.
- À titre d'exemple, j'ai ajouté un service de déduplication qui tente de regrouper les fichiers identiques. S'il fonctionne longuement dans 1% des cas, le client ne le remarquera pratiquement pas (voir ci-dessus), ce qui est un grand avantage, car nous ne demandons plus une vitesse et une fiabilité à 100%.
Cependant, les inconvénients sont également évidents :
- Notre système a perdu une cohérence stricte. Cela signifie que si, par exemple, on s'abonne à différents services, il est théoriquement possible d'obtenir des états différents (puisqu'un des services peut ne pas réussir à recevoir la notification de la file d'attente interne). Comme autre conséquence, le système n'a plus de temps commun. Autrement dit, il n'est pas possible, par exemple, de trier tous les événements simplement par ordre d'arrivée, car les horloges entre les serveurs peuvent ne pas être synchronisées (de plus, deux serveurs ayant la même heure est une utopie).
- Aucun événement ne peut maintenant être simplement annulé (comme cela aurait pu être fait avec une base de données). Au lieu de cela, il est nécessaire d'ajouter un nouvel événement — , qui va changer le dernier état en celui requis. Un exemple d'un domaine similaire : sans réécriture de l'historique (ce qui est mauvais dans certains cas), il n'est pas possible de revenir à un commit dans git, mais on peut faire un spécial , qui en fait ne renverra qu'à l'état précédent. Cependant, l'historique conservera à la fois le commit erroné et le rollback.
- Le schéma des données peut changer d'une version à l'autre, cependant, il ne sera plus possible de mettre à jour les anciens événements vers le nouveau standard (car les événements ne peuvent en principe pas être modifiés).
Comme on peut le voir, l'Event Sourcing s'intègre parfaitement avec le CQRS. De plus, mettre en place un système avec des files d'attente efficaces et pratiques, mais sans séparation des flux de données, est déjà en soi compliqué, car il faudra ajouter des points de synchronisation qui annuleront tout l'effet positif des files d'attente. En appliquant les deux approches simultanément, il est nécessaire d'ajuster légèrement le code de l'application. Dans notre cas, lors de l'envoi d'un fichier au serveur, la réponse ne contient que « ok », ce qui signifie simplement que « l'opération d'ajout de fichier a été enregistrée ». Formellement, cela n'indique pas que les données sont déjà accessibles sur d'autres appareils (par exemple, un service de dé-duplication peut être en train de reconstruire l'index). Cependant, après un certain temps, le client recevra une notification du type « fichier X enregistré ».
En conséquence :
- Le nombre de statuts d'envoi de fichiers augmente : au lieu du classique « fichier envoyé », nous obtenons deux : « fichier ajouté à la file d'attente sur le serveur » et « fichier enregistré dans le stockage ». Ce dernier signifie que d'autres appareils peuvent déjà commencer à recevoir le fichier (avec la nuance que les files d'attente fonctionnent à des vitesses différentes).
- En raison du fait que l'information sur l'envoi arrive maintenant par différents canaux, nous devons trouver des solutions pour obtenir le statut de traitement du fichier. En conséquence, contrairement à la méthode classique de requête-réponse, le client peut être redémarré pendant le traitement du fichier, mais le statut de ce traitement sera correct. De plus, ce point fonctionne en fait de manière native. En conséquence : nous sommes maintenant plus tolérants aux pannes.
Sharding
Comme déjà mentionné, dans les systèmes avec event sourcing, il n'y a pas de cohérence stricte. Cela signifie que nous pouvons utiliser plusieurs stockages sans aucune synchronisation entre eux. En nous rapprochant de notre tâche, nous pouvons :
- Séparer les fichiers par types. Par exemple, les images/vidéos peuvent être décodées et choisies dans un format plus efficace.
- Séparer les comptes par pays. En raison de nombreuses lois, cela peut être nécessaire, cependant, cette architecture offre une telle possibilité automatiquement.
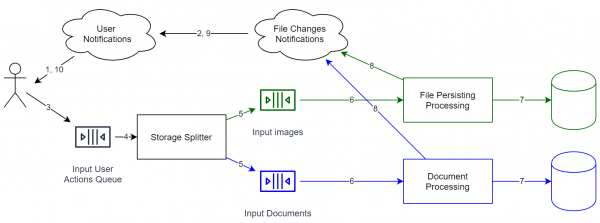
Si vous souhaitez transférer des données d'un stockage à un autre, les moyens standards ne suffisent pas ici. Malheureusement, dans ce cas, il est nécessaire d'arrêter la file d'attente, de faire la migration, puis de la relancer. En général, les données ne peuvent pas être transférées 'à la volée', cependant, si la file d'événements est entièrement conservée, et que vous avez des instantanés des états précédents du stockage, nous pouvons rejouer les événements comme suit :
- Dans Event Source, chaque événement a son identifiant (idéalement — non décroissant). Cela signifie que nous pouvons ajouter un champ dans le stockage — id du dernier élément traité.
- Nous dupliquons la file d'attente, afin que tous les événements puissent être traités pour plusieurs stockages indépendants (le premier étant celui où les données sont déjà stockées, et le second étant nouveau, mais encore vide). La seconde file d'attente n'est bien sûr pas encore traitée.
- Nous lançons la seconde file d'attente (c'est-à-dire que nous commençons à rejouer les événements).
- Lorsque la nouvelle file d'attente sera relativement vide (c'est-à-dire que l'écart moyen de temps entre l'ajout d'un élément et sa récupération sera acceptable), nous pourrons commencer à rediriger les lecteurs vers le nouveau stockage.
Comme on peut le voir, notre système n'a jamais eu de cohérence stricte. Il y a seulement une constance éventuelle, c'est-à-dire la garantie que les événements sont traités dans le même ordre (mais, peut-être, avec un décalage différent). En profitant de cela, nous pouvons relativement facilement transférer des données sans arrêter le système à l'autre bout du monde.
Ainsi, en continuant notre exemple d'un stockage en ligne pour fichiers, une telle architecture nous offre déjà plusieurs avantages :
- Nous pouvons déplacer des objets plus près des utilisateurs, de manière dynamique. Cela peut ainsi améliorer la qualité du service.
- Nous pouvons stocker une partie des données à l'intérieur des entreprises. Par exemple, les utilisateurs d'entreprise exigent souvent que leurs données soient stockées dans des centres de données sous contrôle (pour éviter les fuites de données). Grâce au sharding, nous pouvons facilement soutenir cela. Et la tâche est encore simplifiée si le client a un cloud compatible (par exemple, ).
- Le plus important est que nous n'avons pas à le faire. En fait, au départ, un seul stockage pour tous les comptes nous suffirait (pour commencer à travailler plus rapidement). La caractéristique clé de ce système est qu'il est simple au départ, bien qu'il soit extensible. Il suffit de ne pas écrire immédiatement le code qui traite un million de files d'attente indépendantes, etc. Si nécessaire, cela peut être fait à l'avenir.
Hébergement de Contenu Statique
Ce point peut sembler évident, mais il est néanmoins nécessaire pour une application chargée relativement standard. Son essence est simple : tout le contenu statique est distribué non pas depuis le même serveur que l'application, mais depuis des serveurs dédiés à cet effet. En conséquence, ces opérations sont effectuées plus rapidement (un nginx par exemple, distribue les fichiers de manière plus efficace et moins coûteuse qu'un serveur Java). De plus, l'architecture CDN () permet de placer nos fichiers plus près des utilisateurs finaux, ce qui améliore l'ergonomie de l'utilisation du service.
Le meilleur exemple de contenu statique est un ensemble de scripts et d'images pour un site web. C'est assez simple - ils sont connus à l'avance, puis l'archive est téléchargée sur les serveurs CDN, d'où elle est distribuée aux utilisateurs finaux.
Cependant, en réalité, pour le contenu statique, nous pouvons appliquer une approche similaire à l'architecture lambda. Revenons à notre tâche (un stockage de fichiers en ligne), où nous devons distribuer des fichiers aux utilisateurs. La solution la plus simple serait de créer un service qui effectue toutes les vérifications nécessaires (authentification, etc.) pour chaque demande utilisateur, puis télécharge le fichier directement depuis notre stockage. Le principal inconvénient de cette approche est que le contenu statique (et un fichier avec un certain révision est essentiellement du contenu statique) est distribué par le même serveur qui contient la logique métier. Au lieu de cela, nous pouvons proposer le schéma suivant :
- Le serveur fournit une URL de téléchargement. Elle peut être sous la forme file_id + key, où la key est une signature numérique courte, donnant accès à la ressource pour les prochaines 24 heures.
- La distribution du fichier est gérée par un simple nginx avec les options suivantes :
- Mise en cache du contenu. Étant donné que ce service peut être sur un serveur séparé, nous nous sommes laissés une marge pour l'avenir avec la possibilité de stocker tous les fichiers téléchargés récemment sur le disque.
- Vérification de la clé au moment de la création de la connexion
- En option : traitement en continu du contenu. Par exemple, si nous compressons tous les fichiers dans le service, il est possible de décompresser directement dans ce module. Par conséquent, les opérations IO sont effectuées là où elles ont le plus de sens. Un archiveur en Java pourrait facilement consommer beaucoup de mémoire, mais réécrire le service avec la logique métier en Rust/C++ pourrait également s'avérer inefficace. Dans notre cas, différents processus (ou même services) sont utilisés, ce qui permet de séparer efficacement la logique métier des opérations IO.
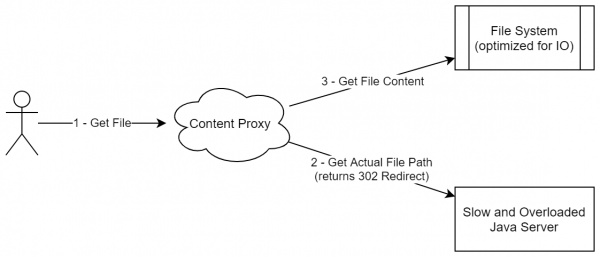
Un tel schéma ressemble peu à la distribution de contenu statique (car nous ne téléchargeons pas l'ensemble du paquet statique quelque part), mais dans la réalité, cette approche s'occupe bien de la distribution de données immuables. De plus, ce schéma peut être généralisé à d'autres cas, où le contenu n'est pas simplement statique, mais peut être représenté par un ensemble de blocs immuables et non supprimables (bien qu'ils puissent être ajoutés).
Un autre exemple (pour bien illustrer) : si vous avez travaillé avec Jenkins/TeamCity, vous savez que les deux solutions sont écrites en Java. Elles représentent toutes deux un processus Java qui s'occupe à la fois de l'orchestration des builds et de la gestion du contenu. En particulier, elles ont toutes deux des tâches du type "transférer un fichier/dossier depuis le serveur". Par exemple : distribution d'artefacts, transmission du code source (quand l'agent ne télécharge pas le code directement depuis le dépôt, mais que le serveur le fait à sa place), accès aux logs. Toutes ces tâches diffèrent par leur charge IO. Cela signifie que le serveur responsable de la logique métier complexe doit également être capable de gérer efficacement de grands flux de données. Et ce qui est intéressant, c'est qu'une telle opération peut être déléguée au même nginx selon le même schéma (à condition d'ajouter une clé de données à la requête).
Cependant, si nous revenons à notre système, nous obtenons un schéma similaire :
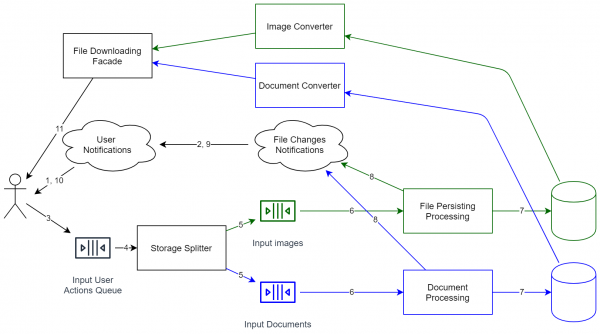
Comme vous pouvez le constater, le système est devenu radicalement plus complexe. Ce n’est plus simplement un mini-processus qui stocke des fichiers localement. Il nécessite maintenant un support non trivial, un contrôle de version de l’API, etc. Il est donc préférable, après avoir dessiné tous les diagrammes, d’évaluer en détail si l’évolutivité de telles dépenses en vaut la peine. Cependant, si vous souhaitez être en mesure d’évoluer (y compris pour gérer un nombre encore plus important d’utilisateurs), vous devrez envisager des solutions de ce type. En revanche, cela rend le système architecturé prêt à une augmentation de la charge (pratiquement chaque composant peut être cloné pour un scaling horizontal). Le système peut être mis à jour sans être arrêté (simplement, certaines opérations vont légèrement ralentir).
Comme je l’ai déjà mentionné au début, un certain nombre de services Internet supportent désormais une charge accrue. Et certains d’entre eux ont simplement cessé de fonctionner correctement. En effet, les systèmes ont échoué au moment même où les entreprises devraient générer des revenus. Au lieu de livraisons différées, au lieu de proposer aux clients de 'planifier la livraison pour les mois à venir', le système a simplement dit 'allez voir nos concurrents'. C'est cela le coût d'une faible performance : les pertes se produisent exactement quand les bénéfices seraient les plus élevés.
Conclusion
Tous ces approches étaient déjà connues auparavant. VK utilise depuis longtemps l'idée de Static Content Hosting pour délivrer des images. De nombreux jeux en ligne utilisent le schéma de Sharding pour diviser les joueurs par régions ou pour séparer les zones de jeu (si le monde est unique). L’approche d’Event Sourcing est activement utilisée dans l’e-mail. La plupart des applications des traders, où les données arrivent en continu, sont en réalité construites sur l’approche CQRS pour pouvoir filtrer les données reçues. De plus, le scaling horizontal est appliqué depuis longtemps dans de nombreux services.
Cependant, ce qui est le plus important, c'est que tous ces patrons sont devenus très faciles à appliquer dans les applications modernes (s'ils sont pertinents, bien sûr). Les clouds proposent le sharding et la mise à l'échelle horizontale immédiatement, ce qui est beaucoup plus facile que de commander différentes serveurs dédiés dans différents centres de données par soi-même. Le CQRS est devenu beaucoup plus simple, rien que grâce au développement de bibliothèques telles que RX. Il y a 10 ans, un site Web rare aurait pu le supporter. L'event sourcing est également configuré incroyablement facilement grâce à des conteneurs prêts à l'emploi avec Apache Kafka. Il y a 10 ans, cela aurait été une innovation, maintenant c'est une banalité. Il en va de même pour l'hébergement de contenu statique : grâce à des technologies plus pratiques (notamment parce qu'il existe une documentation détaillée et une vaste base de réponses), cette approche est devenue encore plus simple.
En fin de compte, la mise en œuvre d'un certain nombre de modèles architecturaux assez complexes est maintenant beaucoup plus facile, ce qui signifie qu'il vaut mieux y prêter attention à l'avance. Si, dans une application vieille de dix ans, on a abandonné l'une des solutions ci-dessus en raison de son coût élevé d'implémentation et d'exploitation, alors maintenant, dans la nouvelle application, ou après une refactorisation, on peut créer un service qui sera déjà extensible sur le plan architectural (en termes de performance) et prêt pour les nouvelles demandes des clients (par exemple, pour la localisation des données personnelles).
Et le plus important : ne utilisez pas ces approches, s'il vous plaît, si vous avez une application simple. Oui, elles sont belles et intéressantes, mais pour un site avec un pic de 100 visiteurs, on peut souvent se contenter d'un monolithe classique (du moins à l'extérieur, à l'intérieur tout peut être divisé en modules, etc.).
Source : habr.com
