

Note de traduction.: ce matériel vient d'un projet éducatif — une réponse à une question populaire lors de la conception d'infrastructure basée sur Kubernetes. Nous espérons que les descriptions détaillées des avantages et des inconvénients de chaque option aideront à faire le meilleur choix pour votre projet.
TL;DR: le même ensemble de charges de travail peut être exécuté sur plusieurs grands clusters (chaque cluster ayant un grand nombre de workloads) ou sur de nombreux petits (avec un petit nombre de charges dans chaque cluster).
Voici un tableau qui évalue les avantages et les inconvénients de chaque approche :
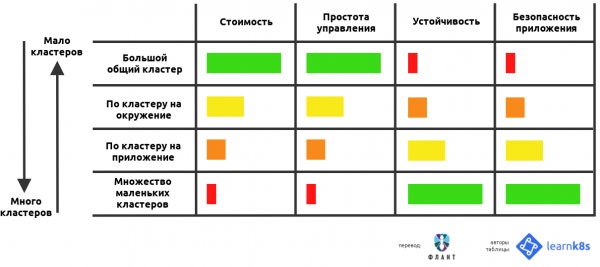
Lors de l'utilisation de Kubernetes comme plateforme pour l'exploitation des applications, quelques questions fondamentales se posent souvent concernant la configuration des clusters :
- Combien de clusters utiliser ?
- Quelle taille leur donner ?
- Que doit inclure chaque cluster ?
Dans cet article, je vais tenter de répondre à toutes ces questions en analysant les avantages et les inconvénients de chaque approche.
Énoncé du problème
En tant que créateur de logiciels, vous développez sûrement et exploitez simultanément de nombreuses applications.
De plus, de nombreux exemples de ces applications sont probablement lancés dans divers environnements — par exemple, cela peut inclure dev, test et prod.
Cela donne donc une matrice complète d'applications et d'environnements :
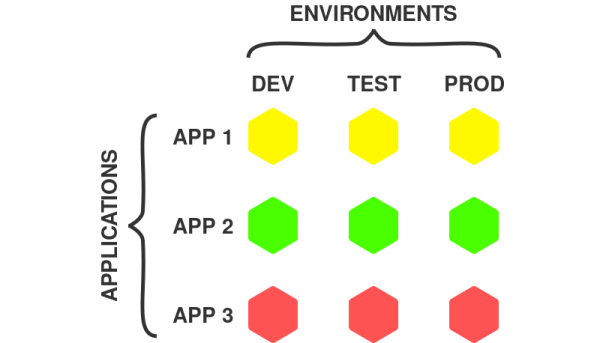
Applications et environnements
Dans l'exemple ci-dessus, 3 applications et 3 environnements sont présentés, ce qui donne au total 9 options possibles.
Chaque instance d'application représente une unité de déploiement autonome, qui peut être manipulée indépendamment des autres.
Veuillez noter que instance d'application peut être composée de plusieurs sont hébergés sur le service, telles que le frontend, le backend, la base de données, etc. Dans le cas d'une application microservices, l'instance inclura tous les microservices.
En conséquence, les utilisateurs de Kubernetes se posent plusieurs questions :
- Faut-il placer toutes les instances d'application dans un seul cluster ?
- Faut-il créer un cluster distinct pour chaque instance d'application ?
- Ou bien, peut-être, devrions-nous opter pour une combinaison des approches mentionnées ci-dessus ?
Toutes ces options sont tout à fait viables, car Kubernetes est un système flexible qui ne limite pas les possibilités de l'utilisateur.
Voici quelques-unes des voies possibles :
- un grand cluster commun;
- un grand nombre de petits clusters spécialisés;
- un cluster par application;
- un cluster par environnement.
Comme indiqué ci-dessous, les deux premières approches se situent aux extrémités opposées de l'échelle des options :
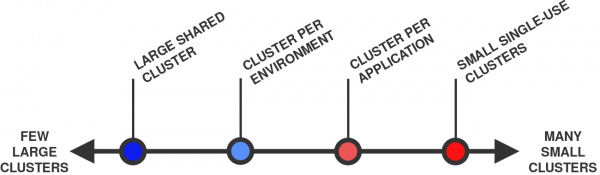
D'un côté, plusieurs grands clusters (à gauche) et de l'autre, de nombreux petits (à droite)
En général, on considère qu'un cluster est « plus grand » qu'un autre si la somme de ses nœuds et pods est supérieure. Par exemple, un cluster avec 10 nœuds et 100 pods est plus grand qu'un cluster avec 1 nœud et 10 pods.
Eh bien, commençons !
1. Un grand cluster partagé
La première option est de placer toutes les charges de travail dans un seul cluster :
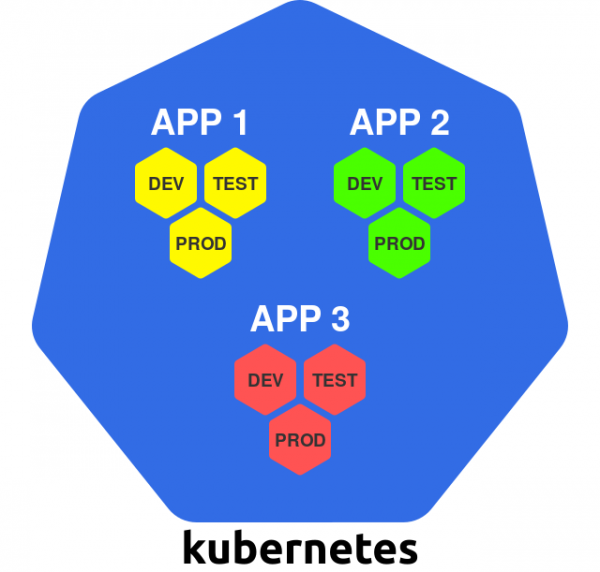
Un grand cluster
Dans ce cadre, le cluster est utilisé comme une plateforme d'infrastructure polyvalente — tout ce dont vous avez besoin est simplement déployé dans le cluster Kubernetes existant.
Kubernetes permet de séparer logiquement les parties du cluster les unes des autres, de sorte qu'un espace de noms distinct puisse être utilisé pour chaque instance d'application.
Examinons les avantages et les inconvénients de cette approche.
+ Utilisation efficace des ressources
Dans le cas d'un cluster unique, une seule copie de toutes les ressources nécessaires au fonctionnement et à la gestion du cluster Kubernetes sera requise.
Par exemple, cela est vrai pour les nœuds maîtres. En général, chaque cluster Kubernetes dispose de 3 nœuds maîtres, donc pour un seul cluster, leur nombre restera le même (en comparaison, 10 clusters nécessiteront 30 nœuds maîtres).
Cette subtilité s'applique également à d'autres services fonctionnant au niveau de l'ensemble du cluster, tels que les équilibreurs de charge, les contrôleurs Ingress, les systèmes d'authentification, de journalisation et de surveillance.
Dans un cluster unifié, tous ces services peuvent être utilisés simultanément pour toutes les charges de travail (pas besoin de créer des copies, comme dans le cas de plusieurs clusters).
+ Économie
En conséquence de ce qui précède, un nombre réduit de clusters coûte généralement moins cher, car il y a moins de dépenses liées aux ressources redondantes.
Cela est particulièrement vrai pour les nœuds maîtres, qui peuvent coûter cher, quelle que soit la solution d'hébergement (sur site ou dans le cloud).
Certains services Kubernetes gérés, tels que ou , fournissant une couche de gestion gratuitement. Dans ce cas, la question des coûts est moins pressante.
Il existe également des services gérés qui facturent un tarif fixe pour le fonctionnement de chaque cluster Kubernetes (par exemple, ).
+ Administration efficace
Gérer un seul cluster est plus facile que plusieurs.
L'administration peut inclure les tâches suivantes :
- mise à jour de la version de Kubernetes ;
- configuration du pipeline CI/CD ;
- installation du plugin CNI ;
- configuration du système d'authentification des utilisateurs ;
- installation du contrôleur d'accès ;
et bien d'autres…
Dans le cas d'un seul cluster, vous n'aurez à le faire qu'une seule fois.
Pour plusieurs clusters, les opérations devront être répétées plusieurs fois, ce qui nécessitera probablement une certaine automatisation des processus et des outils pour assurer la cohérence et l'uniformité des opérations.
Maintenant, quelques mots sur les inconvénients.
− Point de défaillance unique
En cas de défaillance du seul cluster, toutes les tout charges de travail cesseront de fonctionner !
Il existe de nombreuses situations où quelque chose peut mal tourner :
- la mise à jour de Kubernetes entraîne des effets secondaires inattendus ;
- un composant faisant partie du cluster (comme le plugin CNI) ne fonctionne pas comme prévu ;
- un des composants du cluster est mal configuré ;
- une défaillance dans l'infrastructure sous-jacente.
Un tel incident peut causer de graves dommages à toutes les charges de travail hébergées dans le cluster partagé.
− Absence d'isolement strict
Travailler dans un cluster partagé signifie que les applications partagent les ressources matérielles, les capacités réseau et le système d'exploitation sur les nœuds du cluster.
En un sens, deux conteneurs avec deux applications différentes fonctionnant sur le même nœud ressemblent à deux processus exécutés sur la même machine sous un même noyau OS.
Les conteneurs Linux offrent une certaine forme d'isolement, mais cela n'est pas aussi robuste que ce que fourniraient, disons, des machines virtuelles. En essence, le processus dans un conteneur est le même que le processus exécuté dans le système d'exploitation hôte.
Cela peut poser des problèmes de sécurité : une telle organisation permet théoriquement à des applications non liées d'interagir entre elles (intentionnellement ou accidentellement).
De plus, toutes les charges de travail dans le cluster Kubernetes partagent certaines ressources de cluster communes, telles que — cela permet aux applications de trouver les Services d'autres applications dans le cluster.
Tous les points mentionnés ci-dessus peuvent avoir des significations différentes selon les exigences de sécurité des applications.
Kubernetes fournit divers outils pour prévenir les problèmes de sécurité, tels que et . Cependant, une configuration correcte nécessite une certaine expérience et, de plus, ils ne peuvent pas combler complètement toutes les failles de sécurité.
Il est toujours important de garder à l'esprit que Kubernetes a été initialement conçu pour un partage, pas pour l'isolement et la sécurité.
− Absence de multi-tenancy stricte
Étant donné l'abondance de ressources communes dans le cluster Kubernetes, il existe de nombreuses façons pour différentes applications de se « marcher sur les pieds ».
Par exemple, une application peut monopoliser une ressource commune (comme un processeur ou de la mémoire) et priver d'autres applications fonctionnant sur le même nœud de l'accès à celle-ci.
Kubernetes fournit divers mécanismes pour contrôler ce comportement, tels que ((voir aussi l'article «» — note du trad.), et . Cependant, comme en matière de sécurité, leur configuration est assez complexe et ne peut pas prévenir complètement tous les effets secondaires imprévus.
− Un grand nombre d'utilisateurs
Dans le cas d'un seul cluster, il faut y donner accès à de nombreuses personnes. Plus leur nombre est important, plus le risque qu'ils « cassent » quelque chose est élevé.
À l'intérieur du cluster, il est possible de contrôler qui peut faire quoi à l'aide de ((voir l'article «» — note du trad.). Cependant, cela n'empêche pas les utilisateurs de « casser » quelque chose dans les limites de leur zone de responsabilité.
− Les clusters ne peuvent pas croître indéfiniment
Un cluster qui sert toutes les charges de travail sera probablement assez grand (en termes de nœuds et de pods).
Mais cela soulève un autre problème : les clusters dans Kubernetes ne peuvent pas croître indéfiniment.
Il existe une limite théorique à la taille du cluster. Dans Kubernetes, elle est d'environ .
Cependant, dans la vie réelle, les problèmes peuvent commencer beaucoup plus tôt — par exemple, dès .
Le fait est que de grands clusters exercent une forte pression sur la couche de gestion de Kubernetes. En d'autres termes, pour maintenir le cluster opérationnel et utiliser efficacement les ressources, une configuration minutieuse est nécessaire.
Ce problème est abordé dans l'article correspondant dans le blog original intitulé «».
Mais examinons l'approche opposée : de nombreux petits clusters.
2. De nombreux petits clusters spécialisés
Dans cette approche, vous utilisez un cluster distinct pour chaque élément déployé :
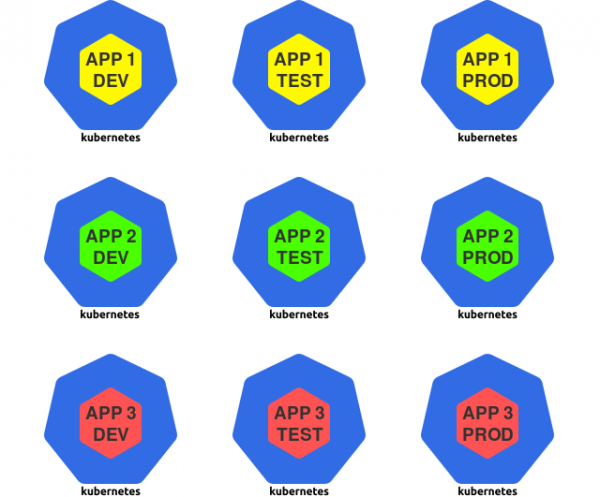
De nombreux petits clusters
Aux fins de cet article, un élément déployé est considéré comme une instance d'application — par exemple, la version de développement d'une application distincte.
Dans cette stratégie, Kubernetes est utilisé comme un environnement d'exécution spécialisé pour des instances d'application individuelles.
Examinons les avantages et les inconvénients de cette approche.
+ Rayon d'impact limité
En cas de "panne" d'un cluster, les conséquences négatives se limitent uniquement aux charges de travail qui ont été déployées dans ce cluster. Toutes les autres charges de travail restent intactes.
+ Isolement
Les charges de travail hébergées dans des clusters individuels ne partagent pas de ressources communes, telles que le processeur, la mémoire, le système d'exploitation, le réseau ou d'autres services.
Nous obtenons ainsi un isolement strict entre les applications non liées, ce qui peut avoir un impact positif sur leur sécurité.
+ Peu d'utilisateurs
Étant donné que chaque cluster ne contient qu'un ensemble limité de charges de travail, le nombre d'utilisateurs ayant accès à celui-ci est réduit.
Moins il y a de personnes ayant accès au cluster, moins le risque que quelque chose "se casse" est élevé.
Voyons les inconvénients.
− Utilisation inefficace des ressources
Comme mentionné précédemment, chaque cluster Kubernetes nécessite un certain ensemble de ressources de gestion : nœuds maîtres, composants de la couche de contrôle, solutions de surveillance et de journalisation.
Avec un grand nombre de petits clusters, il faut allouer une plus grande proportion de ressources pour leur gestion.
− Coût élevé
Une utilisation inefficace des ressources entraîne automatiquement des coûts élevés.
Par exemple, avoir 30 nœuds principaux au lieu de trois avec la même puissance de calcul impactera certainement les coûts.
− Difficultés d'administration
Administrer plusieurs clusters Kubernetes est beaucoup plus compliqué que de travailler avec un seul.
Par exemple, il faudra configurer l'authentification et l'autorisation pour chaque cluster. La mise à jour de la version de Kubernetes devra également se faire plusieurs fois.
Il est probable qu'il soit nécessaire d'appliquer l'automatisation pour améliorer l'efficacité de toutes ces tâches.
Examinons maintenant des scénarios moins extrêmes.
3. Un cluster pour chaque application
Dans cette approche, vous créez un cluster distinct pour toutes les instances d'une application spécifique :
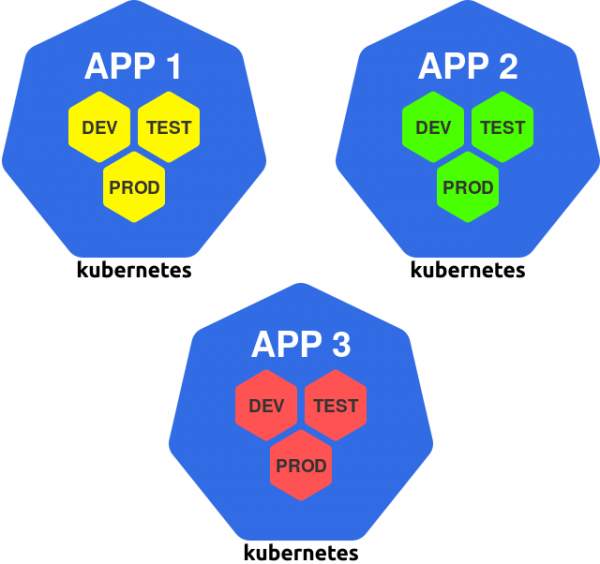
Un cluster par application
Cette voie peut être considérée comme une généralisation du principe «un cluster par équipe», puisque généralement une équipe d'ingénieurs travaille sur le développement d'une ou plusieurs applications.
Examinons les avantages et les inconvénients de cette approche.
+ Le cluster peut être adapté à l'application
Si l'application a des besoins spécifiques, ceux-ci peuvent être satisfaits dans le cluster, sans affecter les autres clusters.
Ces besoins peuvent inclure des workers avec GPU, des plugins CNI spécifiques, un service mesh ou tout autre service.
Chaque cluster peut être configuré selon l'application qu'il héberge, de manière à ne contenir que ce qui est nécessaire.
− Différentes environnements dans un même cluster
L'inconvénient de cette approche est que les instances d'applications de différents environnements coexistent dans un même cluster.
Par exemple, la version prod de l'application fonctionne dans le même cluster que la version dev. Cela signifie également que les développeurs opèrent dans le même cluster que la version production de l'application.
Si en raison des actions des développeurs ou des bugs de la version dev, un échec se produit dans le cluster, la version prod peut également être affectée — un énorme inconvénient de cette approche.
Et enfin, le dernier scénario de notre liste.
4. Un cluster pour chaque environnement
Ce scénario prévoit la création d'un cluster distinct pour chaque environnement :
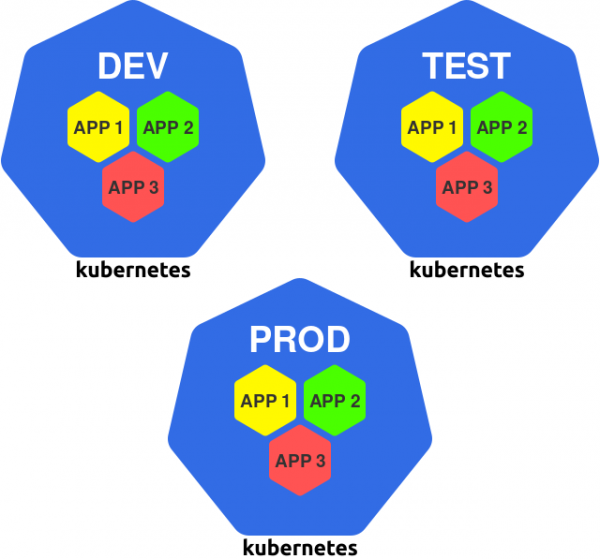
Un cluster par environnement
Par exemple, vous pourriez avoir des clusters dev, test et prod, dans lesquels vous exécuterez toutes les instances d'application destinées à un environnement particulier.
Voici les avantages et les inconvénients de cette approche.
+ Isolation de l'environnement prod
Dans le cadre de cette approche, tous les environnements sont isolés les uns des autres. Cependant, cela est particulièrement important pour l'environnement de production.
Les versions de production de l'application ne dépendent plus de ce qui se passe dans d'autres clusters et environnements.
Ainsi, si un problème survient soudainement dans le cluster de développement, les versions de production des applications continueront de fonctionner comme si de rien n'était.
+ Le cluster peut être adapté à l'environnement
Chaque cluster peut être adapté à son environnement. Par exemple, il est possible de :
- installer des outils de développement et de débogage dans le cluster de développement ;
- installer des frameworks de test et des outils dans le cluster test;
- utiliser du matériel plus puissant et des canaux réseau dans le cluster prod.
Cela permet d'améliorer l'efficacité tant du développement que de l'exploitation des applications.
+ Limitation de l'accès au cluster de production
La nécessité de travailler directement avec le cluster de production se présente rarement, il est donc possible de limiter considérablement le nombre de personnes y ayant accès.
On peut aller encore plus loin et priver complètement les gens de l'accès à ce cluster, en effectuant tous les déploiements à l'aide d'un outil CI/CD automatisé. Cette approche permettra de réduire au maximum le risque d'erreurs humaines précisément là où cela est le plus crucial.
Maintenant, quelques mots sur les inconvénients.
− Absence d'isolement entre les applications
Le principal inconvénient de cette approche est l'absence d'isolement matériel et de ressources entre les applications.
Les applications non liées utilisent conjointement les ressources du cluster : le noyau système, le processeur, la mémoire et certains autres services.
Comme déjà mentionné, cela peut être potentiellement dangereux.
− Incapacité à localiser les dépendances des applications
Si une application a des exigences particulières, elles doivent être satisfaites dans tous les clusters.
Par exemple, si une application nécessite un GPU, chaque cluster doit contenir au moins un worker avec GPU (même s'il n'est utilisé que par cette application).
En conséquence, nous risquons d'avoir des coûts plus élevés et une utilisation inefficace des ressources.
Conclusion
Avec un certain ensemble d'applications, elles peuvent être réparties dans plusieurs grands clusters ou dans de nombreux petits.
Cet article examine les avantages et les inconvénients de différentes approches, allant d'un cluster global unique à plusieurs petits clusters spécialisés :
- un grand cluster commun;
- un grand nombre de petits clusters spécialisés;
- un cluster par application;
- un cluster par environnement.
Alors, quelle approche choisir ?
Comme d'habitude, la réponse dépend du scénario d'utilisation : il faut peser le pour et le contre des différentes approches et choisir l'option la plus optimale.
Cependant, le choix ne se limite pas aux exemples ci-dessus — il est possible d'utiliser n'importe quelle combinaison !
Par exemple, on peut organiser une paire de clusters pour chaque équipe : un cluster pour le développement (dans lequel se trouveront les environnements dev et test) et un cluster pour production (où sera située l'environnement de production).
En vous basant sur les informations de cet article, vous pourrez optimiser les avantages et les inconvénients pour un scénario spécifique. Bonne chance !
P.S.
Lisez aussi dans notre blog :
- «»;
- «»;
- «»;
- «».
Source : habr.com
