

Bonjour à tous. Nous développons un produit pour l'analyse du trafic hors ligne. Dans ce projet, il y a une tâche liée à l'analyse statistique des parcours des visiteurs à travers les zones.
Dans le cadre de cette tâche, les utilisateurs peuvent soumettre des requêtes au système de ce type :
- combien de visiteurs sont passés de la zone "A" à la zone "B" ;
- combien de visiteurs sont passés de la zone "A" à la zone "B" en passant par la zone "C", puis par la zone "D" ;
- combien de temps a mis un visiteur de type particulier pour aller de la zone "A" à la zone "B".
et un certain nombre d'autres requêtes analytiques similaires.
Le mouvement des visiteurs à travers les zones représente un graphe orienté. En lisant sur Internet, j'ai découvert que les bases de données graphiques sont également utilisées pour des rapports analytiques. J'ai eu envie de voir comment ces bases de données graphiques géreront de telles requêtes (TL;DR; mauvais).
J'ai choisi d'utiliser la base de données , en tant que représentant exceptionnel des bases de données graphiques open-source, qui repose sur un ensemble de technologies mûres, qui, selon moi, devraient lui assurer des performances opérationnelles décentes :
- backend de stockage BerkeleyDB, Apache Cassandra, Scylla ;
- des index complexes peuvent être stockés dans Lucene, Elasticsearch, Solr.
Les auteurs de JanusGraph affirment qu'elle convient tant pour l'OLTP que pour l'OLAP.
J'ai travaillé avec BerkeleyDB, Apache Cassandra, Scylla et ES, de plus, ces produits sont souvent utilisés dans nos systèmes, donc j'avais des espoirs quant aux tests de cette base de données graphique. J'ai trouvé étrange le choix de BerkeleyDB plutôt que RocksDB, mais cela doit probablement être lié aux exigences concernant les transactions. Dans tous les cas, pour une utilisation produit évolutive, il est conseillé d'utiliser un backend sur Cassandra ou Scylla.
Je n'ai pas considéré Neo4j, car la version commerciale est nécessaire pour le clustering, c'est-à-dire que le produit n'est pas open-source.
Les bases de données graphiques disent : "Si quelque chose ressemble à un graphe, traitez-le comme un graphe !" — magnifique !
D'abord, j'ai dessiné un graphe qui est fait selon les canons des bases de données graphiques :
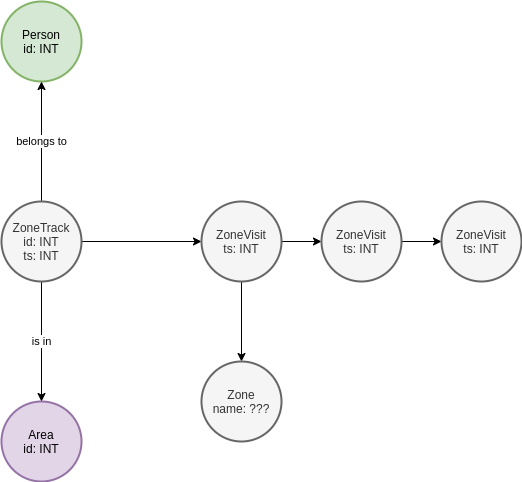
Il y a une entité Zone, qui est responsable de la zone. Si ZoneStep appartient à celle-ci, alors il y fait référence. Pour l'entité ZoneArea ZoneTrack, ne faites pas attention, elles appartiennent au domaine et ne sont pas considérées dans le cadre du test. En somme, pour cette structure graphique, une requête pour rechercher des chaînes ressemblerait à :, Person Attention, do not pay attention to them, they belong to the domain and are not considered within the framework of the test. Therefore, a search query for such a graph structure would look like this:
g.V().hasLabel('Zone').has('id',0).in_()
       .repeat(__.out()).until(__.out().hasLabel('Zone').has('id',19)).count().next()
En français, cela ressemble à : trouve la Zone avec l'ID=0, prends tous les sommets d'où part une arête (ZoneStep), avance sans revenir en arrière jusqu'à ce que tu trouves des ZoneStep d'où part une arête vers la Zone avec l'ID=19, compte le nombre de telles chaînes.
Je ne prétends pas connaître toutes les subtilités de la recherche sur les graphes, mais cette requête a été générée sur la base de ce livre ().
J'ai chargé 50 000 morceaux de musique d'une longueur de 3 à 20 points dans la base de données graphique JanusGraph, utilisant le backend BerkeleyDB, et j'ai créé des index selon .
Script de chargement en Python :
from random import random
from time import time

from init import g, graph

if __name__ == '__main__':

    points = []
    max_zones = 19
    zcache = dict()
    for i in range(0, max_zones + 1):
        zcache[i] = g.addV('Zone').property('id', i).next()

    startZ = zcache[0]
    endZ = zcache[max_zones]

    for i in range(0, 10000):

        if not i % 100:
            print(i)

        start = g.addV('ZoneStep').property('time', int(time())).next()
        g.V(start).addE('belongs').to(startZ).iterate()

        while True:
            pt = g.addV('ZoneStep').property('time', int(time())).next()
            end_chain = random()
            if end_chain < 0.3:
                g.V(pt).addE('belongs').to(endZ).iterate()
                g.V(start).addE('goes').to(pt).iterate()
                break
            else:
                zone_id = int(random() * max_zones)
                g.V(pt).addE('belongs').to(zcache[zone_id]).iterate()
                g.V(start).addE('goes').to(pt).iterate()

            start = pt

    count = g.V().count().next()
    print(count)
J'ai utilisé une VM avec 4 cœurs et 16 Go de RAM sur SSD. JanusGraph a été déployé avec la commande suivante :
docker run --name janusgraph -p8182:8182 janusgraph/janusgraph:latestDans ce cas, les données et les index utilisés pour la recherche de correspondance exacte sont stockés dans BerkeleyDB. En exécutant la requête précédente, j'ai obtenu un temps équivalent à plusieurs dizaines de secondes.
Après avoir lancé les 4 scripts susmentionnés en parallèle, j'ai réussi à transformer la base de données en une citrouille avec un joyeux flot de traces de pile Java (et nous aimons tous lire des traces de pile Java) dans les logs Docker.
Après réflexion, j'ai décidé de simplifier le schéma du graphe comme suit :
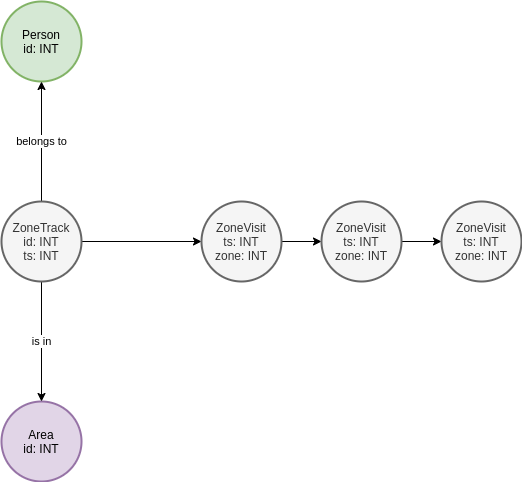
En décidant que la recherche par attributs d'entité serait plus rapide que par arêtes. Au final, ma requête est devenue la suivante :
g.V().hasLabel('ZoneStep').has('id',0).repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',19)).count().next()En français, cela ressemble à : trouve ZoneStep avec l'ID=0, avance sans revenir en arrière jusqu'à ce que tu trouves ZoneStep avec l'ID=19, compte le nombre de telles chaînes.
J'ai aussi simplifié le script de chargement ci-dessus, afin de ne pas créer de liens superflus, en me limitant aux attributs.
La requête était encore en cours d'exécution pendant plusieurs secondes, ce qui était absolument inacceptable pour notre tâche, car pour les requêtes AdHoc de type aléatoire, cela ne convenait pas du tout.
J'ai essayé de déployer JanusGraph en utilisant Scylla, qui est la mise en œuvre la plus rapide de Cassandra, mais cela n'a également pas entraîné de changements significatifs dans les performances.
Ainsi, malgré le fait que "cela ressemble à un graph", je n'ai pas réussi à faire traiter cela rapidement par la base de données graph. Je suppose que je ne sais pas quelque chose et qu'il est possible de faire en sorte que JanusGraph exécute cette recherche en une fraction de seconde, mais je n'y suis pas parvenu.
Comme il fallait quand même résoudre la tâche, j'ai commencé à penser aux JOIN et aux tableaux croisés, ce qui n'inspirait pas beaucoup d'optimisme en termes d'élégance, mais pouvait être une option tout à fait viable en pratique.
Dans notre projet, nous utilisons déjà Apache ClickHouse, j'ai donc décidé de vérifier mes recherches sur cette base de données analytique.
J'ai déployé ClickHouse selon une recette simple :
sudo docker run -d --name clickhouse_1
     --ulimit nofile=262144:262144
     -v /opt/clickhouse/log:/var/log/clickhouse-server
     -v /opt/clickhouse/data:/var/lib/clickhouse
     yandex/clickhouse-server
J'ai créé une base de données et une table de type :
CREATE TABLE
db.steps (`area` Int64, `when` DateTime64(1, 'Europe/Moscow') DEFAULT now64(), `zone` Int64, `person` Int64)
ENGINE = MergeTree() ORDER BY (area, zone, person) SETTINGS index_granularity = 8192
Je l'ai remplie avec les données suivantes :
from time import time

from clickhouse_driver import Client
from random import random

client = Client('vm-12c2c34c-df68-4a98-b1e5-a4d1cef1acff.domain',
                database='db',
                password='secret')

max = 20

for r in range(0, 100000):

    if r % 1000 == 0:
        print("CNT: {}, TS: {}".format(r, time()))

    data = [{
            'area': 0,
            'zone': 0,
            'person': r
        }]

    while True:
        if random() < 0.3:
            break

        data.append({
                'area': 0,
                'zone': int(random() * (max - 2)) + 1,
                'person': r
            })

    data.append({
            'area': 0,
            'zone': max - 1,
            'person': r
        })

    client.execute(
        'INSERT INTO steps (area, zone, person) VALUES',
        data
    )
Étant donné que les insertions se font par lots, le remplissage était beaucoup plus rapide que pour JanusGraph.
J'ai construit deux requêtes avec JOIN. Pour passer du point A au point B :
SELECT s1.person AS person,
       s1.zone,
       s1.when,
       s2.zone,
       s2.when
FROM
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 0)) AS s1 ANY INNER JOIN
  (SELECT *
   FROM steps AS s2
   WHERE (area = 0)
     AND (zone = 19)) AS s2 USING person
WHERE s1.when <= s2.when
Pour passer par 3 points :
SÉLECTIONNER s3.person,
       s1z,
       s1w,
       s2z,
       s2w,
       s3.zone,
       s3.when
DE
  (SÉLECTIONNER s1.person AS person,
          s1.zone AS s1z,
          s1.when AS s1w,
          s2.zone AS s2z,
          s2.when AS s2w
   DE
     (SÉLECTIONNER *
      DE steps
      OÙ (area = 0)
        ET (zone = 0)) AS s1 ANY INNER JOIN
     (SÉLECTIONNER *
      DE steps AS s2
      OÙ (area = 0)
        ET (zone = 3)) AS s2 EN UTILISANT person
   OÙ s1.when <= s2.when) p ANY INNER JOIN
  (SÉLECTIONNER *
   DE steps
   OÙ (area = 0)
     ET (zone = 19)) AS s3 EN UTILISANT person
OÙ p.s2w <= s3.when
Les requêtes semblent en effet plutôt effrayantes, pour une utilisation réelle, il est nécessaire de créer une couche de programmation génératrice. Cependant, elles fonctionnent et le font rapidement. Les deux premières requêtes s'exécutent en moins de 0,1 seconde. Voici un exemple du temps d'exécution d'une requête pour count(*) à travers 3 points :
SÉLECTIONNER count(*)
DE
(
    SÉLECTIONNER
        s1.person AS person,
        s1.zone AS s1z,
        s1.when AS s1w,
        s2.zone AS s2z,
        s2.when AS s2w
    DE
    (
        SÉLECTIONNER *
        DE steps
        OÙ (area = 0) ET (zone = 0)
    ) AS s1
    ANY INNER JOIN
    (
        SÉLECTIONNER *
        DE steps AS s2
        OÙ (area = 0) ET (zone = 3)
    ) AS s2 EN UTILISANT (person)
    OÙ s1.when <= s2.when
) AS p
ANY INNER JOIN
(
    SÉLECTIONNER *
    DE steps
    OÙ (area = 0) ET (zone = 19)
) AS s3 EN UTILISANT (person)
OÙ p.s2w <= s3.when

┌─count()─┐
│   11592 │
└─────────┘
1 ligne dans le set. Temps écoulé : 0,068 sec. Traitement de 250,03 mille lignes, 8,00 Mo (3,69 millions de lignes/s., 117,98 Mo/s.)Remarque sur les IOPS. Lors de la saisie des données, JanusGraph a généré un nombre assez élevé d'IOPS (1000-1300 pour quatre flux de saisie de données), et l'IOWAIT était assez élevé. En même temps, ClickHouse a généré une charge minimale sur le sous-système de disque.
Conclusion
Nous avons décidé d'utiliser ClickHouse pour traiter ce type de requêtes. Nous pouvons toujours optimiser davantage les requêtes en utilisant des vues matérialisées et la parallélisation, en effectuant un prétraitement du flux d'événements avec Apache Flink avant de les charger dans ClickHouse.
Les performances sont si bonnes que nous n'aurons probablement même pas besoin de penser aux pivots de tableaux par des moyens programmatiques. Auparavant, nous devions créer des pivots des données extraites de Vertica par le biais d'un export vers Apache Parquet.
Malheureusement, une nouvelle tentative d'utilisation d'une base de données graphique n'a pas été couronnée de succès. Je n'ai pas trouvé que JanusGraph avait un écosystème convivial qui permet d'apprendre rapidement à maîtriser le produit. De plus, la configuration du serveur suit la méthode Java traditionnelle, ce qui fera pleurer à chaudes larmes ceux qui ne sont pas familiers avec Java :
hôte: 0.0.0.0
port: 8182
threadPoolWorker: 1
gremlinPool: 8
scriptEvaluationTimeout: 30000
channelizer: org.janusgraph.channelizers.JanusGraphWsAndHttpChannelizer

graphManager: org.janusgraph.graphdb.management.JanusGraphManager
graphs: {
  ConfigurationManagementGraph: conf/janusgraph-cql-configurationgraph.properties,
  airlines: conf/airlines.properties
}

scriptEngines: {
  gremlin-groovy: {
    plugins: { org.janusgraph.graphdb.tinkerpop.plugin.JanusGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.server.jsr223.GremlinServerGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.tinkergraph.jsr223.TinkerGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.jsr223.ImportGremlinPlugin: {classImports: [java.lang.Math], methodImports: [java.lang.Math#*]},
               org.apache.tinkerpop.gremlin.jsr223.ScriptFileGremlinPlugin: {files: [scripts/airline-sample.groovy]}}}}

serializers:
# GraphBinary est ici pour remplacer Gryo et Graphson
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { serializeResultToString: true }}
  # Gryo et Graphson, dernières versions
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  # anciennes versions de sérialisation pour compatibilité ascendante:
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoLiteMessageSerializerV1d0, config: {ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV2d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}

processors:
  - { className: org.apache.tinkerpop.gremlin.server.op.session.SessionOpProcessor, config: { sessionTimeout: 28800000 }}
  - { className: org.apache.tinkerpop.gremlin.server.op.traversal.TraversalOpProcessor, config: { cacheExpirationTime: 600000, cacheMaxSize: 1000 }}

metrics: {
  consoleReporter: {enabled: false, interval: 180000},
  csvReporter: {enabled: false, interval: 180000, fileName: /tmp/gremlin-server-metrics.csv},
  jmxReporter: {enabled: false},
  slf4jReporter: {enabled: true, interval: 180000},
  gangliaReporter: {enabled: false, interval: 180000, addressingMode: MULTICAST},
  graphiteReporter: {enabled: false, interval: 180000}}
threadPoolBoss: 1
maxInitialLineLength: 4096
maxHeaderSize: 8192
maxChunkSize: 8192
maxContentLength: 65536
maxAccumulationBufferComponents: 1024
resultIterationBatchSize: 64
writeBufferHighWaterMark: 32768
writeBufferHighWaterMark: 65536
ssl: {
  enabled: false}
J'ai réussi par hasard à "installer" BerkeleyDB version JanusGraph.
La documentation est assez tordue en ce qui concerne les index, car la gestion des index nécessite des manipulations plutôt étranges en Groovy. Par exemple, la création d'un index doit se faire en écrivant du code dans la console Gremlin (qui, soit dit en passant, ne fonctionne pas par défaut). Extrait de la documentation officielle de JanusGraph :
graph.tx().rollback()
// Ne jamais créer de nouveaux index tant qu'une transaction est active
mgmt = graph.openManagement()
name = mgmt.getPropertyKey('name')
age = mgmt.getPropertyKey('age')
mgmt.buildIndex('byNameComposite', Vertex.class).addKey(name).buildCompositeIndex()
mgmt.buildIndex('byNameAndAgeComposite', Vertex.class).addKey(name).addKey(age).buildCompositeIndex()
mgmt.commit()

// Attendre que l'index soit disponible
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameComposite').call()
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameAndAgeComposite').call()
// Réindexer les données existantes
mgmt = graph.openManagement()
mgmt.updateIndex(mgmt.getGraphIndex("byNameComposite"), SchemaAction.REINDEX).get()
mgmt.updateIndex(mgmt.getGraphIndex("byNameAndAgeComposite"), SchemaAction.REINDEX).get()
mgmt.commit()
Postface
En un sens, l'expérience ci-dessus est une comparaison entre des éléments peu comparables. Si l'on y réfléchit, une base de données orientée graphes effectue d'autres opérations pour obtenir les mêmes résultats. Cependant, dans le cadre des tests, j'ai également effectué une expérience avec une requête du type :
g.V().hasLabel('ZoneStep').has('id',0)
    .repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',1)).count().next()
qui reflète l'accessibilité étape par étape. Cependant, même avec de telles données, la base de données orientée graphes affichait des résultats qui dépassaient plusieurs secondes... Cela est bien sûr lié au fait qu'il y avait des chemins tels que 0 -> X -> Y ... -> 1, qui étaient également vérifiés par le moteur de graphes.
Même pour une requête du type :
g.V().hasLabel('ZoneStep').has('id',0).out().has('id',1)).count().next()je n'ai pas réussi à obtenir une réponse satisfaisante avec un temps de traitement inférieur à une seconde.
La morale de l'histoire est que la belle idée et la modélisation paradigmatique ne conduisent pas au résultat escompté, qui est démontré avec une efficacité significativement plus élevée dans le cas de ClickHouse. L'exemple d'utilisation donné dans cet article est un antipatron évident pour les bases de données orientées graphes, même s'il semble adapté à leur paradigme de modélisation.
Source : habr.com
