

Je vais d'abord expliquer le titre de l'article. À l'origine, il était prévu de donner un bon conseil fiable pour accélérer l'utilisation de la réflexion sur un exemple simple mais réaliste. Cependant, lors du benchmarking, il s'est avéré que la réflexion ne fonctionne pas aussi lentement que je le pensais, tandis que LINQ est en réalité plus lent que dans mes pires cauchemars. De plus, je me suis rendu compte que j'avais également commis une erreur dans mes mesures... Les détails de cette histoire de vie se trouvent ci-dessous et dans les commentaires. Comme l'exemple est assez simple et mis en œuvre de la manière dont cela se fait généralement dans une entreprise, cela a donné lieu à une démonstration de vie qui me semble assez intéressante : l'influence sur la vitesse de travail du sujet principal de l'article était imperceptible en raison de la logique externe : Moq, Autofac, EF Core et autres « dépendances ».
J'ai commencé mon travail sous l'influence de cet article :
Comme on peut le voir, l'auteur propose d'utiliser des délégués compilés au lieu d'appeler directement les méthodes des types de réflexion comme un excellent moyen d'accélérer considérablement le fonctionnement de l'application. Il y a aussi, bien sûr, l'émission IL, mais je souhaiterais l'éviter car c'est la méthode la plus coûteuse en termes d'efforts pour accomplir la tâche, qui comporte des risques d'erreurs.
Étant donné que j'ai toujours eu une opinion similaire sur la vitesse de la réflexion, je n'avais pas l'intention de remettre en question les conclusions de l'auteur.
Je rencontre souvent l'utilisation naïve de la réflexion dans l'entreprise. On prend le type. On obtient des informations sur la propriété. On appelle la méthode SetValue, et tout le monde est content. La valeur arrive dans le champ cible, et tout le monde est satisfait. Les gens ne sont pas idiots — les seniors et les leads — écrivent leurs propres extensions sur object, en se basant sur une telle mise en œuvre naïve de mappers « universels » d'un type à un autre. En général, le principe est le suivant : on prend tous les champs, on prend toutes les propriétés, on les itère : en cas de correspondance des noms des membres de type, on exécute SetValue. On attrape périodiquement des exceptions lorsque l'on échoue à trouver une propriété sur l'un des types, mais même ici, il existe une solution qui améliore la performance. Try/catch.
J'ai vu des gens réinventer des parseurs et des mappeurs sans être complètement armés d'informations sur le fonctionnement des vélos inventés avant eux. J'ai vu des gens cacher leurs mises en œuvre naïves derrière des stratégies, des interfaces, des injections, comme si cela excusait la bacchanale qui suivait. J'avais le nez en l'air face à de telles réalisations. En fait, je n'ai jamais mesuré la véritable fuite de performance, et lorsque c'était possible, je changeais simplement l'implémentation pour une version plus « optimale », si je pouvais le faire. C'est pourquoi les premières mesures dont il est question ci-dessous m'ont sérieusement dérouté.
Je pense que beaucoup d'entre vous, en lisant Richter ou d'autres idéologues, ont rencontré l'affirmation plutôt juste selon laquelle la réflexion dans le code est un phénomène qui affecte extrêmement négativement les performances de l'application.
L'appel à la réflexion oblige le CLR à parcourir les assemblies à la recherche de ce qu'il faut, à charger leurs métadonnées, à les parser, etc. De plus, la réflexion lors du parcours de séquences entraîne l'allocation d'une grande quantité de mémoire. Nous consommons de la mémoire, le CLR déploie le GC et les freezes commencent. Cela doit être remarquablement lent, croyez-moi. Les énormes volumes de mémoire des serveurs de production modernes ou des machines cloud ne protègent pas contre les délais élevés de traitement. En fait, plus il y a de mémoire, plus il est probable que vous remarquiez comment le GC fonctionne. La réflexion est, en théorie, un inutile chiffon rouge pour cela.
Cependant, nous utilisons tous des conteneurs IoC et des mappeurs de données, dont le fonctionnement est également basé sur la réflexion, mais il y a généralement peu de questions sur leurs performances. Non, pas parce que l'injection de dépendances et l'abstraction des modèles d'un contexte externe limité sont des choses si nécessaires que nous devons sacrifier la performance dans tous les cas. C'est plus simple - cela n'affecte vraiment pas beaucoup les performances.
Le fait est que les frameworks les plus courants, qui reposent sur la technologie de réflexion, utilisent toutes sortes d'astuces pour fonctionner de manière plus optimale avec elle. En général, c'est du cache. En général, ce sont des expressions et des délégués compilés à partir d'un arbre d'expressions. L'automapper lui-même maintient un dictionnaire concurrent qui associe des types à des fonctions qui peuvent se convertir les uns dans les autres sans appeler la réflexion.
Comment cela est-il accompli ? En substance, cela ne diffère pas de la logique utilisée par la plateforme elle-même pour générer du code JIT. Lors du premier appel de la méthode, celle-ci est compilée (et oui, ce processus n'est pas rapide), lors des appels suivants, le contrôle est donné à la méthode déjà compilée, et ici il n'y aura pas de chute de performance particulière.
Dans notre cas, nous pouvons également utiliser la compilation JIT et ensuite utiliser le comportement compilé avec les mêmes performances que ses analogues AOT. Les expressions nous aideront dans ce cas.
On peut résumer le principe en question de la manière suivante :
Il est conseillé de mettre en cache le résultat final du travail de la réflexion sous la forme d'un délégué contenant la fonction compilée. Tous les objets nécessaires contenant des informations sur les types devraient également être mis en cache dans les champs de votre type – le worker.
Il y a une logique dans cela. Le bon sens nous dit que si quelque chose peut être compilé et mis en cache, il vaut mieux le faire.
Pour anticiper, il convient de dire que le cache dans le travail avec la réflexion a ses avantages, même sans utiliser la méthode de compilation d'expressions proposée. En fait, je vais simplement répéter les thèses de l'auteur de l'article auquel je fais référence ci-dessus.
Maintenant, parlons du code. Examinons un exemple basé sur ma récente douleur à laquelle j'ai dû faire face dans une production sérieuse d'une grande organisation de crédit. Tous les entités sont fictifs, afin que personne ne devine.
Il y a une certaine entité. Appelons-la Contact. Il y a des courriels avec un corps standardisé, à partir desquels le parser et le hydrator créent ces contacts. Un email est arrivé, nous l'avons lu, décomposé en paires clé-valeur, nous avons créé un contact et l'avons enregistré dans la base de données.
C'est élémentaire. Supposons qu'un contact ait des propriétés telles que Nom, Âge et numéro de téléphone. Ces données sont transmises dans l'email. De plus, l'entreprise souhaite que les supports puissent rapidement ajouter des clés pour mapper les propriétés des entités sur des paires dans le corps de l'email. Dans le cas où quelqu'un aurait fait une faute de frappe dans le modèle ou si, avant la sortie, il est nécessaire de lancer rapidement le mappage avec un nouveau partenaire tout en s'adaptant à un nouveau format. Nous pourrons alors ajouter cette nouvelle corrélation de mappage comme un correctif de données à faible coût. C'est-à-dire, un exemple de la vie réelle.
Nous réalisons et créons des tests. Ça fonctionne.
Je ne fournirai pas le code : il y a beaucoup de sources, et elles sont disponibles sur GitHub via le lien à la fin de l'article. Vous pouvez les télécharger, les malmener au point de ne pas les reconnaître et mesurer comment cela agirait dans votre cas. Je fournirai seulement le code de deux méthodes template, qui distinguent le hydrateur qui devait être rapide de celui qui devait être lent.
La logique est la suivante : la méthode template reçoit des paires formées par la logique de base du parseur. Le niveau LINQ sert de parseur et de logique de base pour le hydrateur, établissant une requête au contexte de la base de données et faisant correspondre les clés avec les paires du parseur (pour ces fonctions, il y a du code sans LINQ pour comparaison). Ensuite, les paires sont transmises à la méthode principale d'hydratation et les valeurs des paires sont définies dans les propriétés correspondantes de l'entité.
«Rapide» (Préfixe Fast dans les benchmarks) :
 protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var setterMapItem in _proprtySettersMap)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == setterMapItem.Key);
                setterMapItem.Value(contact, correlation?.Value);
            }
            return contact;
        }
Comme nous le voyons, une collection statique de setters de propriétés est utilisée – des lambdas compilées qui appellent le setter de l'entité. Elles sont créées par le code suivant :
        static FastContactHydrator()
        {
            var type = typeof(Contact);
            foreach (var property in type.GetProperties())
            {
                _proprtySettersMap[property.Name] = GetSetterAction(property);
            }
        }

        private static Action GetSetterAction(PropertyInfo property)
        {
            var setterInfo = property.GetSetMethod();
            var paramValueOriginal = Expression.Parameter(property.PropertyType, "value");
            var paramEntity = Expression.Parameter(typeof(Contact), "entity");
            var setterExp = Expression.Call(paramEntity, setterInfo, paramValueOriginal).Reduce();

            var lambda = (Expression<Action>)Expression.Lambda(setterExp, paramEntity, paramValueOriginal);

            return lambda.Compile();
        }
Dans l'ensemble, c'est clair. Nous parcourons les propriétés, créons des délégués qui appellent les setters et les sauvegardons. Ensuite, nous les appelons quand cela est nécessaire.
«Lent» (Préfixe Slow dans les benchmarks) :
        protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var property in _properties)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == property.Name);
                if (correlation?.Value == null)
                    continue;

                property.SetValue(contact, correlation.Value);
            }
            return contact;
        }
Ici, nous parcourons immédiatement les propriétés et appelons directement SetValue.
Pour visualiser et comme référence, j'ai mis en œuvre une méthode naïve qui écrit les valeurs de leurs paires de corrélation directement dans les champs de l'entité. Préfixe – Manual.
Prenons maintenant BenchmarkDotNet et examinons la performance. Et soudain… (spoiler – ce n'est pas le bon résultat, plus de détails ci-dessous)
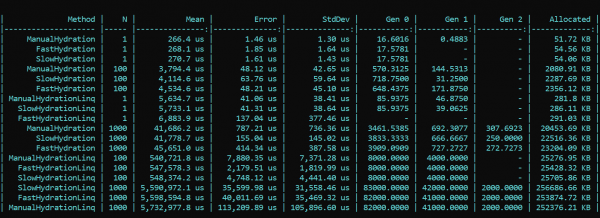
Que voyons-nous ici ? Les méthodes arborant fièrement le préfixe Fast se révèlent souvent plus lentes que celles avec le préfixe Slow dans presque tous les passages. Cela est vrai tant pour l'allocation que pour la vitesse d'exécution. D'un autre côté, une implémentation jolie et élégante de mappage utilisant partout où c'est possible les méthodes LINQ appropriées consomme de manière significative de la performance. La différence est d'un ordre de grandeur. La tendance ne change pas avec le nombre de passages. La différence n'est qu'une question d'échelle. Avec LINQ, c'est de 4 à 200 fois plus lent, et il y a environ la même ampleur de déchets.
Mise à jour
Je n'en croyais pas mes yeux, mais ce qui est plus important, ni mes yeux ni mon code n'ont cru notre collègue — . En vérifiant ma solution, il a brillamment découvert et signalé l'erreur que j'avais manquée à cause des modifications apportées de la mise en œuvre initiale à la finale. Après avoir corrigé le bug trouvé dans la configuration de Moq, tous les résultats se sont remis en place. Selon les résultats du nouveau test, la tendance principale ne change pas : LINQ influencera toujours la performance plus que la réflexion. Pourtant, il est agréable de constater que le travail avec la compilation des Expressions n'est pas vain, et le résultat est visible tant en allocation qu'en temps d'exécution. Le premier lancement, lorsque les champs statiques sont initialisés, est logiquement plus lent pour la méthode « rapide », mais la situation change par la suite.
Voici le résultat du nouveau test :
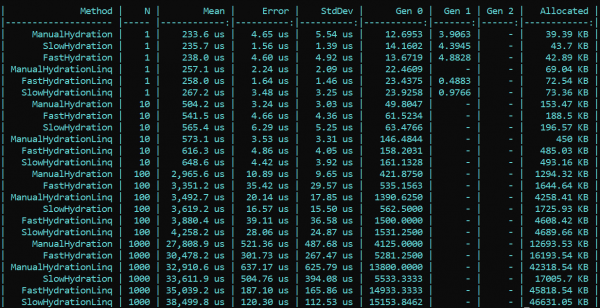
Conclusion : lors de l'utilisation de la réflexion en entreprise, il n'est pas nécessaire de recourir à des astuces particulières – LINQ dévorera la performance davantage. Cependant, dans les méthodes hautement sollicitées nécessitant une optimisation, il est possible de conserver la réflexion sous forme d'initialisateurs et de compilateurs de délégués, qui garantiront ensuite la logique « rapide ». Ainsi, vous pouvez à la fois préserver la flexibilité de la réflexion et la rapidité d'exécution de l'application.
Le code avec le benchmark est disponible ici. Tous ceux qui le souhaitent peuvent vérifier mes propos :
PS : le code dans les tests utilise l'Ioc, tandis que dans les benchmarks, il utilise une construction explicite. En fait, dans l'implémentation finale, j'ai éliminé tous les facteurs susceptibles d'affecter la performance et de brouiller les résultats.
PPS : Merci à l'utilisateur pour avoir découvert mon erreur dans la configuration de Moq, qui a eu un impact sur les premières mesures. Si certains lecteurs ont assez de karma, merci de le liker. Cette personne a pris le temps d'étudier, de vérifier et de signaler l'erreur. Je considère cela comme digne de respect et de sympathie.
PPPS : merci à ce lecteur pointilleux qui a critiqué le style et la présentation. Je suis pour l'uniformité et la commodité. La diplomatie dans la présentation laisse à désirer, mais j'ai pris en compte la critique. Je vous remercie.
Source : habr.com
