

Rem. trad.: c'est la traduction d'un postmortem public du blog technique de l'entreprise . Il décrit un problème avec conntrack dans un cluster Kubernetes, qui a conduit à une interruption partielle de certains services en production.
Cet article peut être utile pour ceux qui souhaitent en savoir un peu plus sur les postmortems ou prévenir certains problèmes potentiels avec DNS à l'avenir.
Ce n'est pas DNS
Impossible que ce soit DNS
C'était DNS
Un peu sur les postmortems et les processus chez Preply
Dans un postmortem, un échec de fonctionnement ou un événement dans la production est décrit. Le postmortem comprend une chronologie des événements, une description de l'impact sur l'utilisateur, la cause première, les actions effectuées et les leçons apprises.
Lors de nos réunions hebdomadaires avec des pizzas, entourés de l'équipe technique, nous partageons diverses informations. Une des parties les plus importantes de ces réunions est les postmortems, qui sont souvent accompagnés d'une présentation avec des diapositives et d'une analyse plus approfondie de l'incident survenu. Bien que nous ne « applaudissions » pas après les postmortems, nous essayons de Cultiver une culture « sans reproches » (). Nous croyons que rédiger et présenter des postmortems peut nous aider (et pas seulement) à prévenir de tels incidents à l'avenir, c'est pourquoi nous les partageons.
Les personnes impliquées dans l'incident doivent sentir qu'elles peuvent en parler en détail, sans craindre de sanctions ou de représailles. Aucune réprimande ! Rédiger un postmortem n'est pas une punition, mais une opportunité d'apprentissage pour l'ensemble de l'entreprise.
Problèmes de DNS dans Kubernetes. Postmortem
Date : 28.02.2020
Auteurs : Amet U., Andrey S., Igor K., Alexey P.
Statut : Terminé
En résumé : Indisponibilité partielle de DNS (26 min) pour certains services dans le cluster Kubernetes
Impact : 15000 événements perdus pour les services A, B et C
Cause première : Kube-proxy n'a pas pu supprimer correctement l'ancienne entrée de la table conntrack, donc certains services essayaient toujours de se connecter à des pods inexistants
E0228 20:13:53.795782 1 proxier.go:610] Échec de la suppression des connexions d'extrémité dns kube-system/kube-dns, erreur : échec de la suppression des entrées conntrack pour le pair UDP {100.64.0.10, 100.110.33.231}, erreur : la commande conntrack a échoué : ...Déclencheur : En raison de la faible charge au sein du cluster Kubernetes, CoreDNS-autoscaler a réduit le nombre de pods dans le déploiement de trois à deux
Solution : Un nouveau déploiement de l'application a déclenché la création de nouveaux nœuds, le CoreDNS-autoscaler a ajouté plus de pods pour gérer le cluster, ce qui a provoqué une réécriture de la table conntrack.
Détection : La surveillance Prometheus a détecté un grand nombre d'erreurs 5xx pour les services A, B et C et a déclenché un appel aux ingénieurs de garde.
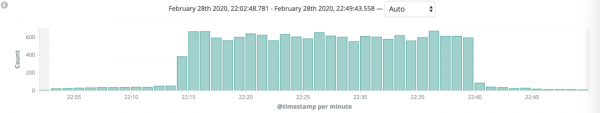
Erreurs 5xx dans Kibana
Actions
Action
Type
Responsable
La tâche
Désactiver l'autoscaler pour CoreDNS
prévenir.
Amet U.
DEVOPS-695
Installer un serveur DNS cache
réduire.
Max V.
DEVOPS-665
Configurer la surveillance conntrack
prévenir.
Amet U.
DEVOPS-674
Leçons tirées
Ce qui a bien fonctionné :
- La surveillance a fonctionné parfaitement. La réaction a été rapide et organisée.
- Nous n'avons rencontré aucune limite sur les nœuds.
Ce qui n'était pas correct :
- La véritable cause profonde reste inconnue, cela semble être dans conntrack.
- Toutes les actions corrigent seulement les conséquences, pas la cause (bug).
- Nous savions qu'à un moment ou à un autre, nous pourrions rencontrer des problèmes avec DNS, mais nous n'avons pas priorisé les tâches.
Où nous avons eu de la chance :
- Un nouveau déploiement a déclenché le CoreDNS-autoscaler, qui a réécrit la table conntrack.
- Ce bug n'a touché qu'une partie des services.
Chronologie (EET)
Temps
Action
22:13
CoreDNS-autoscaler a réduit le nombre de pods de trois à deux.
22:18
Les ingénieurs de garde ont commencé à recevoir des appels du système de surveillance.
22:21
Les ingénieurs de garde ont commencé à enquêter sur la cause des erreurs.
22:39
Les ingénieurs de garde ont commencé à revenir à une version précédente de l'un des derniers services.
22:40
Les erreurs 5xx ont cessé d'apparaître, la situation s'est stabilisée.
- Temps de détection : 4 min
- Temps jusqu'à la prise de mesures : 21 min
- Temps jusqu'à la correction : 1 min
Informations supplémentaires
- Journaux de CoreDNS :
I0228 20:13:53.507780 1 event.go:221] Événement(v1.ObjectReference{Kind:"Deployment", Namespace:"kube-system", Name:"coredns", UID:"2493eb55-3dc0-11ea-b3a2-02bb48f8c230", APIVersion:"apps/v1", ResourceVersion:"132690686", FieldPath:""}): type: 'Normal' raison: 'ScalingReplicaSet' Réduction de l'ensemble de réplicas coredns-6cbb6646c9 à 2. - Liens vers Kibana (coupé), Grafana (coupé)
Pour minimiser l'utilisation du processeur, le noyau Linux utilise quelque chose appelé conntrack. En termes simples, c'est un utilitaire qui contient une liste d'enregistrements NAT stockés dans une table spéciale. Lorsque le prochain paquet arrive du même pod vers le même pod que précédemment, l'adresse IP finale ne sera pas recalculée, mais récupérée depuis la table conntrack.
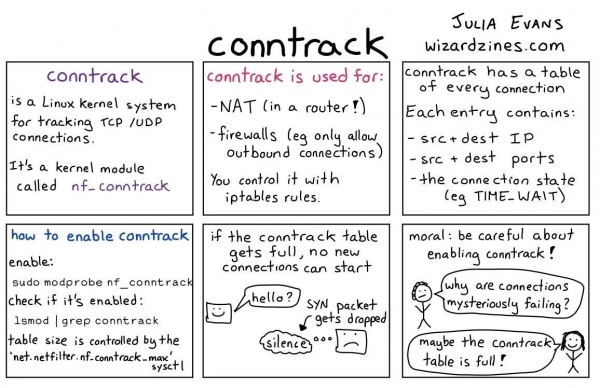
Comment fonctionne conntrack
Résultats
Ceci était un exemple d'un de nos post-mortems avec quelques liens utiles. Dans cet article, nous partageons des informations qui peuvent être bénéfiques pour d'autres entreprises. C'est pourquoi nous n'avons pas peur de faire des erreurs et c'est pourquoi nous avons rendu l'un de nos post-mortems public. Voici quelques autres post-mortems publics intéressants :
- GitLab :
- Dropbox :
- Spotify :
- Beaucoup d'autres de et du dépôt
- Aussi post-mortem public avec le SRE Book
Source : habr.com
