

Je vous propose de consulter la retranscription de la présentation d'Andrei Salnikov de début 2016 "Erreurs typiques dans les applications qui entraînent un bloat dans PostgreSQL"
Dans cette présentation, je vais examiner les principales erreurs dans les applications qui surviennent lors de la conception et de la rédaction du code de l'application. Je vais me concentrer uniquement sur les erreurs qui entraînent un bloat dans PostgreSQL. En général, c'est le début de la fin pour les performances de votre système dans son ensemble, bien qu'aucun signe prémonitoire n'était visible au départ.
Je suis ravi de vous accueillir ! Cette présentation n'est pas aussi technique que celle de mon collègue. Elle s'adresse principalement aux développeurs de systèmes backend, car nous avons un nombre assez élevé de clients. Et tous commettent les mêmes erreurs. Je vais vous en parler. J'expliquerai les conséquences fatales et néfastes de ces erreurs.
Pourquoi ces erreurs se produisent-elles ? Elles se produisent pour deux raisons : par opportunisme, en pensant que cela pourrait fonctionner, et par méconnaissance de certains mécanismes qui se produisent au niveau entre la base de données et l'application, ainsi qu'au sein de la base elle-même.
Je vais vous donner trois exemples avec des images horribles montrant comment tout dégénère. Je détaillerai brièvement le mécanisme en jeu. Et comment réagir lorsqu'ils se produisent, ainsi que les méthodes préventives à utiliser pour éviter les erreurs. Je parlerai des outils auxiliaires et fournirai des liens utiles.
J'ai utilisé une base de données de test, où j'avais deux tableaux. Un tableau avec les factures des clients, l'autre avec les opérations sur ces comptes. Et à intervalles réguliers, nous mettons à jour les soldes de ces comptes.
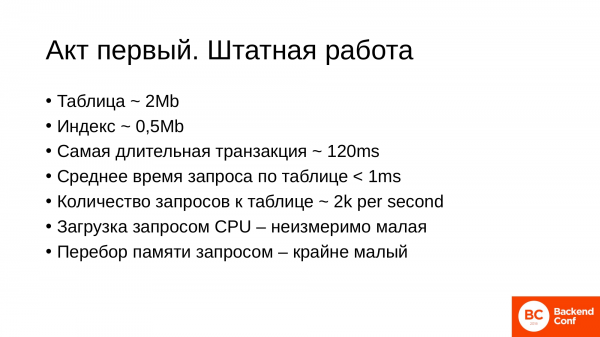
Les données initiales du tableau : il est relativement petit, 2 Mo. Le temps de réponse de la base et spécifiquement du tableau est également très bon. Et la charge est assez importante – 2000 opérations par seconde sur le tableau.
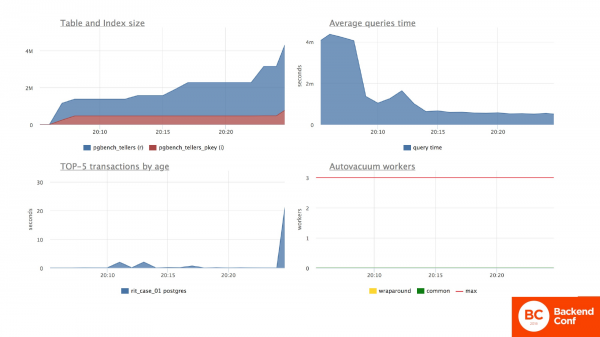
À travers cette présentation, je vais vous montrer des graphiques pour illustrer clairement ce qui se passe. Il y aura toujours 2 diapositives avec des graphiques. La première diapositive montre ce qui se passe en général sur le serveur.
Dans cette situation, nous voyons effectivement que notre tableau est de petite taille. L'index est également petit, à 2 Mo. C'est le premier graphique à gauche.
Le temps de réponse moyen sur le serveur est également stable et faible. C'est le graphique en haut à droite.
Le graphique en bas à gauche montre les transactions les plus longues. Nous constatons que les transactions sont rapidement exécutées. Et l'auto-vacuum n'est pas encore opérationnel ici, car c'était un test initial. Par la suite, il fonctionnera et sera bénéfique pour nous.
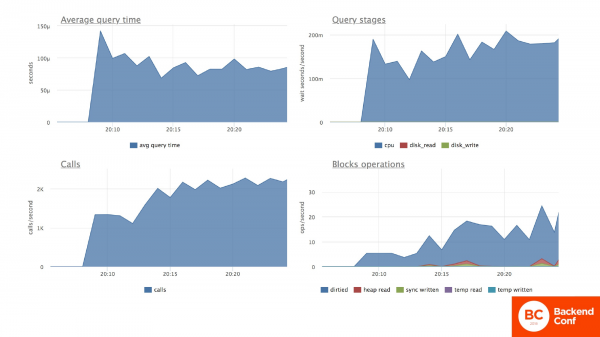
Le deuxième diapositive sera toujours consacré à la table test. Dans cette situation, nous mettons constamment à jour les soldes des comptes des clients. Et nous constatons que le temps de réponse moyen pour les opérations de mise à jour est assez bon, inférieur à une milliseconde. Nous voyons également que les ressources CPU (c'est le graphique en haut à droite) sont utilisées de manière uniforme et restent relativement faibles.
Le graphique en bas à droite montre combien de mémoire opérationnelle et de disque nous analysons à la recherche de notre ligne nécessaire avant de la mettre à jour. Et le nombre d'opérations sur la table est de 2 000 par seconde, comme je l'ai mentionné au début.
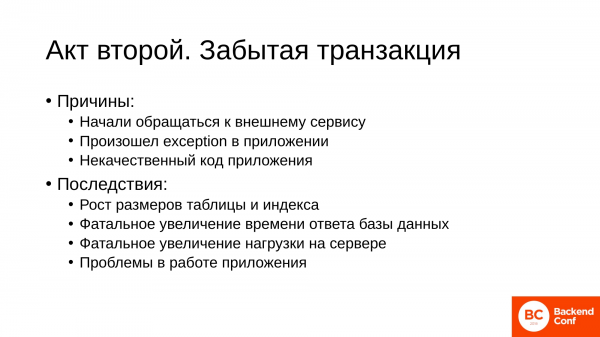
Et maintenant, nous faisons face à une tragédie. Pour une raison quelconque, une transaction oubliée se produit. Les raisons sont généralement banales :
- L'une des causes les plus fréquentes est que nous avons commencé à appeler un service externe depuis le code de l'application. Et ce service ne répond pas. C'est-à-dire que nous avons ouvert une transaction, effectué une modification dans la base de données et sommes partis lire nos e-mails ou consulter un autre service dans notre infrastructure, et pour une raison quelconque, il ne répond pas. Nous avons donc une session suspendue dans un état – on ne sait pas quand cela sera résolu.
- La deuxième situation survient lorsque, pour une raison quelconque, une exception se produit dans notre code. Et nous n'avons pas traité la fermeture de la transaction dans l'exception. Nous avons donc une session suspendue avec une transaction ouverte.
- Et enfin, le dernier – c'est également un cas assez fréquent. C'est du code de mauvaise qualité. Certains frameworks ouvrent une transaction. Elle reste en suspens, et vous pouvez ne pas savoir dans l'application qu'elle est toujours active.
Quelles sont les conséquences de telles situations ?
Elles entraînent un gonflement soudain des tables et des index. C'est exactement cet effet de bloat. Pour la base de données, cela se traduira par une augmentation significative du temps de réponse, une augmentation de la charge sur le serveur de base de données. En conséquence, notre application souffrira. Parce que si dans votre code, vous consacriez 10 millisecondes à une requête dans la base, 10 millisecondes à votre logique, votre fonction s'exécutait en 20 millisecondes. Or maintenant, votre situation sera tout à fait préoccupante.
Voyons ce qui se passe. Le graphique en bas à gauche montre que nous avons une transaction longue. Et si nous regardons le graphique en haut à gauche, nous constatons que la taille de la table de deux mégaoctets a soudainement grimpé à 300 mégaoctets. Pendant ce temps, la quantité de données dans la table n'a pas changé, c'est-à-dire qu'il y a pas mal de déchets.
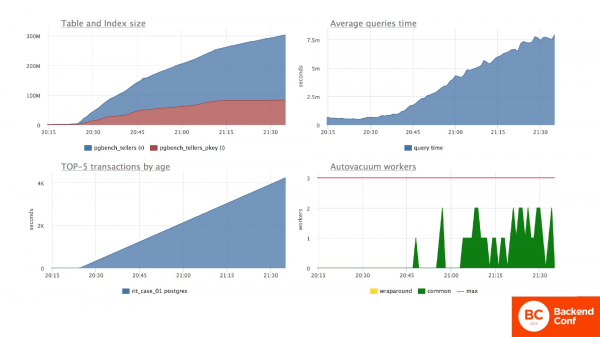
La situation générale concernant le temps de réponse moyen du serveur a également changé de plusieurs ordres de grandeur. Tous les requêtes au serveur ont commencé à ralentir considérablement. De plus, des processus internes de Postgres, sous forme d'autovacuum, se sont lancés, essayant de faire quelque chose et consommant des ressources.
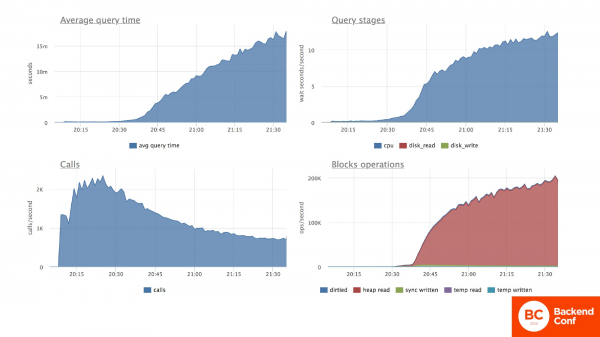
Que se passe-t-il alors avec notre table ? La même chose. Le temps de réponse moyen pour la table a également cru de plusieurs ordres de grandeur. En ce qui concerne les ressources consommées, nous voyons que la charge sur le processeur a fortement augmenté. C'est le graphique en haut à droite. Et cela a augmenté parce que le processeur doit parcourir une multitude de lignes inutiles à la recherche d'une seule nécessaire. C'est le graphique en bas à droite. En conséquence, le nombre d'appels par seconde a commencé à chuter fortement, car la base n'arrive pas à traiter le même nombre de requêtes.
Nous devons revenir à la normale. Nous allons sur Internet et découvrons que les transactions longues posent problème. Nous trouvons et tuons cette transaction. Et tout redevient normal. Tout fonctionne comme il se doit.
Nous sommes calmés, mais après un certain temps, nous commençons à remarquer que l'application ne fonctionne pas aussi bien qu'avant l'incident. Les requêtes sont toujours traitées plus lentement, et ce de manière significative. Dans mon exemple, elles sont lentement traitées une fois et demie à deux fois plus. La charge sur le serveur est également supérieure à celle d'avant l'accident.
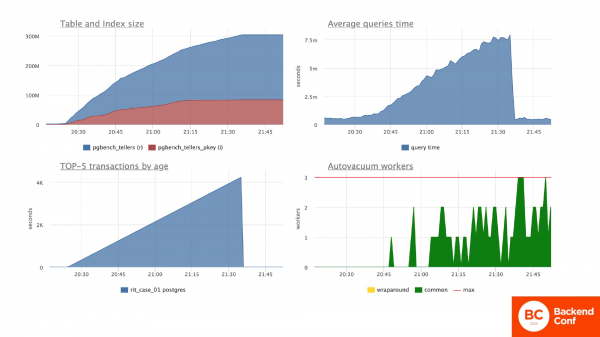
Et la question est : « Que se passe-t-il avec la base à ce moment-là ? ». Voici ce qui se passait avec la base. Sur le graphique des transactions, vous voyez qu'il s'est arrêté et qu'il n'y a pas vraiment de longues transactions. Mais les tailles des tables ont fatidiquement augmenté pendant l'accident. Et elles ne se sont pas réduites depuis. Le temps moyen pour la base s'est stabilisé. Les réponses semblent circuler de manière adéquate à une vitesse acceptable pour nous. L'autovacuum est devenu plus actif et a commencé à faire quelque chose avec la table, car il doit traiter un plus grand nombre de données.
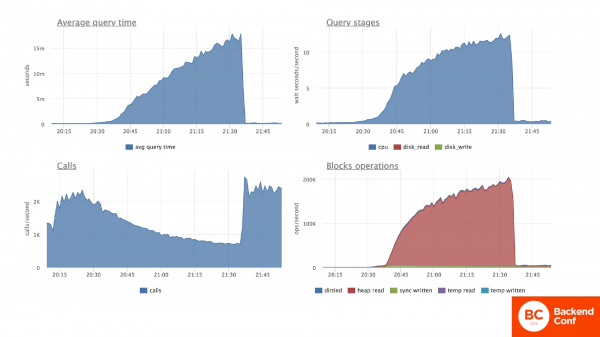
Concernant le tableau testé avec les comptes, où nous modifions les soldes : le temps de réponse des requêtes semble être revenu à la normale. Mais en réalité, il est une fois et demie plus élevé.
Et concernant la charge sur le processeur, nous constatons qu'elle n'est pas revenue à la valeur souhaitée avant l'accident. Les raisons se trouvent dans le graphique en bas à droite. On peut voir qu'il y a un certain surcoût en mémoire. Autrement dit, pour trouver la bonne ligne, nous consommons les ressources du serveur de la base de données en parcourant des données inutiles. Le nombre de transactions par seconde s'est stabilisé.
Dans l'ensemble, c'est bien, mais la situation est pire qu'avant. Il y a une dégradation évidente de la base de données en raison de notre application qui interagit avec cette base de données.
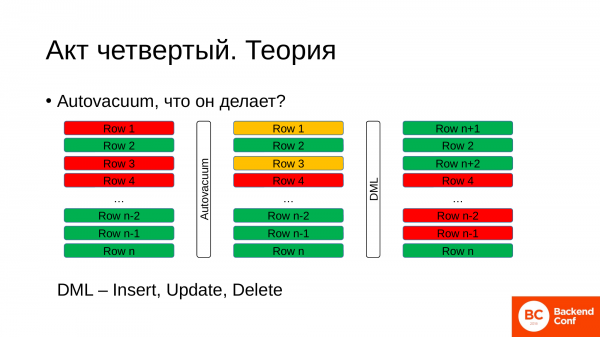
Et pour comprendre ce qui se passe, si vous n'étiez pas présents lors de la précédente présentation, voici un peu de théorie. Une théorie sur le processus interne. Quel est le but d'un autovacuum et que fait-il ?
En bref, pour comprendre. À un moment donné, nous avons une table. Dans cette table, nous avons des lignes. Ces lignes peuvent être actives, vivantes, nécessaires à l'instant. Dans l'image, elles sont marquées en vert. Et il y a des lignes mortes, qui ont déjà été traitées, mises à jour, pour lesquelles de nouvelles entrées ont été créées. Elles sont marquées comme étant déjà non intéressantes pour la base de données. Mais elles restent dans la table à cause des spécificités de Postgres.
À quoi sert l'autovacuum ? L'autovacuum, à un moment donné, s'adresse à la base de données et lui demande : « Donnez-moi, s'il vous plaît, l'id de la transaction la plus ancienne qui est actuellement ouverte dans la base de données. » La base de données retourne cet id. Et l'autovacuum s'appuie sur celui-ci pour parcourir les lignes de la table. Et s'il constate que certaines lignes ont été modifiées par des transactions beaucoup plus anciennes, alors il a le droit de les marquer comme des lignes que nous pourrons réutiliser à l'avenir, en y écrivant de nouvelles données. C'est un processus d'arrière-plan.
Pendant ce temps, nous continuons à travailler avec la base de données, nous continuons à apporter des modifications à la table. Et sur ces lignes que nous pouvons réutiliser, nous écrivons de nouvelles données. Ainsi, nous avons un cycle : il y a toujours des vieilles lignes mortes qui apparaissent, et à leur place, nous écrivons de nouvelles lignes dont nous avons besoin. Et c'est l'état normal pour le fonctionnement de PostgreSQL.
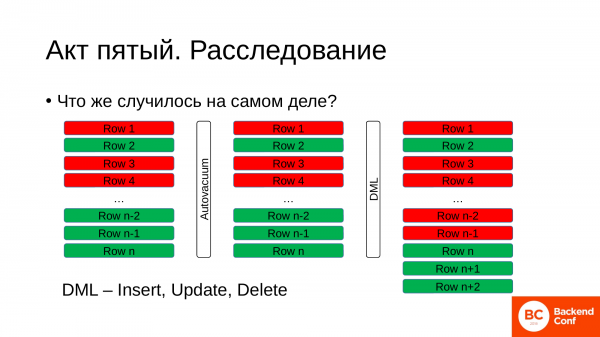
Que s'est-il passé lors de l'accident ? Comment ce processus s'est-il déroulé ?
Nous avions un tableau dans un état particulier, avec certaines lignes actives et d'autres mortes. Un autovacuum est arrivé. Il a demandé à la base de données quelle était notre plus ancienne transaction et quel était son id. Il a obtenu cet id, qui peut remonter à plusieurs heures ou à dix minutes. Cela dépend de la charge sur votre base de données. Puis il est allé chercher les lignes qu'il pouvait marquer comme réutilisables. Mais il n'a trouvé aucune ligne dans notre tableau.
Mais pendant ce temps, nous continuons à travailler avec le tableau. Nous faisons des modifications, nous mettons à jour des données. Et que peut faire la base de données pendant ce temps ? Elle n'a d'autre choix que d'ajouter de nouvelles lignes à la fin du tableau existant. Ainsi, la taille de notre tableau commence à augmenter.
En réalité, nous avons besoin de lignes vertes pour le travail. Mais pendant un tel problème, nous constatons que le pourcentage de lignes vertes est extrêmement faible par rapport à l'ensemble du tableau.
Et quand nous exécutons une requête, la base de données doit examiner toutes les lignes : rouges et vertes, pour trouver la ligne nécessaire. L'effet de gonflement du tableau avec des données inutiles est appelé « bloat », qui consomme aussi notre espace disque. Vous vous rappelez, c'était 2 Mo, ça a augmenté à 300 Mo ? Maintenant, remplacez les mégaoctets par des gigaoctets et vous perdrez assez rapidement toutes vos réserves de ressources disque.
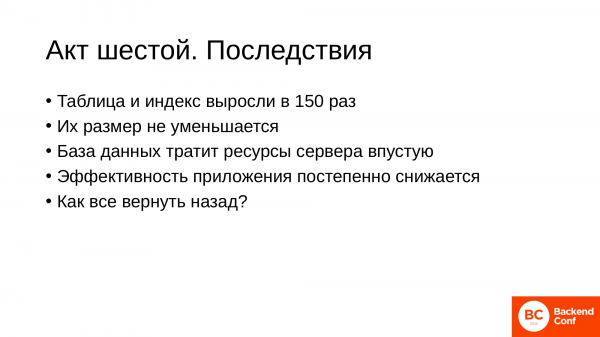
Quelles peuvent être les conséquences pour nous ?
- Dans mon exemple, le tableau et l'index ont grossi de 150 fois. Certains de nos clients ont connu des cas plus fatals, où l'espace disque a commencé à manquer.
- La taille des tableaux ne diminuera jamais d'elle-même. L'autovacuum peut, dans certains cas, couper la queue d'un tableau, s'il n'y a que des lignes mortes. Mais comme il y a une rotation constante, une ligne verte peut rester à la fin sans mise à jour, tandis que toutes les autres seront écrites quelque part au début du tableau. Mais c'est un événement tellement improbable que vous ne devriez pas espérer que votre tableau diminue en taille.
- La base de données doit parcourir toute une pile de lignes inutiles. Et nous gaspillons des ressources disque, des ressources processeur et de l'énergie.
- Et cela affecte directement notre application, car si au départ nous dépensions 10 millisecondes pour la requête et 10 millisecondes pour notre code, pendant la panne, nous en venions à dépenser une seconde pour la requête et 10 millisecondes pour le code, c'est-à-dire que la performance de l'application a chuté d'un ordre de grandeur. Et quand la panne a été résolue, nous avons commencé à dépenser 20 millisecondes pour la requête et 10 millisecondes pour le code. Cela signifie que nous avons tout de même subi une baisse de performance de 1,5 fois. Et tout cela à cause d'une seule transaction qui était suspendue, probablement à cause de notre erreur.
- La question est donc : « Comment tout ramener en arrière ? » pour que tout aille bien et que les requêtes soient à nouveau aussi rapides qu'avant la panne.
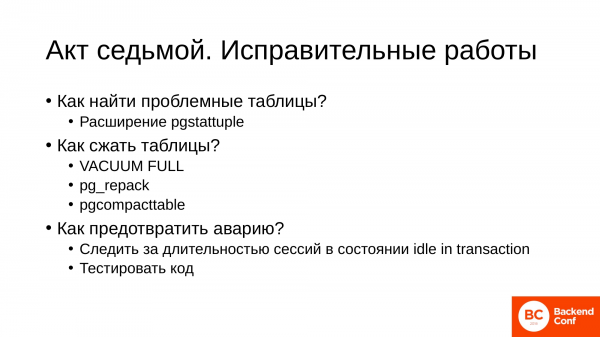
Pour cela, il y a un certain cycle de travail qui doit être effectué.
D'abord, nous devons identifier les tables problématiques qui se sont étendues. Nous comprenons que certaines tables enregistrent plus activement, tandis que d'autres le font moins. Et pour cela, nous utilisons l'extension . En installant cette extension, vous pouvez écrire des requêtes qui vous aideront à trouver les tables qui se sont considérablement étendues.
Une fois que vous avez trouvé ces tables, elles doivent être compactées. Pour cela, il existe déjà des outils. Dans notre entreprise, nous utilisons trois outils. Le premier est le VACUUM FULL intégré. Il est sévère, brutal et impitoyable, mais parfois très utile. et sont des utilitaires tiers pour compresser les tables. Et ils sont plus doux avec la base de données.
Ils sont utilisés en fonction de ce qui vous convient le mieux. Mais j'en reparlerai à la fin. L'important, c'est qu'il y a trois outils. Vous avez le choix.
Une fois que tout est corrigé et que nous avons vérifié que tout va bien, nous devons savoir comment éviter cette situation à l'avenir :
- C'est assez facile à prévenir. Il faut surveiller la durée des sessions sur le serveur maître. Les sessions particulièrement dangereuses sont celles en état idle in transaction.Ce sont celles qui ont ouvert une transaction, ont fait quelque chose, puis se sont éloignées ou se sont perdues dans le code.
- Et pour vous, en tant que développeurs, il est important de tester le code au moment où ces situations se produisent. Ce n'est pas difficile à faire. Cela sera un contrôle utile. Vous éviterez un grand nombre de « problèmes de débutant » liés aux transactions prolongées.
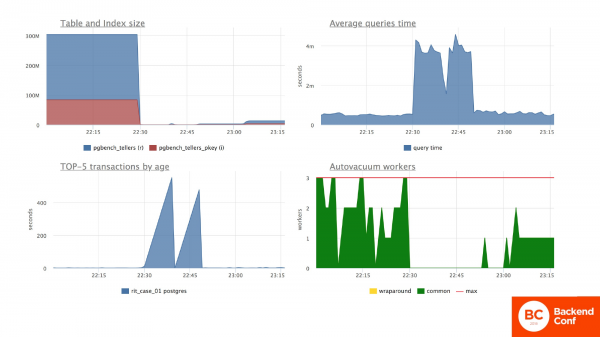
Sur ces graphiques, je voulais vous montrer comment la table et le comportement de la base de données ont changé après avoir effectué un VACUUM FULL sur la table dans ce cas. Ce n’est pas en production.
La taille de la table est revenue immédiatement à un état de fonctionnement normal de quelques mégaoctets. Cela n'a pas trop influencé le temps de réponse moyen du serveur.
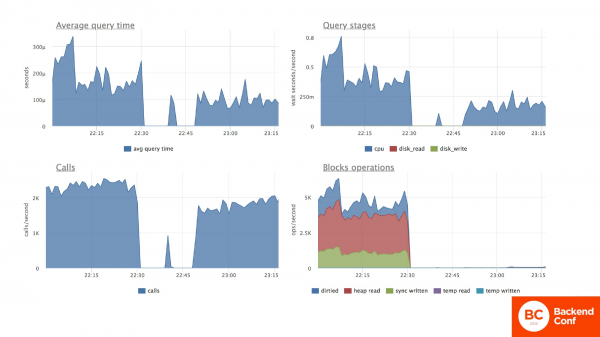
Mais concernant notre table expérimentale, où nous avons mis à jour les soldes, nous constatons que le temps de réponse moyen pour la mise à jour des données dans la table a été réduit à un niveau acceptable. Les ressources processeur utilisées pour exécuter cette requête ont également diminué à un niveau acceptable. Et le graphique en bas à droite montre que nous trouvons maintenant exactement la ligne dont nous avons besoin immédiatement, sans avoir à parcourir un tas de lignes mortes qui existaient avant la compression de la table. Et le temps moyen des requêtes est resté à peu près le même. Mais ici, j'ai probablement des limites liées à mon matériel.
C'est la première histoire. Elle est la plus courante. Cela arrive à tout le monde, indépendamment de l'expérience du client et des compétences des programmeurs. Tôt ou tard, cela se produit.
Deuxième histoire, dans laquelle nous répartissons la charge et optimisons les ressources serveur.
- Nous avons déjà grandi et sommes devenus des acteurs sérieux. Nous comprenons que nous avons une réplique et qu'il serait bien de répartir la charge : écrire sur le Maître et lire depuis la réplique. Cette situation se présente généralement lorsque nous voulons préparer certains rapports ou ETL. Et le business s'en réjouit beaucoup. Il désire vraiment divers rapports avec une analyse complexe.
- Les rapports prennent des heures car il n'est pas possible de calculer une analyse complexe en quelques millisecondes. En tant que fiers développeurs, nous écrivons du code. Dans l'application, nous effectuons des insertions pour que l'enregistrement se fasse sur le Maître, tandis que les rapports s'exécutent sur la réplique.
- Nous répartissons la charge.
- Tout fonctionne parfaitement. Bravo à nous.
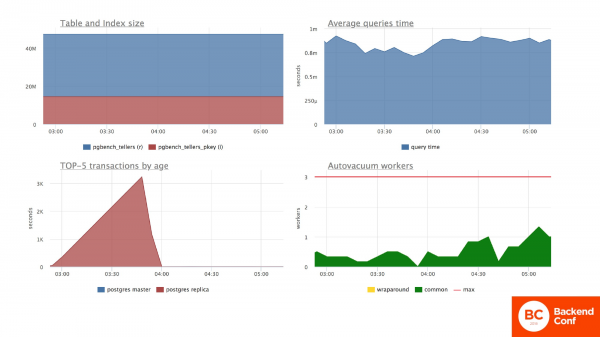
Et à quoi ressemble cette situation ? Concrètement, sur ces graphiques, j'ai également ajouté la durée des transactions depuis la réplique. Tous les autres graphiques concernent uniquement le serveur Maître.
Le tableau des rapports a considérablement augmenté jusqu'à présent. Nous constatons que le temps de réponse moyen du serveur est stable. Nous avons également une transaction longue sur la réplique, qui dure 2 heures. Le fonctionnement de l'autovacuum, qui gère les lignes mortes, est également calme. Tout se passe bien.
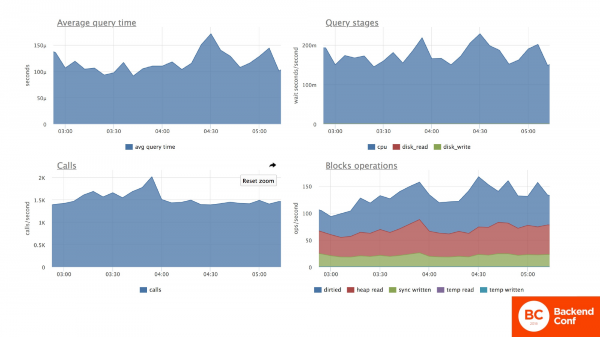
Concernant le tableau testé, nous continuons à mettre à jour les soldes sur les comptes. Nous avons également un temps de réponse stable pour la requête et une consommation de ressources stable. Tout se passe bien.
Tout va bien jusqu'à ce que ces rapports commencent à échouer en raison de conflits de réplication. Et ils échouent avec une fréquence constante.
Nous faisons des recherches en ligne pour comprendre pourquoi cela se produit. Et nous trouvons une solution.
La première solution consiste à augmenter le délai de réplication. Nous savons que notre rapport prend 3 heures. Nous définissons le délai de réplication à 3 heures. Nous lançons tout, mais nous avons toujours des problèmes avec des rapports qui échouent parfois.
Nous voulons que tout soit parfait. Nous continuons nos recherches et découvrons un paramètre génial en ligne – hot_standby_feedback. Nous l'activons. Hot_standby_feedback nous permet de retenir le fonctionnement de l'autovacuum sur le maître. Ainsi, nous éliminons complètement les conflits de réplication. Et tout fonctionne bien avec les rapports.
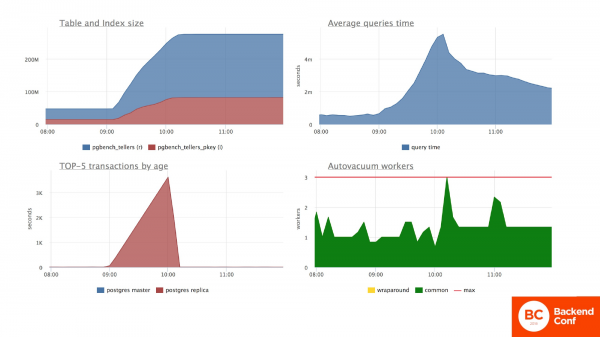
Que se passe-t-il pendant ce temps avec le serveur maître ? Eh bien, il subit une crise totale. Actuellement, nous observons les graphiques depuis que j'ai activé ces deux paramètres. Nous constatons que la session sur la réplique influence d'une manière ou d'une autre la situation sur le serveur maître. Elle a réellement un impact, car elle a suspendu l'autovacuum, qui débarrasse les lignes mortes. La taille de la table a de nouveau grimpé en flèche. Le temps moyen d'exécution des requêtes dans toute la base de données a également augmenté. Les autovacuums sont un peu plus sollicités.
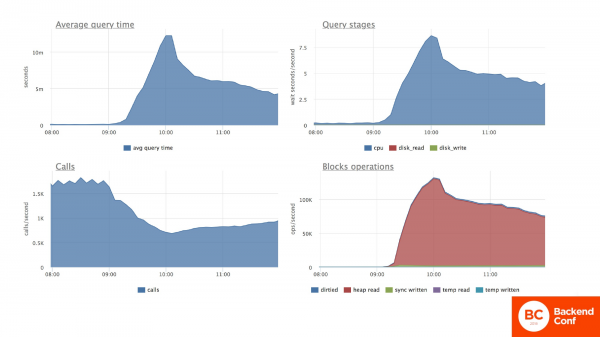
Concernant notre tableau, nous voyons également que la mise à jour des données a augmenté. La consommation des ressources processeur a également considérablement augmenté. Nous parcourons de nouveau un grand nombre de lignes mortes et inutiles. Et le temps de réponse pour ce tableau, le nombre de transactions a chuté.
À quoi cela ressemblerait-il si nous ignorons ce dont je parlais auparavant ?
- Nous commençons à rechercher des problèmes. Si nous avons rencontré des problèmes dans la première partie, nous savons que cela peut être dû à une transaction longue et nous plongeons dans le Master. Le problème se situe sur le Master. Ça bug. Il chauffe, sa charge moyenne frôle les cent.
- Les requêtes ralentissent là-bas, mais nous ne voyons aucune transaction longue. Et nous ne comprenons pas pourquoi. Nous ne savons pas où chercher.
- Nous vérifions le matériel du serveur. Peut-être que notre RAID a échoué. Peut-être qu'une barrette de RAM a brûlé. Tout peut arriver. Mais non, les serveurs sont neufs, tout fonctionne parfaitement.
- Tout le monde court : administrateurs, développeurs et directeur. Rien n'y fait.
- Et à un moment donné, tout commence soudainement à se corriger tout seul.
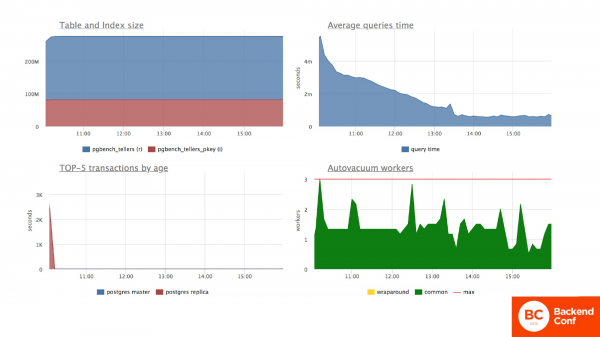
Sur la réplique, à ce moment, une requête a été traitée et est partie. Nous avons reçu un rapport. L'entreprise est toujours satisfaite. Comme nous le voyons, notre tableau a encore grandi et ne compte pas diminuer. Sur le graphique des sessions, j'ai laissé un extrait de cette longue transaction depuis la réplique, afin que vous puissiez évaluer combien de temps il faut avant que la situation ne se stabilise.
La session est partie. Et seulement après un certain temps, le serveur revient plus ou moins à la normale. Le temps de réponse moyen des requêtes sur le serveur Master redevient normal. Parce que, enfin, l'autovacuum a pu commencer à nettoyer, à marquer ces lignes mortes. Et il a commencé à faire son travail. Et aussi rapidement qu'il le fait, c'est aussi rapidement que nous reviendrons à la normale.
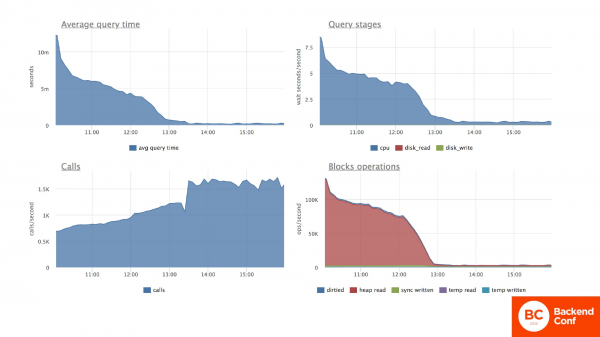
Sur le tableau testé, où nous mettons à jour les soldes des comptes, nous voyons exactement la même image. Le temps moyen de mise à jour des soldes se normalise également progressivement. Les ressources utilisées par le processeur diminuent aussi. Et le nombre de transactions par seconde revient à la normale. Mais à nouveau, ce n'est pas la même normalité qu'avant l'accident.
Dans tous les cas, nous subissons une baisse de performance, tout comme dans le premier cas, d'un niveau et demi à deux fois, voire plus parfois.
Nous avons l'impression d'avoir fait tout correctement. Nous avons réparti la charge. Le matériel ne reste pas inactif. Nous avons judicieusement réparti les requêtes, mais cela n'a toujours pas bien fonctionné.
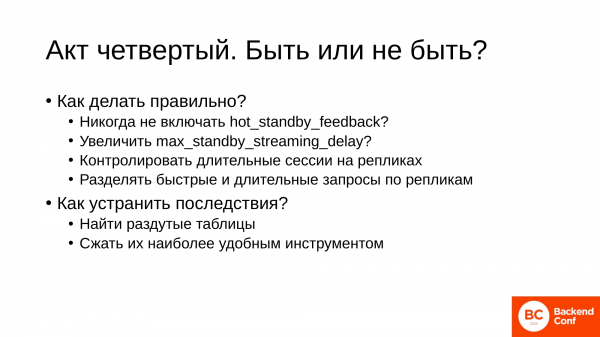
- Ne pas activer hot_standby_feedback ? Oui, il n'est pas recommandé de l'activer sans raison valable. Car ce paramètre affecte directement le serveur principal et suspend le fonctionnement de l'autovacuum. En l'activant sur une réplique et en l'oubliant, vous risquez de compromettre le maître et de rencontrer de sérieux problèmes avec l'application.
- Augmenter max_standby_streaming_delay ? Oui, pour les rapports – c'est tout à fait pertinent. Si vous avez un rapport de trois heures et que vous ne souhaitez pas qu'il échoue à cause de conflits de réplication, augmentez simplement le délai. Un rapport long ne nécessite jamais des données arrivées dans la base à cet instant. S'il est sur trois heures, cela signifie que vous l'exécutez sur une période de données antérieure. Et que ce soit trois heures de retard ou six heures de retard – cela n'aura pas d'importance, mais vous recevrez des rapports stables sans vous soucier des interruptions.
- Il est naturellement important de surveiller les sessions longues sur les répliques, surtout si vous avez décidé d'activer hot_standby_feedback sur la réplique. Car tout peut se produire. Vous avez donné cette réplique à un développeur pour qu'il teste des requêtes. Il a écrit une requête complexe. L'a lancée et est parti prendre un thé, tandis que nous avons obtenu un maître engorgé. Ou nous avons laissé entrer une application inappropriée. Les situations sont variées. Les sessions sur les répliques doivent être surveillées aussi soigneusement que sur le maître.
- Et si vous avez des requêtes rapides et longues sur les répliques, il est préférable de les répartir pour une meilleure gestion de la charge. Cela fait référence à streaming_delay. Pour les rapides, avoir une réplique avec un petit retard de réplication. Pour les longues requêtes de rapport, avoir une réplique qui peut avoir un retard de 6 heures, voire d'un jour. C'est une situation tout à fait normale.
Nous éliminons les conséquences de la même manière :
- Nous identifions les tables surdimensionnées.
- Et nous les compressons avec l'outil le plus approprié pour nous.
Cette histoire s'est terminée ici. Passons à la troisième histoire.
C'est aussi un cas assez courant pour nous, où nous effectuons une migration.
- Tout produit logiciel évolue. Ses exigences changent. Nous voulons progresser. Et il arrive que nous devions mettre à jour les données dans la table, en faisant passer une mise à jour dans le cadre de notre migration vers de nouvelles fonctionnalités que nous intégrons dans notre développement.
- Le format de données ancien ne convient pas. Supposons que nous nous tournions maintenant vers le deuxième tableau, où j'ai les opérations pour ces comptes. Et, disons qu'elles étaient en roubles, mais nous avons décidé d'augmenter la précision et de travailler en kopecks. Pour cela, nous devons effectuer une mise à jour : multiplier le champ avec le montant de l'opération par cent.
- Dans le monde moderne, nous utilisons des moyens automatisés de contrôle de version de base de données. Supposons, . Nous y décrivons notre migration. Nous la testons sur notre base de test. Tout va bien. La mise à jour a lieu. Cela bloque le travail pendant un certain temps, mais nous obtenons des données mises à jour. Nous pouvons lancer de nouvelles fonctionnalités à partir de cela. Nous avons tout testé, vérifié. Tout a été confirmé.
- Nous avons effectué des travaux planifiés, réalisé la migration.
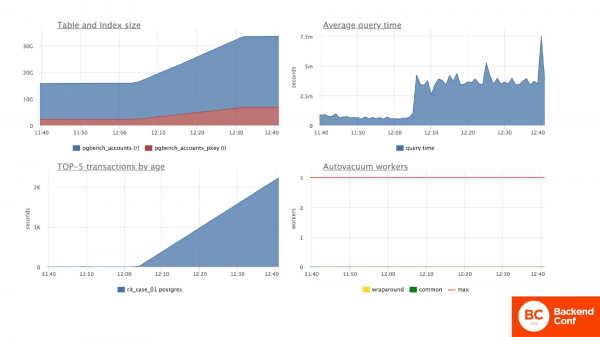
Voici la migration avec mise à jour présentée devant vous. Comme il s'agit d'opérations sur des comptes, le tableau faisait 15 Go. Et comme nous mettrons à jour chaque ligne, nous avons doublé la taille du tableau avec notre mise à jour, car nous avons réécrit chaque ligne.
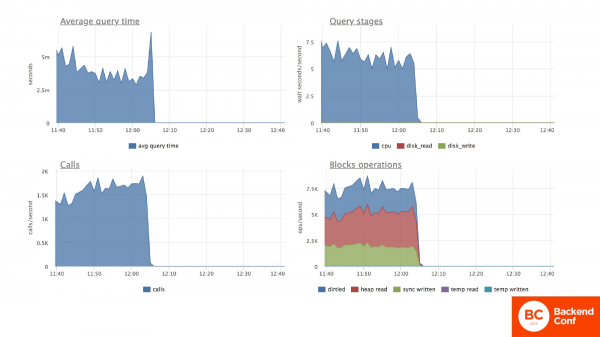
Pendant la migration, nous ne pouvions rien faire avec ce tableau, car toutes les requêtes à celui-ci étaient en attente et attendaient que cette mise à jour soit terminée. Mais ici, je veux attirer votre attention sur les chiffres sur l'axe vertical. C'est-à-dire que nous avons un temps de requête moyen avant la migration d'environ 5 millisecondes et une charge processeur, le nombre d'opérations de lecture mémoire disque, inférieure à 7,5.
Nous avons effectué la migration et rencontré à nouveau des problèmes.
La migration a réussi, mais :
- Le fonctionnement ancien a pris plus de temps.
- La taille de la table a à nouveau augmenté.
- La charge sur le serveur est à nouveau plus importante qu'auparavant.
- Et, bien sûr, nous avons encore des ajustements à faire sur la fonctionnalité qui fonctionnait bien, nous l'avons légèrement améliorée.
Et cela est à nouveau excessif, ce qui nuit à notre expérience.
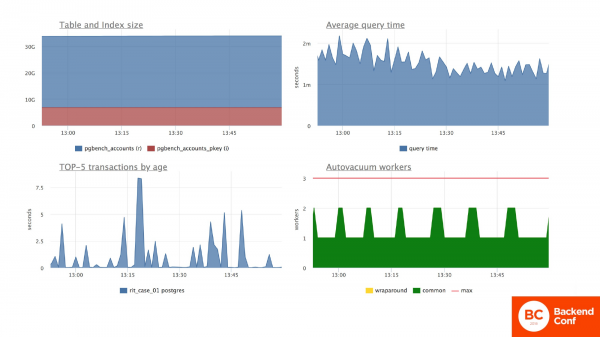
Ici, je montre que le tableau, comme dans les deux cas précédents, ne compte pas revenir à des tailles antérieures. La charge moyenne sur le serveur semble raisonnable.
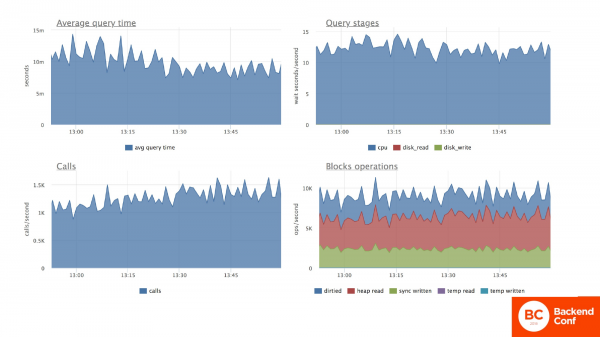
Et si nous nous référons au tableau des factures, nous verrons que le temps moyen de requête a doublé pour ce tableau. La charge sur le processeur et le nombre de lignes parcourues en mémoire a dépassé 7,5, alors qu'il était en dessous. Et cela a doublé pour les processeurs et augmenté de 1,5 fois pour les opérations par blocs, c'est-à-dire que nous avons constaté une dégradation des performances du serveur. En conséquence, une dégradation des performances de notre application. Cependant, le nombre d'appels est resté à peu près au même niveau.
Il est essentiel de comprendre comment effectuer correctement ces migrations. Et il est nécessaire de les faire. Nous effectuons assez régulièrement ces migrations.
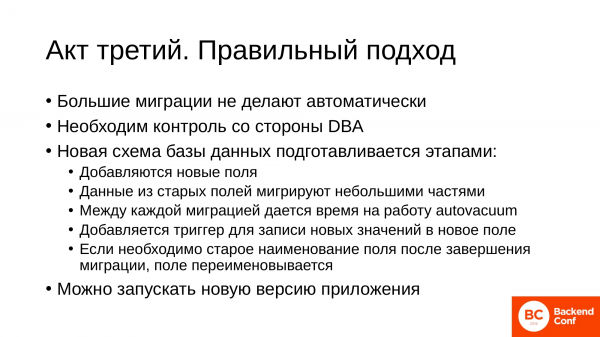
- De telles grandes migrations ne sont jamais effectuées automatiquement. Elles doivent toujours être contrôlées.
- Un contrôle est nécessaire de la part d'une personne expérimentée. Si vous avez un DBA dans l'équipe, que ce soit lui qui s'en occupe. C'est son travail. Sinon, la personne la plus expérimentée devrait s'en charger, celle qui sait comment travailler avec des bases de données.
- Le nouveau schéma de base de données, même si nous mettons à jour une seule colonne, doit toujours être préparé par étapes, c'est-à-dire en amont du déploiement de la nouvelle version de l'application :
- De nouveaux champs sont ajoutés pour stocker les données mises à jour.
- Nous transférons les données de l'ancien champ vers le nouveau champ par petites portions. Pourquoi faisons-nous cela ? Tout d'abord, nous contrôlons toujours le processus. Nous savons que nous avons déjà transféré un certain nombre de lots et qu'il nous en reste encore à faire.
- Un autre effet positif est qu'entre chaque lot, nous fermons la transaction, en ouvrons une nouvelle et cela permet au système d'effectuer l'autovacuumer sur la table, en marquant les lignes mortes pour être réutilisées.
- Pour les lignes qui apparaîtront pendant le fonctionnement de l'application (notre ancienne application est toujours en cours d'exécution), nous ajoutons un déclencheur qui enregistre de nouvelles valeurs dans les nouveaux champs. Dans notre cas, cela correspond à multiplier par cent la valeur ancienne.
- Si nous sommes vraiment obstinés et voulons le même champ, alors une fois toutes les migrations terminées et avant le déploiement de la nouvelle version de l'application, nous simplement renommant les champs. Les anciens prenant un nom fictif, tandis que les nouveaux champs sont renommés en anciens.
- Ce n'est qu'après cela que nous lançons la nouvelle version de l'application.
Et ainsi, nous n'aurons pas de bloat et ne subirons pas de dégradation des performances.
Cette troisième histoire est maintenant terminée.
Et maintenant, un peu plus en détail sur les outils que j'ai mentionnés dans la toute première histoire.
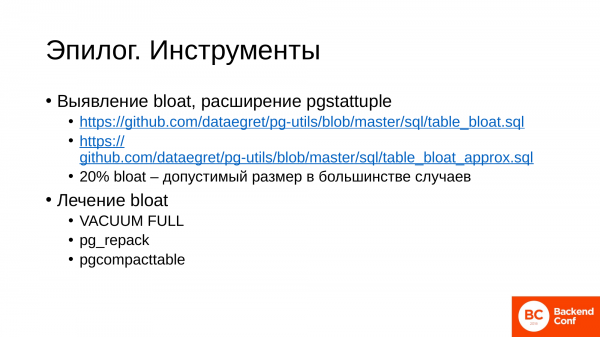
Avant de chercher le bloat, il est impératif d'installer l'extension. .
Pour vous éviter d'inventer des requêtes, nous avons déjà écrit ces requêtes dans notre travail. Vous pouvez les utiliser. Deux requêtes sont présentées ici.
- La première fonctionne assez longtemps, mais elle vous montrera les valeurs exactes du bloat dans la table.
- La deuxième fonctionne plus rapidement et est très efficace lorsqu'il s'agit d'évaluer rapidement – s'il y a du bloat ou non dans la table. Et vous devez également comprendre que le bloat dans la table Postgres est toujours présent. C'est une particularité de son modèle MVCC.
- Et 20 % de bloat est normal pour les tables dans la plupart des cas. Donc, vous ne devriez pas vous inquiéter et compresser cette table.
Nous avons compris comment identifier les tables qui ont gonflé avec des données inutiles.
Maintenant, parlons de la façon de corriger le bloat :
- Si nous avons une petite table et de bons disques, c'est-à-dire qu'il est tout à fait possible d'utiliser VACUUM FULL sur une table allant jusqu'à un gigaoctet. Cela prendra un verrou exclusif sur la table pendant quelques secondes et tout ira bien, mais cela fera le travail rapidement et efficacement. Que fait VACUUM FULL ? Il prend un verrou exclusif sur la table et réécrit les lignes vivantes des anciennes tables dans une nouvelle table. À la fin, il remplace leurs places. Il supprime les anciens fichiers et place les nouveaux à la place des anciens. Mais pendant son exécution, il prend un verrou exclusif sur la table. Cela signifie que vous ne pourrez rien faire avec cette table : ni y écrire, ni y lire, ni la modifier. Et VACUUM FULL nécessite de l'espace supplémentaire sur le disque pour enregistrer les données.
- L'outil suivant est . Par son principe, il est très similaire à VACUUM FULL, car il réécrit également les données à partir des anciens fichiers dans de nouveaux et les remplace dans la table. Mais il ne prend pas de verrou exclusif sur la table au début de son fonctionnement, mais seulement au moment où il a déjà des données prêtes à remplacer les fichiers. Les exigences en matière de ressources disque sont similaires à celles de VACUUM FULL. Vous aurez besoin d'espace supplémentaire sur le disque, ce qui peut parfois être critique si vous avez des tables de plusieurs téraoctets. Et il est assez gourmand en ressources processeur, car il effectue un travail actif d'entrée-sortie.
- La troisième utilité est Elle gère les ressources de manière plus prudente, car elle fonctionne selon des principes légèrement différents. L'essence de pgcompacttable est qu'elle déplace toutes les lignes actives en début de table lors des mises à jour. Ensuite, elle exécute un vide en raison de la connaissance que nous avons des lignes vivantes au début et des mortes à la fin. Le vide va donc couper cette partie, c'est-à-dire qu'il nécessite peu d'espace disque supplémentaire. De plus, il peut être compressé en ressources.
Tout est dans les outils.
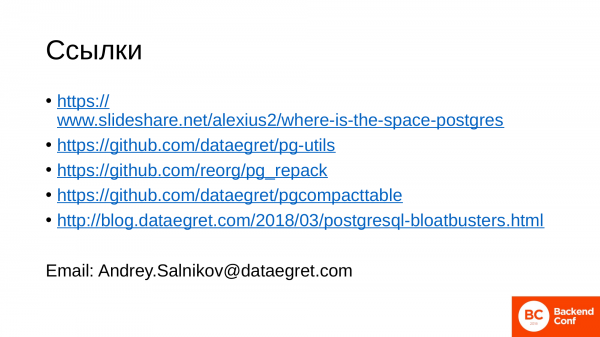
Si le sujet du bloat vous paraît intéressant à explorer plus en profondeur, voici quelques liens utiles :
- – c'est une présentation de mon collègue. Elle aborde de manière générale où l'espace disparaît dans Postgres durant son fonctionnement. Il y a une grande section technique détaillée pour les administrateurs de bases de données sur le bloat.
- – c'est un lien vers notre dépôt où nous stockons de nombreux scripts utiles pour vérifier l'état de la base de données. Vous y trouverez des scripts pour rechercher le bloat.
- et liens vers des outils qui vous aideront à compresser les tables.
- – c'est un article de mon collègue. Il examine de manière plutôt sérieuse et technique le bloat, à un niveau proche des administrateurs.
J'ai essayé ici de montrer un aperçu inquiétant pour les développeurs, car ils sont nos clients directs des bases de données et doivent comprendre les conséquences de leurs actions. J'espère avoir réussi. Merci de votre attention !
Questions
Merci pour la présentation ! Vous avez parlé de la manière de détecter les problèmes. Comment peut-on les prévenir ? C'est-à-dire, j'ai eu une situation où des requêtes bloquaient non seulement parce qu'elles faisaient appel à des services externes. Il s'agissait de simples joins démesurés. Quelques petites requêtes inoffensives sont restées bloquées pendant une journée avant de causer des anomalies. Cela ressemble beaucoup à ce que vous décrivez. Comment le surveiller ? Faut-il surveiller constamment quelle requête est suspendue ? Comment peut-on prévenir cela ?
Dans ce cas, c'est une tâche pour les administrateurs de votre entreprise, pas forcément pour le DBA.
Je suis administrateur.
Dans PostgreSQL, il existe une vue appelée pg_stat_activity qui montre les requêtes en cours. Vous pouvez voir combien de temps elles ont été suspendues.
Dois-je me connecter toutes les 5 minutes pour vérifier ?
Configure cron and keep checking. If you have a long-running query, send an email and that's it. That is, you don't need to watch it manually; this can be automated. You will receive an email, and you react to it. Or you can shoot it off automatically.
Are there obvious reasons why this is happening?
I've listed some. Others are more complex examples. And the conversation there can be lengthy.
Thank you for the presentation! I wanted to clarify about the pg_repack utility. If it doesn't do exclusive locking, then…
It does perform exclusive locking.
… Then I could potentially lose data. My application should not be writing at that time, right?
No, it works fine with the table; that is, pg_repack first moves all active rows. Naturally, some writing occurs in the table. It just appends that tail.
That is, it ultimately does it at the end?
In the end, it takes an exclusive lock to swap those files.
Will this be faster than VACUUM FULL?
VACUUM FULL, as soon as it starts, immediately takes an exclusive lock. And it doesn't release it until everything is done. pg_repack takes an exclusive lock only at the moment of file replacement. At that moment, you can't write to it, but no data will be lost; everything will be fine.
Hello! You talked about the autovacuum operation. There was a graph with red, yellow, and green cells for records. That is, the yellow ones are marked as deleted. Consequently, can something new be written to them?
Yes. Postgres does not delete rows. It has this specificity. If we update a row, we mark the old one as deleted. An ID of the transaction that changed the row appears, and we write a new row. And we have sessions that can potentially read them. At some point, they become completely old. The essence of autovacuum is that it goes through these rows and marks them as unnecessary. And data can be rewritten there.
I understand. But the question is a bit different. I didn't finish my thought. Suppose we have a table. It has variable size fields. If I try to insert something new, it may simply not fit in the old cell.
Non, toute la ligne est mise à jour de toute façon. PostgreSQL dispose de deux modèles de stockage des données. Il choisit en fonction du type de données. Il y a des données qui sont stockées directement dans la table, et il y a aussi des données malloc. Ce sont de grands volumes de données : texte, json. Ils sont stockés dans des tables séparées. Et pour ces tables, c'est la même histoire avec le bloat, c’est-à-dire que c'est tout à fait pareil. Sauf qu'elles sont séparées.
Merci pour la présentation ! Dans quelle mesure est-il acceptable d'utiliser des requêtes de type statement timeout pour limiter la durée des requêtes ?
C'est tout à fait acceptable. Nous l'utilisons partout. Et comme nous n'avons pas de services propres, nous offrons une assistance à distance, donc nous avons des clients assez variés. Et cela satisfait tout le monde. C'est-à-dire que nous avons des tâches dans cron qui vérifient. On discute simplement avec le client de la durée des sessions, avant laquelle nous ne les terminons pas. Cela peut être une minute, cela peut être 10 minutes. Cela dépend de la charge sur la base et de son objectif. Mais pour tous, nous utilisons pg_stat_activity.
Merci pour la présentation ! J'essaie d'adapter votre présentation à mes applications. Et il semble que nous commençons une transaction partout, et nous la terminons clairement partout. S'il y a une exception, alors un rollback se produit quand même. Et je me suis demandé. En effet, une transaction peut démarrer de manière implicite. C'est une indication pour la fille, je suppose. Si je fais simplement une mise à jour d'un enregistrement, la transaction commencera dans PostgreSQL et ne se terminera que lorsque la connexion sera interrompue ?
Si vous parlez maintenant du niveau de l'application, cela dépend du driver que vous utilisez, de l'ORM qui est utilisé. Il y a beaucoup de paramètres. Si vous avez activé l'auto commit, alors la transaction démarre et se ferme immédiatement.
C'est-à-dire qu'elle se ferme immédiatement après la mise à jour ?
Cela dépend des paramètres. J'ai mentionné un paramètre. C'est auto commit. C'est assez courant. S'il est activé, alors la transaction est ouverte et fermée. Si vous n'avez pas explicitement dit « start transaction » et « end transaction », mais avez simplement lancé une requête dans la session.
Bonjour ! Merci pour la présentation ! Imaginons que nous ayons une base de données qui grossit et que l'espace sur le serveur soit limité. Y a-t-il des outils pour corriger cette situation ?
L'espace sur le serveur doit idéalement être surveillé.
Par exemple, un DBA est parti prendre un café, était en vacances, etc.
Lorsque le système de fichiers est créé, un certain espace réservé est au minimum établi, où les données ne sont pas écrites.
Et si c'est complètement à zéro ?
Il est ainsi appelé espace réservé, c'est-à-dire que vous pouvez le libérer, et selon la taille qu'il a été créé, vous avez de l'espace libre. Par défaut, je ne sais pas combien il y a. Dans un autre cas, vous devez fournir des disques pour avoir de la place pour effectuer une opération de récupération. Vous pouvez supprimer une table dont vous êtes sûr qu'elle ne vous est pas nécessaire.
Il n'y a pas d'autres outils ?
C'est toujours un travail manuel. Et sur place, on détermine ce qu'il est préférable de faire, car certaines données sont critiques, d'autres ne le sont pas. Et cela dépend de chaque base et de chaque application qui travaille avec elle, cela varie selon les affaires. Tout se décide sur place.
Merci pour la présentation ! J'ai deux questions. Tout d'abord, vous avez montré des diapositives où il était indiqué que dans le cas de transactions bloquées, à la fois le volume de l'espace tabulaire et la taille de l'index augmentent. Ensuite, dans la présentation, il y avait de nombreux outils qui compactent les tables. Que se passe-t-il avec l'index ?
Ils le compressent aussi.
Mais le vacuum ne touche pas à l'index ?
Certains travaillent avec l'index. Par exemple, pg_rapack, pgcompacttable. Le vacuum recrée les index, il les touche. Le but de VACUUM FULL est de tout réécrire, c'est-à-dire qu'il travaille avec tous.
Et ma deuxième question. Je n'ai pas compris pourquoi les rapports sur les répliques dépendent tant de la réplication elle-même. Je pensais que les rapports étaient de la lecture, et la réplication était de l'écriture.
Où se situe le conflit de réplication ? Nous avons un Maître où les processus se déroulent. Nous avons un autovacuum. Que fait en fait l'autovacuum ? Il supprime certaines anciennes lignes. Si, en même temps, sur la réplique, une requête lit ces anciennes lignes, mais qu'au Maître, l'autovacuum a marqué ces lignes comme pouvant être réécrites, nous les avons réécrites. Et nous avons reçu un paquet de données lorsque nous devons réécrire ces lignes nécessaires à la requête sur la réplique, le processus de réplication attendra le timeout que vous avez configuré. Ensuite, PostgreSQL décidera ce qui est le plus important pour lui. Et la réplication est plus importante pour lui que la requête, donc il rejettera la requête pour pouvoir appliquer ces modifications sur la réplique.
André, j'ai une question. Ces magnifiques graphiques que vous avez montrés pendant la présentation, sont-ils le résultat du travail d'un de vos outils ? Comment ont-ils été réalisés ?
C'est un service .
C'est un produit commercial ?
Oui. C'est un produit commercial.
Source : habr.com
