

Cette histoire porte sur notre utilisation des conteneurs dans un environnement de production, en particulier sous Kubernetes. Cet article est dédié à la collecte de métriques et de journaux à partir des conteneurs, ainsi qu'à la création d'images.
Nous sommes de la société fintech Exness, qui développe des services de trading en ligne et des produits fintech pour le B2B et le B2C. Dans notre R&D, il y a plusieurs équipes différentes, et notre département de développement compte plus de 100 employés.
Nous représentons l'équipe responsable de la plateforme permettant à nos développeurs de collecter et de déployer du code. En particulier, nous sommes chargés de la collecte, du stockage et de la fourniture de métriques, de journaux, et d'événements provenant des applications. Actuellement, nous gérons environ trois mille conteneurs Docker dans un environnement de production, maintenons notre stockage big data de 50 To et fournissons des solutions architecturales construites autour de notre infrastructure : Kubernetes, Rancher et divers fournisseurs de cloud publics.
Notre motivation
Qu'est-ce qui brûle ? Personne ne peut répondre. Où est le foyer ? Difficile à comprendre. Quand cela a-t-il commencé ? On peut le déterminer, mais pas tout de suite.
Pourquoi certains conteneurs sont-ils à l'arrêt tandis que d'autres sont en panne ? Quel conteneur en est la cause ? En dehors, les conteneurs sont identiques, mais chacun a son propre Neo à l'intérieur.
Nos développeurs sont des gens compétents. Ils créent de bons services qui rapportent de l'argent à l'entreprise. Mais il y a des échecs, lorsque les conteneurs avec les applications sont en désordre. Un conteneur consomme trop de CPU, un autre de la bande passante, un troisième des opérations d'entrée-sortie, et un quatrième fait quelque chose d'incompréhensible avec les sockets. Tout cela s'effondre et le navire coule.
Agents
Pour comprendre ce qui se passe à l'intérieur, nous avons décidé d'installer des agents directement dans les conteneurs.
Ces agents sont des programmes d'alerte qui maintiennent les conteneurs dans un état tel qu'ils ne se cassent pas les uns les autres. Les agents sont standardisés, et cela permet de normaliser l'approche de maintenance des conteneurs.
Dans notre cas, les agents doivent fournir des journaux dans un format standard, étiquetés et avec un throttling. Ils doivent également nous fournir des métriques normalisées, extensibles du point de vue des applications commerciales.
Sous le terme agents, on entend également des utilitaires pour l'exploitation et la maintenance, capables de fonctionner dans différents systèmes d'orchestration, prenant en charge différentes images (Debian, Alpine, Centos, etc.).
Enfin, les agents doivent maintenir un CI/CD simple, incluant des fichiers Docker. Sinon, le navire se brisera, car les conteneurs commenceront à être livrés sur des « rails tordus ».
Le processus de construction et la structure de l'image cible
Pour que tout soit standardisé et gérable, il est nécessaire de suivre un certain processus standard de construction. C'est pourquoi nous avons décidé de construire des conteneurs avec des conteneurs — une sorte de récursion.
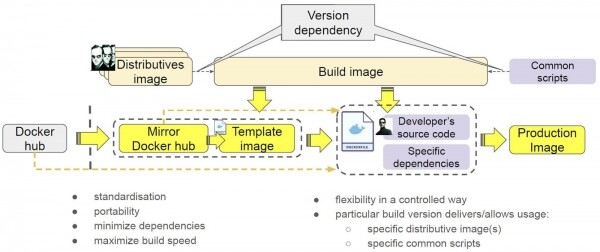
Ici, les conteneurs sont représentés par des contours solides. En même temps, nous avons décidé d'y mettre des distributions, pour que « la vie ne soit pas trop facile ». Nous expliquerons pourquoi cela a été fait ci-dessous.
En résultat, nous avons obtenu un outil de construction — un conteneur d'une version spécifique, qui fait référence à des versions spécifiques de distributions et de scripts.
Comment l'utilisons-nous ? Nous avons un Docker Hub, où se trouve le conteneur. Nous le réfléchissons dans notre système pour nous débarrasser des dépendances externes. Cela a abouti à un conteneur marqué en jaune. Nous créons un modèle pour installer dans le conteneur toutes les distributions et scripts nécessaires. Ensuite, nous construisons une image prête à l'exploitation : les développeurs y ajoutent leur code et certaines de leurs dépendances spécifiques.
Quels sont les avantages de cette approche ?
- Tout d'abord, un contrôle de version complet des outils de construction – conteneur de construction, versions des scripts et des distributions.
- Deuxièmement, nous avons réussi à standardiser : nous créons des modèles, des images intermédiaires et prêtes à l'exploitation de la même manière.
- Troisièmement, les conteneurs nous assurent portabilité. Aujourd'hui, nous utilisons GitLab, et demain nous passerons à TeamCity ou Jenkins tout en continuant à exécuter nos conteneurs de la même manière.
- Quatrièmement, minimisation des dépendances. Nous n'avons pas mis les distributions dans le conteneur par hasard, car cela permet d'éviter de les télécharger à chaque fois depuis Internet.
- Cinquièmement, la vitesse de construction a augmenté – la présence de copies locales des images permet de ne pas perdre de temps à télécharger, car une image locale est disponible.
En d'autres termes, nous avons obtenu un processus de construction contrôlé et flexible. Nous utilisons les mêmes outils pour construire n'importe quels conteneurs avec un versionnage complet.
Comment fonctionne notre procédure de construction
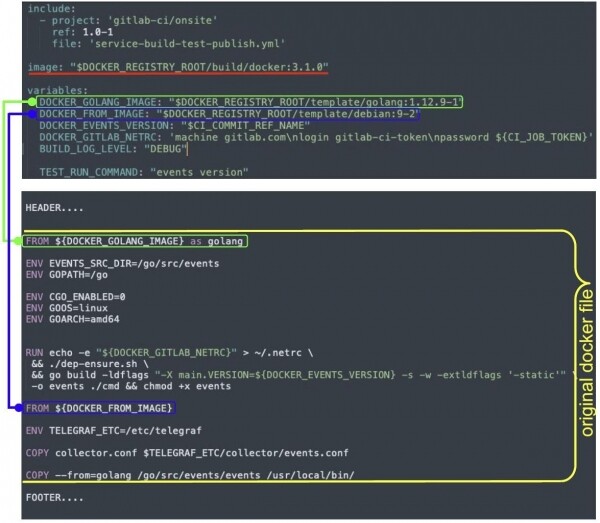
Le déploiement s'effectue par une seule commande, le processus s'exécute dans l'image (soulignée en rouge). Le développeur a un fichier Docker (souligné en jaune) que nous rendons, en remplaçant les variables par des valeurs. Nous ajoutons également des en-têtes et des pieds de page - ce sont nos agents.
L'en-tête ajoute des distributions à partir des images correspondantes. Le pied de page insère nos services, configure le démarrage de la charge de travail, des journaux et d'autres agents, remplace l'entrypoint, etc.
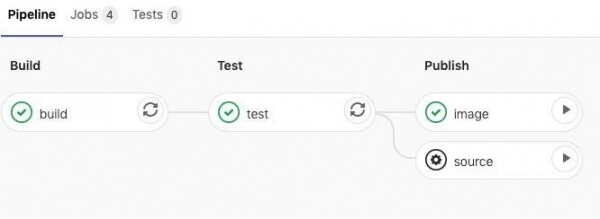
Nous avons longtemps réfléchi à l'opportunité d'installer un superviseur. Finalement, nous avons décidé qu'il nous était nécessaire. Nous avons choisi S6. Le superviseur gère le conteneur : il permet de s'y connecter en cas de tombée du processus principal et offre un contrôle manuel du conteneur sans le recréer. Les journaux et les métriques sont des processus s'exécutant à l'intérieur du conteneur. Nous devons également les contrôler d'une manière ou d'une autre, et nous le faisons avec l'aide du superviseur. Enfin, S6 prend en charge l'entretien, le traitement des signaux et d'autres tâches.
Puisque nous utilisons différents systèmes d'orchestration, après la construction et le démarrage, le conteneur doit comprendre dans quel environnement il se trouve et agir en conséquence. Par exemple :
Cela nous permet de construire une seule image et de la lancer dans différents systèmes d'orchestration, en prenant en compte les spécificités de ce système d'orchestration.
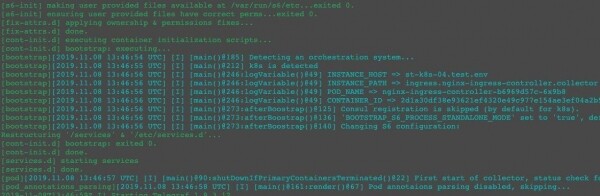
Pour le même conteneur, nous obtenons différents arbres de processus dans Docker et Kubernetes :
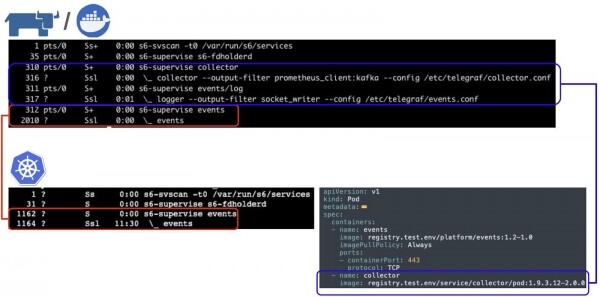
La charge utile s'exécute sous le superviseur S6. Notez le collector et les événements - ce sont nos agents responsables des journaux et des métriques. Dans Kubernetes, ils ne sont pas présents, tandis que dans Docker, ils le sont. Pourquoi ?
Si nous regardons la spécification du « pod » (ici et ci-après - pod Kubernetes), nous verrons que le conteneur events s'exécute dans le pod, qui a un conteneur collector distinct, chargée de la collecte des métriques et des journaux. Nous pouvons utiliser les fonctionnalités de Kubernetes : lancer des conteneurs dans un même pod, dans un même espace de processus et/ou réseau. En fait, nous pouvons intégrer nos propres agents et réaliser certaines fonctions. Et si le même conteneur est lancé dans Docker, il obtiendra toutes les mêmes fonctionnalités, c'est-à-dire qu'il pourra livrer des journaux et des métriques, car les agents seront lancés à l'intérieur.
Métriques et journaux
La livraison des métriques et des journaux est une tâche complexe. Sa résolution est liée à plusieurs aspects.
L'infrastructure est créée pour exécuter des charges utiles, et non pour le transport massif de journaux. Cela signifie que ce processus doit être réalisé avec des exigences minimales en ressources pour les conteneurs. Nous nous efforçons d'aider nos développeurs : « Prenez un conteneur Docker Hub, exécutez-le, et nous pourrons livrer les journaux ».
Le deuxième aspect concerne la limitation du volume des journaux. Si plusieurs conteneurs rencontrent une situation de pic de volume de journaux (une application en boucle affiche une stack-trace), cela augmente la charge sur le CPU, les canaux de communication, le système de traitement des journaux, et cela influence le fonctionnement de l'hôte dans son ensemble ainsi que d'autres conteneurs sur l'hôte, ce qui peut parfois entraîner un « crash » de l'hôte.
Le troisième aspect est qu'il est nécessaire de supporter dès le départ autant de méthodes de collecte de métriques que possible. Cela va de la lecture de fichiers au sondage d'un point de terminaison Prometheus, jusqu'à l'utilisation de protocoles spécifiques aux applications.
Et le dernier aspect consiste à minimiser la consommation de ressources.
Nous avons choisi une solution open-source en Go appelée Telegraf. C'est un connecteur polyvalent qui prend en charge plus de 140 types de canaux d'entrée (input plugins) et 30 types de sortie (output plugins). Nous l'avons amélioré et maintenant nous allons expliquer comment il est utilisé chez nous via Kubernetes.
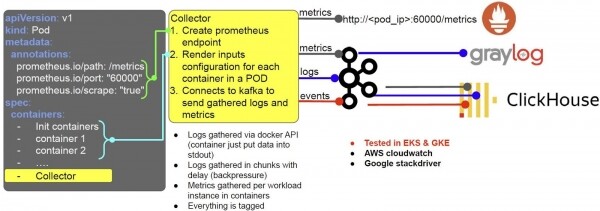
Supposons qu'un développeur déploie une charge, et Kubernetes reçoit une demande de création d'un pod. À ce moment-là, un conteneur appelé Collector est automatiquement créé pour chaque pod (nous utilisons un webhook de mutation). Collector est notre agent. Au démarrage, ce conteneur s'auto-configure pour travailler avec Prometheus et le système de collecte des journaux.
- Pour cela, il utilise les annotations du pod, et selon leur contenu, il crée, disons, un point de terminaison Prometheus ;
- Sur la base de la spécification du pod et des configurations spécifiques des conteneurs, il décide comment livrer les journaux.
Nous collectons les journaux via l'API Docker : il suffit aux développeurs de les placer dans stdout ou stderr, et le Collector s'en occupera. Les journaux sont collectés par morceaux avec un certain délai pour éviter une éventuelle surcharge de l'hôte.
Les métriques sont collectées selon les instances de charge de travail (processus) dans les conteneurs. Tout est étiqueté : namespace, pod, etc., puis converti au format Prometheus – et devient accessible pour la collecte (en plus des journaux). De plus, les journaux, les métriques et les événements sont envoyés dans Kafka et ensuite :
- Les journaux sont disponibles dans Graylog (pour une analyse visuelle) ;
- Les journaux, métriques et événements sont envoyés vers Clickhouse pour un stockage à long terme.
De la même manière, cela fonctionne sur AWS, mais nous remplaçons Graylog avec Kafka par Cloudwatch. Nous y envoyons les journaux, et tout est très pratique : il est immédiatement clair à quel cluster et conteneur ils appartiennent. Cela s'applique également à Google Stackdriver. En d'autres termes, notre système fonctionne à la fois sur site avec Kafka et dans le cloud.
En revanche, si nous n'avons pas de Kubernetes avec des pods, le schéma devient un peu plus complexe, mais fonctionne selon les mêmes principes.
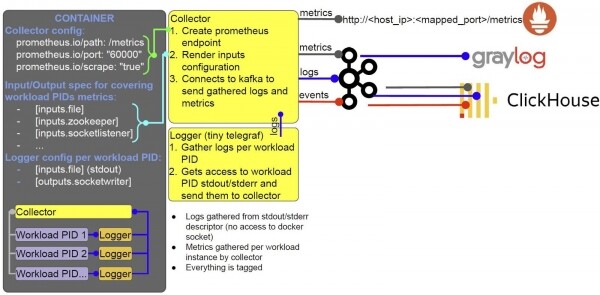
À l'intérieur du conteneur, les mêmes processus sont exécutés, orchestrés à l'aide de S6. Tous ces mêmes processus sont lancés à l'intérieur d'un seul conteneur.
En fin de compte
Nous avons créé une solution complète pour la construction et le déploiement d'images, avec des options de collecte et de livraison de journaux et de métriques :
- Nous avons développé une approche standardisée pour la construction d'images, sur laquelle nous avons basé nos modèles CI ;
- Les agents de collecte de données sont nos extensions Telegraf. Nous les avons bien testées en production ;
- Nous utilisons un webhook de mutation pour intégrer des conteneurs avec des agents dans les pods ;
- Nous avons intégré l'écosystème Kubernetes/Rancher ;
- Nous pouvons exécuter des conteneurs identiques dans différents systèmes d'orchestration et obtenir les résultats que nous attendons ;
- Nous avons créé une configuration entièrement dynamique pour la gestion des conteneurs.
Co-auteur : Ilya Prudnikov
Source : habr.com
